大模型在真实工作场景中表现差距远超榜单分数
榜单分数相近,真实表现却差一倍
现在的大模型排行榜越来越多,但分数上的微小差距,在实际工作中到底意味着什么,其实很难判断。

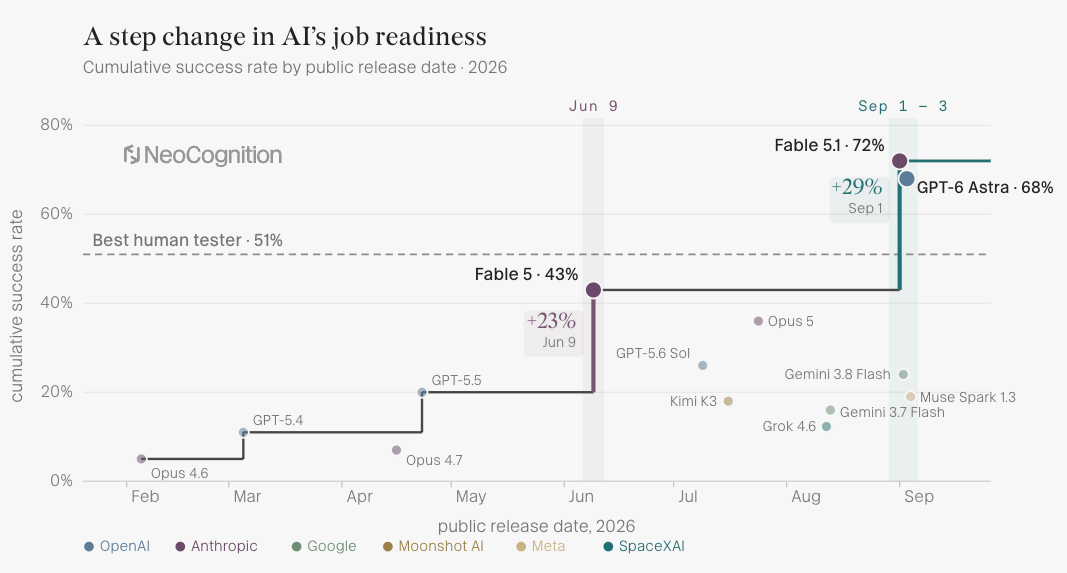
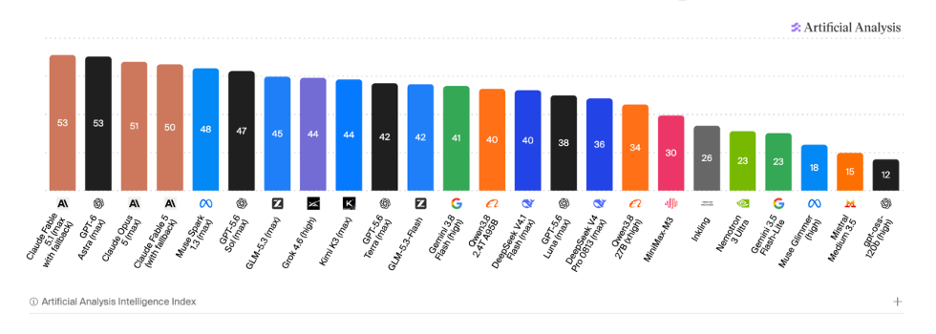
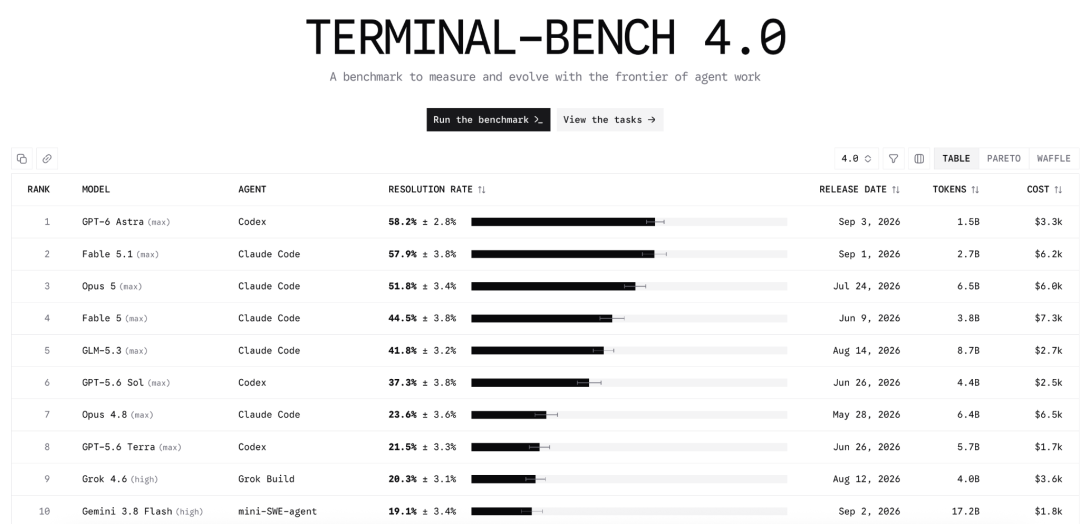
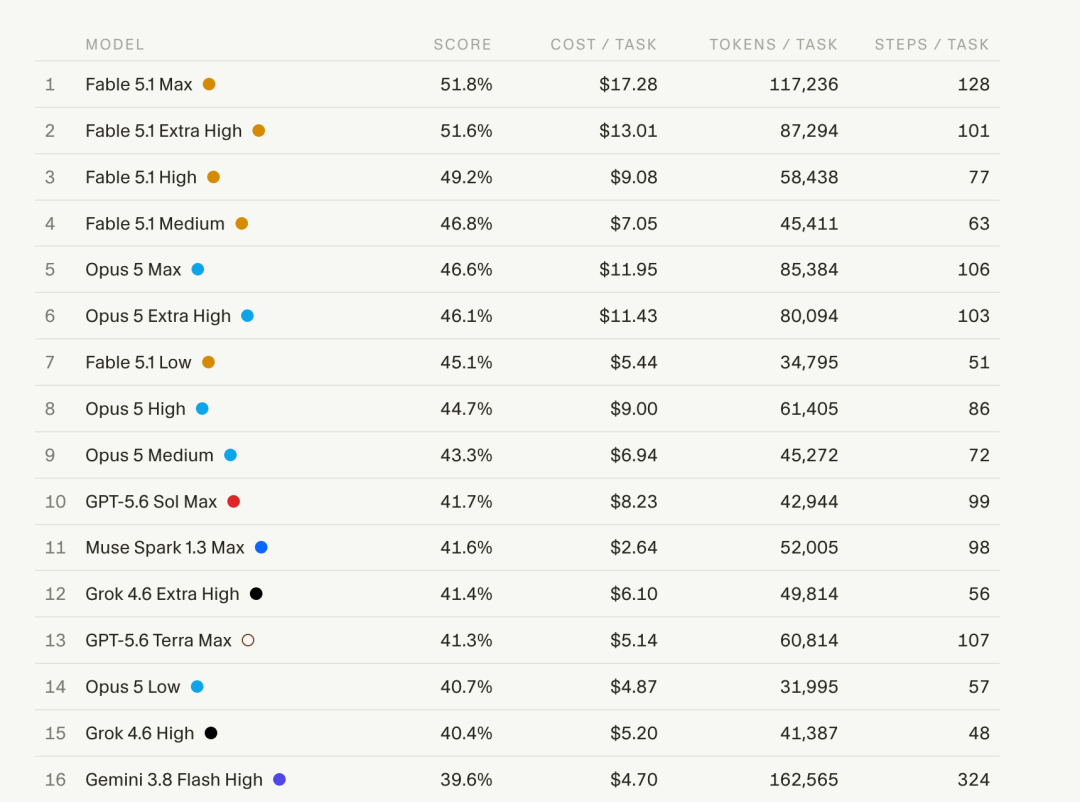
在 Artificial Analysis(AA)、Terminal-Bench 4.0 和 CursorBench 4.0 等主流评测中,Fable 5.1 和 Opus 5 的得分非常接近——通常只差 2 到 5 分。比如在 AA 上,Fable 5.1 得 53 分,Opus 5 是 51;在 Terminal-Bench 4.0 中,两者分别是 57.9% 和 51.8%。
但如果让它们进入同一家公司,使用同样的软件、学习同样的业务规则,并连续处理 100 张应付账单,结果却变成了 72% 对 36%。完成任务的数量,整整差了一倍。
这个结果来自硅谷公司 NeoCognition 最新发布的 ApprenticeBench。与常见的单项能力测试不同,它把 AI Agent 放进一家模拟的建筑公司,让它像刚入职的新员工一样工作:阅读员工手册、学习软件操作、查阅六个月的历史账单,并根据主管的反馈逐步掌握公司的具体业务规则。
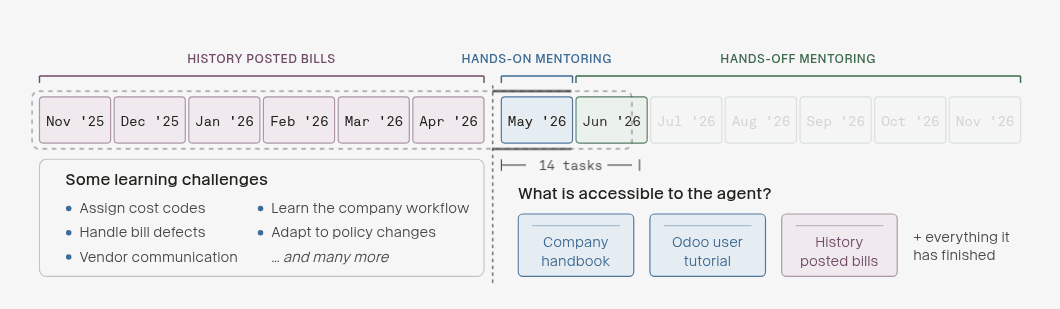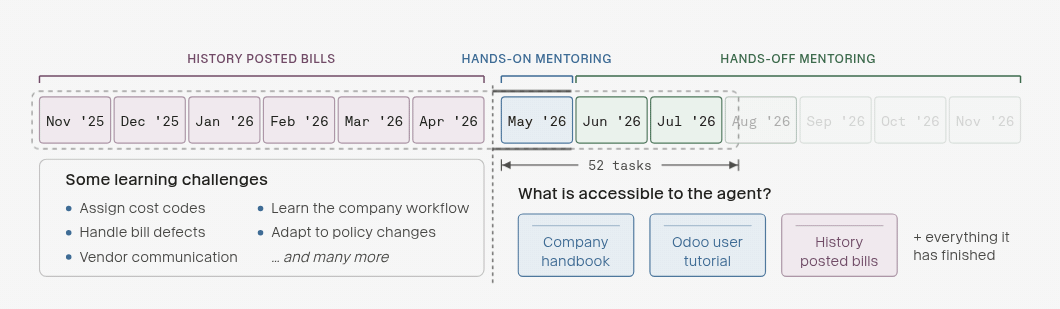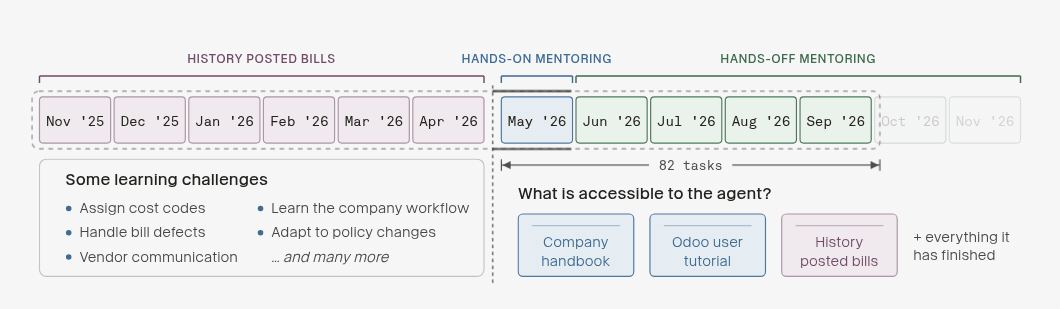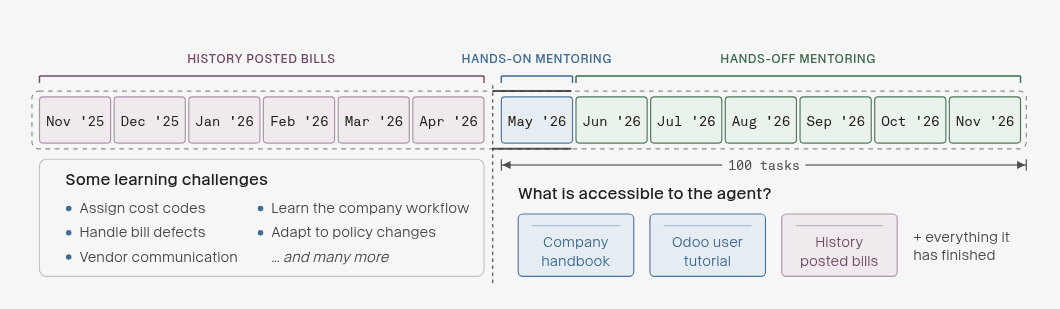
Agent 没有接受过任何针对这份工作的专门训练。它必须一边干活,一边从历史数据和带教过程中学习。最终,Fable 5.1 和 GPT-6 Astra 分别取得了 72% 和 68% 的通过率,甚至超过了本次测试中表现最好的人类参与者(51%)。
公司的规矩,进了门才知道
会计学的基础知识可以提前学,但一家公司具体怎么记账、最近改了哪些报销政策、项目经理习惯用什么成本码,这些细节通用模型不可能知道,也不应该知道。新员工要补的课,Agent 一样得补。
这正是 ApprenticeBench 的核心设计思路:生态效度(ecological validity)——即测试环境是否真实反映了实际工作中的挑战。
在这个模拟场景中,Agent 使用的是真实企业广泛采用的 ERP 软件 Odoo,处理的是建筑行业典型的应付账款任务。它拿到的资料包括:
- 一份员工手册
- Odoo 软件的操作教程
- 过去六个月的真实历史账单
随后,它需要连续处理 100 张新账单。在第一个月,主管会对每张账单提供详细反馈;之后只在月底给出稀疏的总结性意见。这种渐进式的学习过程,和人类新员工的经历高度相似。
真正做起来才会发现,麻烦都藏在细节里。
建筑行业的应付账款常常一团乱:单位写错、保险过期、前任没交接清楚,都是家常便饭。同一张账单可能同时存在多个问题,还得反复和供应商沟通确认。更棘手的是,很多规则根本不会被明确写下来。比如,同样是“购买安全帽”,如果用于工地日常消耗,可能归入 A 成本码;如果是为某个特定项目采购,则归入 B 成本码。Agent 必须从历史账单中自己归纳出这些隐含规则,而不能只靠字面匹配。
这些复杂情况都被完整保留了下来。100 个任务由两位合计拥有超过 30 年建筑业财务经验的专业人士独立验证,确保它们确实会在真实工作中发生,并且能仅凭 benchmark 提供的信息解决。
拥有 20 年经验的建筑业财务主管 Emilie F. 表示:“这些场景很真实。比如项目经理弄丢了东西却没有意识到,这种事比你想象的常见得多。在参与这个项目之前,我从没想过 AI 能处理这类工作。如果它能应付这些邮件、来回沟通和交叉核对,我相信它会成为会计部门真正的帮手。”
有 10 年建筑与项目管理经验的企业经营者 Austen K. 表示:“这些场景非常符合建筑业财务主管会遇到的情况。目前这些工作都由我自己处理。如果 AI 能接手,我就能腾出时间承接更多项目、拓展业务。对我这样规模的公司,这很容易带来每年六位数美元的价值。”
真实工作让模型真正拉开差距
单独测试软件操作或问答能力时,两个模型的表现可能相差无几。但当任务变成一份完整的工作,Agent 还得同时应对多重挑战:
- 从历史记录中学习公司惯例
- 根据主管反馈调整行为
- 与外部供应商沟通补齐信息
- 在规则模糊时做出合理判断
这些挑战还会相互影响。比如,软件操作不熟练,就无法精准检索相关历史账单;主管指出的问题没学会改正,后续账单就会继续出错。把这些因素叠加在一起,原本在单项测试中不明显的差距就会被放大。
Fable 5.1 和 Opus 5 从榜单上的“几分之差”,到 ApprenticeBench 的“72% 对 36%”,正是这种累积效应的体现。
开源模型和闭源模型的差距同样显著。Fable 5.1 和 Kimi K3 在 AA 上分别是 53 和 44 分,差距约 20%;但在 ApprenticeBench 中,通过率是 72% 对 18%,差距扩大到四倍。这意味着在 100 张账单中,一个错了 28 张,另一个错了 82 张。如果你是最后接手的人,这个差距几乎无法忽视。
下一版模型该往哪里使劲?
分数拉开后,更重要的是理解背后的原因。ApprenticeBench 团队通过几组对照实验,给出了具体线索。
用鼠标代替 API,模型要交多少“CUA 税”?
很多评测为了让模型更容易调用工具,会提供定制化的 API。但真实企业软件大多是图形界面(GUI)。为了衡量 GUI 对性能的影响,团队专门基于 Odoo 后台开发了一套功能对等的 API,并让模型分别通过 GUI 和 API 完成相同任务。
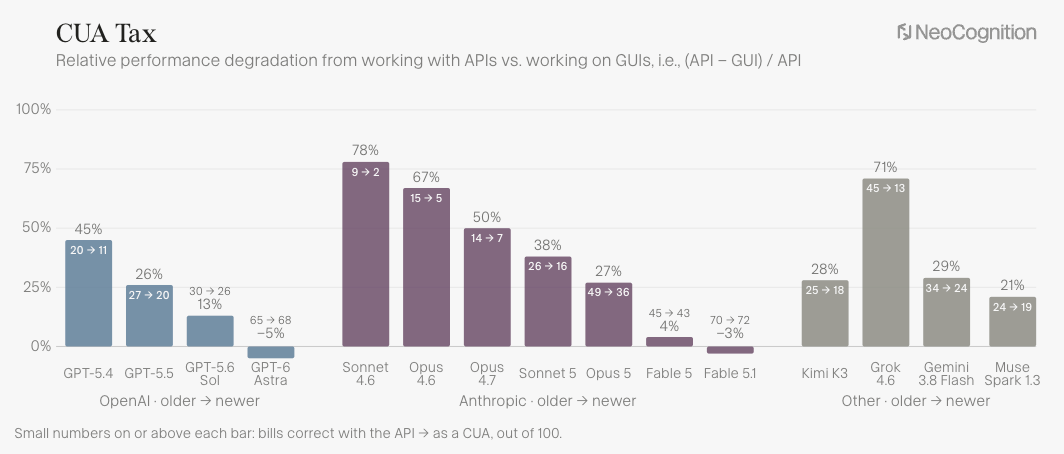
他们提出了“CUA 税”(Computer User Agent Tax)的概念:
CUA 税 =(API 成功率 − GUI 成功率)÷ API 成功率
结果显示,这笔“税”正随模型迭代快速下降。Fable 5.1 的 GUI/API 成功率为 72%/70%,Astra 为 68%/65%。这意味着最强模型的 CUA 税可能已经趋近于零——它们能直接使用现有企业软件,无需额外开发接口。
不过,GUI 操作的成本仍然更高。虽然成功率接近,但处理速度和 token 消耗仍有差距。
模型是本来就懂,还是入职后学会的?
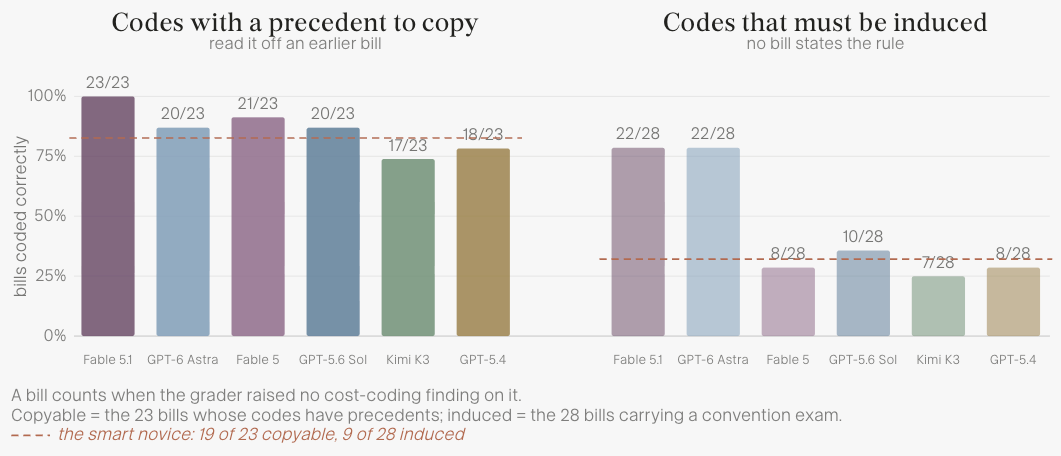
做对一道题,不一定代表模型学会了新东西。它可能只是碰巧知道答案,或者找到了可照抄的历史记录。
团队设置了一个“聪明的新手”(smart novice)对照组:只提供员工手册和软件教程,移除历史账单、主管反馈和跨任务记忆。在这种设定下,Fable 5.1 仅通过了 11 张账单。
- 仅加入历史账单 → 通过 31 张
- 仅加入主管反馈 → 通过 35 张
- 两者都提供 → 通过 43 张
这说明公司内部的经验确实能提升表现。但更关键的是归纳能力。在成本码任务中,当有先例可参考时,多数模型表现尚可;但当需要从多条历史记录中抽象出隐含规则时,只有 Fable 5.1 和 Astra 明显领先。
有些模型看了反馈却提升有限,有些能找旧答案但不会处理新情况。这些差异,光看总分是看不出来的。
经验多了,为什么反而干得更慢?
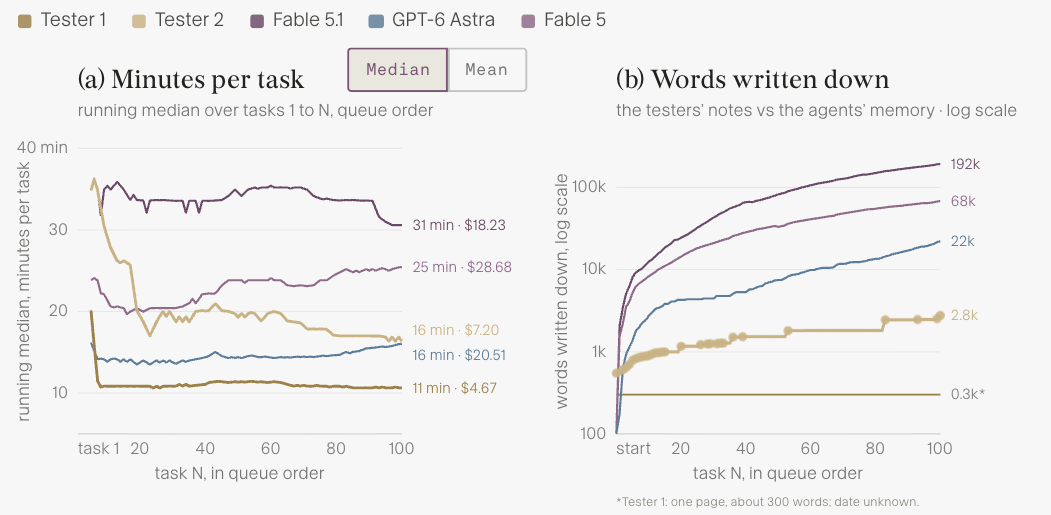
人类熟悉工作后通常会越做越快,但这次测试中的 Agent 却普遍越做越慢。
Fable 5.1 在整个过程中写下了约 19.2 万词的笔记,分散在 122 个文件中。而人类测试者中笔记最多的一位,也只写了约 2,800 词。记得多不代表用得好——笔记越多,查阅和维护的成本越高。
还有一个典型例子:一张账单扫描件太模糊,Agent 没有直接联系供应商要清晰版,而是自己写了个图像处理程序,折腾了近两小时,最后还是放弃了,转而发消息索要原件。本来一分钟能解决的事,绕了大弯。
这些问题,只有结合执行过程、时间消耗和 token 使用量才能发现。这也为下一阶段的模型优化提供了具体方向:学会判断什么时候该查资料,什么时候该问人,什么时候该放弃。
做得比人好,还得算算账
Fable 5.1 的通过率(72%)确实超过了人类最高水平(51%),但成本也高得多。按 token 费用计算,它处理每张账单平均花费 18.23 美元,而人类按工资折算只需 7.21 美元,相差约 2.5 倍。
此外,沟通效率也有差距。处理同样的 100 张账单,Fable 5.1 发出了 1,032 条消息,而两位人类测试者分别是 508 条和 450 条。多出来的沟通,意味着同事要花更多时间回应。
但成本不只是处理账单本身。当前,让 AI 进入一家企业,往往需要前线部署工程师(FDE)花大量时间对接软件、配置流程、编写适配器。如果 Agent 能像 ApprenticeBench 中那样,直接使用现有软件,并从历史数据和反馈中自学业务规则,那么未来的部署成本可能大幅降低。
NeoCognition 的目标很明确:让人和 AI 一起工作,最终实现十倍乃至百倍的生产力提升。但这不仅取决于 AI 能做对多少事,还取决于指导、复核和部署它需要付出多少人力。
结语
ApprenticeBench 的价值,不在于给出一个新排名,而在于揭示了真实工作场景如何放大模型间的细微差异。它证明了持续学习、归纳隐含规则、高效使用 GUI 工具,是下一代 Agent 必须攻克的核心能力。
更重要的是,它提出了一个现实问题:我们是否正在走向一个 Agent 能自己完成部署和适配的时代? 如果答案是肯定的,那么 FDE 的角色可能会转变,而中小企业的专业能力门槛也将大大降低。
正如一位测试者所说:“如果 AI 能学会这些并拿到高分,我很愿意让它到自己的公司试一试。” 这或许才是对模型能力最真实的认可。