AI 应用如何做日志、监控、成本统计和效果评估?
日志、指标、追踪:AI 可观测性的三个支柱
AI 系统上线后,光能跑通还不够,得“看得见、管得住”。这靠的是可观测性三件套:日志、指标、链路追踪。
日志记录具体事件,比如某次推理请求失败的原因、时间戳、输入参数。它像行车记录仪,出问题时回放细节。但日志量大,不能直接看趋势。
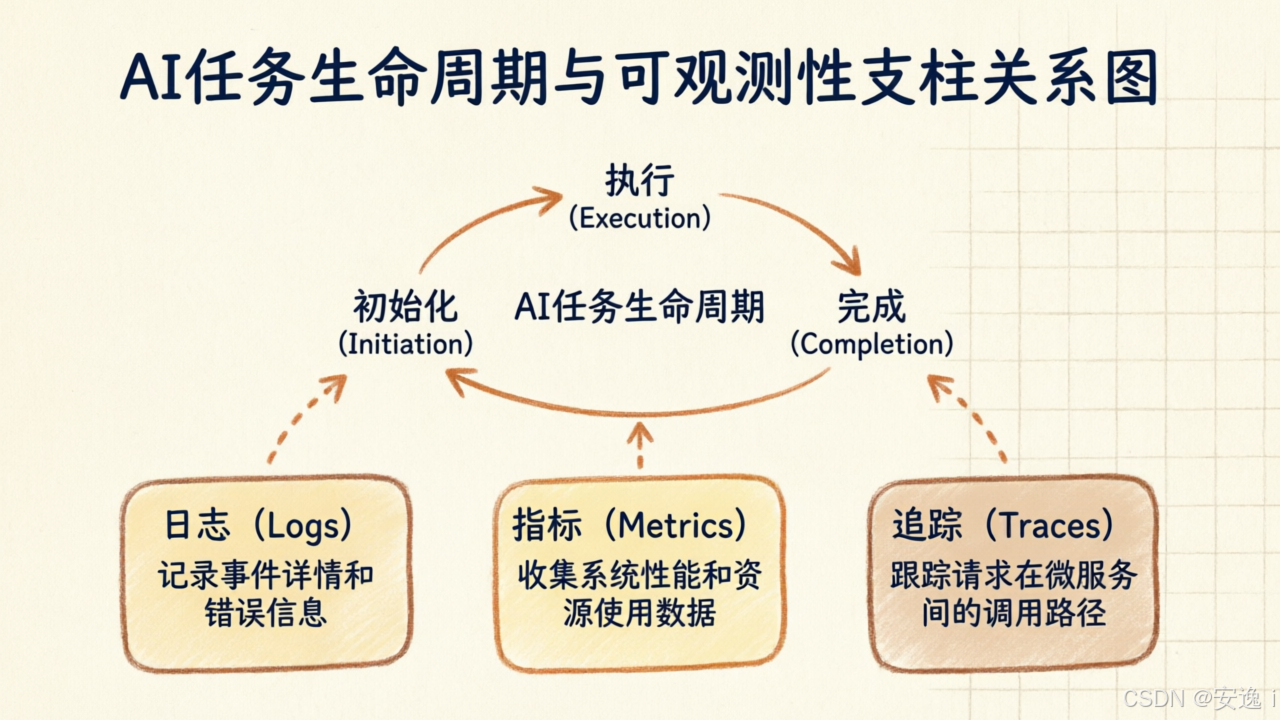
指标是聚合后的数值,比如 GPU 利用率、P99 延迟、QPS。它们适合画成图表,快速判断系统是否健康。但指标看不到上下文,不知道为什么突增或下跌。
链路追踪把一次用户请求从入口到出口的所有服务调用串起来,标出每个环节耗时。比如一个 RAG 请求经过查询解析、向量检索、重排、生成四个步骤,追踪能告诉你哪一步拖慢了整体响应。
三者互补:日志查根因,指标看全局,追踪定瓶颈。实际部署时,通常用 OpenTelemetry 统一采集,再分别写入 Loki(日志)、Prometheus(指标)、Jaeger 或 Tempo(追踪)。
训练监控 vs 推理监控:目标完全不同
很多人把训练和推理的监控混为一谈,其实两者关注点差异很大。
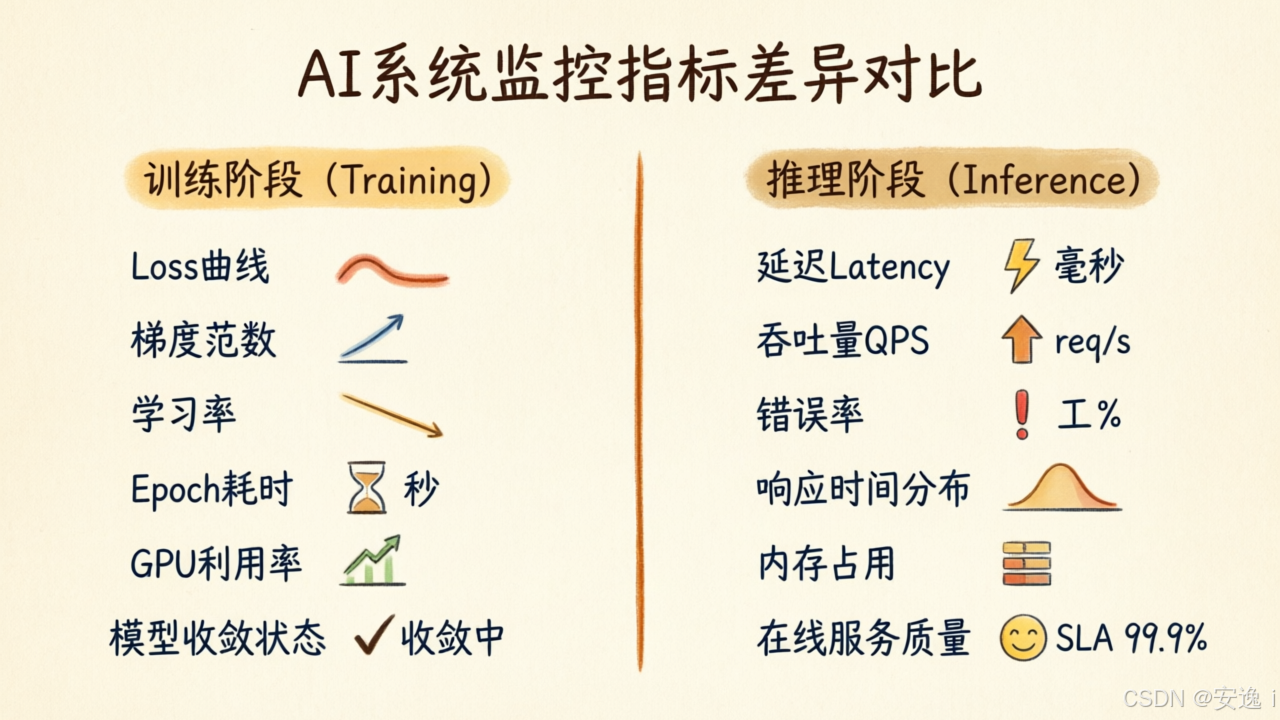
训练阶段的核心是资源效率。你得盯住:
- 任务完成率:提交的训练任务有多少成功跑完?失败的任务卡在哪一步?
- 排队等待时间:任务从提交到真正开始训练等了多久?这反映资源调度是否合理。
- GPU 有效利用率:不是看 GPU 是否满载,而是看计算是否真用在梯度更新上。有些任务因数据加载慢或通信瓶颈,GPU 大部分时间在空转。
- 失败分类统计:OOM(内存溢出)、超时、代码错误——不同原因需要不同优化策略。
举个例子,GPU 利用率 90% 看似高效,但如果一半时间花在从远程存储读数据上,那其实是 I/O 瓶颈,该优化数据流水线而不是加 GPU。
推理阶段则更关注服务质量和成本。关键指标包括:
- 延迟分布:P50、P95、P99 响应时间,尤其要关注长尾延迟。
- 吞吐量:每秒能处理多少请求,是否满足业务峰值需求。
- 错误率:HTTP 5xx、模型返回异常、超时等占比。
- 单位成本:每千次调用消耗多少 GPU 小时或 API 费用。
训练看“能不能高效跑完”,推理看“能不能稳定扛住”。监控面板也该分开设计,别用同一套看板应付两个阶段。
成本怎么算清楚?按租户、模型、场景拆分
AI 推理成本动辄占项目预算大头,糊里糊涂烧钱不可持续。成本主要来自三块:GPU 算力、显存占用、第三方 API 调用费(如调用 Claude 或 GPT-4)。
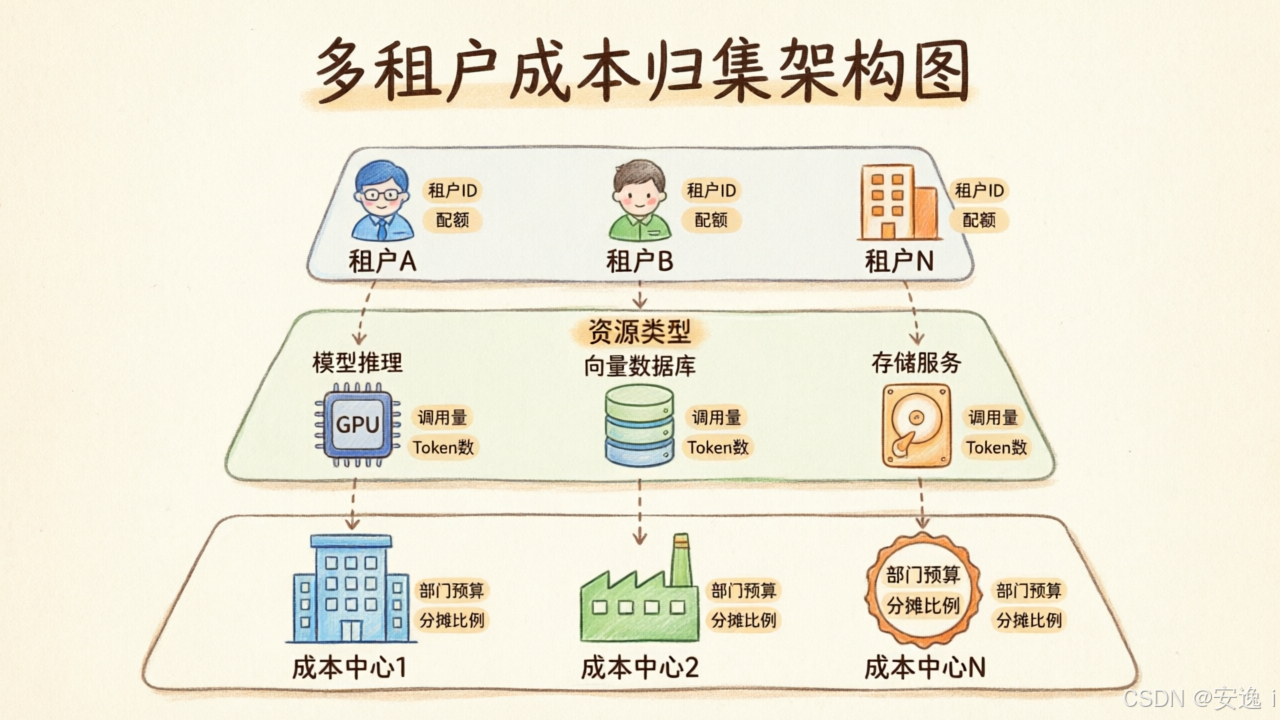
要控制成本,首先得归集清楚。常见维度有:
- 按租户:SaaS 场景下,不同客户消耗的资源必须分开计量,否则无法定价或对账。
- 按模型版本:v1 和 v2 模型可能效果接近,但 v2 因结构复杂贵了 30%。没成本数据就无法做技术选型。
- 按调用场景:搜索类请求通常短平快,对话类请求上下文长、生成多,成本结构天然不同。
有了明细,才能针对性优化。常用手段包括:
- 缓存:对高频相似查询(如“北京天气”)缓存结果,避免重复计算。
- 批处理:非实时任务(如夜间批量生成报告)合并请求,提升 GPU 利用率。
- 降级策略:非核心功能(如推荐理由生成)在高峰时段切到小模型,保主链路稳定。
有个容易被忽略的点:冷启动成本。模型首次加载到 GPU 时会消耗额外时间和显存,频繁启停反而更贵。长期低频服务不如常驻小实例。
Agent 效果评估:四步法 + 主流框架
评估普通模型看准确率、F1 值就行,但 Agent(智能体)涉及多轮交互、工具调用、决策链,评估复杂得多。
一套可行的方法是四步评估法:
- 明确评估目标:是看任务完成率?工具调用准确率?还是最终输出质量?目标不同,测试集和指标也不同。
- 构建高质量测试集:覆盖典型场景和边界 case。比如订机票 Agent,测试用例要包含正常预订、改签、退票、无航班等情形。
- 选择评估方式:
- 人工评估:最准但成本高,适合关键场景。
- 规则评估:对结构化输出(如 JSON 工具参数)用脚本校验,快但覆盖有限。
- LLM as Judge:用大模型给 Agent 输出打分,成本低但可能有偏见或误判。
- 分析短板并迭代:比如发现工具调用错误集中在日期解析,就加强该模块的 prompt 或增加后处理校验。
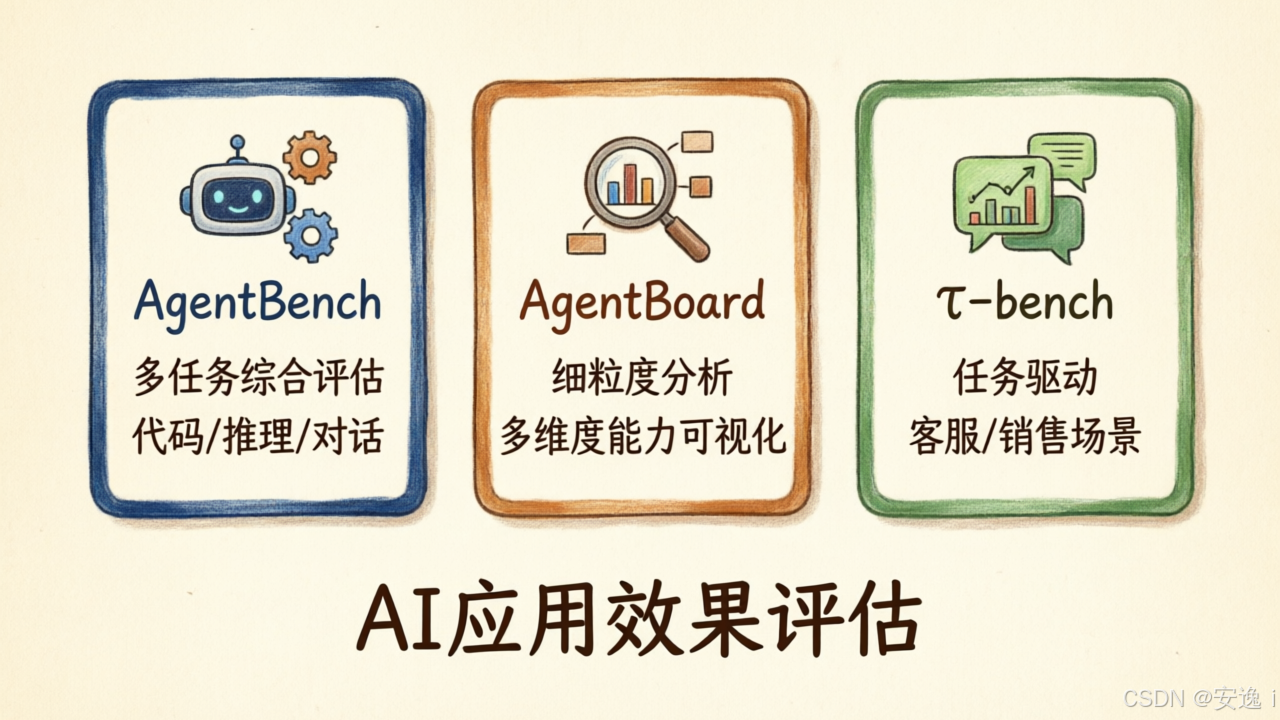
目前有几个主流评估框架可参考:
- AgentBench:覆盖 8 类任务(数学、代码、知识问答等),适合全面评测 Agent 通用能力。
- τ-bench:专注对话场景,评估 Agent 是否正确理解用户意图并调用合适工具。
- AgentBoard:提供细粒度调试视图,能看到每一步的中间状态,适合开发阶段快速定位问题。
需要注意,LLM as Judge 在高风险领域(如医疗、金融)不可全信。曾有案例显示,大模型给错误的法律建议打了高分,因为表述“听起来专业”。这类场景必须保留人工审核环节。
告警别乱报:分级、去重、聚合
很多团队初期监控做得不错,但告警配置太粗糙,导致“狼来了”效应——真正出事时没人敢信告警。
解决告警疲劳,靠三招:
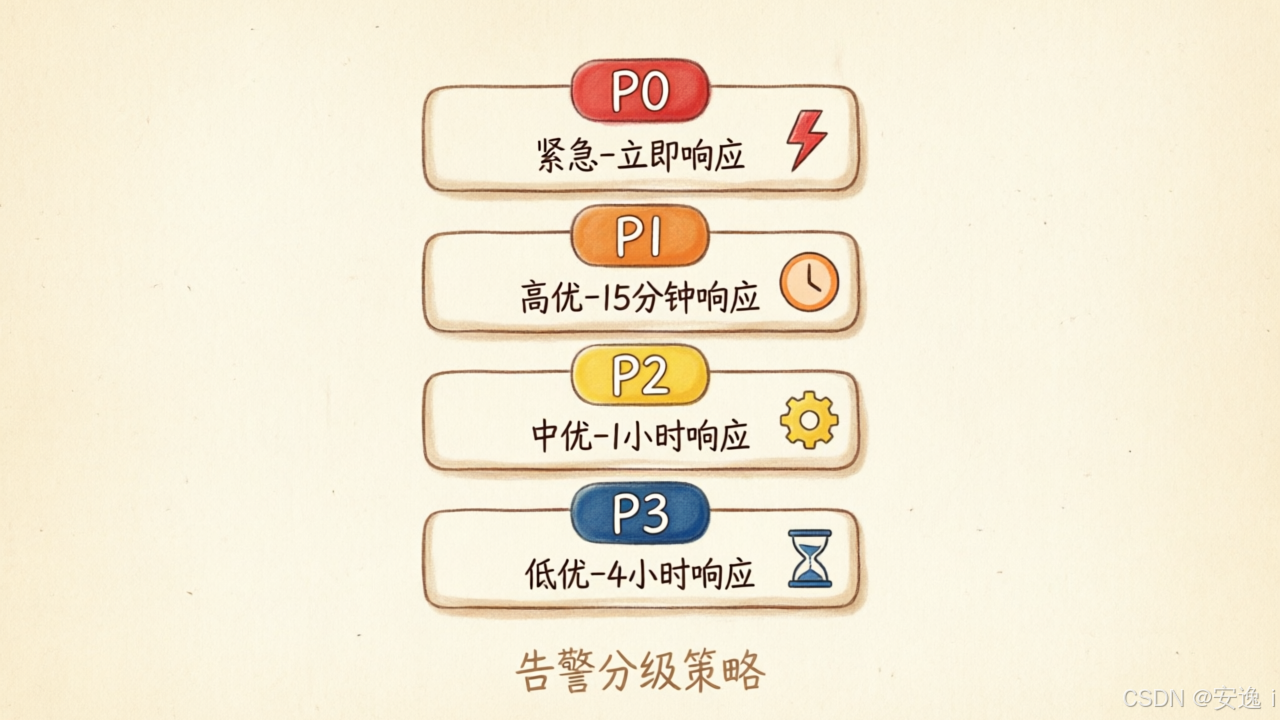
- 分级:按影响程度分 P0-P3:
- P0:核心业务完全不可用(如所有推理请求失败),需立即响应。
- P1:关键指标严重劣化(如延迟翻倍、错误率超 10%),15 分钟内处理。
- P2:性能下降但业务可用(如 GPU 利用率持续 95%),1 小时内跟进。
- P3:预警类(如磁盘使用率达 80%),可纳入周报处理。
- 去重:同一问题在短时间内只告一次。比如数据库连接池耗尽,1 分钟内无论触发多少次,只发一条告警。
- 聚合:关联告警合并。例如某个微服务宕机,导致下游 50 个接口报错,应聚合成“XX 服务不可用”,而不是刷屏 50 条接口错误。
AI 系统特有的关键告警指标包括:任务完成率骤降、工具调用失败率上升、缓存命中率异常下跌。这些比传统的 CPU 使用率更能反映 AI 业务的真实状态。
另外,告警要配静默期。比如凌晨自动扩缩容期间,短暂的指标波动不应触发告警,避免打扰值班人员。
实践建议:从小处着手,逐步完善
搭建 AI 可观测性体系不必一步到位。建议按以下顺序推进:
- 先保证基础日志:至少记录每次请求的 trace_id、时间戳、输入摘要、输出状态、耗时。这是后续所有分析的基础。
- 加上核心指标:GPU 利用率、请求延迟、错误率、QPS。用 Grafana 做个简单看板。
- 引入链路追踪:对关键路径(如 RAG 全流程)打点,定位性能瓶颈。
- 细化成本归集:在日志或指标中加入租户 ID、模型版本等标签,方便后续分账。
- 建立评估闭环:哪怕每周只人工评估 20 个 Agent 样本,也比完全不评估强。
记住,可观测性不是为了堆砌工具,而是为了快速发现问题、量化影响、验证优化效果。所有投入最终都要服务于这个目标。