2026年Python+AI入门实操指南:避开新手常见误区
为什么现在学Python+AI更简单了?
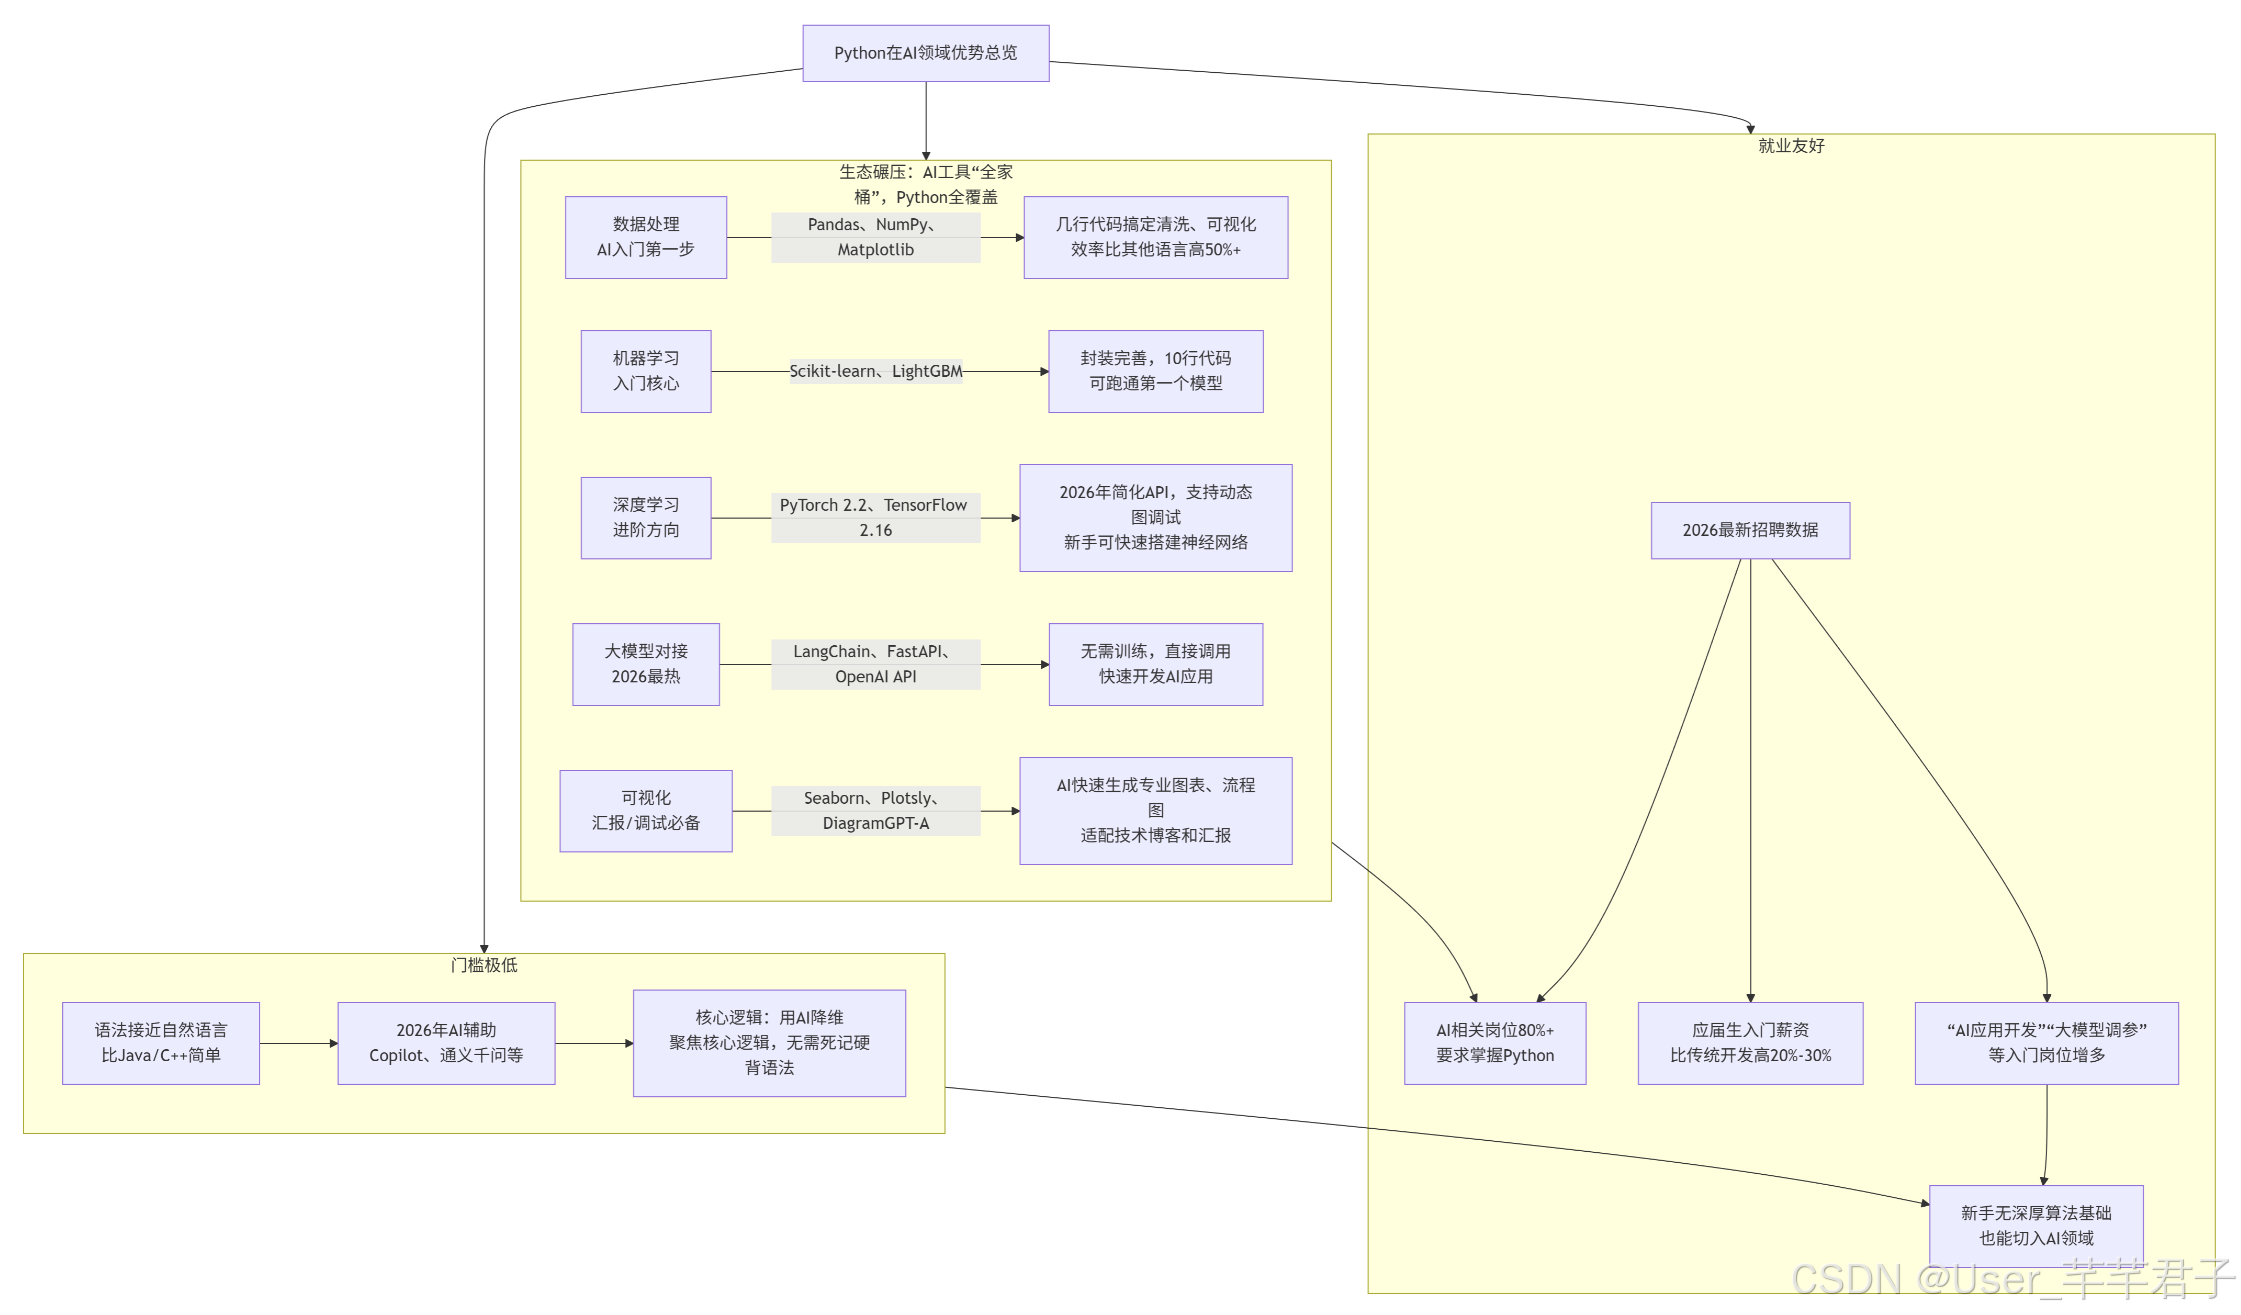
2026年,用Python做AI开发比以往任何时候都更友好。不是因为技术变简单了,而是工具链成熟了——你不需要从头训练大模型,也不必精通所有数学细节,就能调用现成的AI能力,做出能跑起来的应用。

很多人卡在“先学什么”的纠结里:是先把Python学到精通,还是先把高数线代啃完?其实更高效的做法是边做边学。比如你想预测房价,就从读取CSV文件开始,用几行代码清洗数据、训练一个线性回归模型,过程中自然会遇到列表操作、函数封装、异常处理等问题,这时候再去查语法,印象更深。

Python之所以成为AI首选语言,关键在于生态。Pandas处理表格数据、Scikit-learn跑机器学习模型、LangChain对接大模型——这些库已经把底层复杂性封装好了。你只需要知道怎么组合它们,而不是从零造轮子。
入门前的必要准备
数学:够用就行
别被“AI需要高深数学”吓住。入门阶段,你只需要理解几个核心概念:
- 线性代数:知道矩阵是什么、怎么相乘就够了。AI模型内部大量使用矩阵运算,但你调用库时不用手动算。
- 概率论:了解均值、方差、正态分布,能看懂模型输出的置信度或不确定性。
- 微积分:知道“梯度下降”是通过调整参数让误差变小就行,不用手推公式。
建议在具体项目中补数学。比如做线性回归时,再去看梯度下降的原理;做分类任务时,再理解交叉熵损失。这样学得快,也记得牢。
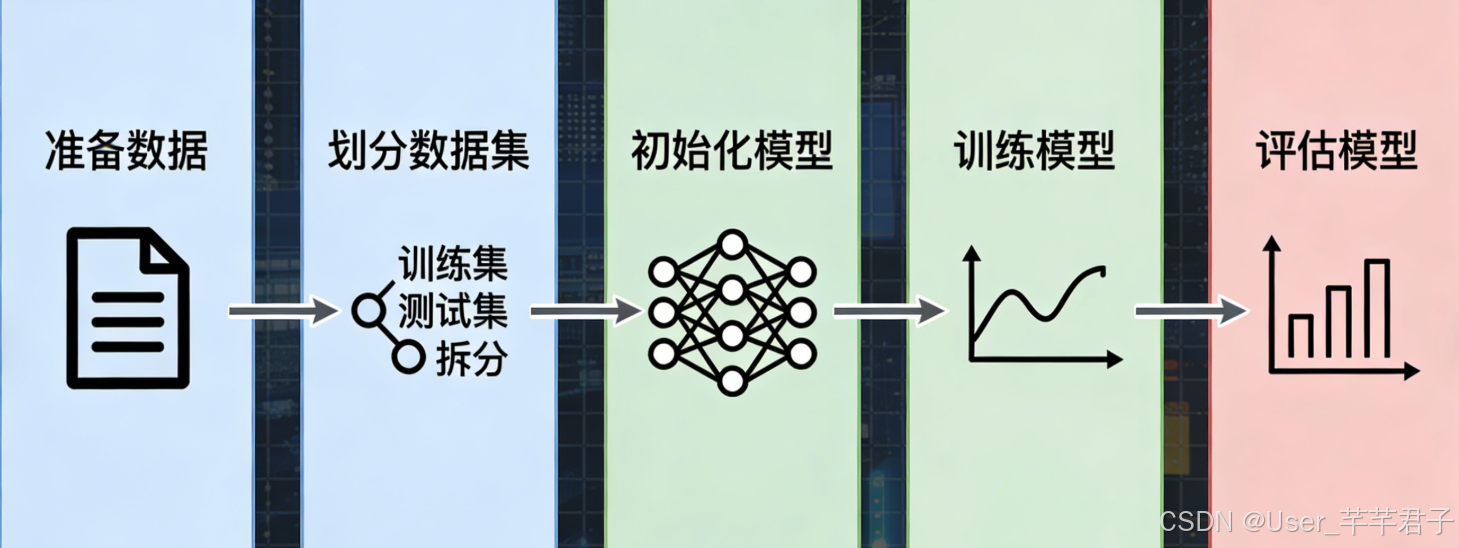
环境搭建:10分钟搞定
环境配置是很多人的第一道坎。推荐以下步骤:
- 安装Python 3.10–3.12:去官网下载,安装时务必勾选“Add Python to PATH”。装完在终端输入
python --version验证。 - 用pip安装核心库:打开终端,依次执行:
pip install --upgrade pip pip install numpy pandas matplotlib scikit-learn pip install torch torchvision # 或 tensorflow pip install langchain openai fastapi - 选个顺手的编辑器:新手推荐 PyCharm Community(免费),开箱即用;熟悉命令行的可以用 VS Code + Python 插件。
装好后,新建一个 .py 文件,试着运行 import pandas as pd; print(pd.__version__),如果没报错,环境就配好了。
Python基础:只学AI用得上的部分
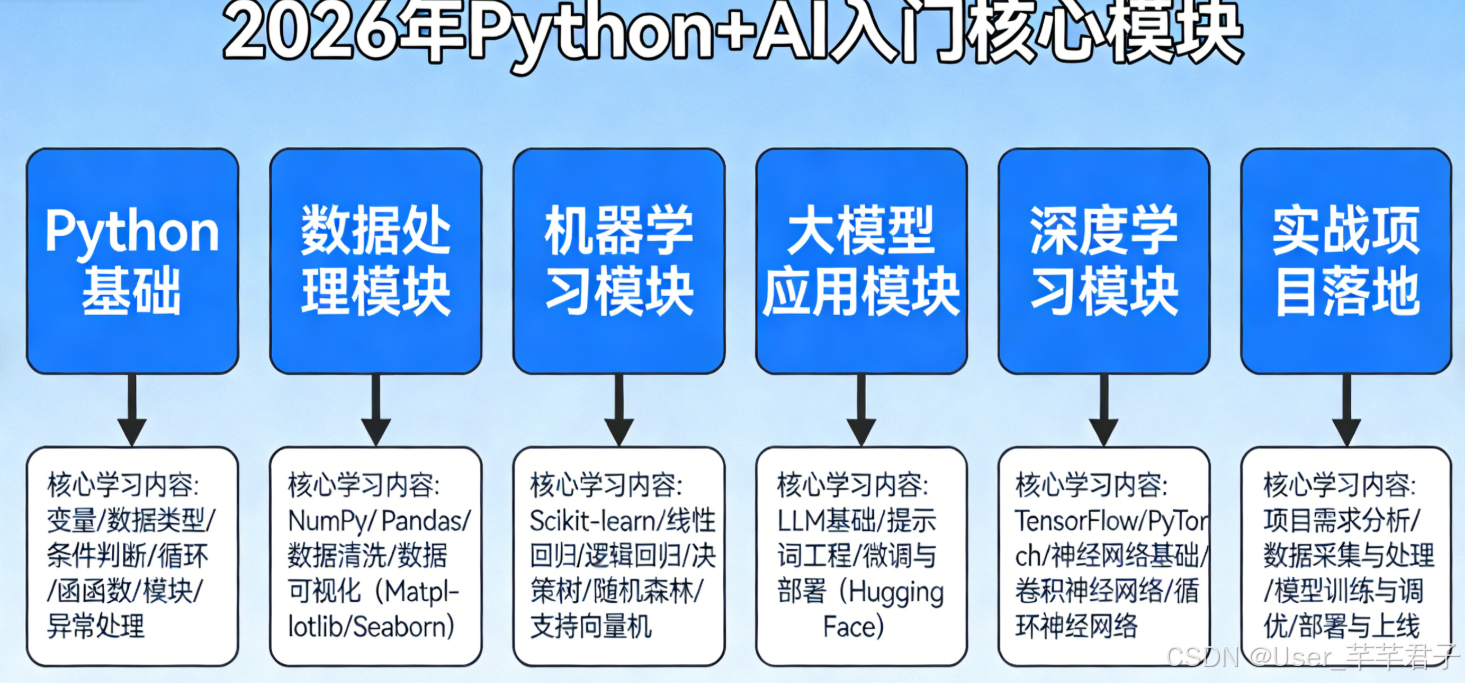
AI开发对Python的要求其实很聚焦。你不需要掌握装饰器、元类这些高级特性,重点掌握以下内容即可:
核心语法五件套
变量与数据结构:重点是列表(存特征)、字典(存参数)。例如:
features = [1.2, 3.4, 5.6] params = {"lr": 0.01, "epochs": 100}循环与条件判断:for循环遍历数据,if-else做逻辑分支。列表推导式能简化代码:
doubled = [x * 2 for x in features if x > 2]函数封装:把重复逻辑包起来。比如写个函数标准化数据:
def normalize(data): mean = sum(data) / len(data) std = (sum((x - mean) ** 2 for x in data) / len(data)) ** 0.5 return [(x - mean) / std for x in data]文件读写:AI项目离不开CSV。用pandas一行读取:
df = pd.read_csv("data.csv") df.to_csv("output.csv", index=False)异常处理:避免程序崩溃。比如文件不存在时提示:
try:
    df = pd.read_csv("data.csv")
except FileNotFoundError:
    print("请检查文件路径")
自测标准
如果你能:
- 用列表/字典存数据,用推导式处理批量数据;
- 写一个函数做数据预处理;
- 用pandas读写CSV并做简单清洗;
那就可以进入AI模块了,不用再刷LeetCode。
AI入门三步走:数据 → 模型 → 应用
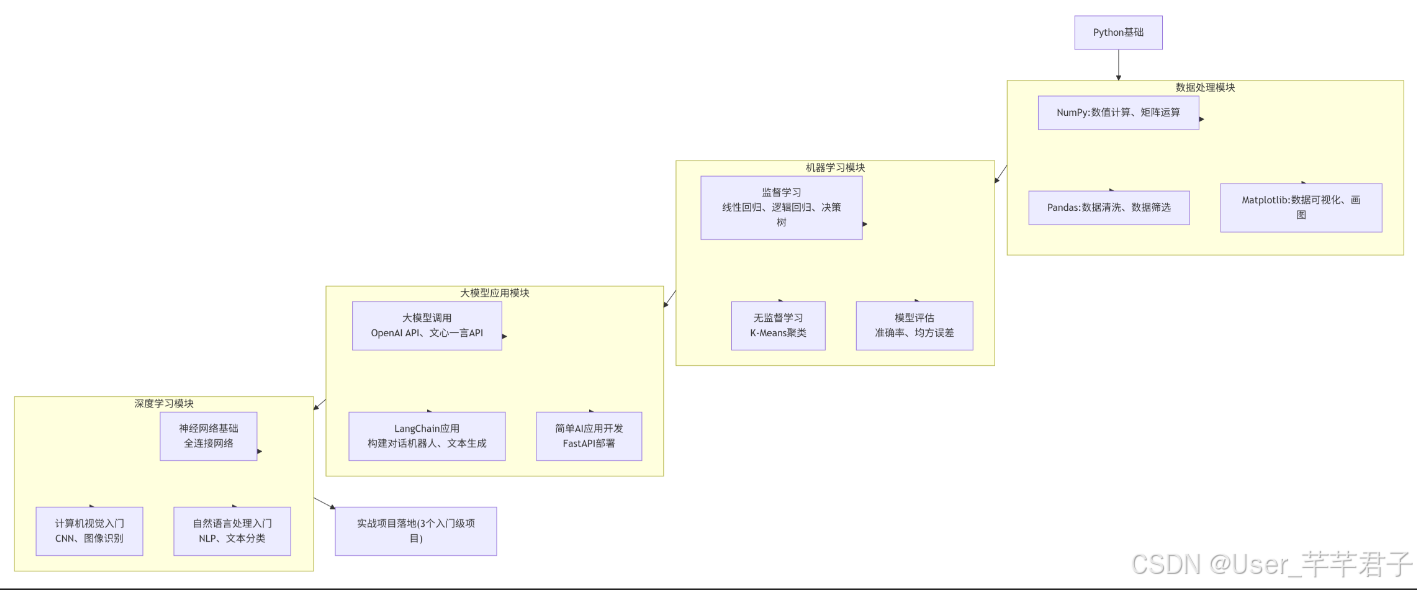
第一步:数据处理(占80%时间)
AI的本质是数据驱动。再好的模型,喂垃圾数据也出不来好结果。重点掌握三个库:
NumPy:处理数值数组。比如创建特征矩阵、计算均值:
import numpy as np X = np.array([[1, 2], [3, 4]]) print(np.mean(X, axis=0)) # 按列求均值Pandas:清洗表格数据。典型操作包括:
df = pd.DataFrame({"age": [25, None, 30], "income": [5000, 8000, 7000]}) df = df.dropna() # 删除缺失行 df["age_group"] = df["age"].apply(lambda x: "young" if x < 30 else "old")Matplotlib:可视化验证数据。比如画散点图看特征关系:
plt.scatter(df["age"], df["income"])
plt.xlabel("年龄"); plt.ylabel("收入")
plt.show()
第二步:机器学习(快速出成果)
用Scikit-learn,10行代码就能跑通一个模型。重点学三个经典算法:
线性回归(预测连续值)
比如预测房价:
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

# 准备数据
X = df[["area"]]; y = df["price"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)

# 训练+预测
model = LinearRegression()
model.fit(X_train, y_train)
print(f"预测150㎡房价: {model.predict([[150]])[0]:.2f}万")
逻辑回归(预测分类)
比如判断用户是否会购买:
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler

X = df[["age", "income"]]; y = df["purchase"]
X_scaled = StandardScaler().fit_transform(X)

model = LogisticRegression()
model.fit(X_scaled, y)
# 预测新用户
new_user = StandardScaler().transform([[28, 9000]])
print("会购买" if model.predict(new_user)[0] else "不会")
K-Means聚类(无监督分群)
比如给电商用户分组:
from sklearn.cluster import KMeans

X = df[["consumption", "frequency"]]
X_scaled = StandardScaler().fit_transform(X)

kmeans = KMeans(n_clusters=3)
df["cluster"] = kmeans.fit_predict(X_scaled)
第三步:大模型应用(2026年热点)
不用自己训模型,直接调用API。比如用LangChain+OpenAI做问答:
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate

llm = ChatOpenAI(api_key="your-key", model="gpt-4o")
prompt = ChatPromptTemplate.from_template("解释{topic}是什么")
chain = prompt | llm

response = chain.invoke({"topic": "线性回归"})
print(response.content)
三个可运行的入门项目
项目1:房价预测
模拟数据,训练线性回归模型:
import pandas as pd
from sklearn.linear_model import LinearRegression
import matplotlib.pyplot as plt

# 数据
data = pd.DataFrame({
    "area": [50,60,70,80,90,100,110,120],
    "price": [100,120,145,160,185,200,225,240]
})
X, y = data[["area"]], data["price"]

# 训练
model = LinearRegression()
model.fit(X, y)

# 可视化
plt.scatter(X, y)
plt.plot(X, model.predict(X), color="orange")
plt.show()

print(f"130㎡预测价格: {model.predict([[130]])[0]:.2f}万")
项目2:用户购买预测
基于年龄和收入预测行为:
import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler

data = pd.DataFrame({
    "age": [25,26,27,28,29,30,31,32],
    "income": [5000,6000,7500,8000,9000,10000,11000,12000],
    "purchase": [0,0,0,1,1,1,0,1]
})
X, y = data[["age","income"]], data["purchase"]

scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

model = LogisticRegression()
model.fit(X_scaled, y)

# 预测新用户
new = scaler.transform([[27, 7800]])
print("会购买" if model.predict(new)[0] else "不会")
项目3:用户分群
用K-Means划分消费群体:
import pandas as pd
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "consumption": [100,200,300,400,500,600,700,800],
    "frequency": [2,3,1,4,2,5,3,6]
})

scaler = StandardScaler()
X_scaled = scaler.fit_transform(data)

kmeans = KMeans(n_clusters=3)
data["cluster"] = kmeans.fit_predict(X_scaled)

plt.scatter(data["consumption"], data["frequency"], c=data["cluster"])
plt.xlabel("消费金额"); plt.ylabel("消费频率")
plt.show()
新手常踩的五个坑
- 等数学学完再动手:结果永远没开始。正确做法是边做项目边补知识。
- Python基础学太深:花一个月学装饰器,结果AI项目根本用不上。
- 一上来就啃深度学习:CNN、Transformer听起来酷,但入门门槛高。先掌握Scikit-learn更实际。
- 只看不练:视频看十遍不如代码敲一遍。每个知识点都要亲手运行。
- 忽视数据质量:花80%时间调参,却忽略数据清洗。记住:垃圾进,垃圾出。
推荐学习资源
- Python基础:B站“黑马程序员Python入门(AI专项)”,跳过GUI、网络编程等无关章节。
- 数据处理:Pandas官方10分钟教程,配合Kaggle的Titanic数据集练习。
- 机器学习:Scikit-learn官方文档的“User Guide”,案例代码可直接复制。
- 大模型应用:LangChain官方Quickstart,用免费API额度试玩。
最后提醒
2026年学AI,优势在于工具成熟、路径清晰。你不需要成为算法专家,也能做出有用的应用。关键是动手——今天装好环境,明天跑通第一个模型,一周后完成一个小项目。坚持下来,两个月足够入门。