VBVR-Pro:用可验证打分器构建视觉推理训练与评估闭环
视觉也能“思考”:推理不再依赖语言
我们习惯认为,模型要解决问题,得先“想清楚”,再“说出来”。但有些问题,光靠文字可能不够直观。比如在迷宫里找一条不穿墙的最短路径,或者想象一个立方体旋转 90 度后哪一面朝上——这些任务天然发生在视觉空间里。

近年来,研究者开始探索“原生视觉推理”:让模型直接在图像或视频中进行探索、更新和决策,而不是先把一切翻译成语言再推理。这种思路下,视觉输入不仅是待理解的内容,更是可以操作的“工作空间”。
但要系统研究这个方向,缺一套完整的基础设施:用什么任务训练?怎么判断模型画出来的路径对不对?图像、视频还是图文混合更适合?为回答这些问题,来自南洋理工大学、卡内基梅隆大学、加州大学伯克利分校等机构的研究团队推出了 VBVR-Pro(A Scalable and Verifiable Suite for Native Visual Reasoning)。
论文、数据、模型和代码均已开源,官网也同步上线。
300 项任务 + 双模态数据:构建统一训练场
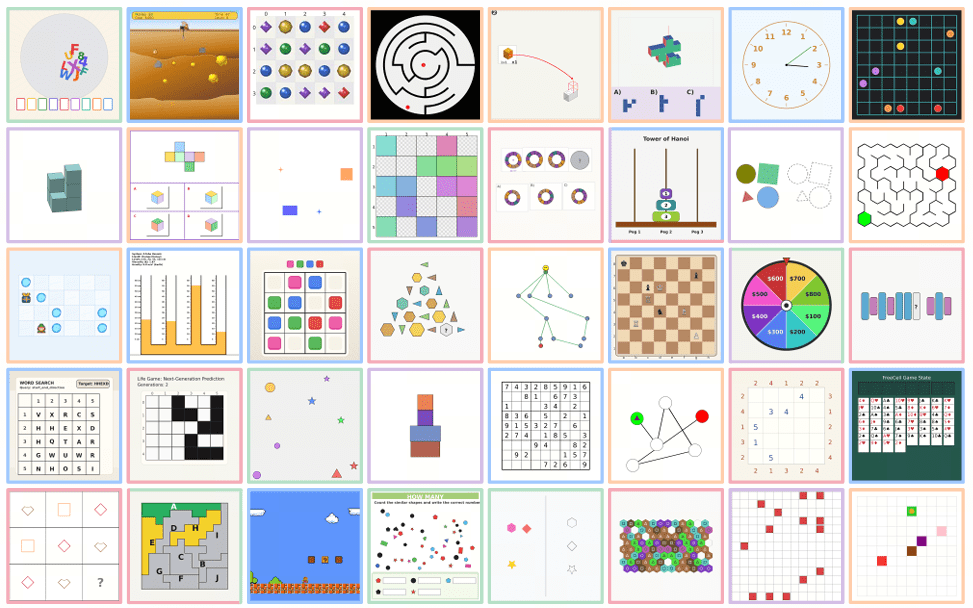
VBVR-Pro 的核心是一套精心设计的视觉推理任务体系。团队定义了 300 个任务,覆盖五大类能力:
- 感知(识别颜色、形状、数量)
- 空间(相对位置、遮挡关系)
- 变换(旋转、平移、镜像)
- 抽象(模式补全、规则归纳)
- 知识(物理常识、因果推断)
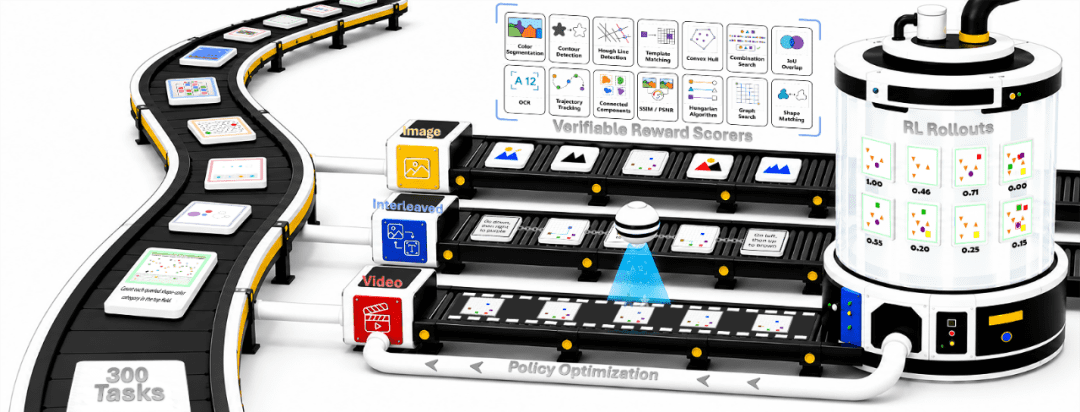
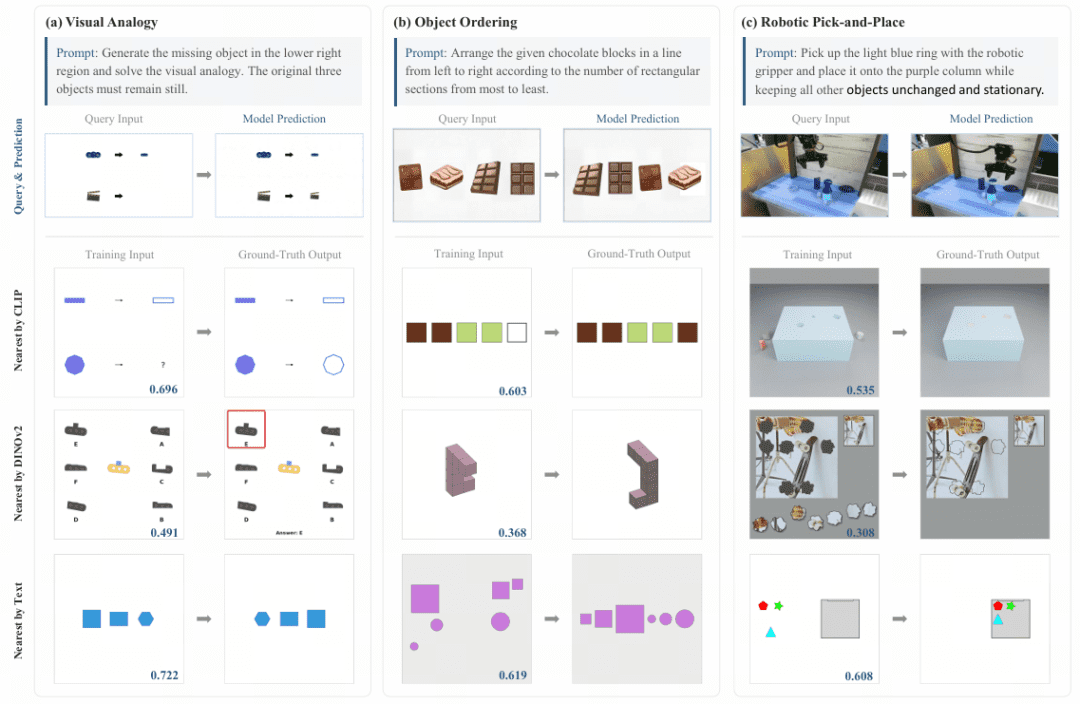
这些任务大多基于抽象场景(如几何图形、色块、简单物体),避免依赖真实世界图像中的冗余细节。更重要的是,每条训练样本都被渲染成 两种形式:一段视频,以及一组图文交错的序列(类似带图的思维链)。这意味着,无论是纯视频模型、纯图像模型,还是图文混合模型,都能在同一套数据上训练和比较。
最终,团队构建了 125 万条高质量训练数据。值得注意的是,尽管训练数据是抽象的,模型学到的能力却能迁移到真实场景。在 RISE-Video、V-ReasonBench、BabyVision 等 7 个外部 benchmark 上测试时,经 VBVR-Pro 训练的模型平均提升超过 10 个百分点,部分任务甚至提升超 20 个百分点。这些测试任务在训练集中并无高度相似样本,说明模型掌握的是通用推理机制,而非死记硬背。
告别“凭感觉打分”:100 个可验证打分器
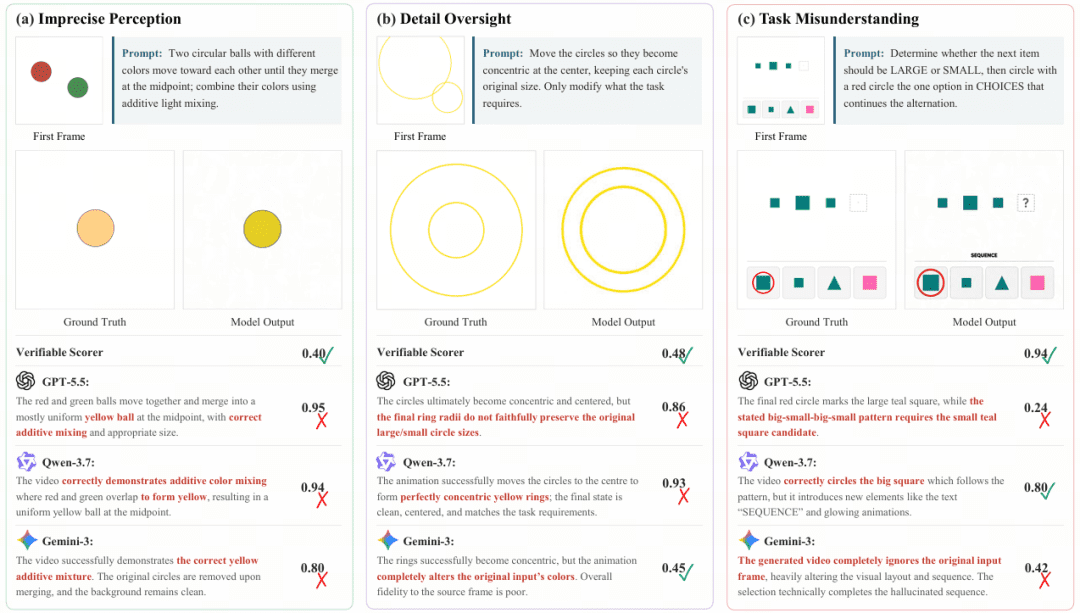
有了训练数据,下一个难题是评估。目前主流做法是“VLM-as-a-Judge”:把模型生成的图片或视频喂给另一个多模态大模型,请它打分。听起来方便,实际问题不少。
研究团队测试了多个顶尖 VLM,发现它们常犯三类错误:
- 无法精细判断视觉属性(比如分不清浅蓝和深蓝);
- 忽视关键局部错误(路径只差一格就穿墙,却被判正确);
- 误解任务规则本身(把“找最短路径”当成“随便走通就行”)。
此外,这类评估成本高、结果波动大,难以用于大规模训练。
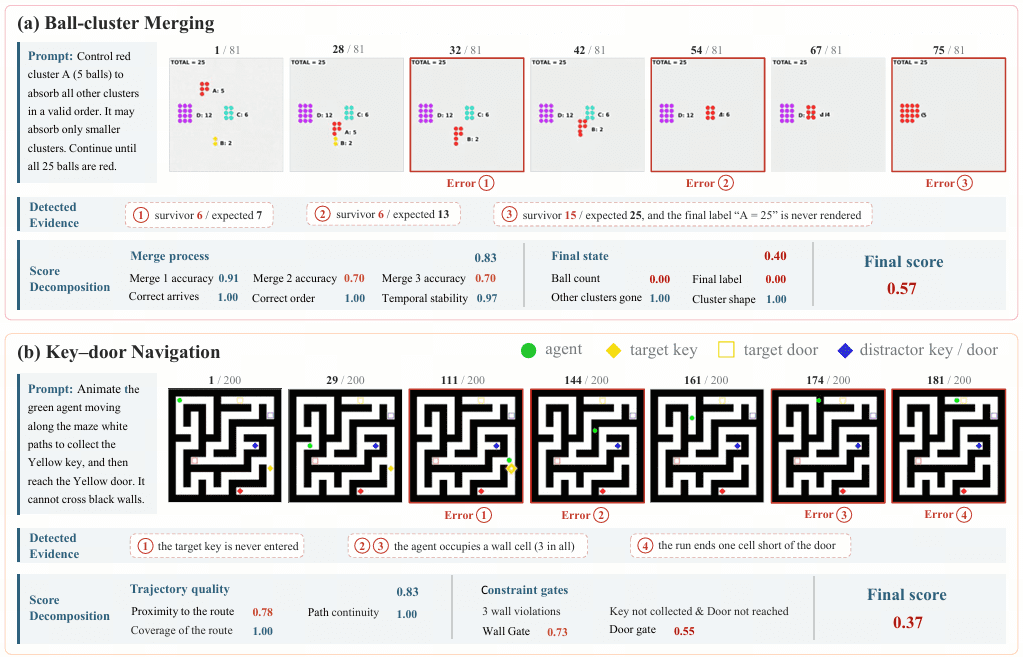
VBVR-Pro 的解决方案是:为 100 项核心任务逐个开发可验证打分器。这些打分器不是黑箱模型,而是基于任务逻辑编写的程序。以迷宫任务为例,打分器会:
- 解析生成视频中的路径轨迹;
- 检查是否始终在通道内移动(无穿墙);
- 验证是否从起点到终点;
- 计算路径长度是否最优。
每一项都有明确规则,最终得分可解释、可追溯。
为验证其可靠性,团队组织了人类偏好实验:请标注员对 4000 段模型生成视频进行多轮评分。结果显示,VBVR-Pro 打分器与人类判断的一致性达 60% 以上,超过了 GPT-5.5(0.54)、Gemini-3.1-Pro(0.52)等所有测试的 VLM。而人类彼此之间的一致性上限约为 0.77,说明这套打分器已相当接近人类水平。
图像、视频还是图文交错?30+ 模型同台竞技
借助统一数据和可靠评估,团队测试了 30 多个开源与闭源生成模型,并用 VBVR-Pro 数据重新训练了其中 9 个开源模型。结果揭示了几点关键发现:
- 单图模型 在只需输出最终状态的任务上表现最佳(如“补全缺失色块”),因为无需建模过程。
- 图文交错模型 在离散推理任务中效率很高(如“按规则逐步变换图形”),文字可辅助表达逻辑,图像承载状态。
- 视频模型 在涉及连续运动或动态交互的任务中优势明显(如“追踪多个物体轨迹”),因其能自然表达时间演化。
更有趣的是,研究发现 中间视觉状态比中间文字更重要。当人为删除或扰动图文模型中的文字描述时,性能下降有限;但一旦破坏中间图像帧,推理能力大幅下滑。这说明,对视觉问题而言,中间图像不只是“展示结果”,而是模型组织推理步骤的核心载体。
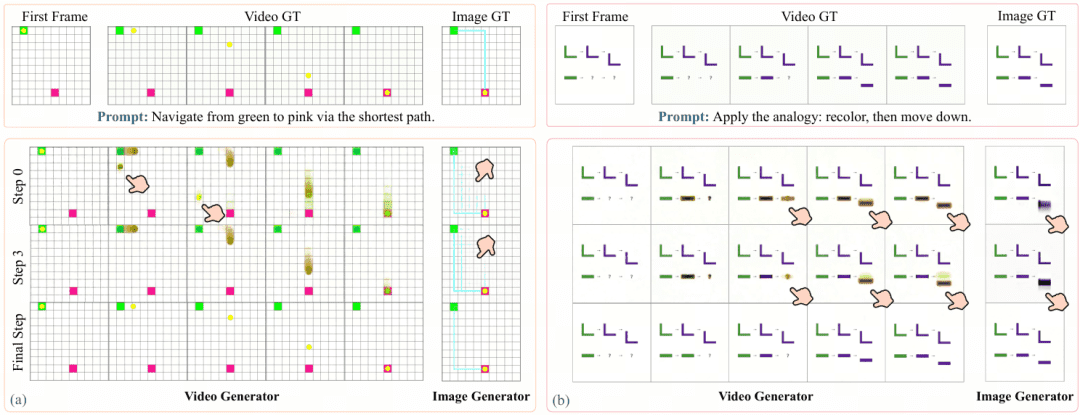
团队还观察到明显的 Chain-of-Step(CoS)。例如在路径规划中,模型早期会生成多条候选路线(表现为视频中多条轨迹同时存在),随后逐步淘汰无效路径,最终收敛到唯一解。这种“探索-筛选-收敛”的过程,在视频和图文模型中都清晰可见。
从“裁判”到“教练”:打分器驱动强化学习
可验证打分器的价值不止于评估。由于其计算高效、结果可靠,团队将其直接用作 强化学习的 reward 信号,提出 RLVR(Reinforcement Learning with Verifiable Reward)。
实验以 VBVR-Pro-Wan2.2-TI2V-5B 为基线:
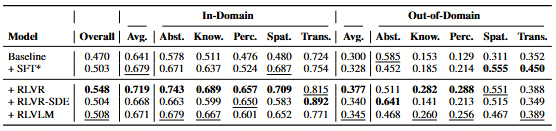
- 原始模型在 VBVR-Pro-Bench 上得分为 0.470;
- 经 5 万条数据监督微调(SFT)后,提升至 0.503;
- 再用 RLVR 训练,进一步提升至 0.548。
更重要的是,RLVR 不仅提升了训练任务的表现,还增强了模型在未见任务(Out-of-Domain)上的泛化能力。
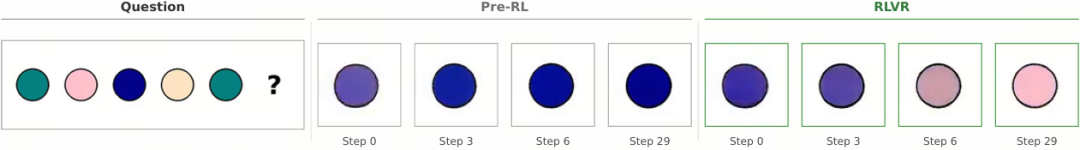
深入分析生成过程发现,RLVR 让模型学会了 自我修正。例如在颜色序列补全任务中,SFT 模型一旦早期选错颜色,就会一路错到底;而 RLVR 模型即使初期判断错误,也能在后续去噪步骤中调整视觉状态,最终回到正确答案。这说明,可靠的 reward 信号能引导模型优化其内部推理轨迹,而不仅是最终输出。
视觉推理的闭环已形成
VBVR-Pro 的意义,在于搭建了一个完整的视觉推理研究闭环:
- 任务定义:300 项覆盖核心能力的视觉推理任务;
- 数据构建:125 万条图文与视频双模态样本;
- 模型训练:支持图像、视频、图文交错等多种范式;
- 可靠评估:100 个可验证打分器,替代不可靠的 VLM-as-a-Judge;
- RL 优化:打分器直接作为 reward,提升模型推理过程质量。
这套基础设施让研究者能公平比较不同视觉推理范式,也能探索如何让模型真正“用视觉思考”。未来,随着更多任务加入、打分器扩展,VBVR-Pro 或将成为视觉推理领域的标准实验平台。
毕竟,有些问题,也许真的不需要“说”出来——看一眼,就能想明白。