Jev:专做判断题的AI模型,正成为Agent开发新宠
Jev 是什么?一个专做“判断题”的AI
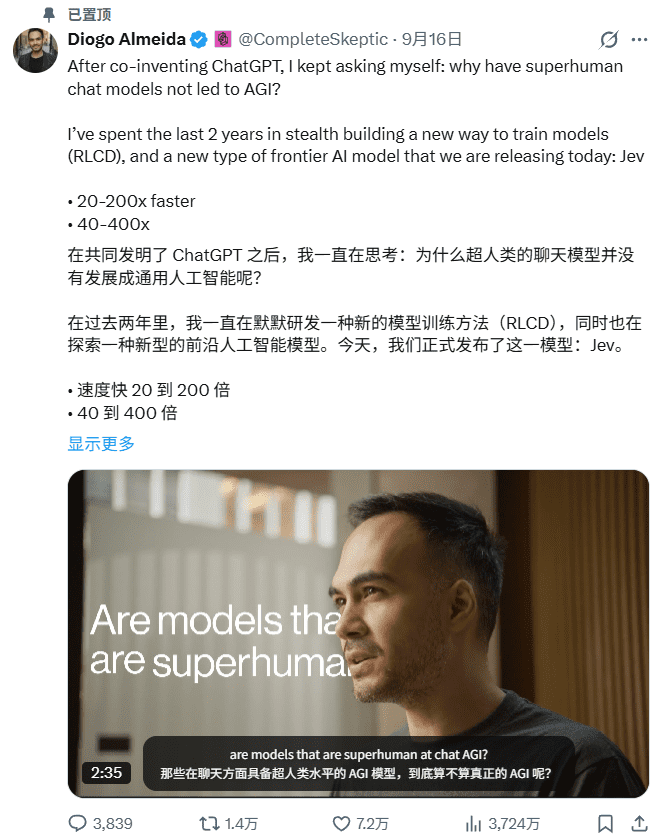
最近几天,一个叫 Jev 的 AI 模型在开发者社区突然火了。它不像 GPT 或 Claude 那样擅长写文章、编代码,而是专注干一件事:快速判断。

9月15日,初创公司 TypeSafe AI 正式发布 Jev,并给这类模型起了个新名字——“System One Models”。这个名字来自心理学家丹尼尔·卡尼曼在《思考,快与慢》中提出的“系统一”(System 1):快速、直觉、自动化的思维模式。Jev 的设计目标就是模拟这种能力——输入一段文本或程序状态,立刻输出结构化的判断结果和对应的置信度。
举个具体例子:假设你的客服系统收到一封用户邮件,你可以同时问 Jev 四个问题:
- 这是销售线索吗?
- 用户情绪是否激烈?
- 是否需要人工介入?
- 属于账单、技术还是销售问题?
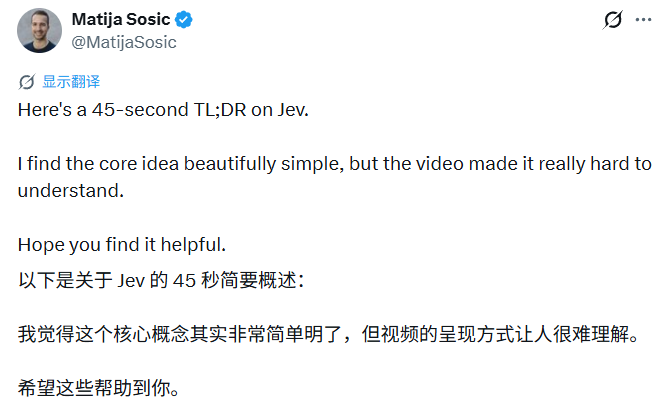
Jev 返回的可能是一组概率值:销售线索 0.91,需要人工介入 0.12,技术问题 0.83。你的程序可以立刻根据这些数字决定下一步流程——比如自动转给技术支持,同时标记为高价值线索。

这种“多问题并行判断 + 概率输出”的机制,让它特别适合嵌入到自动化流程中,尤其是当前火热的 AI Agent 开发。
为什么 Agent 开发者疯狂追捧 Jev?
今天的 AI Agent 往往要连续执行几十甚至上百个步骤:搜索网页、调用工具、修改文件、生成报告……但最难的往往不是“怎么做”,而是“做完了没?”、“结果对不对?”、“要不要继续?”。
这些问题本质上都是判断题。
过去,开发者通常让大模型自己判断任务是否完成,但这既慢又贵。而 Jev 的出现提供了一个轻量级替代方案:把 Agent 的执行记录(比如日志、输出内容、页面截图描述)喂给 Jev,直接问它:“目标达成了吗?”、“有没有遗漏关键步骤?”、“结果质量打几分?”。
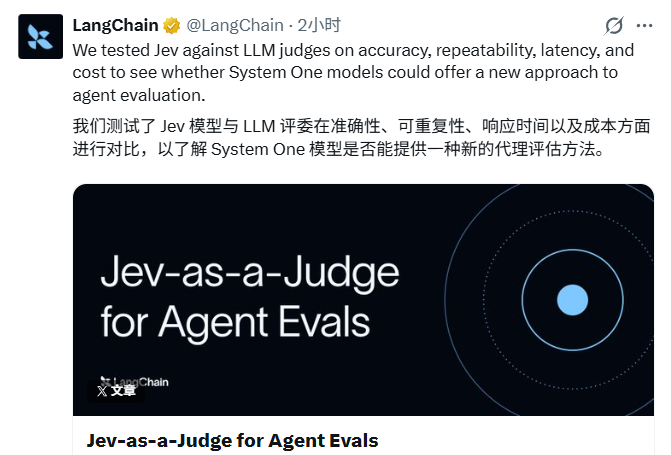
LangChain 在 9 月 20 日就发布了一项实验,测试 Jev 作为 Agent 评估器的表现。他们让 Jev、GPT-5.6 Luna、GPT-5.6 Terra 和 Claude Sonnet 4.6 对同一组 Agent 输出反复评分。初步结果显示,Jev 平均每次调用耗时约 0.44 秒,成本仅 0.00035 美元,在连续评分的一致性上表现突出。当然,LangChain 也强调这还只是小规模测试,真实生产环境的效果有待验证。
但即便如此,这个方向已经足够吸引人。因为当 Agent 每天要处理成千上万次任务时,哪怕每次判断省下几毫秒和几厘钱,累积起来也是巨大的效率提升。
实战案例:从广告分析到浏览器自动化
Jev 的热度不仅停留在理论讨论,实际应用已经遍地开花。
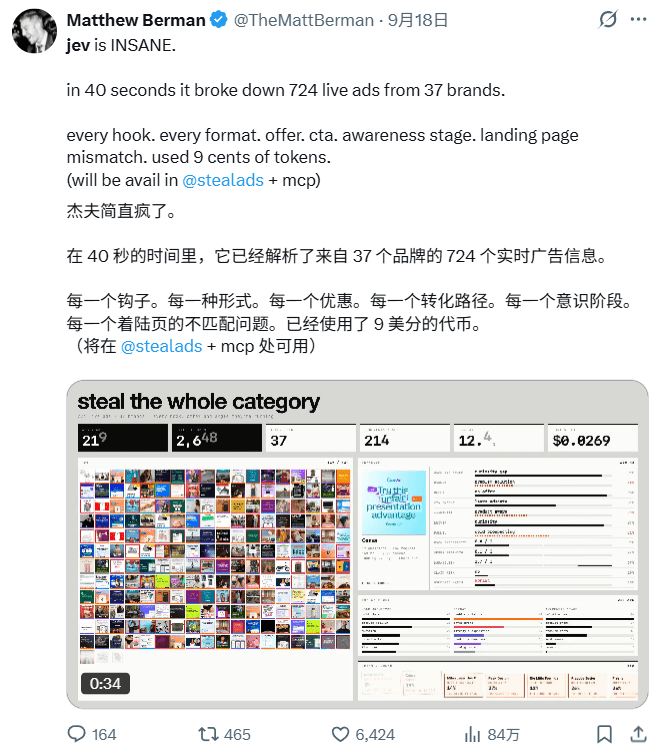
开发者 Matthew Berman 分享了一个广告分析案例:系统用 Jev 同时分析 37 个品牌的 724 条实时广告,对每条广告的 Hook(钩子)、形式、Offer(优惠)、CTA(行动号召)、用户认知阶段以及广告与落地页的一致性进行分类。整个过程产生了 8724 次独立判断,仅用 40 秒完成,总 Token 成本约 9 美分,平均每条广告处理时间 216 毫秒。这个案例很快被收录进 Jev 社区案例库。
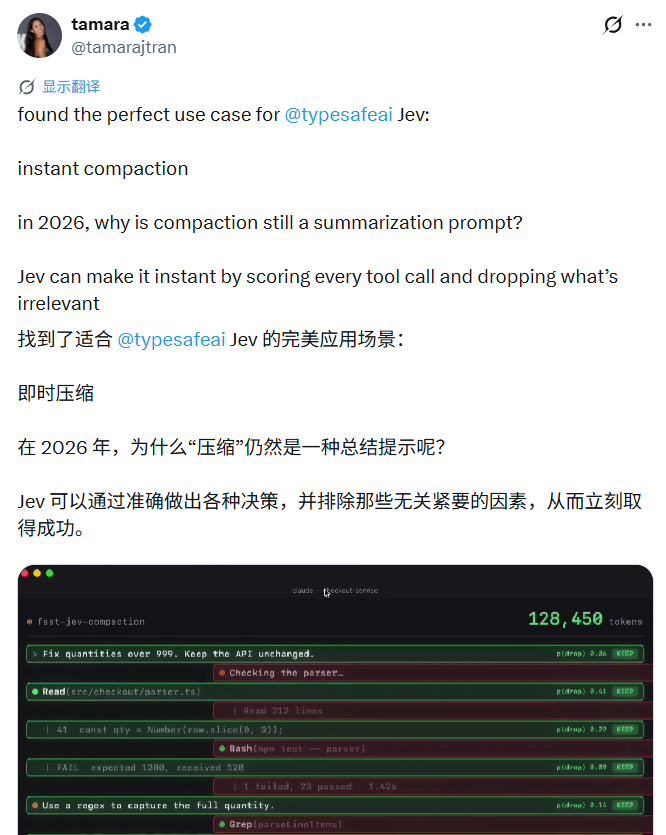
另一个热门项目叫 fast-jev-compaction,是一个 Claude Code 插件。它把大量工具调用记录和终端输出交给 Jev 评分,由 Jev 判断哪些内容仍与当前任务相关,再据此压缩发送给大模型的上下文。这能有效缓解长上下文带来的性能和成本压力。项目上线后迅速走红,GitHub 上出现了多个移植版本。
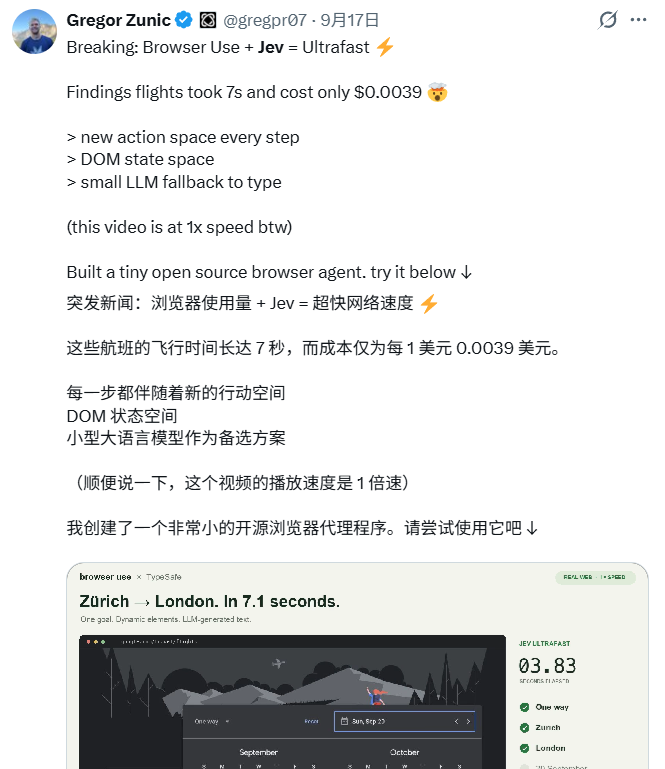
浏览器自动化也是 Jev 的试验田。已有多个开源项目采用“浏览器读取页面 → 生成候选动作 → Jev 选择动作 → 浏览器执行”的循环逻辑。在一个公开的航班搜索 Demo 中,整个流程耗时约 7 秒,成本仅 0.004 美元。开发者不再需要让大模型反复推理“该点哪个按钮”,而是由 Jev 快速裁决。
技术设计:Noul、Choice 和 Score
Jev 目前提供三种核心判断形式:
- Noul:处理 Yes/No 类问题,比如“这封邮件是否紧急?”
- Choice:从预设选项中选择答案,比如“用户意图属于哪一类:账单、技术、销售?”
- Score:按标准打分,比如“这段代码的可读性得几分(1-5)?”
每种判断都会附带置信度或概率值,而且多个问题可以围绕同一份输入同时进行。这种设计让它既能做二分类,也能处理多选和评分任务,灵活性很高。
TypeSafe 在内部 workflow benchmark 中宣称,Jev 在部分任务上最高实现 193.6 倍的速度提升和 444.6 倍的成本优势。不过公司也坦承,这些数据来自其模型能力团队制作的测试集,属于技术路线的高端参考值,实际收益会因场景而异。
命名背后的野心:杰文斯悖论
Jev 的名字并非随意取的。它来自 19 世纪经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)。他提出的“杰文斯悖论”指出:当一种资源的使用效率大幅提高,其总体消耗量反而可能激增。
比如蒸汽机效率提升后,煤炭消耗不降反升;LED 灯更省电,但人们装了更多灯,总用电量未必减少。
TypeSafe 显然想把这个逻辑套用到 AI 上:如果一次智能判断的成本降到几乎可以忽略,开发者就会在以前根本不会考虑用 AI 的地方加入判断逻辑。
一条系统日志是否重要?一封邮件属于什么类型?一个 Agent 是否真正完成了任务?一条广告处于用户决策的哪个阶段?一个网页上该点击哪个按钮?
这些看似微不足道的“小判断”,一旦被自动化,每天可能产生数百万次调用。而 Jev 想成为的,正是这些“智能 if 语句”背后的基础设施。
早期阶段,但方向明确
目前 Jev 仍处于 early access 阶段,API 访问需要申请。社区围绕它的实验才刚刚起步,主要集中在浏览器 Agent、代码辅助、广告分析、评估器和上下文管理这几个方向。
但它已经清晰地提出了一个问题:在未来的 AI 应用架构中,真正消耗最多算力的,可能不是那些宏大的生成任务,而是隐藏在软件流程中的成千上万个微小判断。
大模型负责“创造”,Jev 这类轻量判断模型负责“裁决”——这种分工或许会成为下一代智能系统的基础模式。
正如一位开发者在 X 上所说:“我们一直在教 AI 怎么做事,现在终于有人教它怎么判断事做得好不好了。”
Jev 能否成为这个新范式的起点?还得看接下来几个月社区的反馈和实际落地效果。但至少现在,它已经成功吸引了第一批尝鲜者,并给出了一个值得认真对待的技术路径。