TimechoAI时序大模型实操指南:从可视化分析到SDK集成
TimechoAI的两种使用路径
在工业现场,传感器每天产生大量连续时间序列数据,但真正用起来并不容易。传统方法要么依赖人工设阈值,要么需要专门的算法团队建模,成本高、周期长。TimechoAI提供了一套更轻量的解决方案——不用自己搭大模型环境,打开网页或调个接口就能做时序智能分析。
这套工具主要面向两类人:一是业务或运维人员,他们不需要写代码,通过可视化界面就能完成分析;二是开发工程师,可以把分析能力嵌入到自己的监控系统或数字孪生平台里。
可视化操作:零代码做时序分析
访问 https://ai.timecho.com 注册账号后,可以直接使用平台内置的测试数据集,比如电力负荷、轨道交通测点或期货价格数据。用户上传自己的CSV或TimechoDB导出的TsFile文件后,系统会自动识别时间戳和指标列。
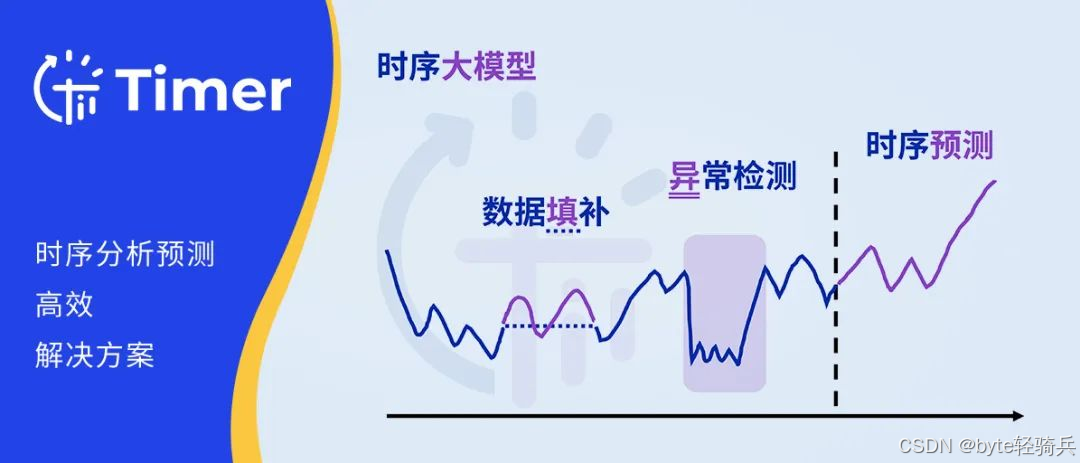
接下来,只需指定要预测的目标(比如“设备温度”),再选几个可能影响它的协变量(如“环境温度”“负载率”),设定预测未来多少个时间点,就能提交任务。平台支持三类常见任务:时序预测、异常检测和缺失值补全。
模型运行完成后,会输出趋势曲线、置信区间和一份数据质量报告。图表可以导出为图片,数值结果也能下载成CSV,方便后续汇报或对接其他系统。
开发者集成:Python SDK调用示例
如果企业已有自己的运维平台,想把时序智能能力嵌进去,可以用官方提供的Python SDK。安装很简单:
pip install timechoai-sdk然后在代码中初始化客户端,填入从控制台获取的API Key和Secret:
from timechoai import TimechoAIClient

client = TimechoAIClient(
    api_key="your_api_key",
    api_secret="your_api_secret",
    base_url="https://ai.timecho.com/api/v1"
)
加载本地数据后,配置任务参数。例如,预测设备温度未来48小时的变化,同时考虑负载和环境温度的影响:
data = client.load_ts_data(path="./sensor_data.csv")

task_config = {
    "target_col": "device_temp",
    "covariate_cols": ["load", "air_temp"],
    "predict_steps": 48,
    "task_type": "forecast"
}

res = client.run_task(data=data, params=task_config)
print("预测序列数据:", res["forecast_data"])
print("数据集综合评分:", res["quality_score"])
分析结果可以回写到TimechoDB,联动告警或大屏展示,形成完整的数据闭环。
TimechoDB与TimechoAI的协同架构
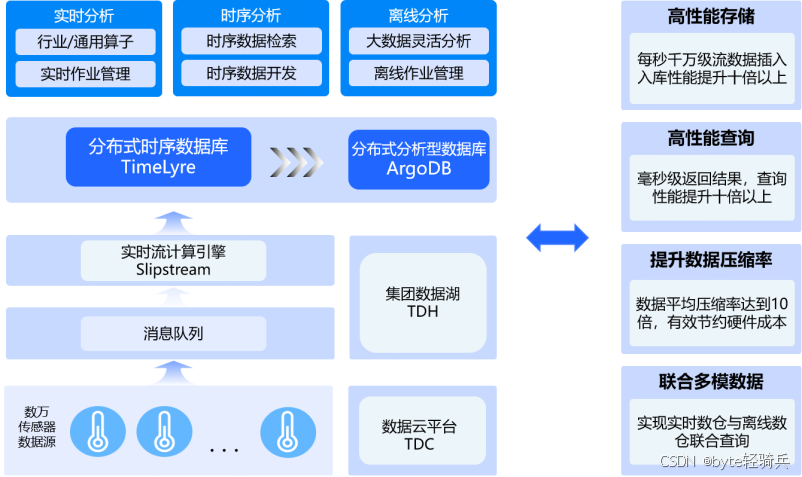
这套方案的核心在于存储与计算的深度打通。TimechoDB是专为时序数据设计的数据库,支持海量测点高效写入和压缩存储。它内置了AINode计算节点,与TimechoAI共享Timer大模型的底层框架。
典型工作流是这样的:设备数据先存入本地TimechoDB;云端利用历史数据训练大模型;训练好的轻量化模型再下发到边缘节点,实现低延迟的实时判断。这样既发挥了云端大数据建模的优势,又满足了现场对实时性的要求。
Timer-XL模型的四大技术能力
TimechoAI背后是Timer-XL时序大模型,基于Transformer架构做了专项优化,专门处理连续时间序列。它和传统ARIMA、LSTM等方法有明显区别,尤其在处理超长序列和多变量关联时表现更好。
多变量长周期预测
普通模型通常只能看几百个时间步的历史,而Timer-XL能读取数万个时间步的数据。这意味着它可以捕捉到设备老化、季节性负荷变化这类长期规律。比如在城轨车辆上,通过分析过去一年的振动、温度数据,模型能预判某个轴承是否会在下个月出现性能衰减。
预测时不仅输出一个点估计值,还会给出置信区间。这对调度决策很有帮助——比如电网负荷预测,知道“大概率在9000–10500兆瓦之间”比单纯说“10000兆瓦”更实用。
无监督异常识别
很多工厂还在用固定阈值做报警,一旦工况变化(比如换了一批原材料),误报就满天飞。Timer-XL采用无监督方式,只需要正常运行期间的数据就能建立基线模型。
它能识别三种异常:瞬时突变(如电压骤降)、缓慢退化(如电机效率逐渐下降)以及多指标耦合异常(如温度升高同时振动频率偏移)。系统会输出一个异常分数,并指出最可能出问题的维度,方便工程师快速定位。
缺失值智能修复
现场网络不稳定或设备重启常导致数据断档。传统插值法(如线性填充)在长时段缺失时效果很差。Timer大模型利用两个信息来修复:一是同一设备其他测点的关联性(比如温度和电流通常同步变化),二是历史同期的周期规律(比如每天早高峰负荷都会上升)。
在气象监测中,这种方法能有效修复因通信故障丢失的观测数据,提升中长期天气模型的输入质量。
自动特征挖掘与自然语言交互
对于高频波形数据(如振动、声学信号),手动提取特征很麻烦。Timer-XL内置了自动化工具,能计算上百种时序特征,包括周期性强度、波动幅度、自相关性等。
更特别的是,它支持用自然语言描述分析需求。比如输入“预测未来24小时主轴温度,考虑环境温度和转速的影响”,系统会自动解析意图,生成对应的分析任务和图表。这大大降低了非技术人员的使用门槛。
行业落地场景
这套技术已经在多个领域跑通了实际业务价值,不是纯概念演示。
在轨道交通领域,车辆每天产生TB级测点数据。通过TimechoAI做预测性维护,提前两周发现部件性能衰减趋势,避免突发故障。同时,只存储关键特征而非原始高频数据,节省了70%以上的服务器存储空间。
能源行业用它做两件事:一是短期负荷预测,误差比传统方法低15%以上;二是设备微小故障识别,比如通过分析变压器油温、绕组温度的细微偏差,提前发现绝缘老化迹象。
冶金厂的冶炼炉温度高达上千度,传感器容易漂移。系统通过多测点交叉验证和周期规律,自动修正异常读数,并在真正出现工艺偏差时发出预警,减少非计划停机。
金融量化团队则用它批量处理多年期货Tick数据,自动挖掘价格、成交量、持仓量之间的时序关联,辅助构建多因子模型。
气象部门面对全国上千个观测站,每天都有部分站点因通信问题丢数据。用Timer大模型批量修复后,中长期气候分析的输入完整性显著提升。
国产时序技术栈的价值
过去,企业做时序智能分析往往依赖国外闭源工具,不仅授权费用高,数据本地化也难保障。TimechoDB + TimechoAI组成了一套完整的国产方案,支持信创环境,既能云端试用,也能私有化部署。
对业务团队来说,网页端让运维人员自己就能挖数据,不用排队等算法工程师;对研发团队来说,SDK几行代码就能集成核心能力,省去了自建GPU集群和招专职AI人才的成本。
更重要的是,它盘活了企业长期积累但一直“沉睡”的时序数据。这些数据不再只是存在库里占空间,而是变成了可行动的洞察——无论是优化设备维护计划、提升资源调度效率,还是加强风险监测能力。
目前,TimechoDB和TimechoAI都开放了在线试用。技术人员可以先用测试数据跑几个任务,看看预测准不准、异常检出是否合理,再决定是否引入到生产环境中。