LLM Agent 能力该放模型内还是外部?北航等机构提出内化与外化统一框架
模型和外部系统,能力该放哪边?
一个本可以靠已有知识直接回答的问题,智能体却反复搜索网页、调用多个工具,最后虽然答对了,但花了更多时间和费用。另一种情况是,问题需要最新数据,智能体却一直在内部推理,最终给出一段流畅但过时甚至错误的答案。
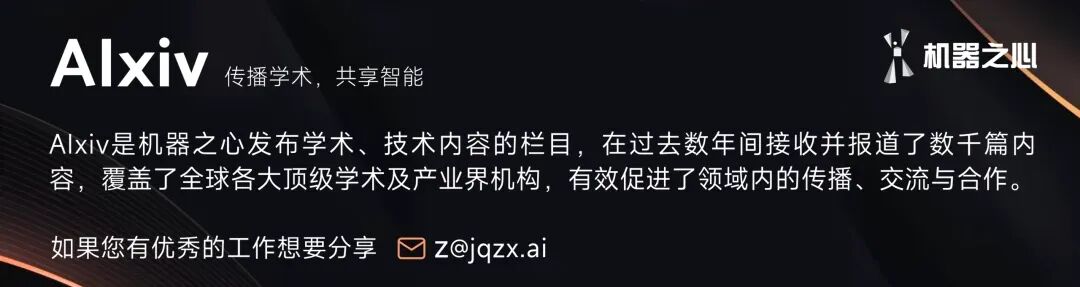
前者叫过度行动(overacting),后者常同时包含过度思考(overthinking)和行动不足(underacting)。这类失误的核心,是智能体没搞清楚自己的能力边界:哪些问题能靠模型内部解决,哪些必须求助外部世界。
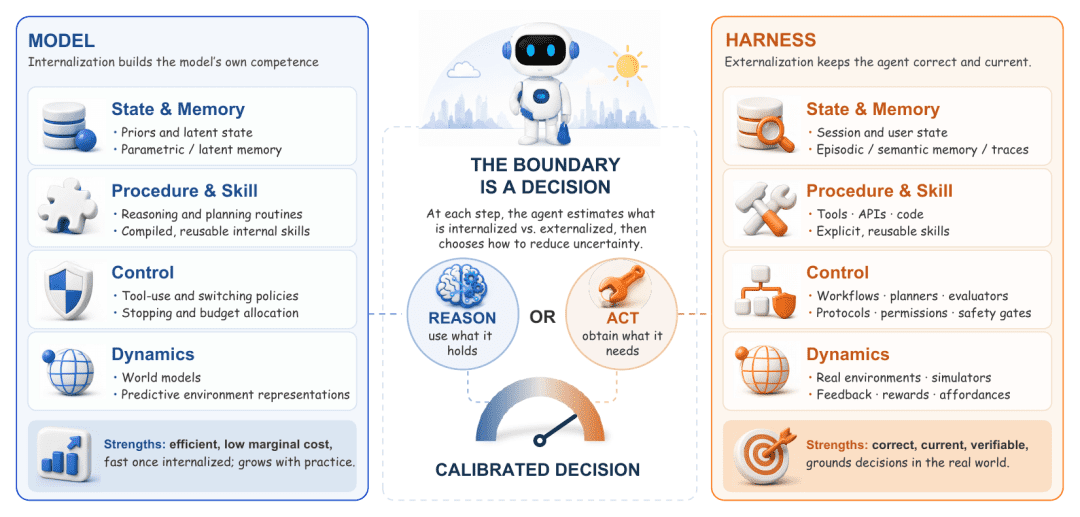
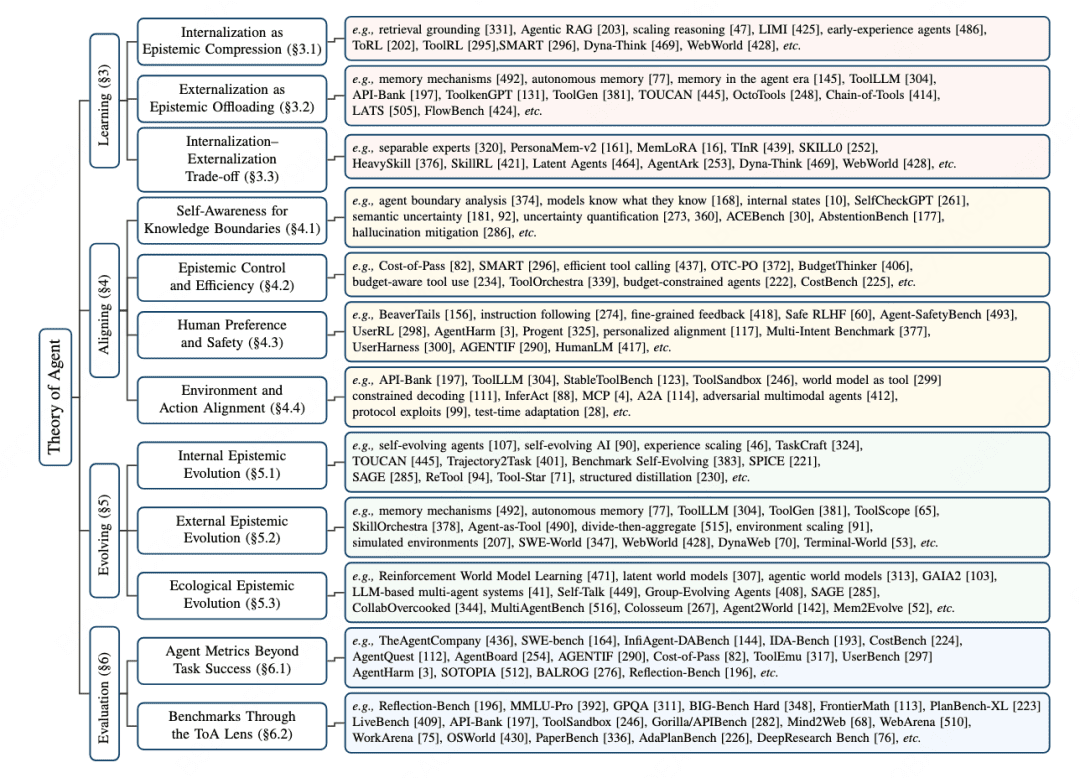
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等8家机构的19位研究者在《Theory of Agent: The Science of Internalization and Externalization for LLM-based Agents》这篇综述中,提出用内化(internalization)与外化(externalization)这一统一视角,重新审视大模型智能体的设计逻辑。
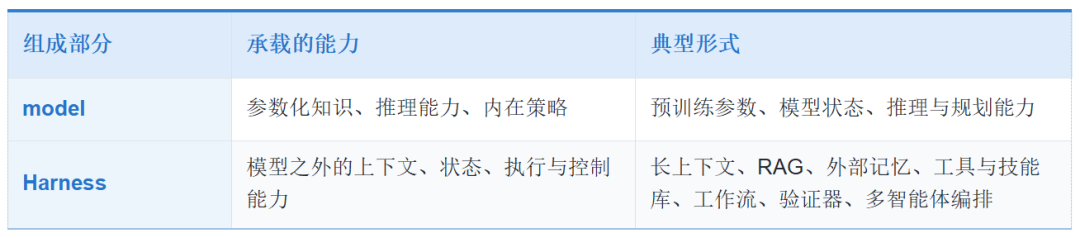
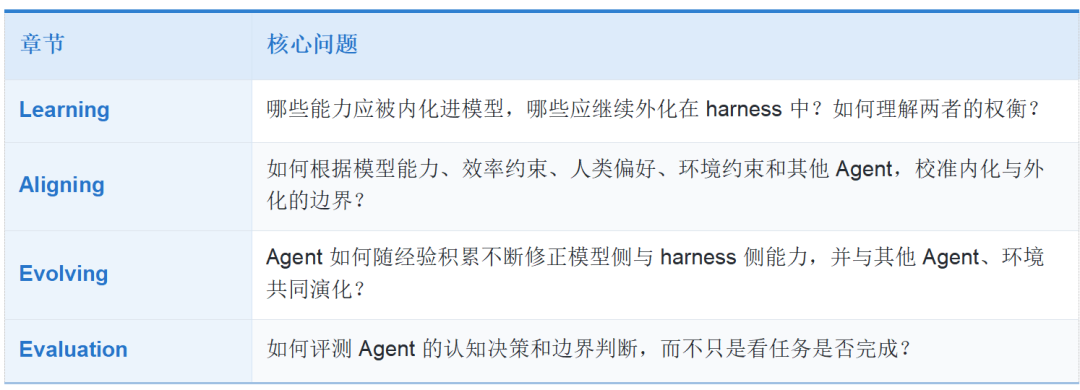
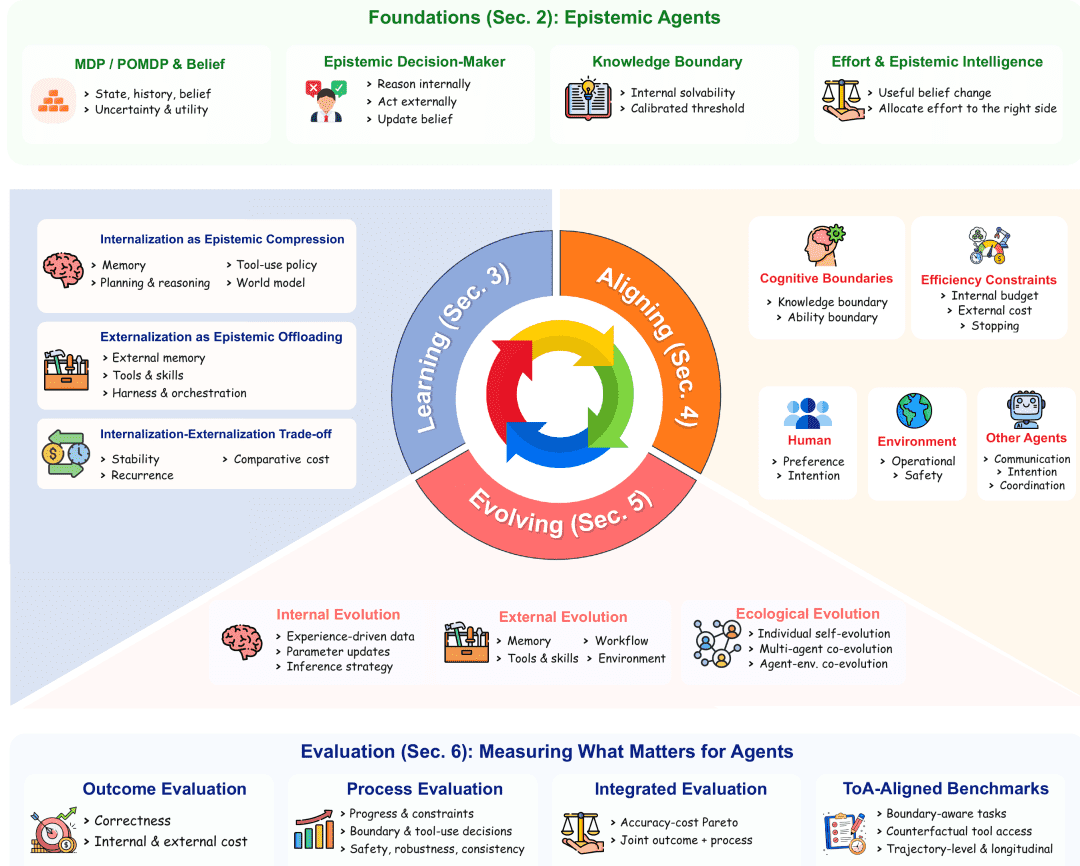
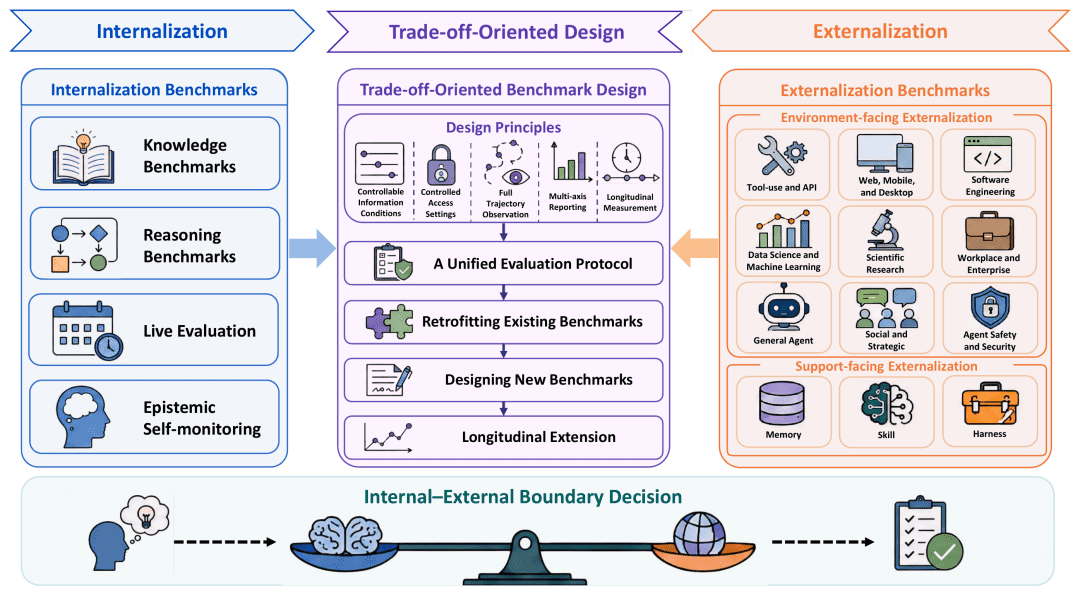
他们分析了约600项近期研究,覆盖智能体的学习、对齐、演化与评测全过程,核心观点很直接:能力配置不是非此即彼,而是要根据任务特性、信息时效性和治理需求,在模型参数和外部harness之间动态划分边界。
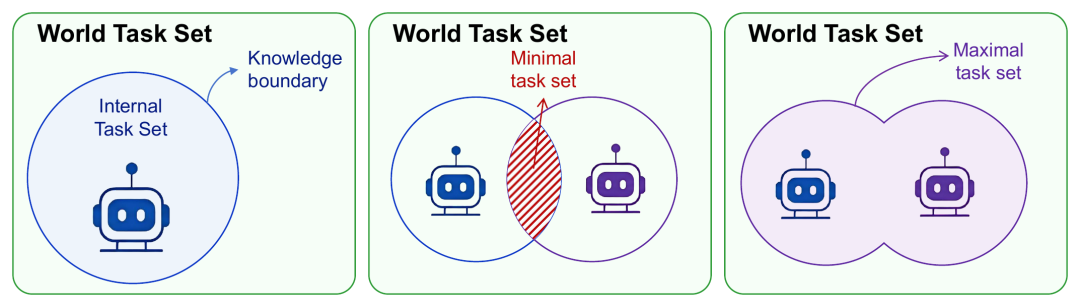
内部任务集 vs. 世界任务集
论文定义了两个关键概念:
- 内部任务集:当前智能体仅靠内部推理就能可靠完成的任务;
- 世界任务集:在允许适当外部交互的前提下,原则上可在环境中完成的任务。
两者之间的分界线,就是智能体的知识边界(knowledge boundary)。这个边界不是固定的——不同模型的能力不同,同一模型在不同上下文、可用工具或训练阶段下,边界也会变化。
比如,一个经过金融领域微调的模型,可能在财报分析任务上拥有更大的内部任务集;但面对“今天某股票收盘价是多少”这种问题,无论模型多强,都必须依赖外部数据源。
工具的可用性和必要性要分开看。任务落在内部任务集时,调用工具可能提升鲁棒性,但并非必需;一旦任务超出内部能力,外部行动就具有认知必要性——这时候不调用工具,反而是一种失误。
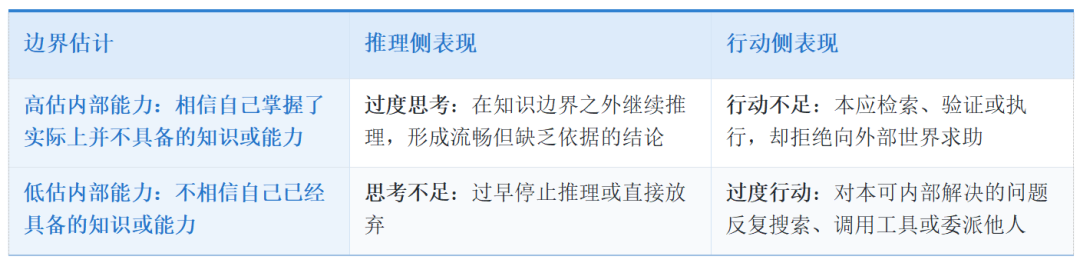
四种典型失误,都源于边界误判
论文从两个维度解释常见失败:
- 能力估计偏差:高估或低估自身能力;
- 行为表现失准:在推理侧或行动侧投入不当。
组合起来就是四种情况:
- 过度思考:内部能力其实足够,却继续冗长推理;
- 思考不足:内部能力不足,却拒绝调用工具;
- 过度行动:内部已能解决,仍频繁调用外部资源;
- 行动不足:需要外部信息,却迟迟不采取行动。
值得注意的是,工具调用次数或推理长度本身不能说明问题好坏。关键在于是否匹配任务需求和成本约束。一个复杂科研任务调用十次工具可能是合理的,而一个简单事实查询调用一次就算浪费。
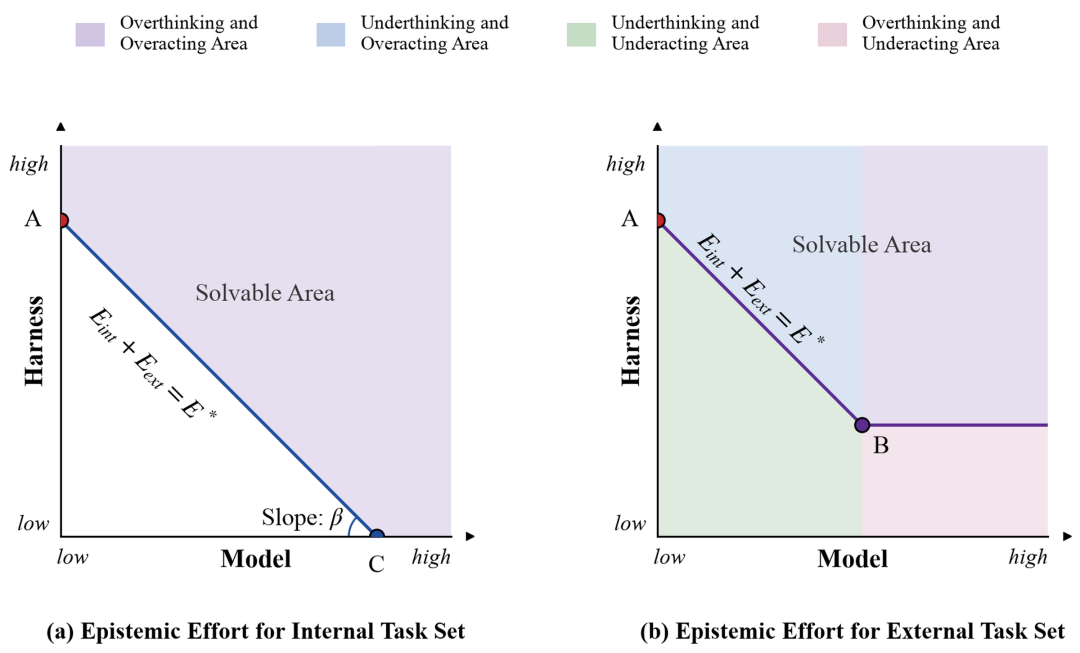
认知努力的合理分配
论文将完成任务所需的认知努力分解为两部分:
- 内部成本(C_in):如推理token数、思维链长度、内部模拟深度;
- 外部成本(C_out):如API调用费用、网络延迟、权限暴露风险、不可逆副作用。
理想情况下,智能体应在给定任务下找到使总成本最小、信息增益最大的操作点(operating point)。偏离这个点,就会出现上述四类失准行为。
为此,作者提出用认知智能比率(epistemic intelligence ratio, η)来衡量效率:
η = ΔU / (C_in + C_out)
其中ΔU代表有助于下游决策的不确定性减少量。在四类失准中,分母(成本)持续增加,但分子(有用信息)并未同步增长,导致η下降。
不过,η只是可观测指标,真正的认知智能还包括:识别自身边界、合理分配内外努力、在无解时主动拒绝,以及通过学习扩大内部能力。
学习阶段:什么该放进模型,什么该留在外面?
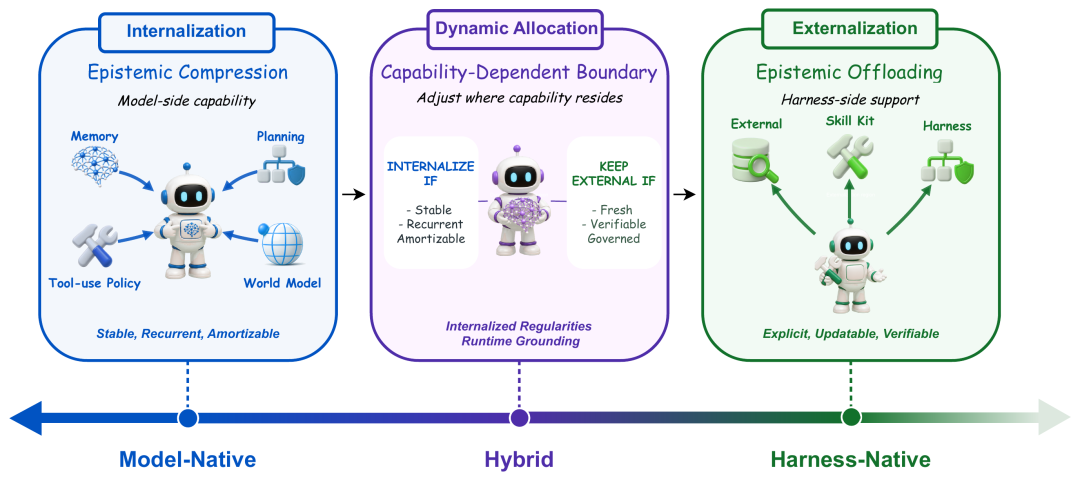
在训练和部署过程中,开发者需要决定哪些能力通过学习进入模型参数,哪些由外部系统提供。论文建议从六个维度权衡:
- 稳定性:是否长期不变;
- 复现频率:是否高频重复;
- 摊销价值:训练一次能否在大量任务中降低成本;
- 新鲜度:是否必须实时更新;
- 可验证性与可回滚性:是否需要保留来源、支持审计和撤销;
- 用户控制与安全治理:是否应允许用户编辑或受外部权限约束。
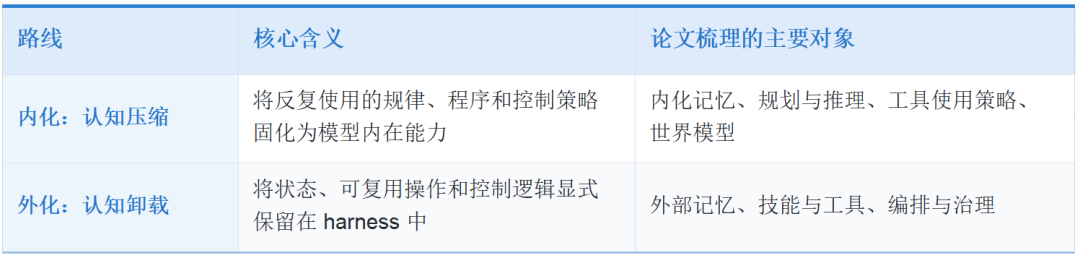
据此,长期稳定、高频复现、有摊销价值的规律适合内化;实时变化、高风险或需审计的操作适合外化。
内化的四种形式
- 内化记忆:将用户习惯、任务模式等高频经验逐步融入模型状态、适配器或参数;
- 内化规划与推理:把临时生成的任务分解、反思、验证等过程,转化为稳定的程序性能力;
- 内化工具使用策略:不仅学调用格式,更学何时调、选哪个、怎么构造参数、如何响应结果;
- 内化世界模型:通过学习环境动力学,在执行前进行内部模拟,减少昂贵试错。
外化的三类支持
- 外部记忆:管理不断变化的状态、历史和证据,支持写入、检索、合并、遗忘;
- 外部技能:将流程封装为可检查、可复用、可组合的操作单元;
- 外部编排:把控制流、权限、验证、回滚、多智能体协作等放在harness中,确保过程可观察、可恢复、可治理。
实践中,多数系统采用混合配置:模型内化通用策略,harness提供实时证据、执行接口和安全边界。
对齐:不只是输出合规,更是决策合理
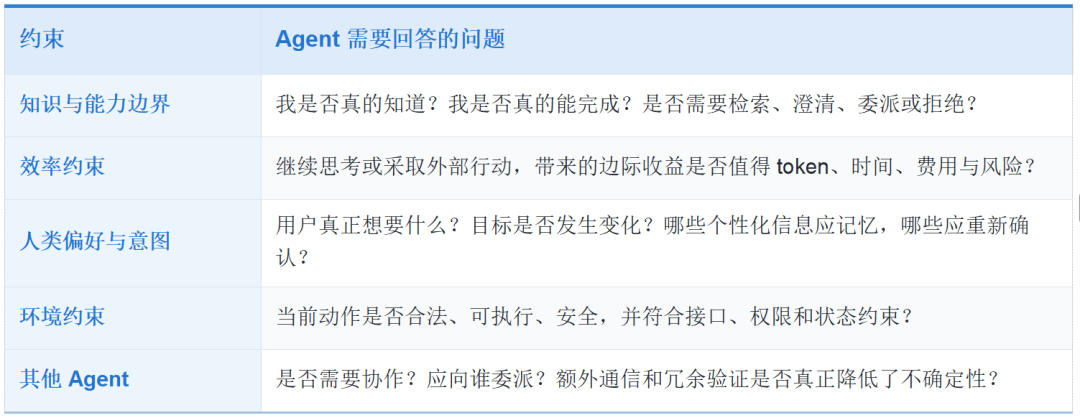
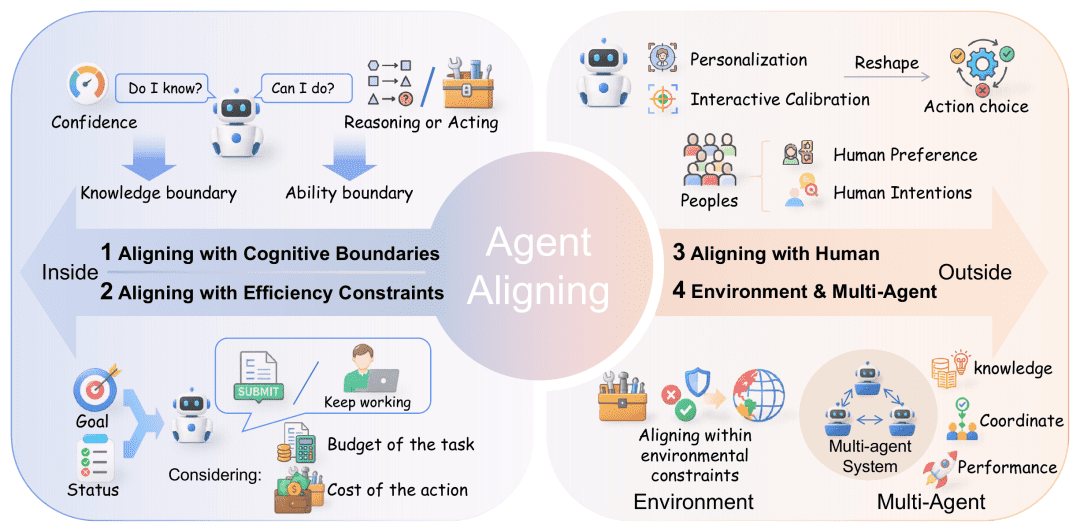
传统大模型对齐关注输出是否符合人类偏好。但智能体进入真实环境后,还需对齐一系列中间决策:是否检索、调用工具、执行动作、协作、停止。
论文将这些决策纳入五类约束框架:
- 内部约束:认知边界、效率;
- 外部约束:人类意图、环境规则、多智能体系统。
具体要求包括:
- 不确定性估计必须指导行为:分数只有能驱动“回答/检索/澄清/验证/拒绝”才有意义;
- 工具路由需区分可用性与必要性:随模型能力、任务状态动态调整;
- 个性化信息分类处理:稳定低风险偏好可内化,敏感或易变信息应保留在可审计外部记忆;
- 安全检查覆盖整条轨迹:单看最终输出无法判断过程是否安全;
- 多智能体协作核算边际价值:新增角色或通信的成本应低于其带来的信息增益。
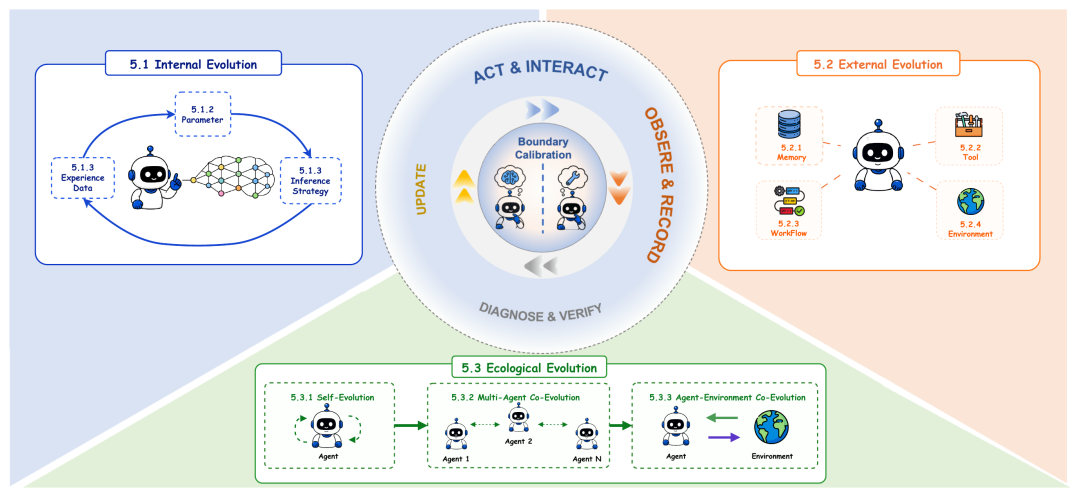
演化:通过经验降低未来成本
智能体上线后会持续积累经验,这些反馈可推动三个层次的演化:
- 内部演化:将高频外部工作流蒸馏为模型内部程序,摊销后续成本;
- 外部演化:优化harness中的记忆检索、技能库、编排逻辑;
- 生态演化:利用群体与环境反馈,调整任务难度和协作策略。
有效演化的标志是:长期降低有用信息获取成本、提高可靠性、改善边界判断。例如:
- 将反复使用的工具调用序列固化为内部子程序;
- 压缩膨胀的记忆库,提升关键证据召回率;
- 只在需要专业分工时才启动多智能体协作;
- 让环境根据当前能力生成适配任务,逐步扩大内部任务集。
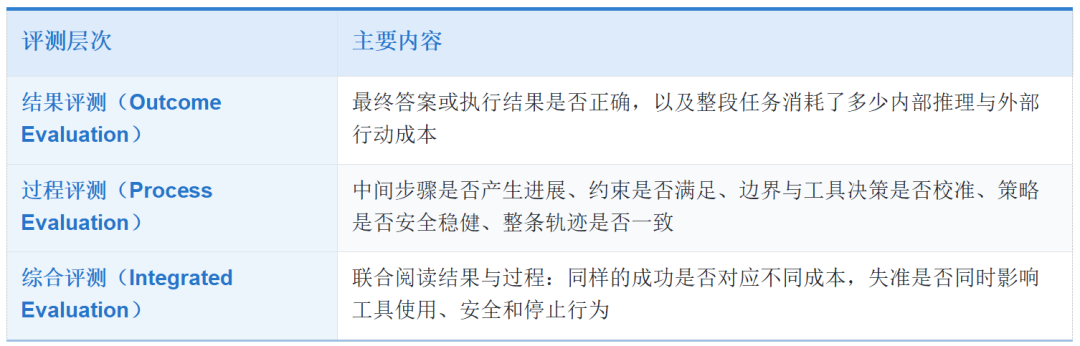
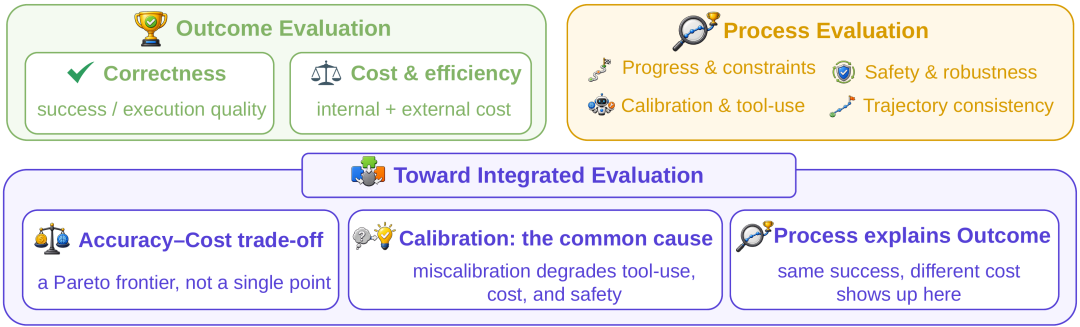
评测:不能只看结果对不对
两个智能体都答对了问题,一个只做必要推理加一次验证,另一个调用十几个工具、经历多轮无效循环、中途还执行高风险操作。如果只看成功率,两者得分相同;但部署时,成本、风险、过程质量同样重要。
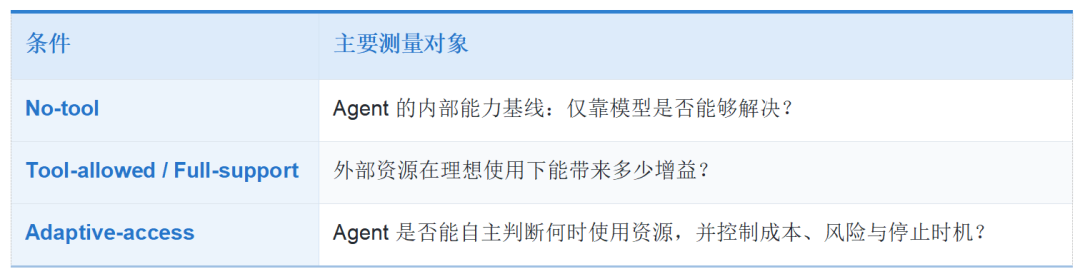
论文主张结合结果评测与过程评测,并提出反事实评测协议:对同一任务设置三种访问条件:
- No-tool:禁止任何外部调用;
- Fixed-access:提供固定工具集;
- Adaptive-access:允许智能体自主决定是否调用。
通过对比这三种条件下的表现,可诊断边界决策问题:
- No-tool已成功,但Adaptive仍大量调用 → 过度行动;
- No-tool失败,Adaptive拒绝求助 → 行动不足或过度思考;
- 工具返回错误信息时能否验证并拒绝盲从;
- 外部行动虽提升成功率但带来安全风险时,是否知道停止。
作者认为,下一代基准测试需满足五项要求:
- 可控的信息条件:明确决定性证据位于模型、上下文、记忆还是外部;
- 可控的访问条件:支持无工具、固定支持、自适应支持的对比;
- 完整轨迹观测:记录推理、检索、工具调用、验证、委派、停止等操作;
- 多轴报告:同时呈现成功率、边界错误、内外成本、安全、验证质量;
- 纵向测量:观察经验积累后,是否减少冗余调用、改善停止决策、选择性内化能力。
开放问题与总结
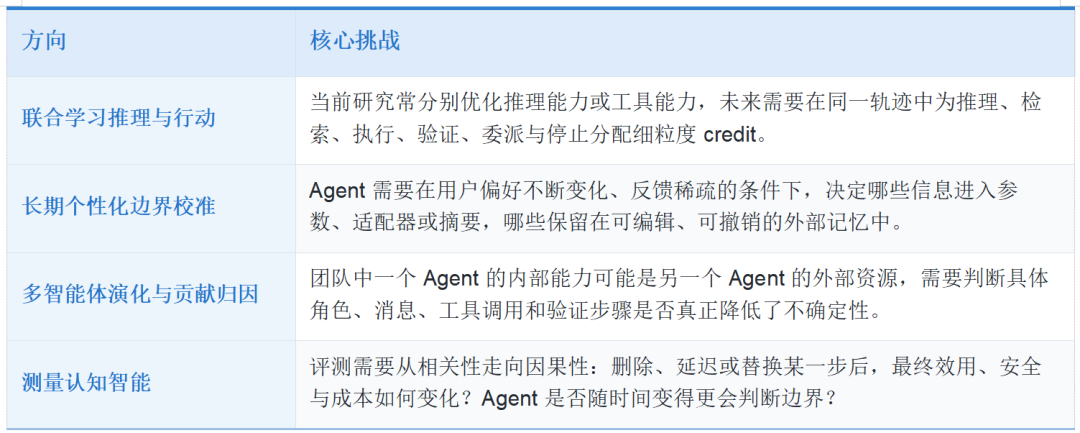
论文最后指出四个待解方向:
- 如何形式化建模知识边界的动态演化;
- 如何设计支持选择性内化的训练机制;
- 如何构建覆盖多轴指标的标准化评测体系;
- 如何在多智能体生态中协调个体与群体的内外化策略。
总的来说,这套框架没有预设“内化优于外化”或反之。是否调用工具,取决于任务是否需要;是否继续思考,取决于剩余不确定性能否在内部消解;经验是否进入参数,取决于稳定性、复用价值和治理需求。
智能体的终极目标不是“全能”,而是在给定约束下,以最低成本做出最可靠决策。而实现这一点,首先要学会判断:这件事,我到底能不能自己搞定?