T-Mem:让大模型记住“小张海鲜过敏”并在团建时主动提醒
当“团建去哪儿”遇上“小张海鲜过敏”
你跟 AI 助手聊过一次:“小张海鲜过敏,上周都吃进医院了。”几个月后,你问它:“下周团建我们去哪儿呢?”
这两句话,字面上毫无重叠,语义上也看不出直接联系。但一个真正懂你的 AI,应该能在这时候说一句:“要不别去海边?小张可吃不了海鲜。”
问题在于,今天的长期记忆系统几乎都做不到这一点。它们依赖一个根深蒂固的假设:只要查询和记忆足够“像”,记忆就能被召回。这个逻辑在问答式交互中勉强够用——比如你问“小张对什么过敏”,系统能从历史记录里找出原话。但一旦进入长期陪伴场景,用户不会重复提问,话题会跳跃,措辞会变化,记忆就容易“失联”。
这不是某个模型没调好参数,而是整个技术路线的结构性盲区。认知科学早就指出,人类回忆过去,往往不是为了存档,而是为了预演未来。这种能力叫“情景未来思维”(episodic future thinking)——我们记住一件事,是因为预感到它会在某个未来场景中派上用场。
T-Mem 的核心思想,就是把这种人类机制工程化:让记忆在写下的那一刻,就准备好“将来会被怎样想起”。
相似度检索的局限:看不见的语义线
当前主流的记忆系统,无论底层用向量数据库、图数据库还是其他结构,在检索环节几乎都走同一条路:计算当前查询与历史记忆的相似度,挑出最接近的几条。
这套方法在表面相似的场景下有效。比如你问“上次提到的小张怎么了”,系统能轻松召回“小张海鲜过敏”的记录。但一旦问题换了个说法,比如“团建选餐厅要注意什么”,相似度就断了。
关键在于,真实对话中的关联往往是潜在的、因果的、叙事性的,而非词汇或句法层面的。团建聚餐 → 餐厅选择 → 过敏忌口 → 小张不能吃海鲜,这条推理链里没有重复词,也没有语义嵌入能直接拉近“团建”和“海鲜过敏”的距离。
论文把这种靠潜在关联想起旧事的能力称为“联想性回忆”(associative recall)。而现有系统几乎只支持“描述性回忆”(descriptive recall)——即靠表面特征匹配。
T-Mem 的解法:提前为“联想”铺路
T-Mem 的做法很直接:既然检索时找不到相似点,那就别等到检索时再找。在记忆写入的那一刻,就为它预设一组未来可能触发它的场景线索,论文里叫 triggers。
回到“小张海鲜过敏”的例子。当这句话被存入记忆库时,T-Mem 会多做一步:推测这条信息将来可能在哪些情境下被用到。比如:
- 大家讨论聚餐吃什么的时候
- 组织团建活动选地点的时候
- 填写健康调查表统计过敏史的时候
这些推测出的场景,会被编码成“联想线索”并和原始记忆绑定。后续哪怕用户问的是“团建去哪儿”,系统也能通过匹配“团建选地点”这个预设线索,间接召回“小张海鲜过敏”的事实。
你可能会担心:每条记忆都生成一堆线索,会不会爆炸?T-Mem 在工程上做了收敛处理——线索之间会去重、合并,并随对话进展增量更新,确保开销可控。
四象限模型:填满被忽略的半边天
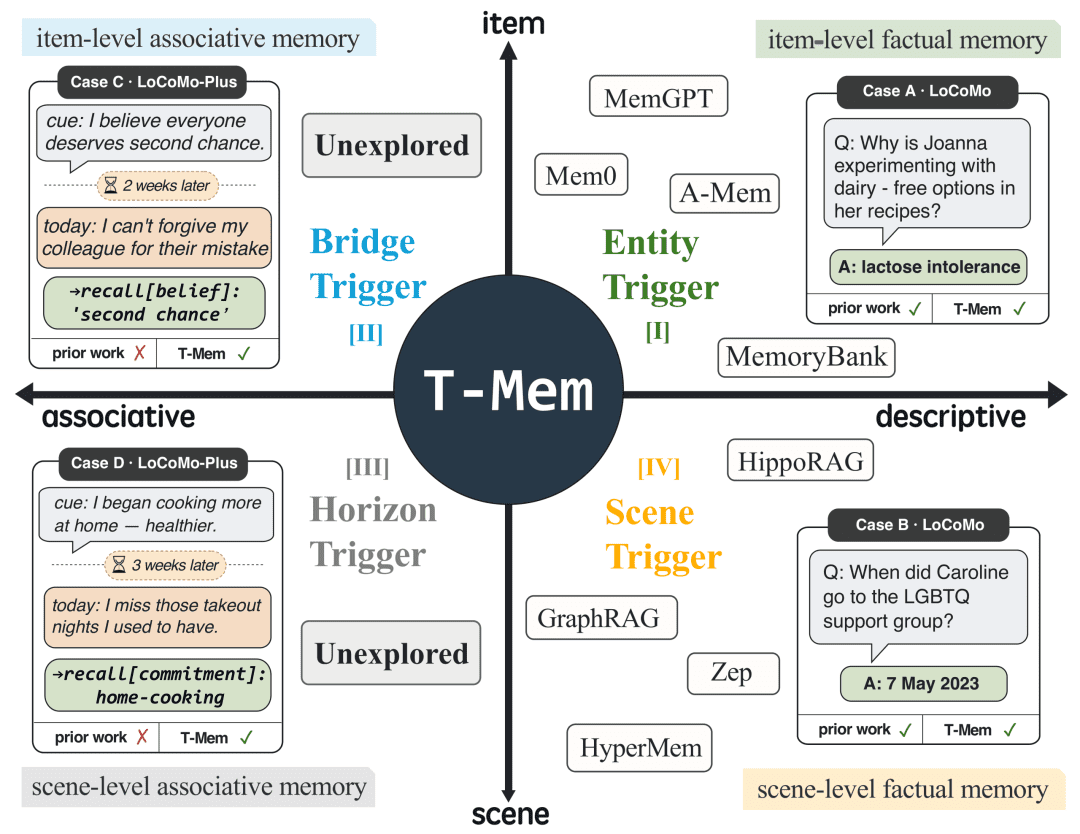
T-Mem 用一张 2×2 象限图清晰划分了记忆能力的空间:
- 方向轴:描述性回忆 vs 联想性回忆
- 粒度轴:单条事实 vs 完整场景
主流系统几乎全挤在“描述”这一侧。无论是给句子打向量,还是构建知识图谱,最终检索都依赖“像不像”。而“联想”那一侧长期空白,因为没人解决“不像但相关”怎么找的问题。
T-Mem 则为四个象限分别设计了触发机制:
- QI(实体触发):给单条事实打泛化标签,比如“小张”关联“过敏人群”
- QIV(场景触发):把整段对话压缩成多维档案,便于整体匹配
- QII(桥接触发):在事实粒度预判使用场景,如“海鲜过敏”连到“团建选餐厅”
- QIII(前瞻触发):在场景粒度向前推演,比如深夜聊身体不适时,联想到之前说过“怕一个人去医院”
其中 QII 和 QIII 是真正的创新点。它们让记忆不再被动等待“复述”,而是主动准备“联想”。
写入与读取:两条链路如何协同
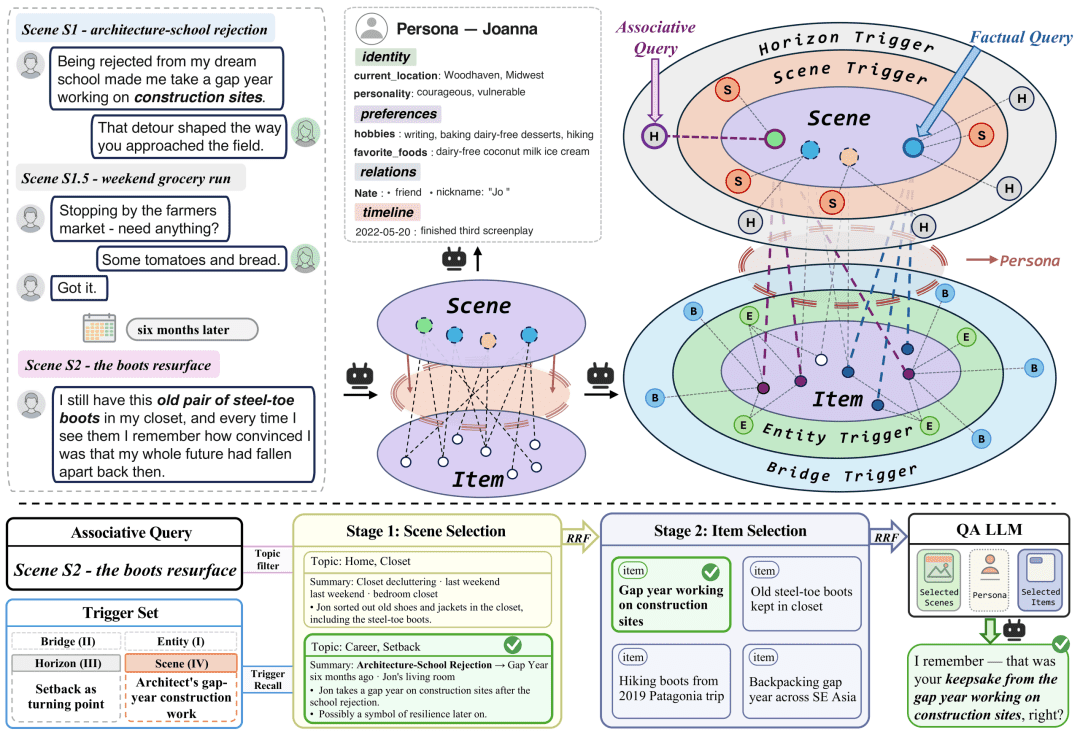
T-Mem 的运行分为写入和读取两条链路。
写入链路在后台持续工作:
- 将连续对话切分成有完整情节的独立场景
- 将多个场景归入同一主题(如“健康”“工作”)
- 从场景中抽取出原子化事实(如“小张 - 过敏 - 海鲜”)
- 构建场景-事实图,并为每条事实和场景生成对应的 triggers
这个过程不占用问答响应时间,对话推进一段,记忆库就更新一段。
读取链路则在收到新问题时启动:
- 先判断问题所属主题
- 在该主题下检索相关场景
- 通过 triggers(包括联想线索)召回具体事实
关键区别在于:联想线索在第一步就参与筛选。即使问题和某条记忆毫无表面相似,只要它“踩中”了预设的触发场景,记忆就会被带入候选集,不会被主题过滤提前丢弃。
性能验证:在“不像但相关”的题目上碾压对手
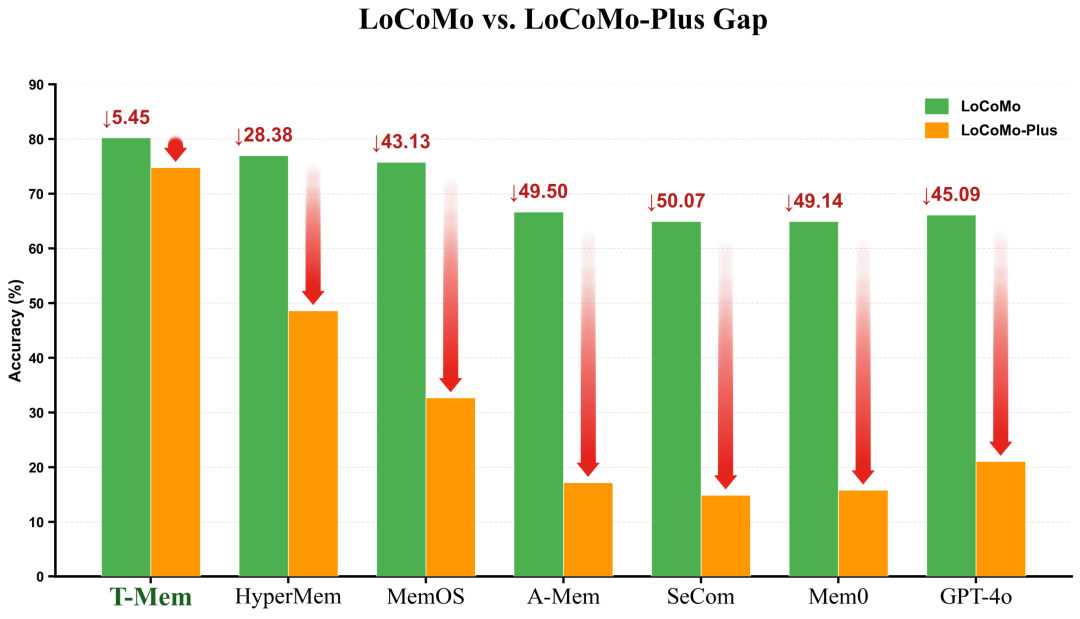
T-Mem 在两个基准上测试:LoCoMo 和 LoCoMo-Plus。
LoCoMo 是当前主流的长对话记忆基准,但它的题目本质上是相似召回——查询和记忆共享关键词或实体就能命中。T-Mem 在这里达到 80.26% 准确率,刷新 SOTA,说明基础能力不输他人。
真正的考验是 LoCoMo-Plus。它在 LoCoMo 基础上增加了一个“认知子集”:题目中的线索和答案之间刻意抹掉词汇与语义相似度,只保留叙事或因果关联。比如“用户曾说怕打雷,现在问周末天气”,正确答案应是“记得带耳塞”,但“打雷”和“天气”在嵌入空间里并不接近。
据作者所知,这是目前唯一能单独检验“联想记忆”的公开基准。T-Mem 在这里取得 74.81% 准确率,同样刷新 SOTA。
更关键的是跨域落差:主流系统从 LoCoMo 掉到 LoCoMo-Plus,平均准确率下降 28–50 个百分点,而 T-Mem 只掉了 5.45 个百分点。这个差距证明,联想能力不是锦上添花,而是现有方案结构性缺失的核心能力。
记忆的价值在于“被想起”,而非“被存下”
论文结尾引用了一句认知科学的经典判断:
“一个长期记忆系统的价值,不在于忠实地归档对话流,而在于写入的那一刻就预见到:未来的查询会通过怎样的线索来触及它。”
T-Mem 正是这句话的工程实现。它把记忆从“档案柜”变成“备忘录”——不是等你翻找,而是提前把答案放在你明天会经过的路上。
这项工作已发表于 EMNLP 2026,代码与数据开源。团队来自腾讯 PCG,相关技术已在 QQ AI 伙伴项目中上线。对于希望打造真正“懂你”的长期陪伴智能体的研究者和工程师来说,T-Mem 提供了一条绕过相似度陷阱的新路径:与其教机器找相似,不如教它学会联想。