光轮智能如何用10万小时人类数据推动具身智能规模化
光轮智能的两座数据金字塔
在最近一期 RoboPapers 播客中,光轮智能创始人兼 CEO 谢晨博士与主持人 Michael Cho 和新加坡国立大学助理教授 Jiafei Duan 展开了一场深度对谈。这场对话的核心,是如何让具身智能真正走向规模化。
谢晨提出了一个关键判断:具身智能的 Scaling Law 需要两座金字塔——一座用于训练,一座用于评测。训练金字塔的底座是可规模化的第一视角人类数据,解决“从哪里学”的问题;评测金字塔的底座是可规模化的仿真,解决“如何知道学会了什么、还缺什么”的问题。
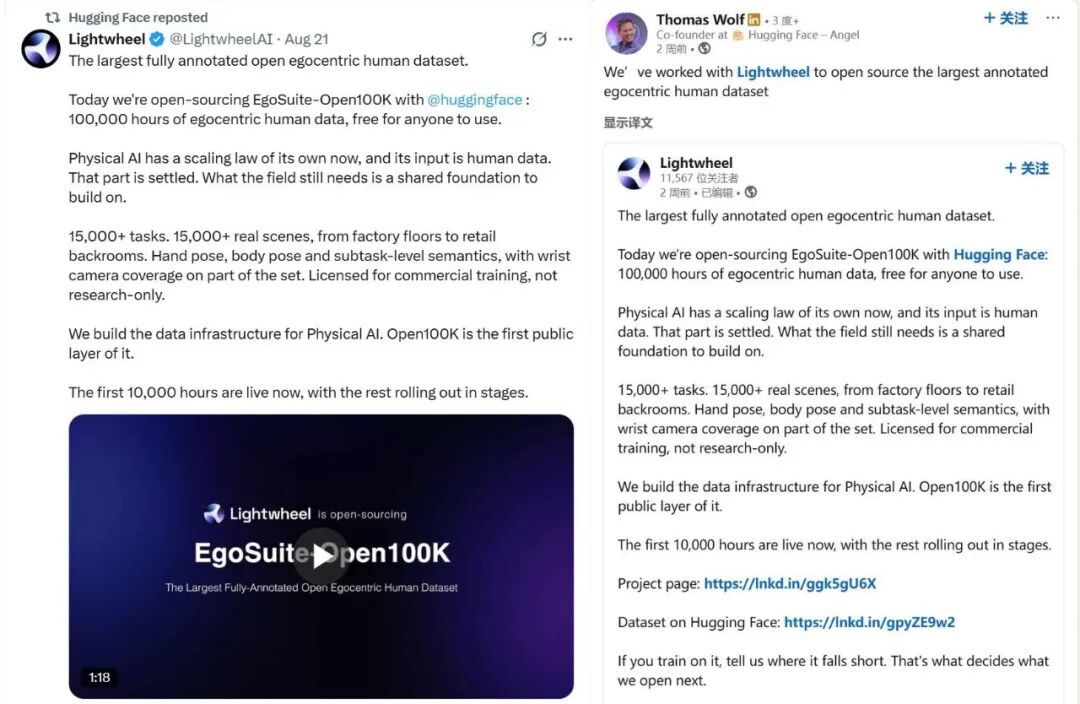
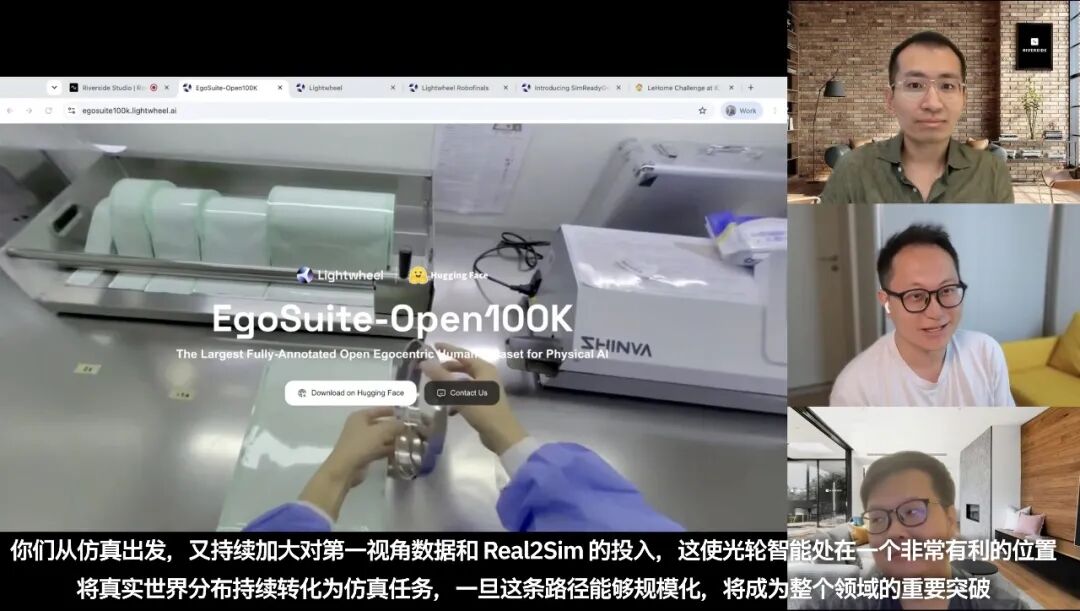
这个观点并非空谈。就在 2026 年世界机器人大会上,光轮智能开源了 EgoSuite-Open100K——一个包含 10 万小时高质量多模态人类行为视频的数据集。它覆盖超过 15,000 个场景和任务,提供头部与腕部双视角,并附带手部与全身位姿、语义标注和深度信息。数据已在 Hugging Face 和 AtomGit 上线,并捐赠给开放原子开源基金会孵化。Hugging Face 首席科学官 Thomas Wolf 也罕见地公开支持这一举措。
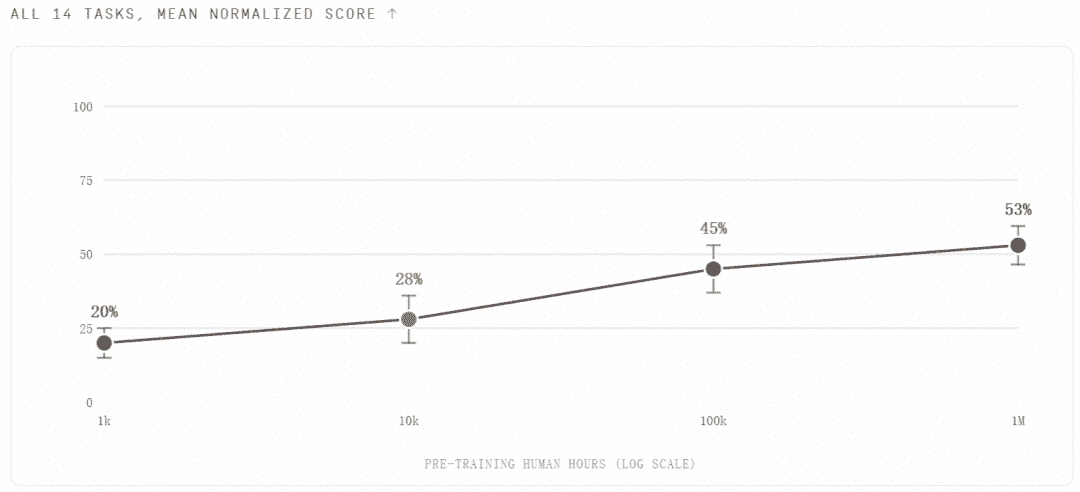
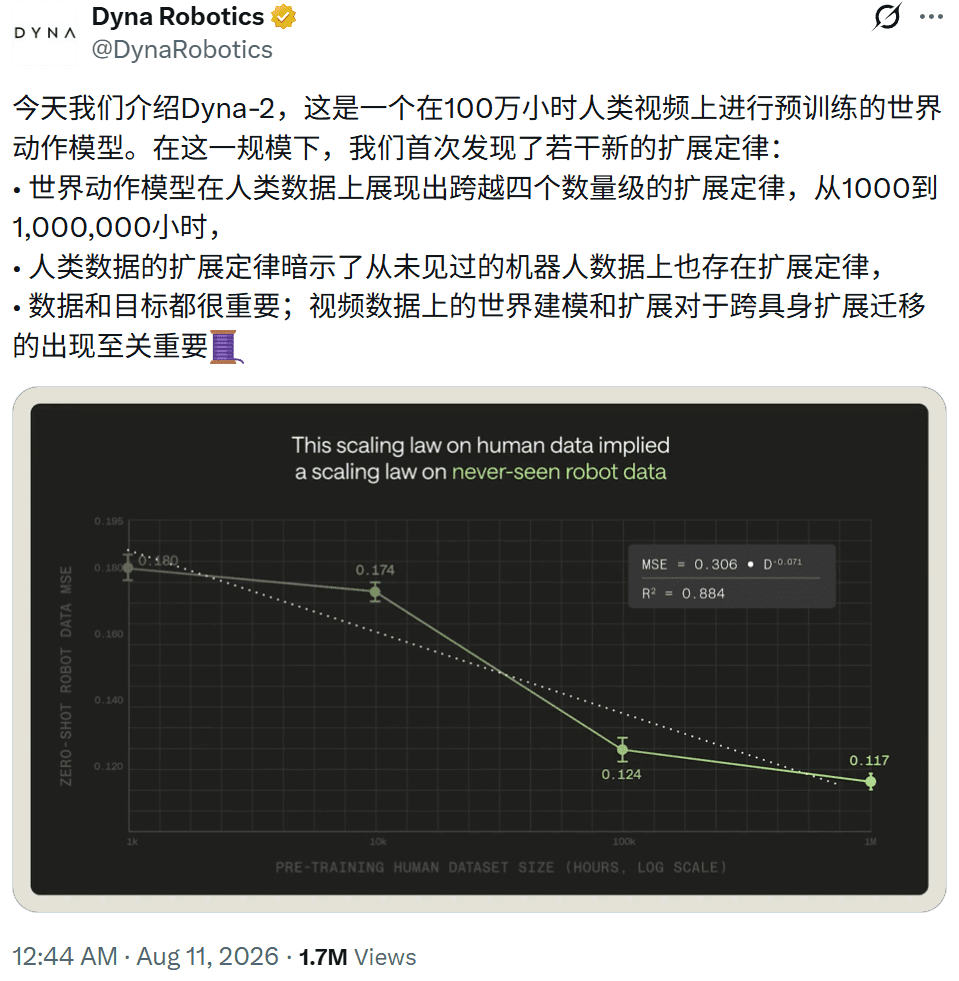
这背后是对行业痛点的精准回应。Dyna Robotics 刚刚发布的 DYNA-2 模型证明,当预训练数据从 1000 小时扩展到 100 万小时,机器人在复杂任务(如开锁)上的成功率能从 0% 跃升至 90%。但数据从哪来?如何保证质量?又如何验证模型是否真的进步?光轮智能试图从供给侧给出系统性答案。
为什么机器人需要“本体无关”的人类数据
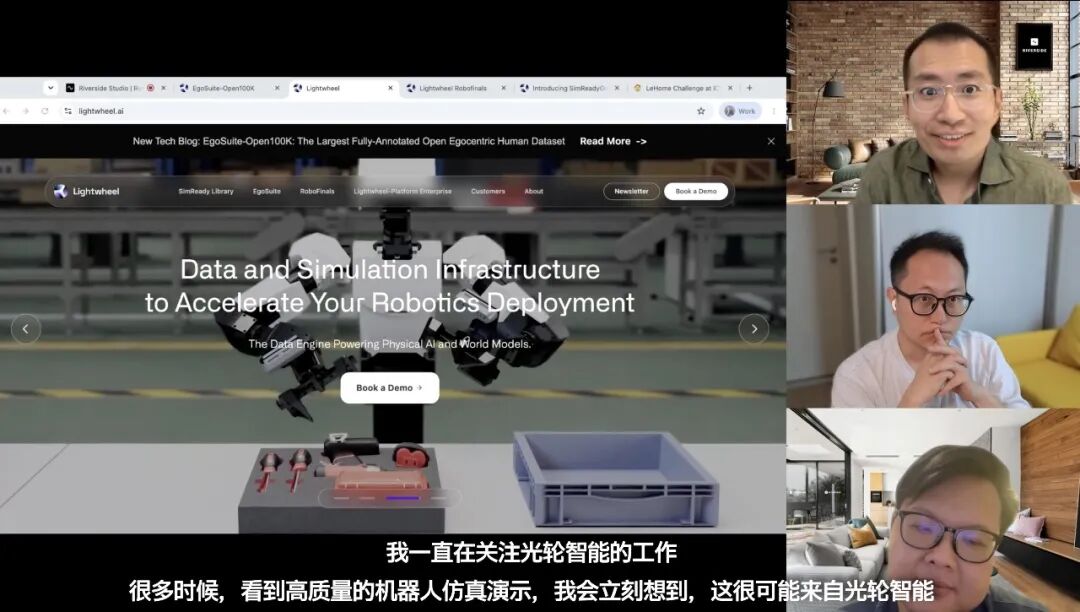
Jiafei Duan 在访谈中直言:“很多时候看到高质量的机器人仿真演示,我会立刻想到这很可能来自光轮智能。”但他紧接着抛出一个问题:一家以仿真见长的公司,为何要大举投入人类第一视角数据?
谢晨的回答直指核心:机器人缺乏像自动驾驶那样的天然数据飞轮。特斯拉有数百万辆车在路上运行,司机的每一次操作都是潜在的监督信号。而全球人形机器人可能只有几万台,且并非持续采集数据。真机数据虽然物理真实、质量高,但成本昂贵、绑定特定本体,任务或硬件一变,历史数据就难以复用。
因此,光轮智能把第一视角人类数据放在训练金字塔的底部。这类数据不依赖特定机器人形态,能提供跨任务、跨环境、跨本体的通用经验。少量高质量真机数据则负责“Embodiment Grounding”——将人类经验对齐到具体机器人的观察空间、动作空间和动力学约束上。仿真则承担 Rollout 与 Verification 的角色,用于扩展长尾状态、支持强化学习,并以低成本持续评测模型。
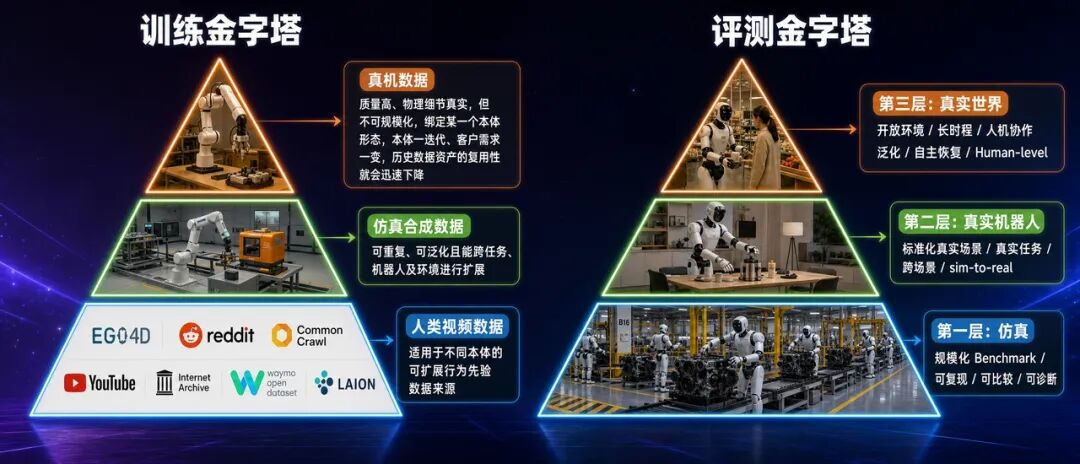
这三者不是替代关系,而是一个闭环中的不同层次。谢晨的判断很明确:“人类数据可能是机器人基础模型最具规模化能力的来源。”
高质量数据的四个关键维度
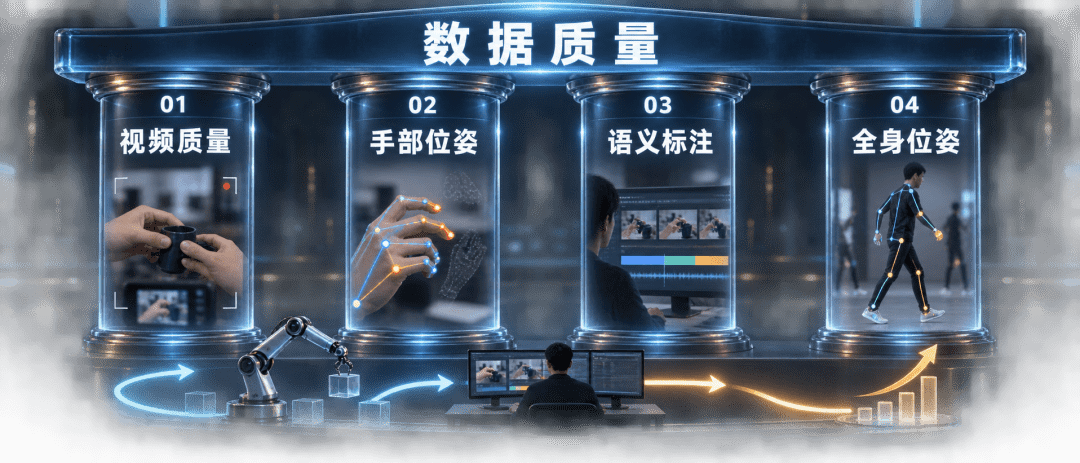
开源 10 万小时数据的底气,来自光轮智能自研的数据引擎——一套可规模化的采集、自动标注与质检 pipeline。谢晨将其拆解为四个关键维度。
首先是视频质量。这是整条产线的门槛:画面不能有坏帧,双手必须始终在视野内,动作要自然流畅——不能太快也不能太慢。光轮在采集端就部署了实时的 agentic 质检流程:一个片段刚录完,系统立刻自动检查,结果直接反馈给采集者。“让数据采集者在工作中学习、实时获得反馈并不断改进,本身就是数据质量体系非常重要的一部分。”谢晨说。
自动质检后还有两轮人工复核。尽管 AI 的 precision 和 recall 已经很高,但仍未达到 100%。更重要的是,人工发现的失败案例会反哺自动化系统:“我们正在建立一个持续反馈闭环,用人类反馈不断改进自动化流程。”
第二个维度是手部位姿。手是人与环境交互的核心,其标注精度直接决定数据价值。光轮专门组建团队,自研了一整套算法来计算手部姿态。
第三个维度语义标注则是当前真正的瓶颈。内部已迭代七个版本,从事件级做到动作级。难点不在描述内容,而在时间戳——动作究竟从哪一帧开始、哪一帧结束?现有视觉语言模型(VLM)还给不出足够准确的答案。目前的解法是组合拳:用已积累的动作级标注数据微调基础模型,让 VLM 更准,从而逐步降低人在回路的比例。
第四个维度全身位姿相对早期,因为当前主流机器人基础模型大多从手部任务切入。
除此之外,对客户而言还有一个隐性但关键的维度:多样性。要在保证质量的同时,实现任务、场景和采集者的多样性,绝非易事。光轮将任务分为家居、酒店、零售、运动、物流、办公、工业七大类,每类下再拆解具体任务。为此,内部专门开发了一个“任务 agent”,负责生成、维护任务,并将其匹配到真实场景和采集者。每个场景和任务都设有时长上限,以防止数据过度集中于少数高频行为。
评测金字塔:从真实数据中生成仿真考题
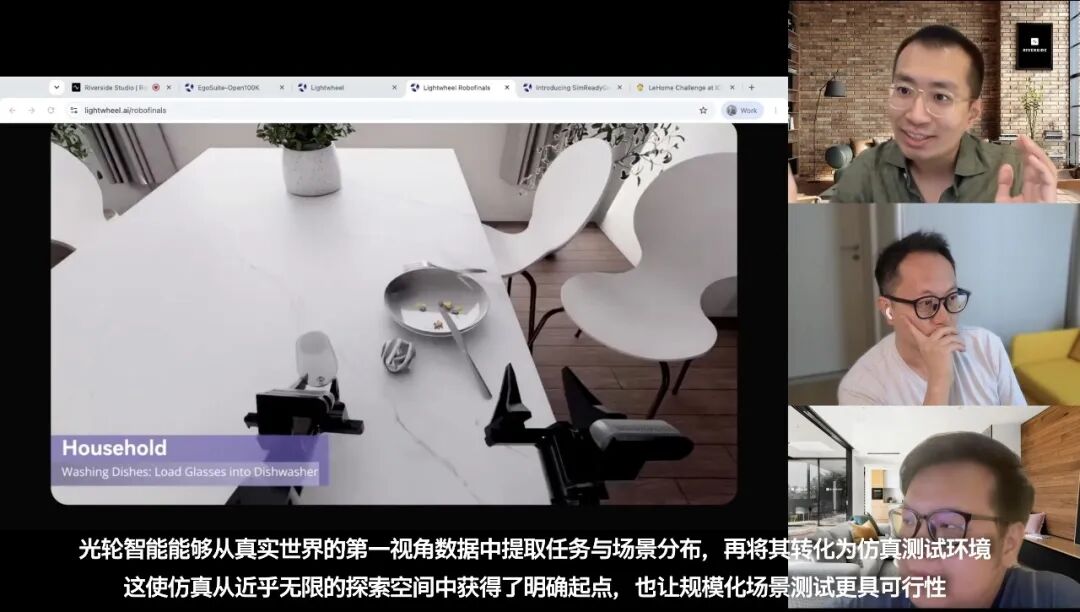
经典仿真的一个老大难问题是:即使有强大的引擎,也很难回答“究竟该模拟什么”。光轮智能的解法是从真实世界的第一视角数据中提取任务与场景分布,再将其转化为仿真测试环境。
这套思路源于谢晨在 Cruise 和英伟达做自动驾驶仿真的经验。他总结道:要让仿真规模化,必须先有规模化的真实数据来对齐、标定和验证。光轮智能的产品体系中,RoboFinals 承担仿真评测任务,被谢晨比作“机器人的高考”。但“高考”不能是一套固定题库。
目前行业内的仿真 benchmark 多由人工构造。光轮的做法是:从 EgoSuite 真实数据中抽取代表性任务与场景,输入自研的 SimFoundry 仿真平台生成测试环境,再由 RoboFinals 观察数据变化是否真正转化为机器人能力提升。
为了确保物理真实,光轮打造了物理测量工厂:用机械臂、灵巧手和触觉传感器测量开门力度、可动部件运动、线缆形变等真实力学参数。这些数据用于构建高保真仿真环境和任务。同时,通过抽样真机验证,持续检查仿真结果与真实表现的相关性,缩小 Sim-to-Real Gap。
在这个系统里,每一次真实失败都能变成一道新考题,每道新考题又重新定义下一批训练数据。评测不再是终点,而是持续学习闭环中的正向反馈,驱动模型高效迭代。
“三个唯一”:中国公司在国际标准中的话语权
这套方法论已获得市场验证。谢晨透露,光轮智能的标品数据复售倍数超 10 倍,头部模型客户复购率接近 100%,部分客户采购规模扩张了 20 倍。近三个月,公司已向 30 多家头部模型企业交付超 20 万小时标品数据。
这些数据能被不同本体、不同团队反复使用,恰恰验证了“robot-agnostic”假设的成立。反之,如果每个客户都要高度定制,这条路就走不通。“如果只顺着客户需求做,你会变成一家高度定制化的公司:质量可能很高,但不具备规模化能力,也不代表真实世界的分布。”
更关键的是,光轮智能已成为多个国际标准组织中的“唯一中国企业”:
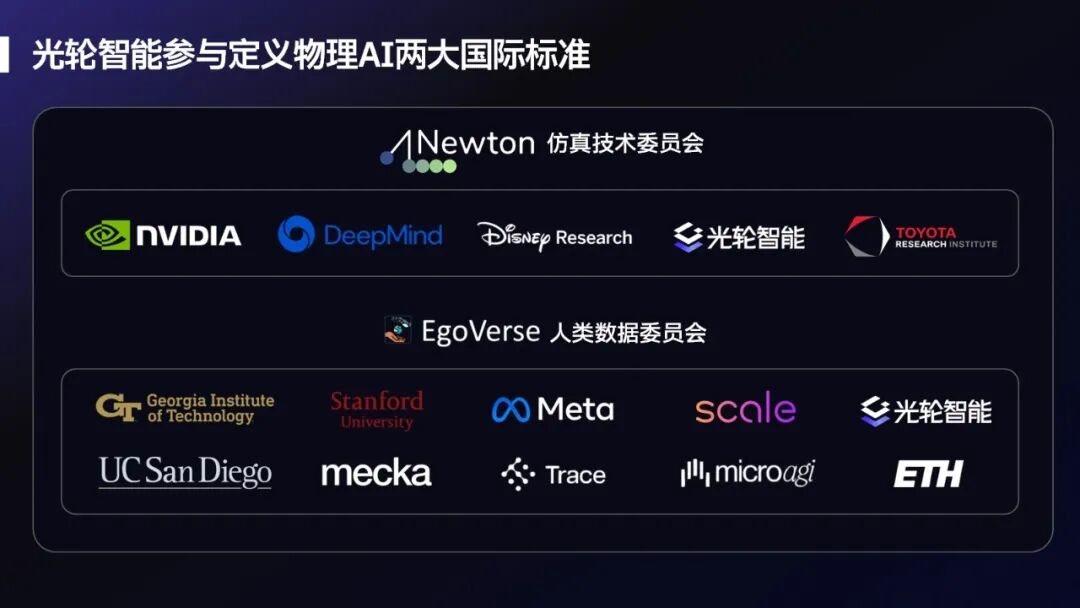
- 在仿真领域,作为 Newton 仿真技术委员会唯一中国企业,与英伟达、谷歌 DeepMind、迪士尼研究院、丰田研究院共同制定下一代开源物理 AI 仿真标准;
- 在数据领域,作为 EgoVerse 人类数据委员会唯一中国企业成员,与 Stanford、Meta、Scale AI、Mecka AI 等共建全球最大人类数据训练体系。
今年 7 月,《The Robot Report》评选出“塑造 2026 年机器人产业的五大物理 AI 基础设施平台”:英伟达提供算力与开发底座,Applied Intuition 负责验证,Scale AI 做训练数据工业化,Hugging Face 承担开源协调,而光轮智能被定位为“持续学习基础设施”——连接真实经验、仿真、评测与部署的闭环。
由此,光轮智能成为物理 AI 基础设施、仿真与人类数据三大国际顶尖组织中唯一的中国公司。
打造具身数据的“Model 3”:失败驱动的 pipeline
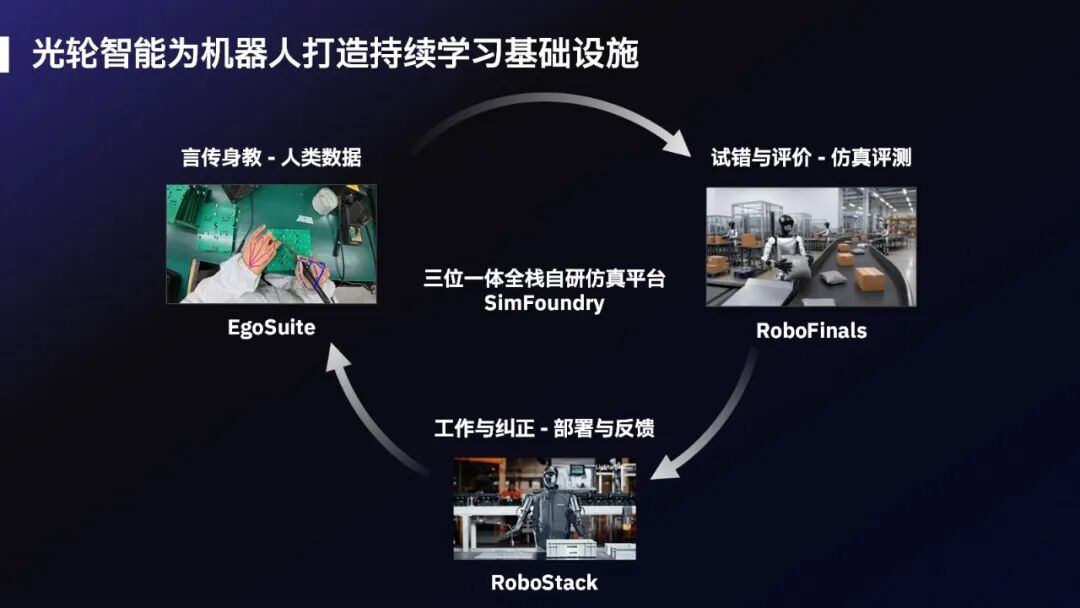
访谈后半程,谢晨多次引用特斯拉作比。他认为,机器人问题可能比 FSD 难 1000 倍以上,未来或许需要 10 亿人佩戴设备为机器人采集数据。但 10 亿人不可能用同一款设备,“未来应该是一个开放生态”。目前,光轮的采集端已兼容 PICO、自研头显和 iPhone,并正与硬件厂商合作设计下一代第一视角采集设备。
而在数据生产力方面,他强调:“真正的 Model 3,是整套 pipeline,是整个 data engine。未来应该是一条失败驱动的 pipeline,我们从失败中学习,只回传最有价值、最有意思的片段。”
这正是特斯拉车队数据飞轮的精髓:在车端部署模型,实时比对人类操作与模型输出,仅在出现差异时上传片段。光轮正在将这一逻辑迁移到第一视角采集——在采集端部署算力和模型,做实时推理与重定向,只回传人与模型行为不一致的片段。
这也解释了其“5 年 100 亿小时”计划的关键细节:这 100 亿小时不能是重复数据,端侧的 shadow mode 是必须的。
在光轮的持续学习系统中,EgoSuite 提供人类示范,SimFoundry 与 RoboFinals 提供试错与评测空间,RoboStack 真机平台则不断回流真实世界反馈,告诉系统需要补充哪些数据。正是这个闭环,让两位主持人在访谈尾声感慨:光轮智能从仿真出发,持续加码第一视角数据和 Real-to-Sim 转化,已处在一个非常有利的位置,有机会真正解决具身智能的规模化难题。