大模型如何逐字生成回答:Token 与自回归机制详解
大模型不是“想好再说”,而是“边写边猜”
你有没有想过,当你问大模型一个问题时,它是像人一样在脑子里组织好完整答案再输出,还是另有套路?
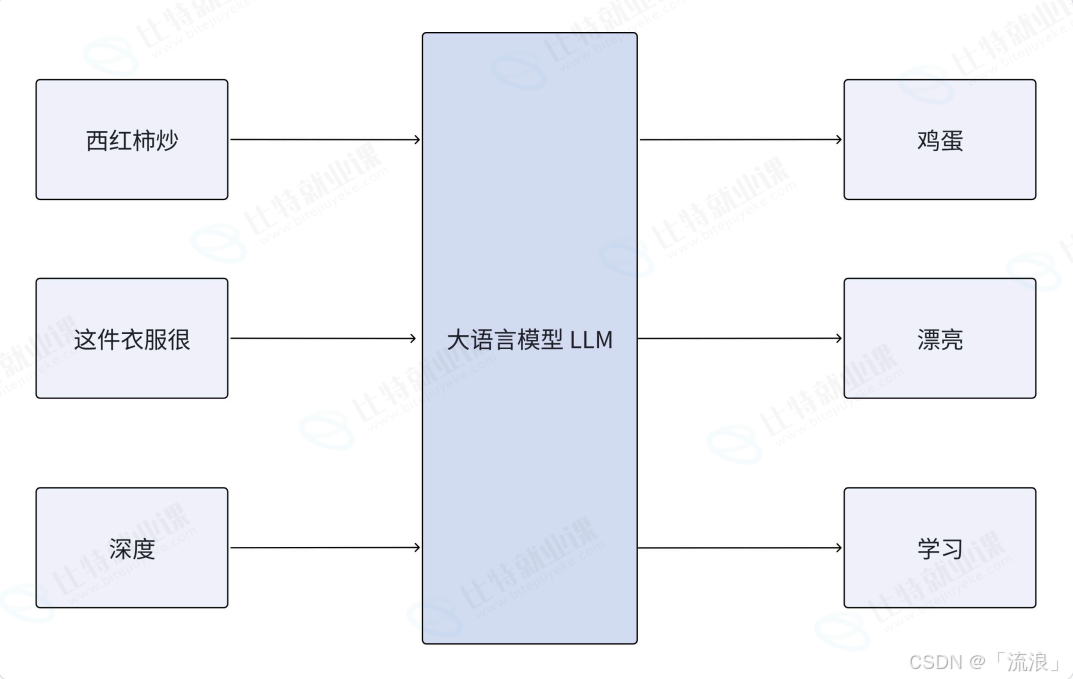
答案是后者——它根本不会预先构思整句话。它的生成方式更像一场“逐字接龙”游戏:根据已经写下的内容,不断预测下一个最可能出现的词(准确说是 Token),然后把这个新词加到末尾,再继续预测下一个。这个过程一直持续,直到模型输出一个特殊的终止符。
这种机制叫自回归生成(Autoregressive Generation),是当前几乎所有主流大语言模型(如 GPT 系列)的核心工作方式。
选词靠概率,不是确定性
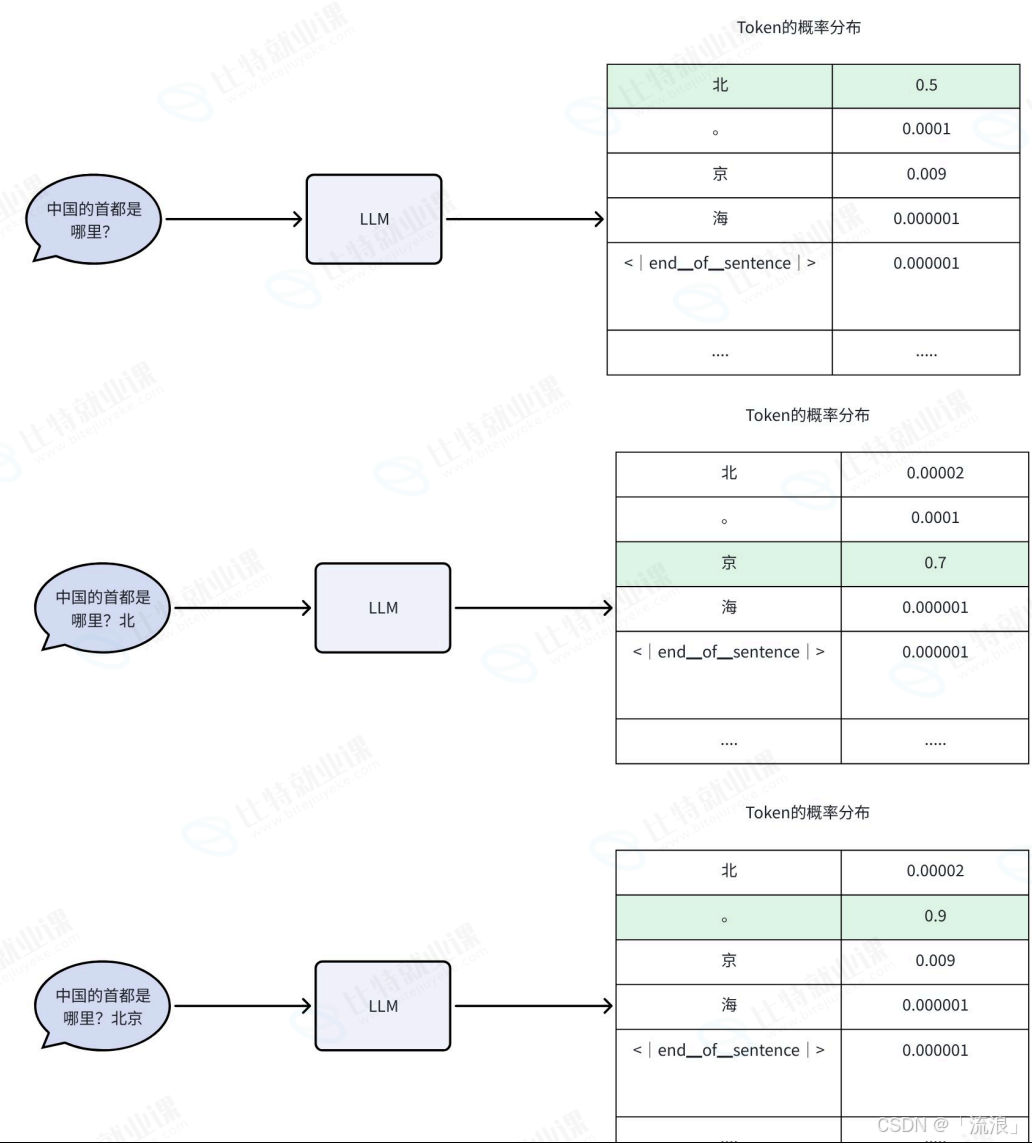
模型决定下一个 Token 的过程,并不是简单地挑“最可能”的那个,而是先计算出词表中所有 Token 的概率分布,再通过某种采样策略(比如 top-p、temperature 调控)从中随机抽取一个。
举个例子:当输入是“今天天气真”,模型可能会给“好”分配 70% 的概率,“棒”15%,“不错”10%,其他词共占 5%。最终输出哪个,取决于采样结果。这也是为什么同一个问题多次提问,AI 的回答可能略有不同——它不是在复读,而是在按概率“掷骰子”。
生成过程是串行的
以“中国的首都是哪里?”为例:
- 第一步:模型看到完整问题,预测第一个输出 Token 是“北”;
- 第二步:输入变成“中国的首都是哪里?北”,预测下一个 Token 是“京”;
- 第三步:输入变为“……北京”,预测“是”;
- ……
- 直到最后输出终止符(如
<|end▁of▁sentence|>),生成结束。
每一步都依赖前一步的结果,无法并行。这种串行特性,直接导致了后续提到的性能和成本问题。
Token:AI 眼中的“最小语言单位”
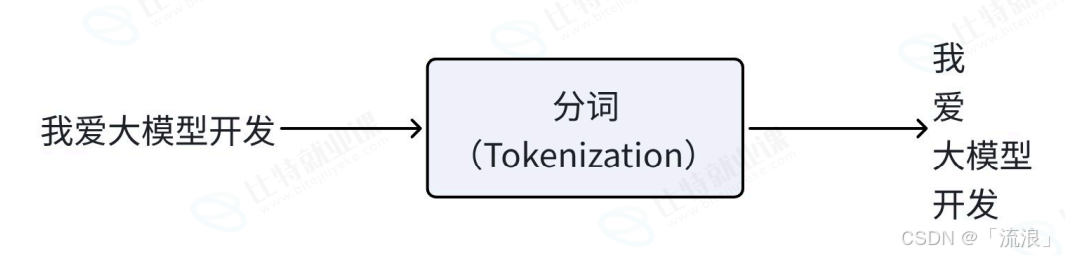
人类阅读时会自然断句,比如把“我爱大模型开发”理解为“我 / 爱 / 大模型 / 开发”。AI 也需要类似的“断句”过程,这个过程叫分词(Tokenization),断出来的每个单元就是 Token。
Token 不一定是完整的词。例如:
- 英文中,“unbelievable”常被切分为 “un” + “believe” + “able” 三个 Token;
- 中文里,一个常用汉字通常对应 1 个 Token,但生僻字或罕见组合可能被拆成多个;
- 标点符号、空格、换行符也各自占用 Token;
- 表情符号如 😊 可能被拆成多个字节级 Token。
不同模型使用的分词器(Tokenizer)不同,同一句话切出的 Token 数量也可能不一样。比如有的模型把“大模型”视为一个整体,有的则拆成“大”+“模型”。
为什么要用 Token?
计算机只能处理数字,不能直接理解文字。Token 化解决了两个关键问题:
- 数字化桥梁:先把文本切成 Token,每个 Token 分配一个唯一 ID(比如“北”=891,“京”=432),再将这些 ID 映射为高维向量。语义相近的词,其向量在空间中距离更近。
- 平衡效率与覆盖:如果按字母切,序列太长,计算开销爆炸;如果按完整单词切,词表会过于庞大,且无法处理新词。主流方案(如 BPE、SentencePiece)采用子词切分,在词表大小和表达能力之间取得平衡。
词表:模型只能在“认识的词”里选
词表(Vocabulary)是模型训练时就固定下来的 Token 字典,每个 Token 对应一个唯一整数 ID。GPT-2 的词表大小是 50,257,这意味着模型永远不可能输出 ID 为 50,258 的 Token。
这带来一个重要限制:模型无法生成词表之外的新 Token。但它可以通过组合已有 Token 来拼出新词。比如词表里有 “un”、“believe”、“able”,就能拼出 “unbelievable”,即使这个词本身不在词表中。
冷门内容为何更贵?
如果某个专业术语或罕见字符不在词表中,模型就得用多个 Token 来表示它。例如一个生僻汉字可能被拆成 3~4 个字节级 Token。这意味着:
- 同样长度的文本,冷门内容消耗更多 Token;
- 更多 Token 意味着更长的计算时间、更高的显存占用、更大的 KV Cache;
- 最终反映在 API 费用上——处理技术文档或小语种时,账单涨得更快。
字节级回退:确保不丢字符
早期分词器遇到未知字符(如 Emoji)会直接替换为 [UNK],导致信息丢失。现代方案(如 Byte-fallback BPE)则把未知字符按 UTF-8 编码拆成字节,每个字节映射到一个专用 Token。这样虽然效率略低,但保证了 100% 的字符覆盖率。
为什么输出比输入更贵?
同样长度的内容,模型“写出来”比“读进去”贵得多。这不是厂商故意抬价,而是由技术本质决定的。主要有三大原因:
1. 算力严重闲置
- 输入阶段(Prefill):所有 Token 一次性打包成矩阵,GPU 并行计算,利用率接近 100%,几毫秒完成。
- 输出阶段(Decode):每次只生成一个 Token,必须串行执行。即使 GPU 有强大算力,也只能一次算一个,其余时间都在等待。实测中,GPU 利用率常低于 5%。
类比:输入像满载货车跑高速,输出像一个人在市区堵车中搬砖——虽然每趟搬得少,但来回次数多,总耗时更长。
2. 显存带宽成为瓶颈
输出阶段的瓶颈不再是计算能力,而是显存带宽。每生成一个新 Token,都需要从显存中读取之前所有 Token 的 Key 和 Value 向量(即 KV Cache),进行注意力计算。这个过程频繁搬运数据,极易打满显存带宽(如 H100 的 3.35TB/s),导致延迟飙升。
3. KV Cache 占用大量显存
为了加速自回归生成,系统会缓存每个已生成 Token 的 K 和 V 向量,这就是 KV Cache。它的大小随输出长度线性增长:
- 生成 1000 个 Token,就要缓存 1000 份 K/V;
- 对于 70B 参数的大模型,每 1K Token 的 KV Cache 可能占用数 GB 显存;
- 一张 80GB 的 A100 显卡,可能同时服务几十个短请求,但只能支持几个长文本生成任务。
显存是稀缺资源,占用越多,单位成本越高。因此,输出 Token 的单价普遍高于输入 Token。
多轮对话:AI 的“记忆”只是假象
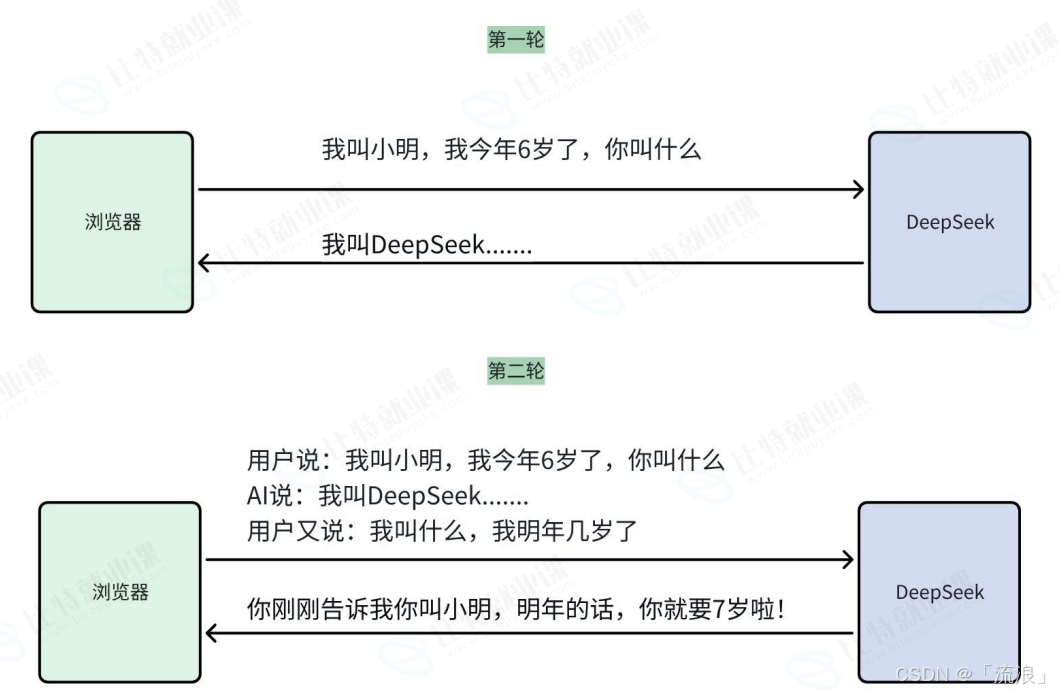
很多人以为 AI 能记住对话历史,其实不然。大模型本身是无状态的(Stateless)——每次调用都是独立的,模型不知道你上一轮说了什么。
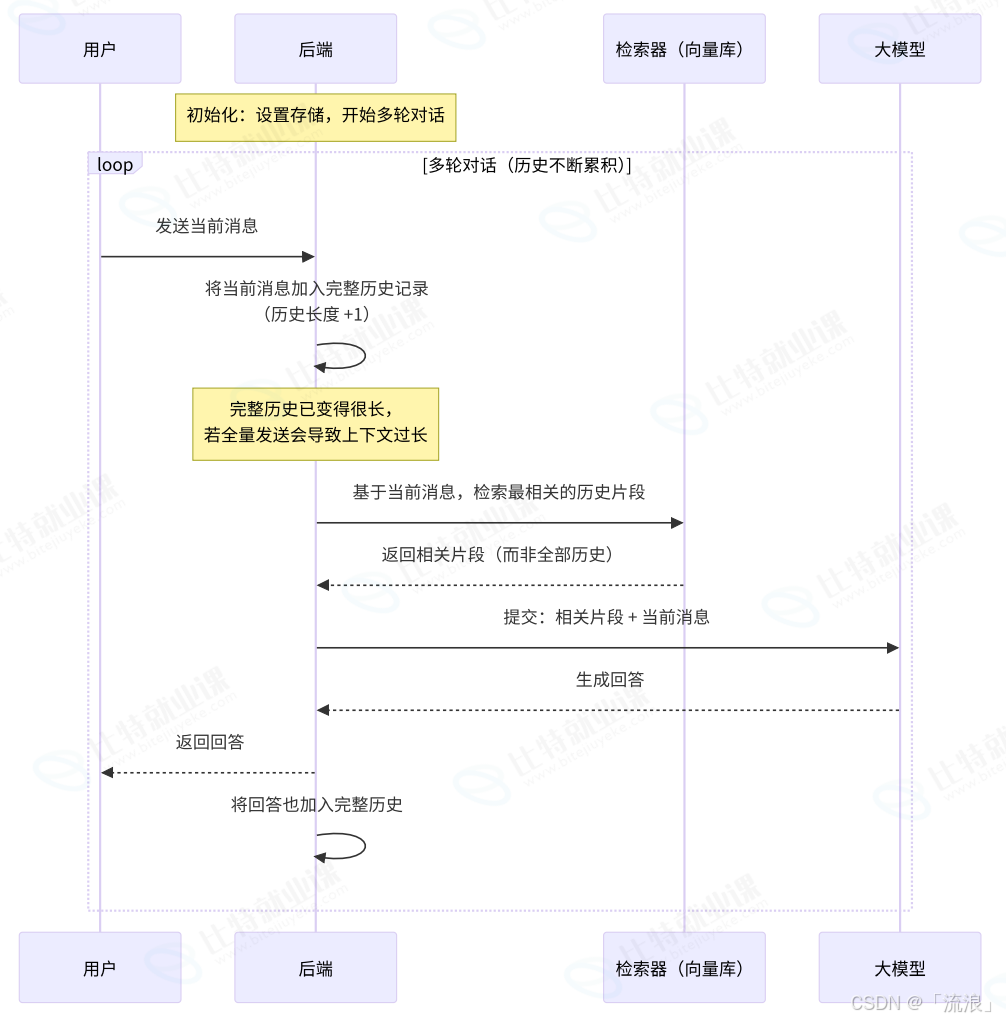
所谓的“多轮记忆”,是应用层把整个对话历史(包括用户和 AI 的所有发言)拼接到当前问题前面,重新发送给模型。模型看到的是一个超长的输入,而不是真的“回忆”起了过去。
上下文超限 = AI 失忆
每个模型都有上下文窗口上限(如 32K、128K Token)。一旦历史对话超过这个长度,系统会自动截断最早的部分。结果就是:你开头说“我对花生过敏”,聊了几十轮后,模型忘了这条信息,可能推荐含花生的食谱。
长对话又慢又贵
每轮对话都要重新处理全部历史,导致:
- Token 消耗线性增长(历史越长,每轮输入越多);
- 推理延迟增加(Prefill 阶段要处理更多 Token);
- KV Cache 膨胀(输出阶段显存压力更大)。
为缓解这个问题,生产系统通常采用:
- KV Cache 复用:缓存历史部分的 K/V,每轮只计算新内容;
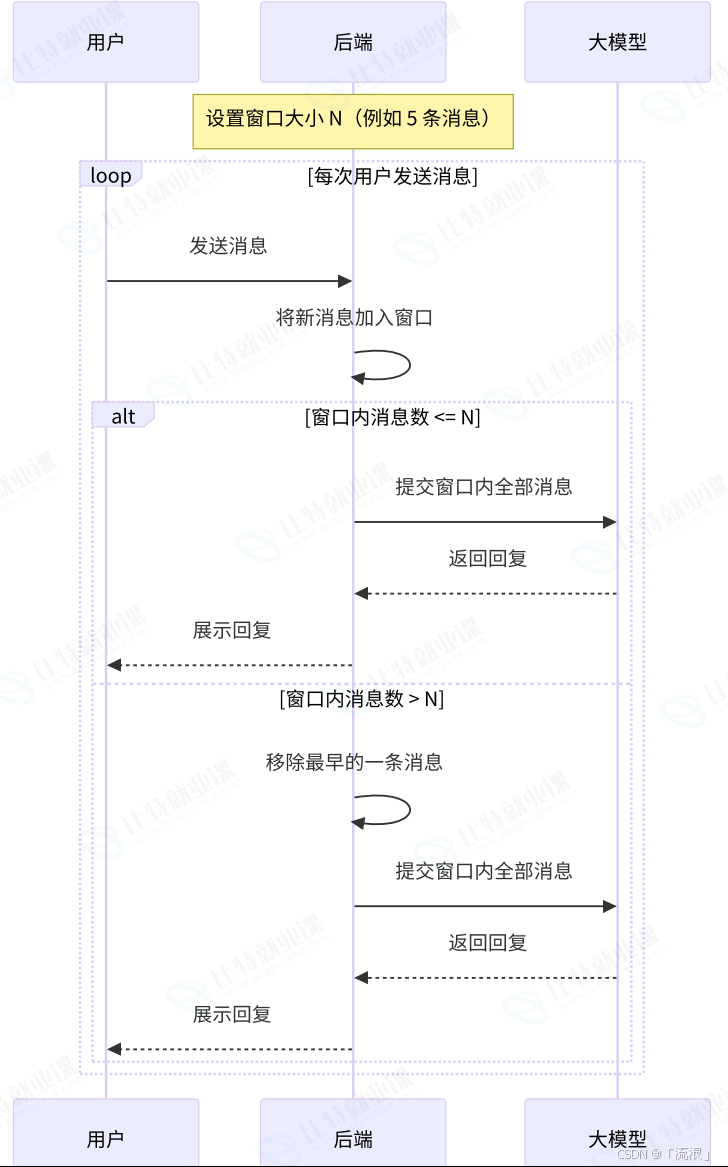
- 上下文剪枝:移除无关历史(如闲聊),保留关键信息;
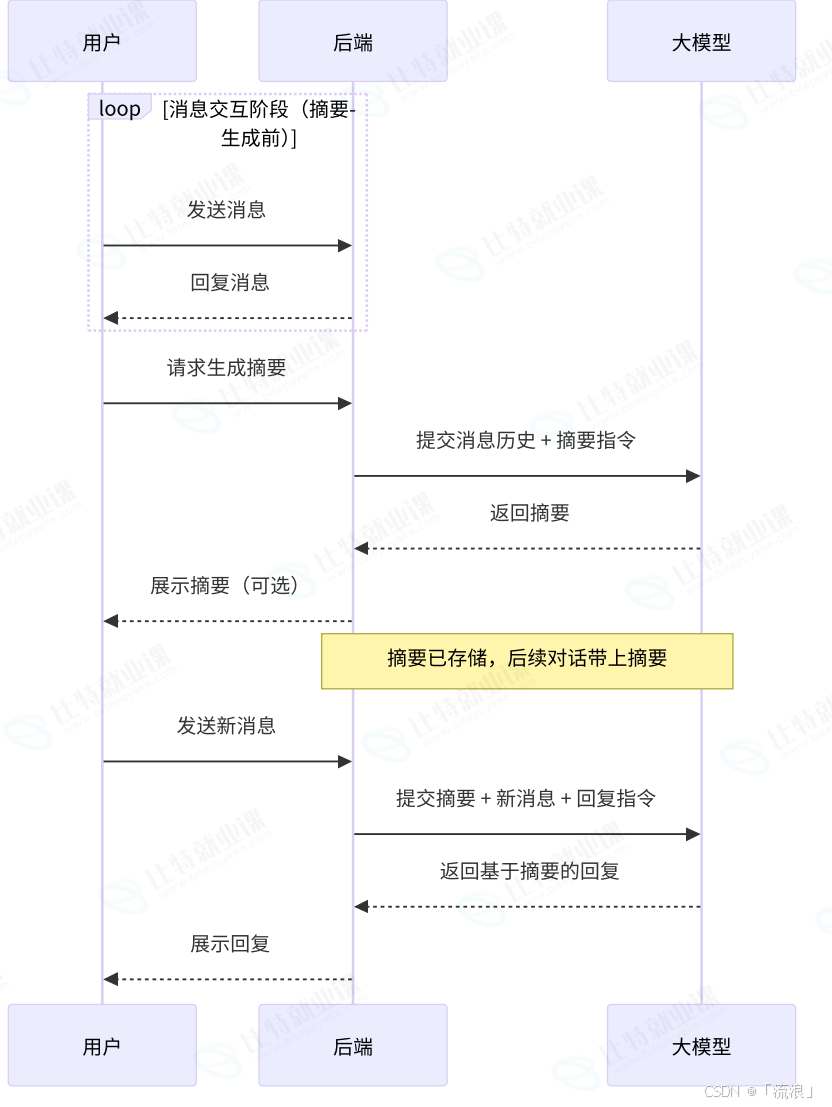
- 对话摘要:当历史过长时,用模型生成一段摘要替代原始记录;
- RAG 检索:将历史存入向量数据库,按需检索相关片段插入上下文。
模型更容易记住开头和结尾
研究发现,大模型对上下文首尾部分的记忆更强,中间内容容易被忽略。这被称为“大海捞针”现象:如果关键信息藏在大量无关文本中间,模型很可能漏掉。这也解释了为什么重要指令最好放在问题开头或结尾。
常见问题澄清
Q:中文一个字等于一个 Token 吗? 不一定。常用汉字通常是一个 Token,但生僻字、繁体字或特殊符号可能被拆成多个。精确数量需用官方 Tokenizer 工具验证。
Q:为什么充的钱很快用完? 因为计费 = 输入 Token + 输出 Token,而输出单价更高。长对话每轮都重发历史,Token 累积极快。
Q:上下文塞满会怎样? 超出部分会被截断(通常丢弃最前面的内容),导致模型“遗忘”早期信息。
Q:AI 真的记住我说的话了吗? 没有。换新会话后,历史上下文不再发送,模型就一无所知。所谓记忆,只是应用层不断重发上下文的模拟效果。
Q:模型能创造新词吗? 不能。它只能从固定词表中选择 Token。新词靠组合实现,但组合越复杂,Token 消耗越多,成本越高。
理解这些机制,不仅能帮你更高效地使用大模型,也能在设计应用时做出更合理的架构选择——比如控制上下文长度、避免冗余输入、合理使用摘要或 RAG。毕竟,每一枚 Token,都是真金白银。