MAGI Preview如何用MoE架构打破视频生成的‘不可能三角’?
近年来,生成式人工智能在文本、图像领域取得显著突破,但视频生成始终面临一道难以逾越的技术鸿沟——容量、成本与质量构成的“不可能三角”。高分辨率、长时长、高帧率的视频需要处理海量视觉token,导致模型参数规模与计算开销呈指数级增长。稠密架构下的训练和推理成本迅速失控,使得许多先进模型如Sora虽能力出众却难以商业化落地。然而,2026年8月,Sand.ai发布的MAGI Preview模型,凭借其创新的超细粒度混合专家(Ultrafinegrained MoE)架构与单流音视频统一设计,首次在开源社区实现了千亿参数规模下的低成本高效推理,为行业提供了全新的破局思路。
视频生成的核心瓶颈:token爆炸与通信墙
视频生成的本质挑战在于其序列长度远超文本任务。以720P图像为例,在ViT类视觉编码器中通常被划分为约900个patch tokens;而一段10秒、24帧/秒的视频则包含240帧,对应超过21万个视觉token。若叠加音频波形采样与文本指令,总序列长度轻松突破百万量级。相比之下,一篇千字英文文章仅需约1000个token。这种数量级差异直接导致两个后果:一是模型必须具备极高的上下文容量以捕捉时空一致性;二是每次前向传播的计算与显存需求急剧膨胀。
在稠密模型中,参数增加意味着每个token的计算量同步上升。当序列长度达到数十万时,即使使用最先进的GPU集群,单次推理也可能耗时数分钟、成本高达数元。更严峻的是,跨设备通信成为新的性能瓶颈。传统MoE架构虽能通过稀疏激活降低计算量,但在视频场景下,大量token需在不同GPU间路由至对应专家,通信开销往往抵消稀疏带来的收益。这正是过去两年开源视频模型参数规模长期停滞在10B–30B区间的核心原因——不是不想做大,而是做不大也用不起。
MAGI Preview的双重技术突破
面对上述困境,MAGI Preview采取了两项关键设计,分别从架构层面与系统层面实现突破。
超细粒度MoE:在低维子空间中实现高效稀疏
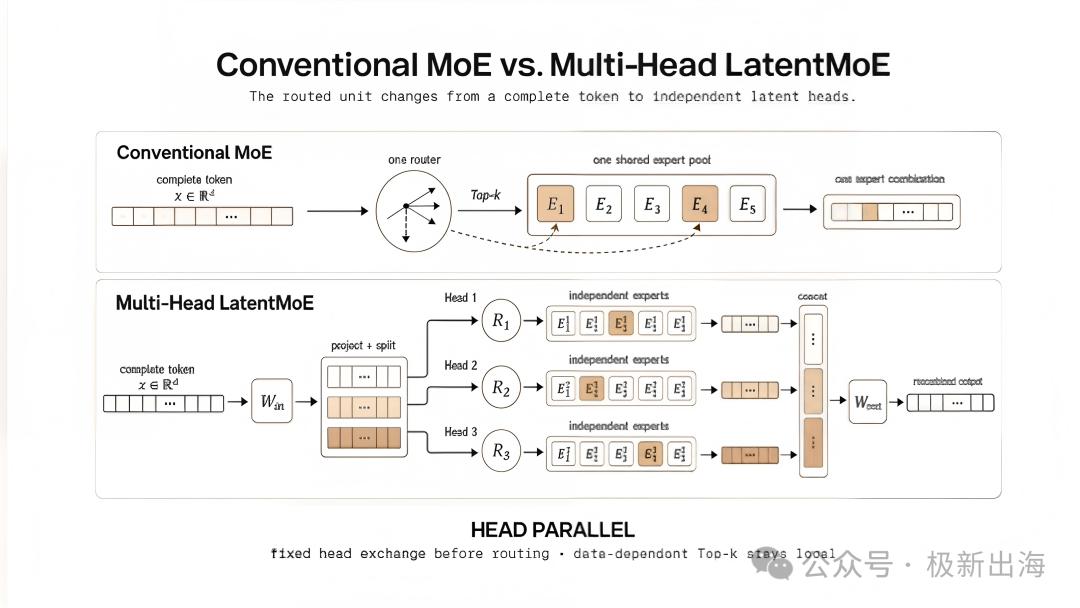
MAGI Preview并未沿用传统MoE的粗粒度路由策略(即整个token整体分配给1–2个专家),而是提出MultiHead MoE机制。具体而言,模型将3072维的隐藏状态拆分为12个256维的head,每个head独立维护256个专家,并在每层动态选择其中6个进行激活。这意味着,单个token在12个head中可并行激活72个微型专家,形成总计3072个局部专家单元。
这种设计的优势在于:
- 细粒度专业化:不同head可专注于不同语义维度,如人物外观、动作轨迹、语音特征等,提升生成细节的准确性;
- 降低路由冲突:在低维子空间中选择专家,减少了高维空间中相似token竞争同一专家的概率;
- 控制激活规模:尽管总参数达114B,但单次前向仅激活约6B,有效平衡容量与效率。
更重要的是,为解决通信瓶颈,团队引入Head Parallel机制。在路由发生前,先将固定形状的head表示分发至各计算设备,后续专家选择与计算均在本地完成。如此一来,通信量由输入head数量决定,而非激活专家数量,避免了随序列增长而线性膨胀的带宽压力。
配合自研的MagiMoE高性能算子库,模型进一步融合路由、排序与计算步骤,减少中间张量搬运;分布式优化器MagiMuon则采用混合更新策略(主体参数用Muon,其余用AdamW),显著提升训练稳定性与收敛速度。这套软硬协同的设计,使得千亿级MoE视频模型首次在开源生态中具备可复现性与可扩展性。
单流音视频统一架构:从源头保障多模态对齐
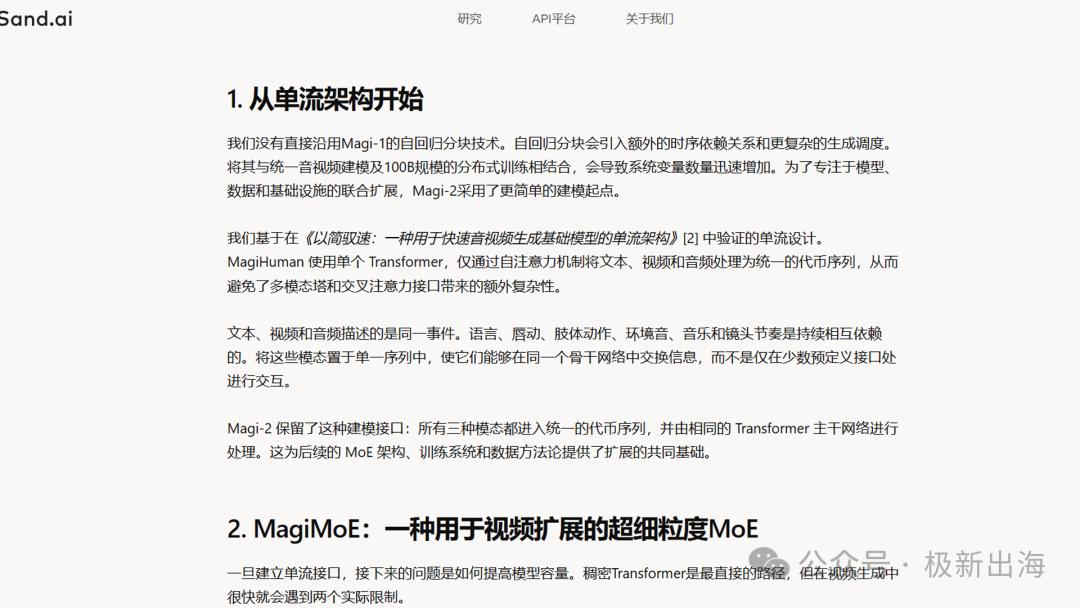
除成本问题外,视频生成的另一痛点是音画不同步。传统方案多采用多流架构(video/audio分支+cross-attention)或级联生成(先画面后配音),导致口型与语音错位、环境声与动作脱节等问题频发。MAGI Preview延续Sand.ai在daVinciMagiHuman中的理念,采用单流统一序列建模:将文本、视频帧patch、音频波形token拼接为单一输入序列,由同一Transformer主干处理。
在此框架下,语言指令、嘴唇运动、身体姿态、声音频谱与镜头节奏在每一层都进行深度融合。模型内部设置两类专家:共享专家学习跨模态共性(如“说话”这一行为关联口型、语音与表情),专属专家则分别优化视觉细节或音频保真度。实测显示,该设计显著提升了人物对白的自然度、环境互动的实时性以及音乐节奏与镜头切换的协调性。
对于广告、短剧、动画等强依赖视听一致性的场景,这种端到端生成方式省去了后期对齐的繁琐工序,一次推理即可输出接近成品的完整镜头,大幅缩短内容生产周期。
开源的意义:从技术垄断到生态共建
MAGI Preview的另一重大价值在于其彻底开源。Sand.ai不仅公开了114B参数的模型权重,还发布了完整的训练代码与61页技术报告。这在视频生成领域尚属首次——此前开源模型多为小规模稠密架构,难以支撑复杂场景应用。
开源的核心意义不在于“免费”,而在于降低全行业的实验门槛。中小团队无需投入数千万美元训练基础模型,即可基于MAGI Preview进行微调、蒸馏或领域适配。例如,游戏公司可针对角色动作数据集进行LoRA微调,快速生成符合IP风格的过场动画;短视频平台可构建垂直领域的提示词优化器,提升用户生成内容的质量一致性。
这种开放生态有望加速技术迭代。正如DeepSeek在语言模型领域推动MoE普及一样,MAGI Preview可能成为视频生成领域的“基础设施”,催生更多围绕低成本、高质量视频生成的创新应用。
成本下降背后的产业变革
0.5元生成10秒1080P视频,表面看是价格数字,实质是生产范式的转变。过去,高昂成本迫使创作者“一次定稿”,容错率极低;如今,低成本允许进行多轮A/B测试——尝试不同运镜、角色动作、背景音乐,再从中筛选最优版本。这种“高频试错+快速迭代”的模式,更贴近真实创作逻辑。
对出海电商、信息流广告、独立游戏开发者而言,这意味着可将AI视频生成嵌入日常工作流:商品展示视频按需生成、广告素材每日批量更新、NPC对话动画动态合成。视频不再是高成本的“奢侈品”,而成为可规模化调用的“基础资源”。
此外,Sand.ai自身已验证商业化路径。其C端产品VidMuse上线两月ARR破千万美元,证明在音乐视频等垂直场景中,用户愿意为高质量、低延迟的AI生成服务付费。这为行业提供了清晰的变现参考。
结语:临界点已至
MAGI Preview的出现,标志着视频生成技术正从“实验室演示”迈向“生产级应用”。它用MoE架构打破了成本天花板,用单流设计解决了质量瓶颈,用彻底开源激活了生态创新。当推理成本降至0.5元、千亿模型向全球开放、音画同步成为标配,我们有理由相信:AI原生视频内容的大规模爆发,或许就在下一个季度。