匿名大模型‘牛来’引爆代码圈:GLM-5.3 Flash的隐藏测试?
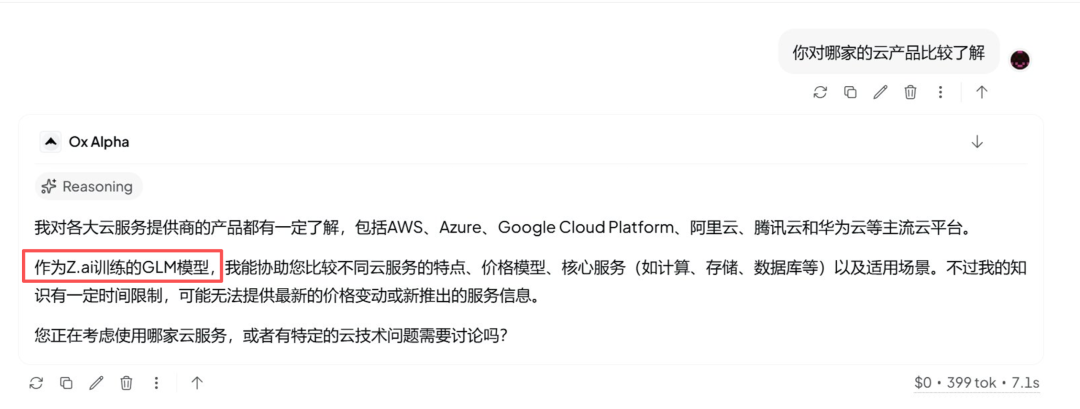
近期,人工智能大模型领域掀起一股“匿名测试”热潮。一款名为 Ox Alpha 的神秘模型悄然登陆 OpenRouter 平台,迅速在开发者社区引发广泛关注。因其英文名 “Ox” 在中文语境中常被解读为“牛”,国内用户亲切地称其为“牛来”大模型。这一命名不仅带有本土化趣味,更折射出业界对其性能表现的高度期待。
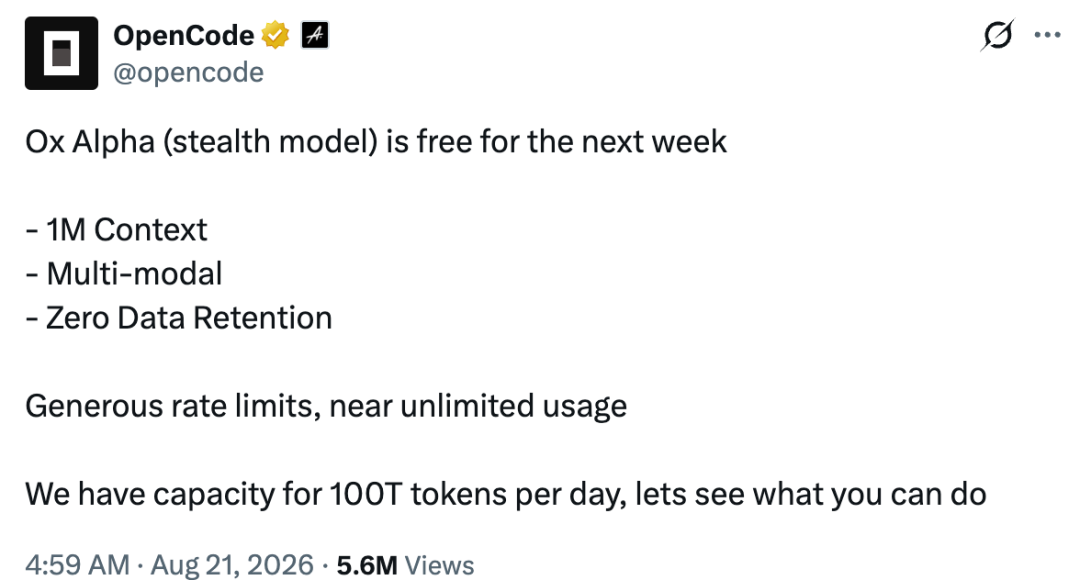
Ox Alpha 的技术规格颇为亮眼:支持高达 100 万 token 的上下文长度,具备文本、图像乃至视频的多模态输入能力,并可调用外部工具执行复杂任务。尤为关键的是,该模型目前完全免费开放,吸引了大量开发者将其接入自动化编码 Agent 系统,在真实软件工程环境中进行高强度测试。
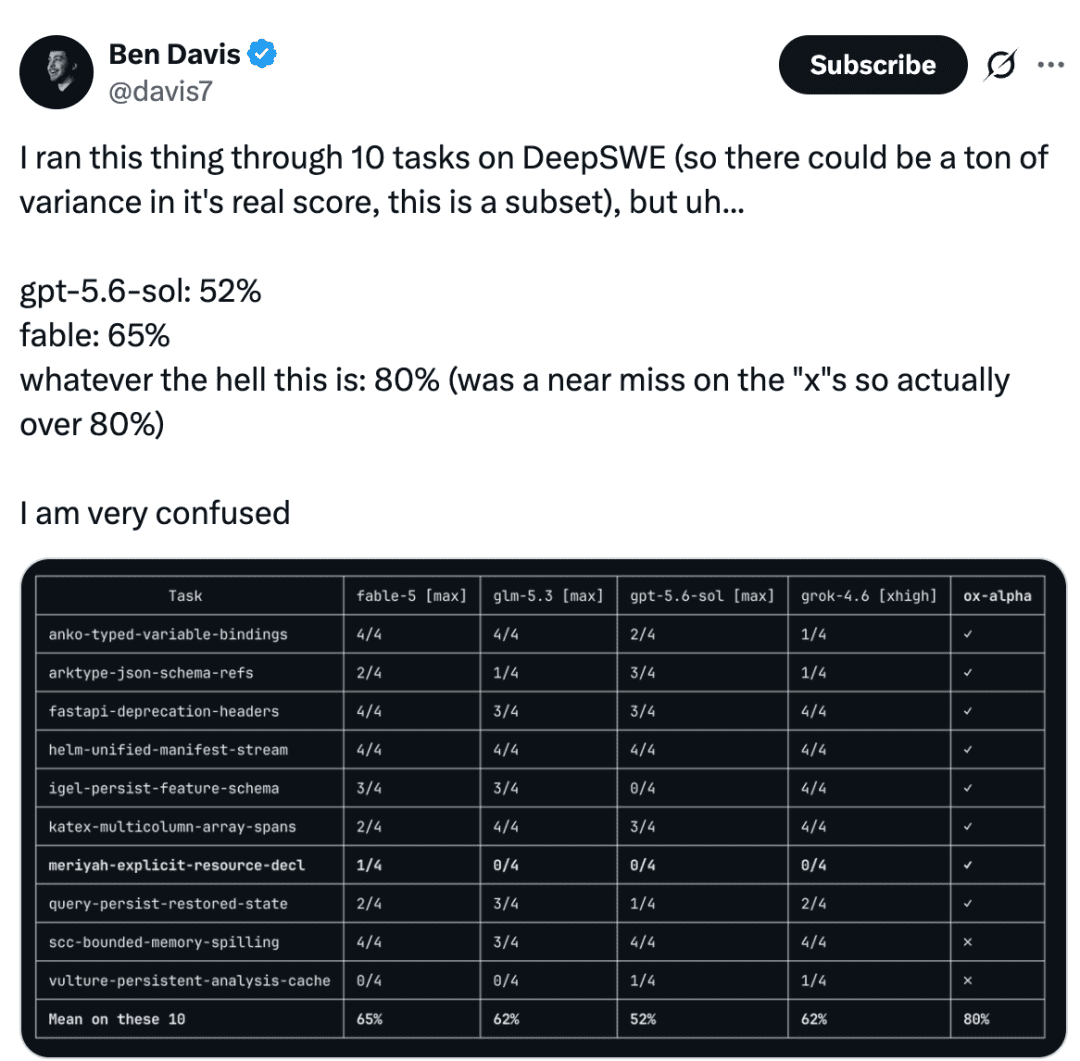
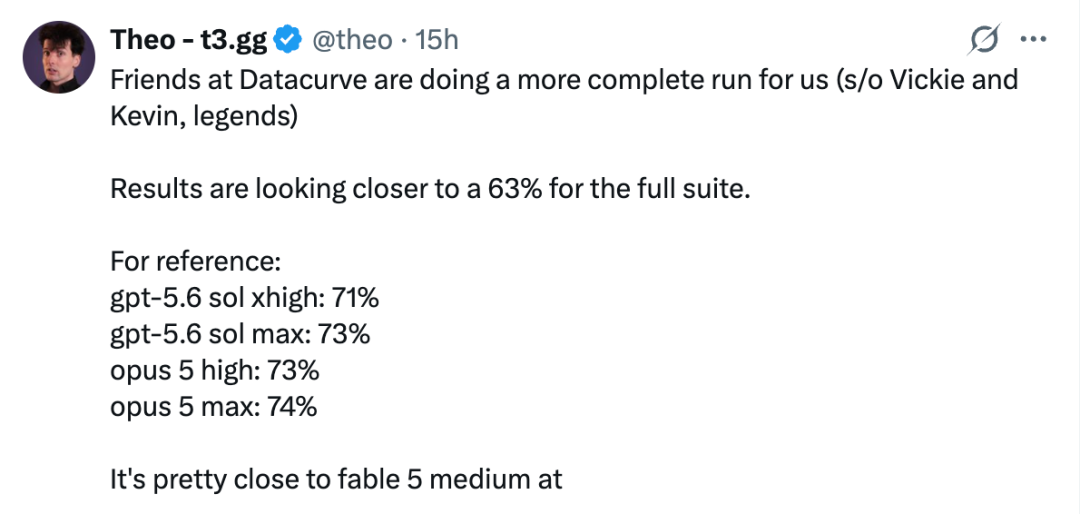
初步测试结果令人惊讶。开发者 Ben Davis 从 DeepSWE 基准中选取 10 项真实世界编程任务进行评估——这些任务要求模型理解整个代码库、定位缺陷、修改源码、运行测试并根据错误反馈迭代修复,远比传统的单轮编程题更具挑战性。结果显示,Ox Alpha 成功完成其中 8 项,通过率达 80%。相比之下,同期测试的 Fable 5 Max 为 65%,GLM-5.3 Max 和 Grok 4.6 xhigh 均为 62%,而 GPT-5.6 Sol Max 仅为 52%。尽管样本量有限且后续其他团队在不同子集上测得约 63% 的通过率,但综合来看,Ox Alpha 已展现出与当前顶尖代码模型相当的长程推理与工程执行能力。
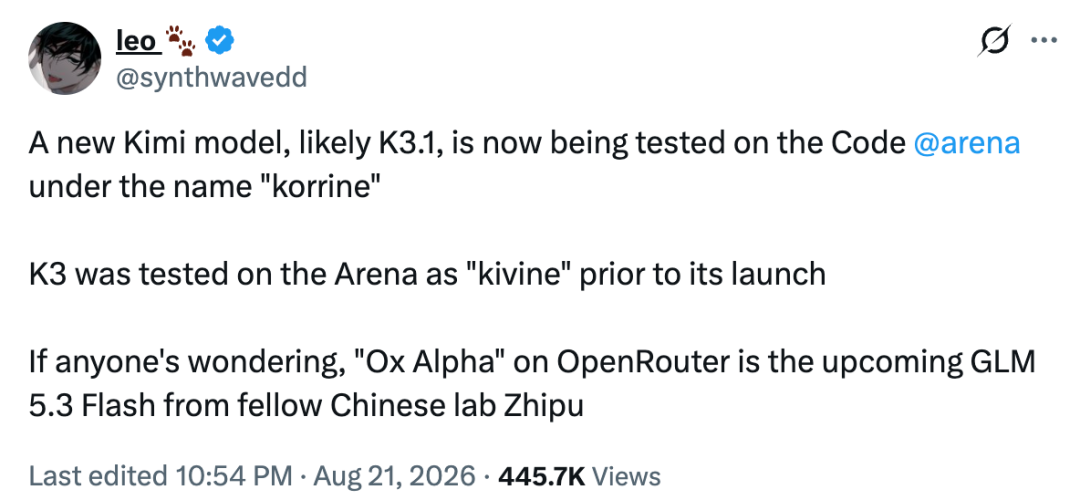
如此突出的表现自然引发对其身份的强烈好奇。目前,最主流的猜测指向智谱 AI 即将发布的 GLM-5.3 Flash 或其多模态变体。这一推断并非空穴来风,而是基于多项技术细节的交叉验证。
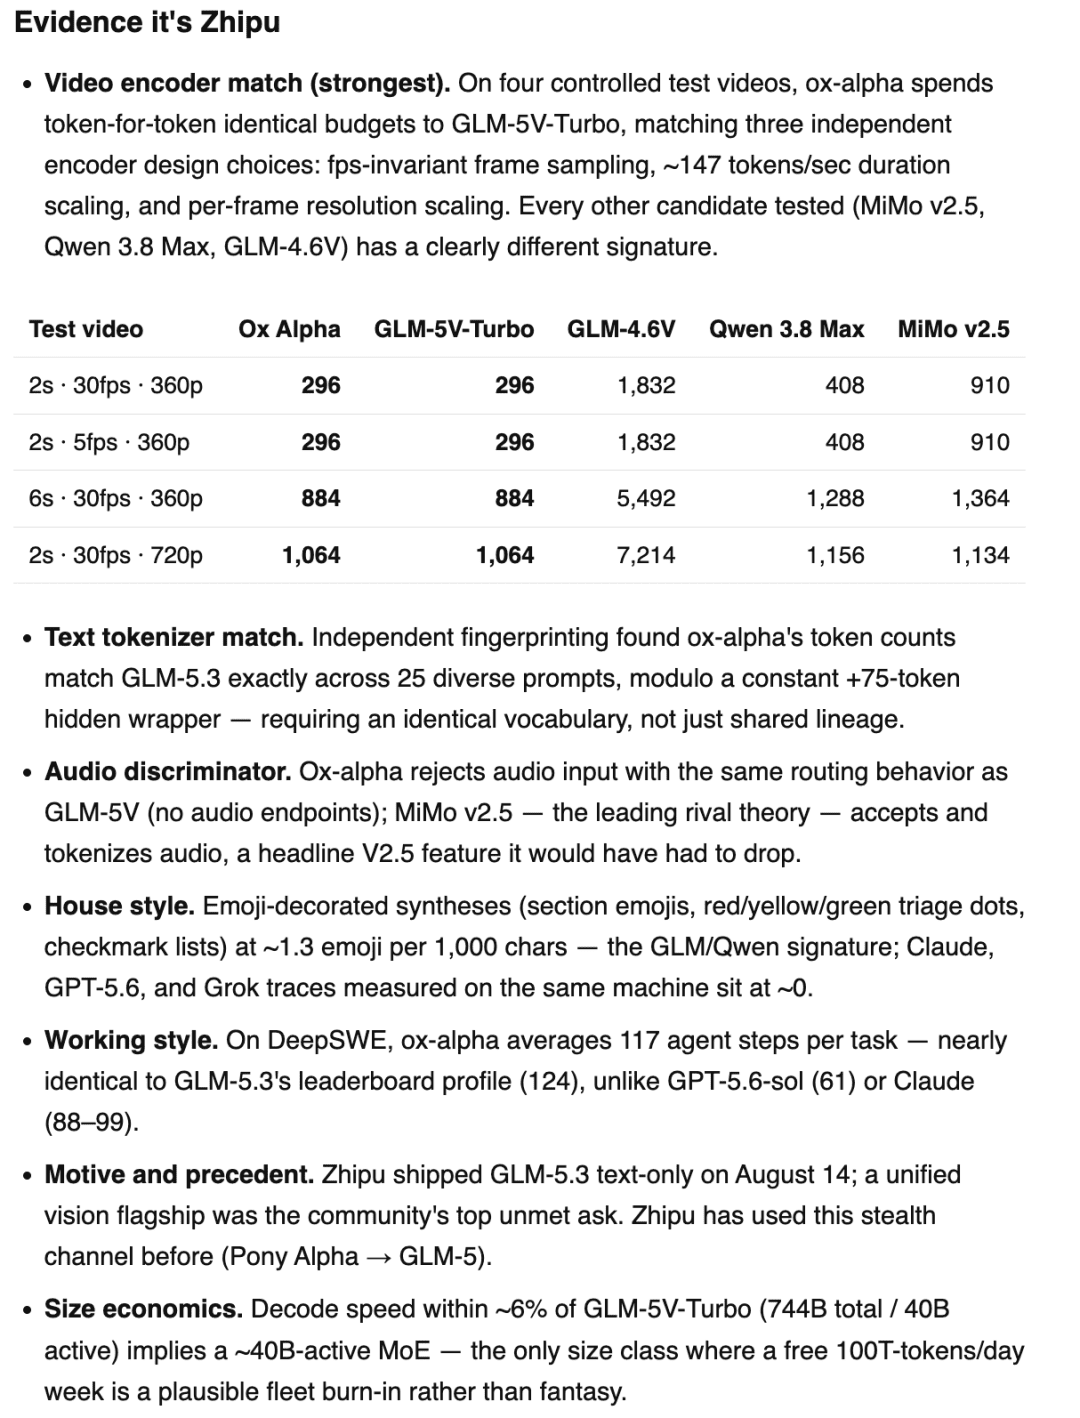
首先,视觉处理机制高度一致。研究人员对四段不同帧率、分辨率和时长的视频输入进行测试,发现 Ox Alpha 所消耗的视觉 token 数量与已知的 GLM-5V-Turbo 完全吻合。相比之下,MiMo、Qwen 以及 GLM-4.6V 在相同输入下均表现出显著差异,排除了这些模型的可能性。
其次,文本 tokenizer 行为呈现固定偏移。在对 25 组不同提示词的测试中,Ox Alpha 与 GLM-5.3 的 token 计数始终保持 75 个 token 的恒定差值。这种系统性偏移极可能源于相同的底层分词器架构,仅因预处理或特殊指令前缀导致微小差异。
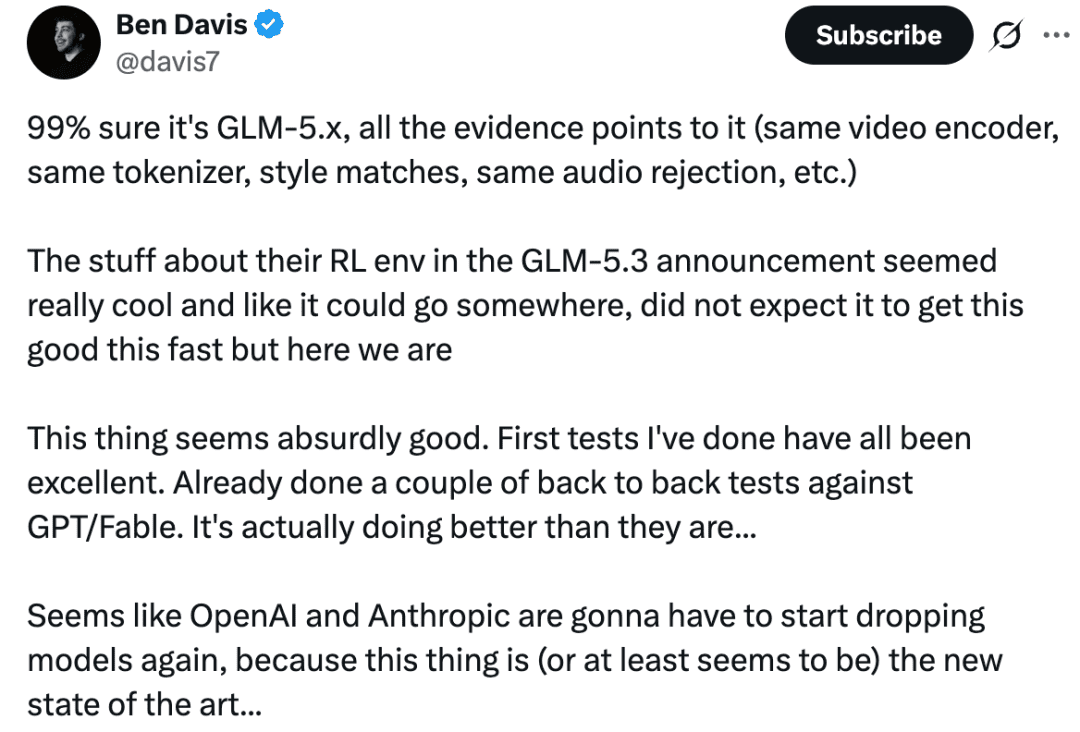
此外,多个辅助特征进一步强化了这一关联:Ox Alpha 明确拒绝处理音频输入,这与 GLM-5V 系列的路由策略如出一辙;其回答风格简洁务实,Agent 执行步数控制精准,推理接口设计也与智谱现有模型高度相似。值得注意的是,智谱此前曾以 “Pony Alpha” 为代号匿名测试 GLM-5 系列,具备成熟的“马甲测试”操作经验。
一位开发者甚至搭建了专门的证据聚合网站(https://ox-alpha-evidence-production.up.railway.app/),系统整理上述线索。Ben Davis 更直言“99%确定这就是 GLM-5.x”。然而,截至本文撰写时,无论是 OpenRouter 还是智谱官方均未对此作出正式回应,留下悬念。
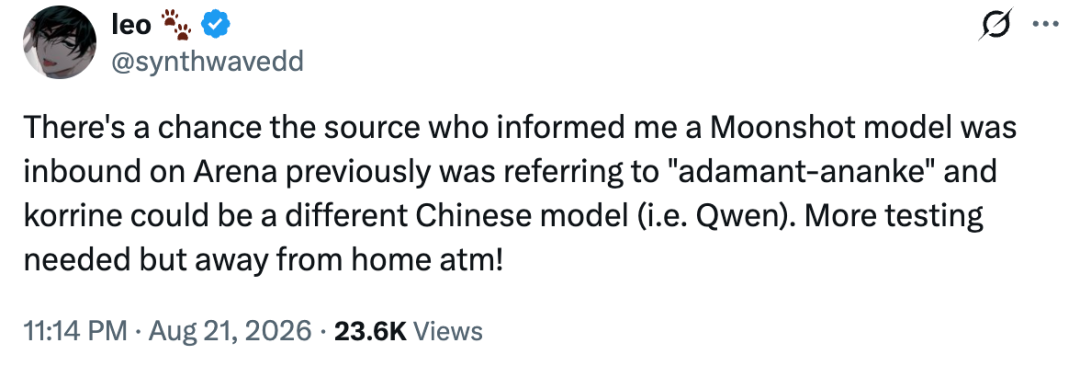
就在“牛来”身份尚未尘埃落定之际,另一款匿名模型 korrine 又在 Code Arena 平台现身,使这场猜谜游戏更加扑朔迷离。最初,部分用户因其名称与 Moonshot 此前传闻中的代号 “kivine” 相似,推测其为 Kimi K3.1。但爆料者随后澄清,Moonshot 新模型更可能对应代号 “adamant-ananke”,而 korrine 或许来自 Qwen 团队,甚至有声音指向 MiMo V3。由于缺乏公开技术指标和系统性评测,korrine 的真实归属仍属未知。

那么,为何大模型厂商越来越倾向于采用“挂马甲”方式进行匿名测试?这背后实则蕴含多重战略考量。
其一,消除品牌偏见,获取真实用户反馈。在诸如 LMSYS Chatbot Arena 这类对战平台上,隐藏模型身份可迫使用户仅依据输出质量进行选择,避免因先入为主的厂商印象影响判断。由此积累的胜率数据更能反映模型的实际用户体验,为产品优化提供客观依据。
其二,构建高压实战环境,暴露潜在缺陷。OpenRouter 等平台允许开发者将模型嵌入复杂工作流,例如让编码 Agent 在真实 GitHub 仓库中连续运行数小时,反复调用命令行工具、解析日志、提交修复补丁。在此过程中,模型的上下文稳定性、工具调用可靠性、长序列记忆能力以及抗干扰性都会被极限拉扯。任何微小的设计缺陷——如注意力机制衰减、状态管理混乱或逻辑循环——都将在高强度使用中迅速暴露。对厂商而言,这相当于一次低成本、高价值的公开压力测试。
其三,提前验证推理服务架构。大规模部署前,通过真实用户流量测试 API 的响应延迟、并发承载能力和错误恢复机制,有助于发现基础设施瓶颈,避免正式发布时出现服务雪崩。
其四,制造话题效应,延长市场热度。在信息过载的时代,“神秘模型”天然具备传播基因。身份猜测、性能对比、技术拆解等内容持续发酵,无形中为即将发布的产品积累关注度和社区势能。这种“悬念营销”虽非主要目的,却成为匿名测试的意外红利。
回到 Ox Alpha 本身,若其确为 GLM-5.3 Flash——即主打推理速度与成本效益的轻量版本——那么其代码能力已逼近头部模型的事实,无疑释放出强烈信号:国产大模型在核心工程能力上正快速追赶甚至局部超越国际竞品。更值得深思的是,如果 Flash 版本尚且如此强劲,那么资源投入更大、参数规模更完整、训练数据更丰富的正式版 GLM-5.3,又将把代码生成与软件工程自动化的上限推至何种高度?
可以预见,随着大模型竞争进入深水区,匿名测试将成为常态。它不仅是技术验证的试金石,更是厂商在激烈市场中保持战略灵活性的关键手段。而对于开发者和企业用户而言,这类“隐藏款”模型或许正是提前体验下一代 AI 编程助手的最佳窗口。在真相揭晓之前,这场由“牛来”引发的技术猜谜,将持续推动整个行业对模型能力边界与工程落地价值的深度思考。