CFT突破人像重打光瓶颈:如何让AI精准控制光影而不失真?
在数字影像日益普及的今天,人像修图早已不再是专业摄影师的专属技能,而是普通用户日常表达自我的重要方式。其中,“换光效”是最常见也最具挑战性的需求之一。一句“把光线调成午后暖阳”或“换成霓虹灯下的赛博氛围”,看似简单,背后却涉及复杂的光照建模与图像生成逻辑。然而,当前基于AI的人像重打光技术在实际应用中频频遭遇瓶颈:光照方向混乱、肤色偏移、面部结构扭曲,甚至出现“修完不像自己”的尴尬局面。
这些问题的根源,在于现有方法未能有效解耦“光照变化”与“非光照内容”(如身份、表情、几何结构)。目前主流的三类基于扩散模型的重打光方案各有短板。第一类是控制信号驱动(Control-based)方法,通过边缘图、法线图或光照探针等显式控制信号引导生成。虽然可控性有所提升,但结果高度依赖这些信号的准确性和完整性——一旦输入信号存在噪声或缺失,输出质量便急剧下降。第二类是本征分解驱动(Decomposition-based)方法,试图将图像分解为反照率、法线、光照等物理成分后再重组。这类方法在理想条件下效果不错,但在复杂真实场景中,分解过程极易出错,微小的误差会在后续重建中被放大,导致阴影不一致、颜色失真或细节丢失。第三类是直接图到图翻译(Image-to-image translation)方法,将重打光视为端到端的映射任务。这类方法虽简洁,但未显式建模“光照专属”的特征位移,导致编辑精度不足,难以实现精细的光影控制。
更深层的制约因素在于数据。现有的公开人像重打光数据集,如MIT Intrinsic Images in the Wild、Relighting Humans等,大多在受控实验室环境下采集,光照类型单一(多为均匀点光源或简单环境光),缺乏真实世界中常见的复杂光照效果——例如室内混合光源(窗光+台灯+屏幕反光)、室外多时段色温变化、舞台灯光的空间结构化照明等。这种数据偏差使得模型在面对真实用户上传的照片时,泛化能力严重受限。
针对上述挑战,美图影像研究院(MT Lab)提出了Consistent Feature Transport(CFT,一致特征传输)方法,将人像重打光问题重新表述为“在保持身份与场景结构不变的前提下,实现光照特征的一致性传输”。该工作已被计算机视觉顶级会议ECCV 2026录用,标志着在可控图像编辑领域的重要突破。
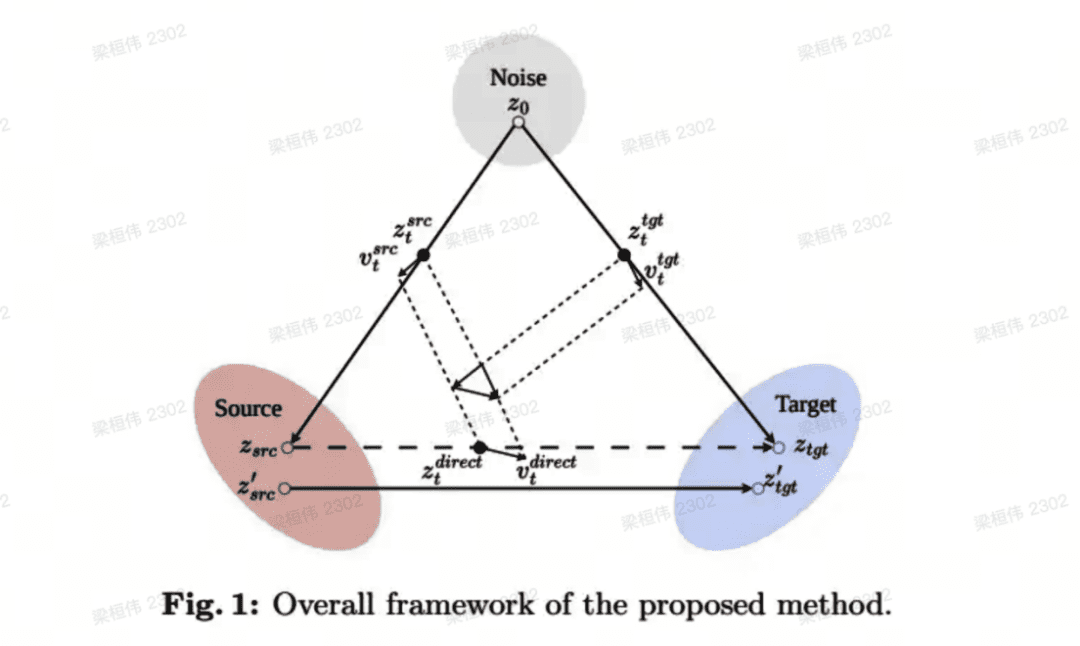
CFT的核心创新在于其三重联合建模机制,在Rectified Flow这一新兴生成框架下实现高效稳定的特征传输。Rectified Flow因其线性轨迹和低采样步数优势,近年来在图像生成任务中备受关注。CFT在此基础上,构建了三个相互关联的学习目标:
首先是噪声→目标图(L₁)。给定源图像xsrc、目标重打光图像xtgt以及描述目标光照的文本条件ctgt(如“伦勃朗光”、“霓虹夜景”),模型学习从标准高斯噪声到目标图像潜在表示(latent)的速度场。这是典型的条件生成任务,确保模型能够根据语义指令生成符合预期的光照效果。
其次是噪声→源图(L₂)。在同一组噪声输入下,模型以“中性光照”条件csrc(如均匀白光)重建源图像。这一路径的关键作用在于强化对非光照内容的保持能力。通过强制模型在不同光照条件下都能准确还原原始身份、面部几何和背景结构,L₂有效防止了重打光过程中出现的身份漂移或结构变形。
而真正体现CFT思想精髓的是第三部分:源图→目标图的光照一致特征传输(L₃)。这里借鉴了无反演编辑(inversion-free editing)的思路,利用Rectified Flow的线性性质,通过平行四边形法则构造一条从源图到目标图的直接传输路径。具体而言,若ztsrc和zttgt分别是从源图和目标图反推回时间t的潜在表示,则直接传输的潜在状态可表示为ztdirect = zsrc + (zttgt - ztsrc)。对应的速度场则由两个条件速度场相减得到:vtdirect = vθ(zttgt, t, xsrc, ctgt) - vθ(ztsrc, t, xsrc, csrc)。
值得注意的是,L₃的监督信号并非来自同一人物的(xsrc, xtgt)配对,而是来自不同人物但经历相同光照变换的图像对。例如,一组在“午后暖阳”下拍摄的不同人脸图像。这种设计避免了模型过度拟合特定样本的内容差异,迫使它学习一种可跨实例复用的、纯粹的光照变换模式。换言之,模型学到的不是“如何把A变成B”,而是“如何将任意人脸从光照X转换到光照Y”。这种泛化能力正是解决真实场景多样性的关键。
为了支撑CFT在复杂光照下的训练,研究团队还构建了一个大规模人像重打光数据集。该数据集覆盖室内、室外、舞台、夜景等主流场景,包含14类光照效果类别,特别强调空间结构化照明(如侧逆光、顶光、底光)、多色温混合(如冷暖对比)以及非均匀阴影(如百叶窗投影、树叶斑驳)。这一数据资源有效弥补了现有基准在复杂光效上的不足,为模型提供了更贴近真实世界的训练信号。
实验结果充分验证了CFT的有效性。在自建测试集上,CFT在多个维度均显著优于现有方法:像素保真度(PSNR/SSIM)更高,说明细节还原更准确;感知相似度(LPIPS)更低,意味着视觉上更接近真实图像;分布真实感(FID)更优,反映整体图像质量更自然;同时在专门设计的光照专用指标(如光照方向一致性、色温准确性)上也表现突出。
定性分析进一步揭示了CFT的优势。在多光源交互场景(如室内窗光与台灯共存)、空间结构化照明(如戏剧性侧光)以及色温大幅偏移(如从正午日光切换到烛光)等困难案例中,CFT生成的图像不仅光照效果逼真,而且面部身份、五官比例、皮肤纹理等关键特征保持高度一致,未出现常见的“换脸”或“塑料感”问题。
用户研究也佐证了这一点。在一项包含30名参与者、40组随机样本的双盲评估中,Flux-Kontext + CFT组合在四项关键指标上均获得最高分:光照质量(IQ)——光影是否符合物理规律且美观;内容一致性(CC)——是否仍是同一个人;物理合理性(PP)——阴影方向、高光位置是否逻辑自洽;图像美学(IA)——整体视觉吸引力。这表明CFT不仅在技术指标上领先,在用户体验层面也更具优势。
消融实验则深入剖析了各组件的作用。单独使用L₂(源图重建)并不能提升重打光质量,但与L₃联用时能提供额外的结构约束,使完整CFT效果最优。反之,若L₃使用原始(xsrc, xtgt)配对或完全随机配对进行监督,性能反而下降,甚至不如仅使用L₁的基线模型。此外,对传输速度场的方差分析显示,完整CFT在训练集和测试集上均具有最低方差,证明其确实学习到了更稳定、更一致的光照特征传输场。
更令人振奋的是,CFT的“一致特征传输”思想具有良好的可泛化性。研究团队将其应用于风格迁移任务,在OmniStyle-150k数据集上构建风格迁移对,并集成到OmniStyle与Qwen-Image-Edit等系统中。结果显示,CFT在保持内容结构和感知保真的同时,实现了更平衡、更自然的风格化效果。这表明,该方法不仅适用于光照编辑,还可推广至色彩调整、材质迁移、艺术风格转换等多种属性编辑任务,展现出作为通用图像编辑范式的潜力。
目前,基于CFT的图片打光能力已上线美图旗下多款产品,包括Picchi、AirBrush与BeautyPlus。用户无需输入冗长的技术性提示词,只需选择预设的光效模板(如“电影感侧光”、“柔雾晨光”),即可一键获得专业级的光影效果。这种“所见即所得”的体验,正是AI技术从实验室走向大众消费场景的典型例证。

总的来说,CFT通过重新定义人像重打光问题,结合创新的三重损失设计与高质量数据集构建,在保持身份一致性的前提下,实现了对复杂光照的精准、稳定控制。它不仅解决了当前AI修图中的痛点,也为未来可控图像生成提供了新的方法论思路——即在生成过程中显式建模“变化”与“不变”的边界,让AI真正理解并尊重图像中的语义结构。