GLM-4.7与MiniMax M2.1限免:工程级Agent模型如何重塑开发流
在大模型技术浪潮从“尝鲜”走向“深耕”的关键节点,行业关注的焦点已悄然转移。过去,我们惊叹于模型生成文本的流畅度或单次问答的准确性;如今,面对真实复杂的业务场景,工程交付的稳定性、长时任务的执行效率以及多步逻辑的连贯性,成为了衡量模型价值的硬指标。这一转变标志着大模型应用正式进入“工程化落地”深水区。在此背景下,智谱AI推出的GLM-4.7与MiniMax发布的M2.1模型,作为国产大模型阵营中两条差异化成熟路线的代表,不仅突破了单轮生成的局限,更在长期稳定运行能力上展现了显著优势。而AI Ping平台通过整合多方资源,将这两款旗舰模型以限免形式开放,并辅以统一的调度机制,为开发者搭建了一座从技术选型到实际落地的便捷桥梁。
工程化视角下的模型分化:稳定交付与高效执行的博弈
在传统的软件开发范式中,代码生成往往被视为一种辅助手段,但在AI-native的组织形态下,Agent(智能体)正在成为新的生产力单元。这就要求底层模型不仅要“懂代码”,更要“懂工程”。GLM-4.7与MiniMax M2.1虽然都指向工程级应用,但其技术侧重点截然不同,这种差异源于对“工程难题”不同维度的解构。
GLM-4.7的核心竞争力在于“可控性”与“复杂性管理”。在面对涉及多个技术栈、需要长时间规划的任务时,模型容易陷入逻辑发散或指令遵循偏差。GLM-4.7通过强化可控推理机制,使得模型在执行多步任务时能够保持高度的指令一致性。其支持的200K长上下文窗口,并非仅仅是数字上的堆砌,而是为了容纳庞大的项目代码库、文档规范以及历史交互记录,从而确保模型在理解全局语境的基础上做出决策。这种设计思路特别适合那些需要深度理解现有系统架构、进行重构或复杂功能开发的场景。
相比之下,MiniMax M2.1则选择了“效率”与“广度”作为突破口。依托高效的混合专家(MoE)架构,M2.1在激活参数量较低的情况下,实现了极高的推理吞吐量和较低的延迟。这对于需要频繁交互、快速迭代的开发流程至关重要。更重要的是,M2.1在Rust、Go、Java、C++等多语言生产级代码能力上进行了系统性强化。在现代微服务架构中,多语言混合编程已成常态,M2.1的这种通用性使其能够胜任跨语言的模块集成与调试任务。其收敛的推理路径设计,减少了不必要的思维跳跃,使得长链Agent的执行更加稳定,适合持续性的工作流自动化。
深度解析GLM-4.7:复杂任务中的定海神针
GLM-4.7作为智谱最新的旗舰模型,其在Agentic Coding(代理式编程)场景下的表现尤为引人注目。在多个公开基准测试中,GLM-4.7在开源模型梯队中取得了领先位置,这背后是对其底层推理能力的全面升级。除了通用的语言理解能力提升外,GLM-4.7在回复的自然度与沉浸感上也做了大量优化,这使得它在与人机协作的过程中,沟通成本大幅降低。
在实际的工程实践中,工具调用(Tool Use)是Agent能力的试金石。GLM-4.7增强了指令遵循能力,能够更精准地识别何时需要调用外部工具,以及如何构建正确的参数。例如,在前端开发中,Artifacts的生成不仅要求代码正确,还要求视觉美感与交互逻辑的统一。GLM-4.7在这一领域的提升,意味着它能够直接输出更符合设计师意图的前端组件,减少了人工调整UI细节的时间。此外,其在长程任务完成效率上的优化,使得处理跨越数百行代码的逻辑修改成为可能,而不会出现中途遗忘初始需求的情况。
对于开发者而言,选择GLM-4.7意味着选择了一种“稳健”的开发伙伴。它可能不是响应最快的,但在处理那些一旦出错就会导致系统崩溃的关键逻辑时,其提供的可靠性是无价的。特别是在涉及数据库迁移、安全权限配置等高风险操作中,GLM-4.7的可控推理机制能够有效降低幻觉产生的概率,确保每一步操作都在预期轨道上运行。
深度解析MiniMax M2.1:高吞吐MoE架构的效率革命
如果说GLM-4.7是深思熟虑的架构师,那么MiniMax M2.1就是雷厉风行的全栈工程师。M2.1的最大亮点在于其高效的MoE架构。在传统稠密模型中,每次推理都需要激活所有参数,导致计算资源消耗巨大且延迟较高。而MoE架构通过动态路由,仅激活处理当前任务所需的专家网络,从而在保证性能的同时大幅降低了计算成本。这一特性使得M2.1在高并发场景下依然能保持稳定的低延迟响应。
在多语言编程支持方面,M2.1的表现堪称全面。它不仅精通Python和JavaScript这些热门语言,更在Rust、Go、C++等系统级语言上展现了深厚的功底。这对于从事底层开发、高性能计算或嵌入式系统的团队来说,是一个巨大的利好。M2.1能够准确理解这些语言特有的内存管理规则和并发模型,生成符合最佳实践的代码片段。例如,在编写Rust代码时,它能有效避免常见的借用检查错误;在处理Go协程时,它能合理建议通道的使用方式以防止死锁。
此外,M2.1在长链Agent执行中的稳定性也得益于其收敛的推理路径。在连续编码任务中,模型需要不断参考前文生成的代码来维持上下文的一致性。M2.1通过优化注意力机制,减少了对无关信息的关注,使得其在长文本生成过程中不易偏离主题。这种特性使其非常适合用于自动化脚本编写、批量数据处理管道构建等需要连续输出的场景。
数据背后的真相:多供应商实测与性能对比
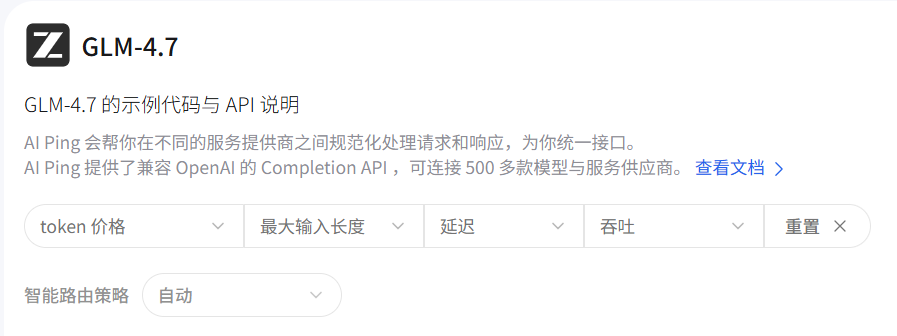
理论上的优势需要通过实际数据来验证。AI Ping平台整合了包括SophNet、UCloud、七牛云、智谱官方、无问芯穹、PPIO派欧云等多家供应商的资源,为我们提供了丰富的对比维度。
在GLM-4.7的测试中,SophNet的表现尤为突出,其吞吐量达到了175.93 tokens/s,首字延迟仅为0.26秒,且在200K的上下文长度下保持了100%的可靠性。这意味着在大规模代码库的分析任务中,SophNet能够提供极速且稳定的服务。相比之下,UCloud在吞吐和延迟上略逊一筹,但依然处于第一梯队。值得注意的是,七牛云和智谱官方的可靠性数据显示为94%,这在某些对稳定性要求极高的生产环境中可能需要谨慎评估。无问芯穹虽然将上下文长度限制在128K,但其可靠性同样达到了100%,适合中等规模项目的快速迭代。PPIO派欧云在各项指标上相对偏弱,但在价格敏感型场景中仍具吸引力。
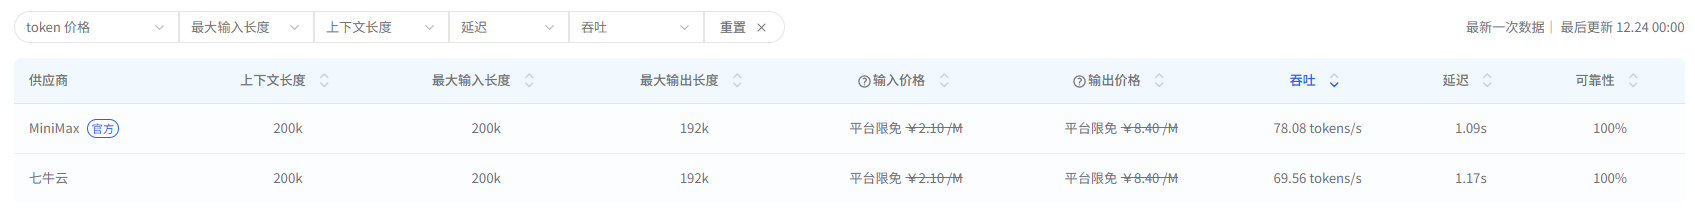
对于MiniMax M2.1,主要对比的是MiniMax官方与七牛云两家供应商。两者均支持200K输入和192K输出,且可靠性均为100%。MiniMax官方在吞吐量(78.08 tokens/s)和延迟(1.09秒)上略优于七牛云(69.56 tokens/s,1.17秒)。虽然差距不大,但在高频调用的场景下,官方接口的微弱优势可能会累积成显著的体验差异。然而,七牛云作为云服务巨头,其在网络稳定性和全球节点覆盖上可能具有潜在优势,用户可根据自身部署地域灵活选择。
智能路由与统一接口:降低接入门槛的技术基石
面对如此多样的供应商和性能指标,手动切换API不仅繁琐,而且容易出错。AI Ping平台提供的智能路由功能,正是为了解决这一痛点。通过统一的OpenAI兼容接口,开发者无需关心底层具体由哪家供应商提供服务,只需设定偏好策略,平台即可自动选择最优路径。
在代码实现层面,这种抽象极大地简化了集成过程。开发者只需初始化一个标准的OpenAI客户端,指定base_url为AI Ping的地址,并填入API Key。在发起请求时,通过extra_body参数,可以精细控制路由策略。例如,可以指定只使用某些供应商(only),或者按照特定顺序优先尝试(order),甚至可以设定价格范围、吞吐量阈值和延迟上限。这种灵活性使得应用程序能够根据实时负载和成本预算,动态调整模型调用策略。
以下是一个典型的Python调用示例,展示了如何通过流式输出获取GLM-4.7的回复,并处理推理内容(reasoning_content)和最终内容(content):
from openai import OpenAI

openai_client = OpenAI(
    base_url="https://www.aiping.cn/api/v1",
    api_key="YOUR_API_KEY_HERE"
)

response = openai_client.chat.completions.create(
    model="GLM-4.7",
    stream=True,
    extra_body={
        "provider": {
            "sort": "latency_asc"  # 按延迟升序排列,优先选择最快供应商
        }
    },
    messages=[
        {"role": "user", "content": "请解释一下MoE架构的优势"}
    ]
)

for chunk in response:
    if not getattr(chunk, "choices", None):
        continue

    reasoning_content = getattr(chunk.choices[0].delta, "reasoning_content", None)
    if reasoning_content:
        print(reasoning_content, end="", flush=True)

content = getattr(chunk.choices[0].delta, "content", None)
    if content:
        print(content, end="", flush=True)
此外,为了支持多轮对话,开发者需要在本地维护消息历史列表。每次用户输入后,将其追加到列表中,并将模型的完整回复也加入列表,以便在下一次请求时提供给模型作为上下文。这种状态管理虽然简单,却是实现连贯交互的关键。
VSCode Cline集成:将模型能力嵌入开发全流程
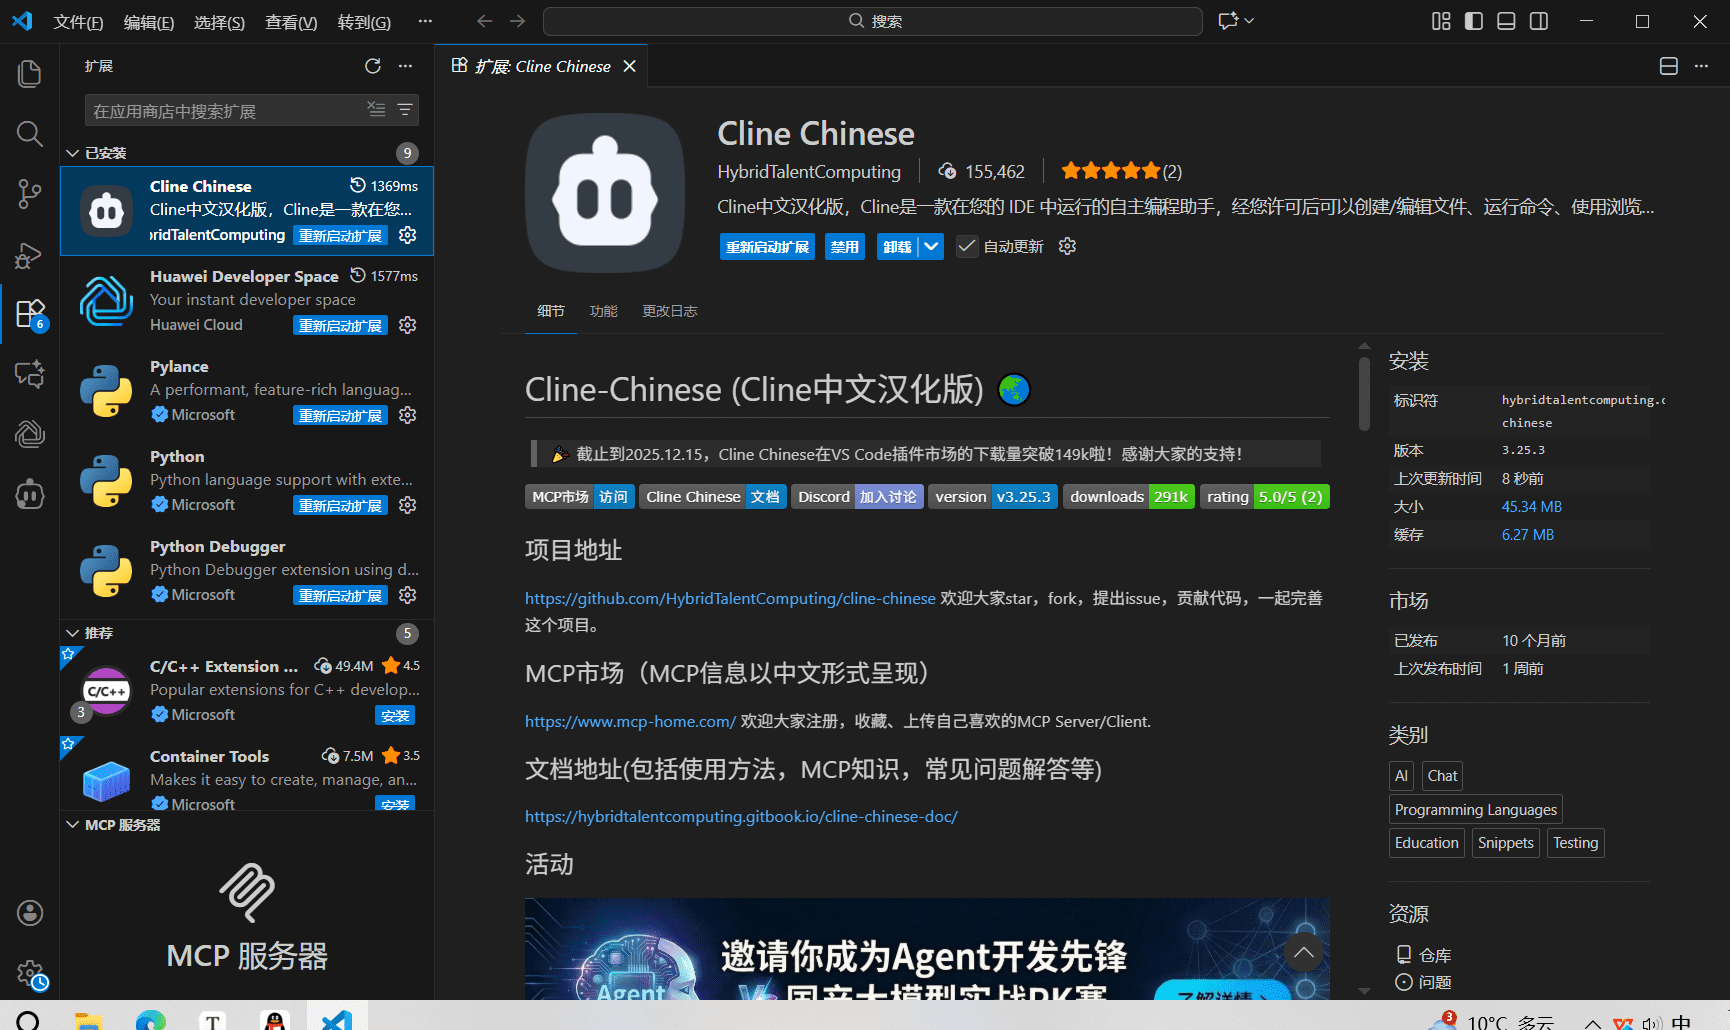
真正的工程化落地,不仅仅是在终端里跑几个测试用例,而是要将模型能力无缝嵌入到开发者的日常工具链中。VSCode作为最流行的代码编辑器之一,其插件生态极为丰富。Cline插件作为一款强大的AI编程助手,支持通过OpenAI兼容接口接入任意模型。
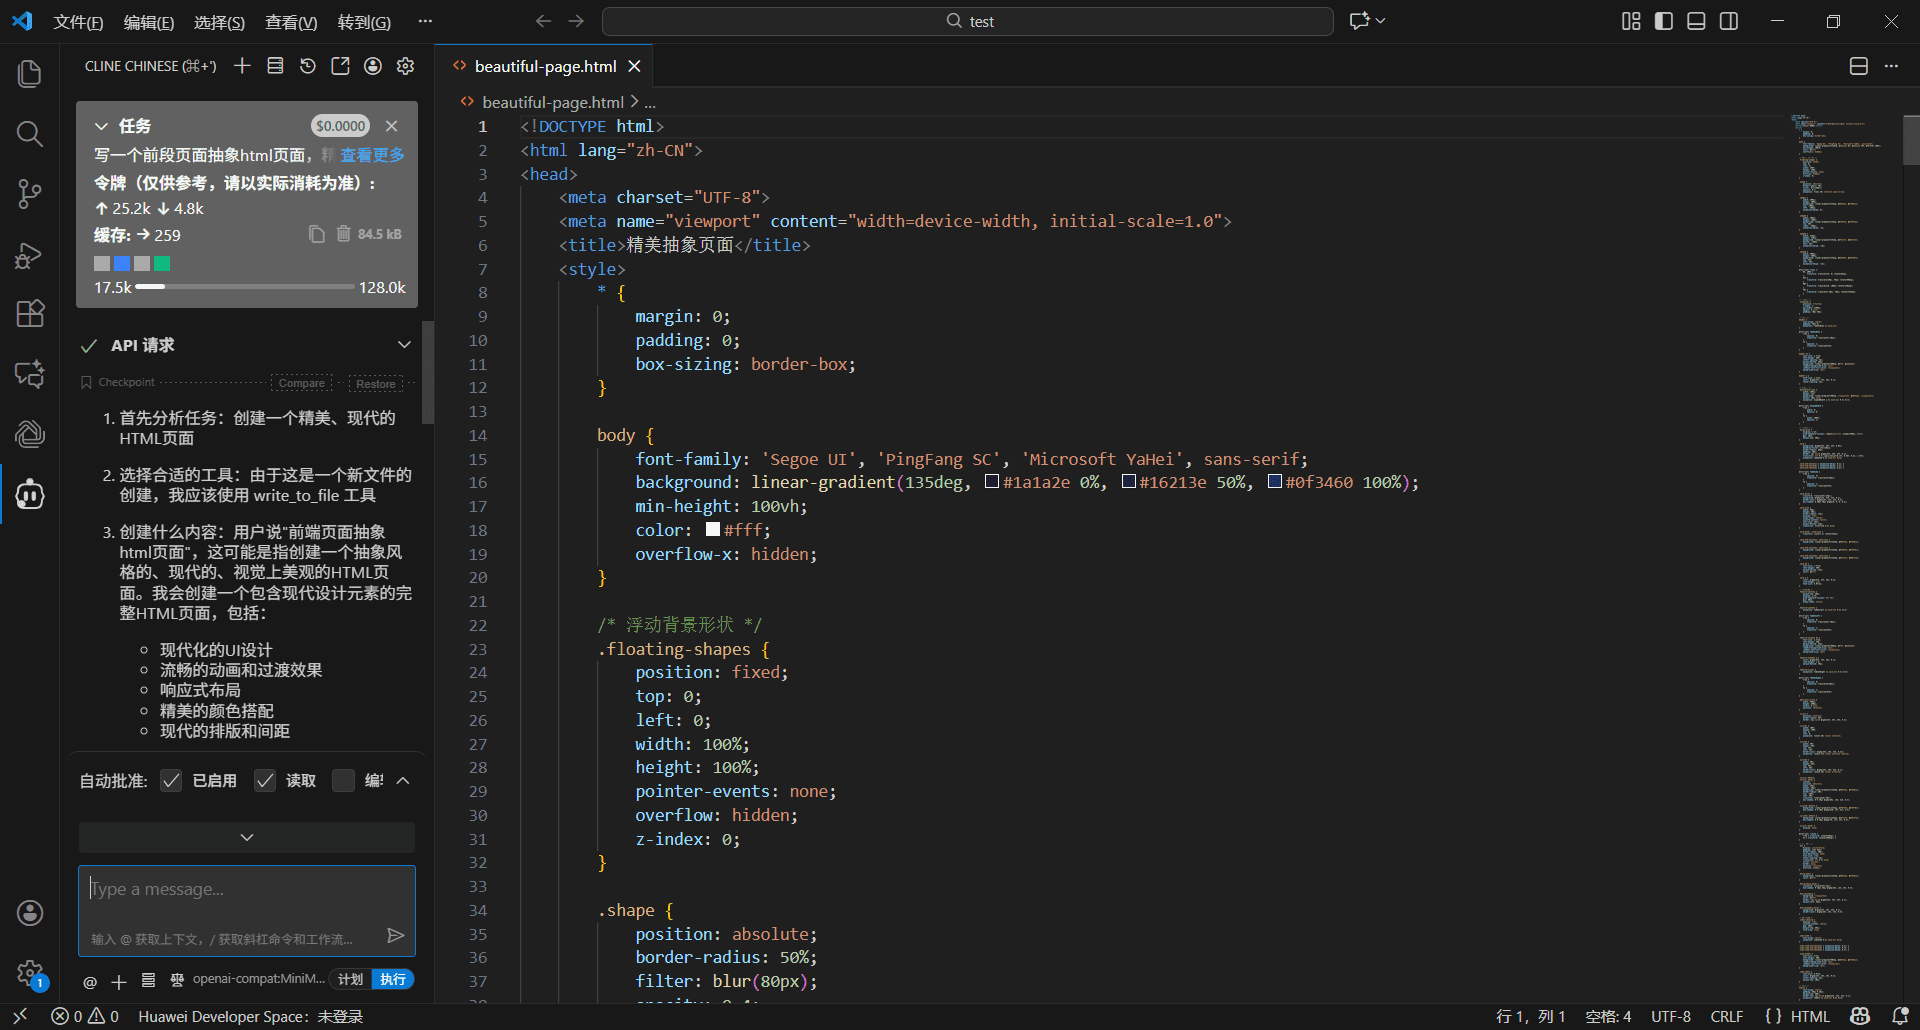
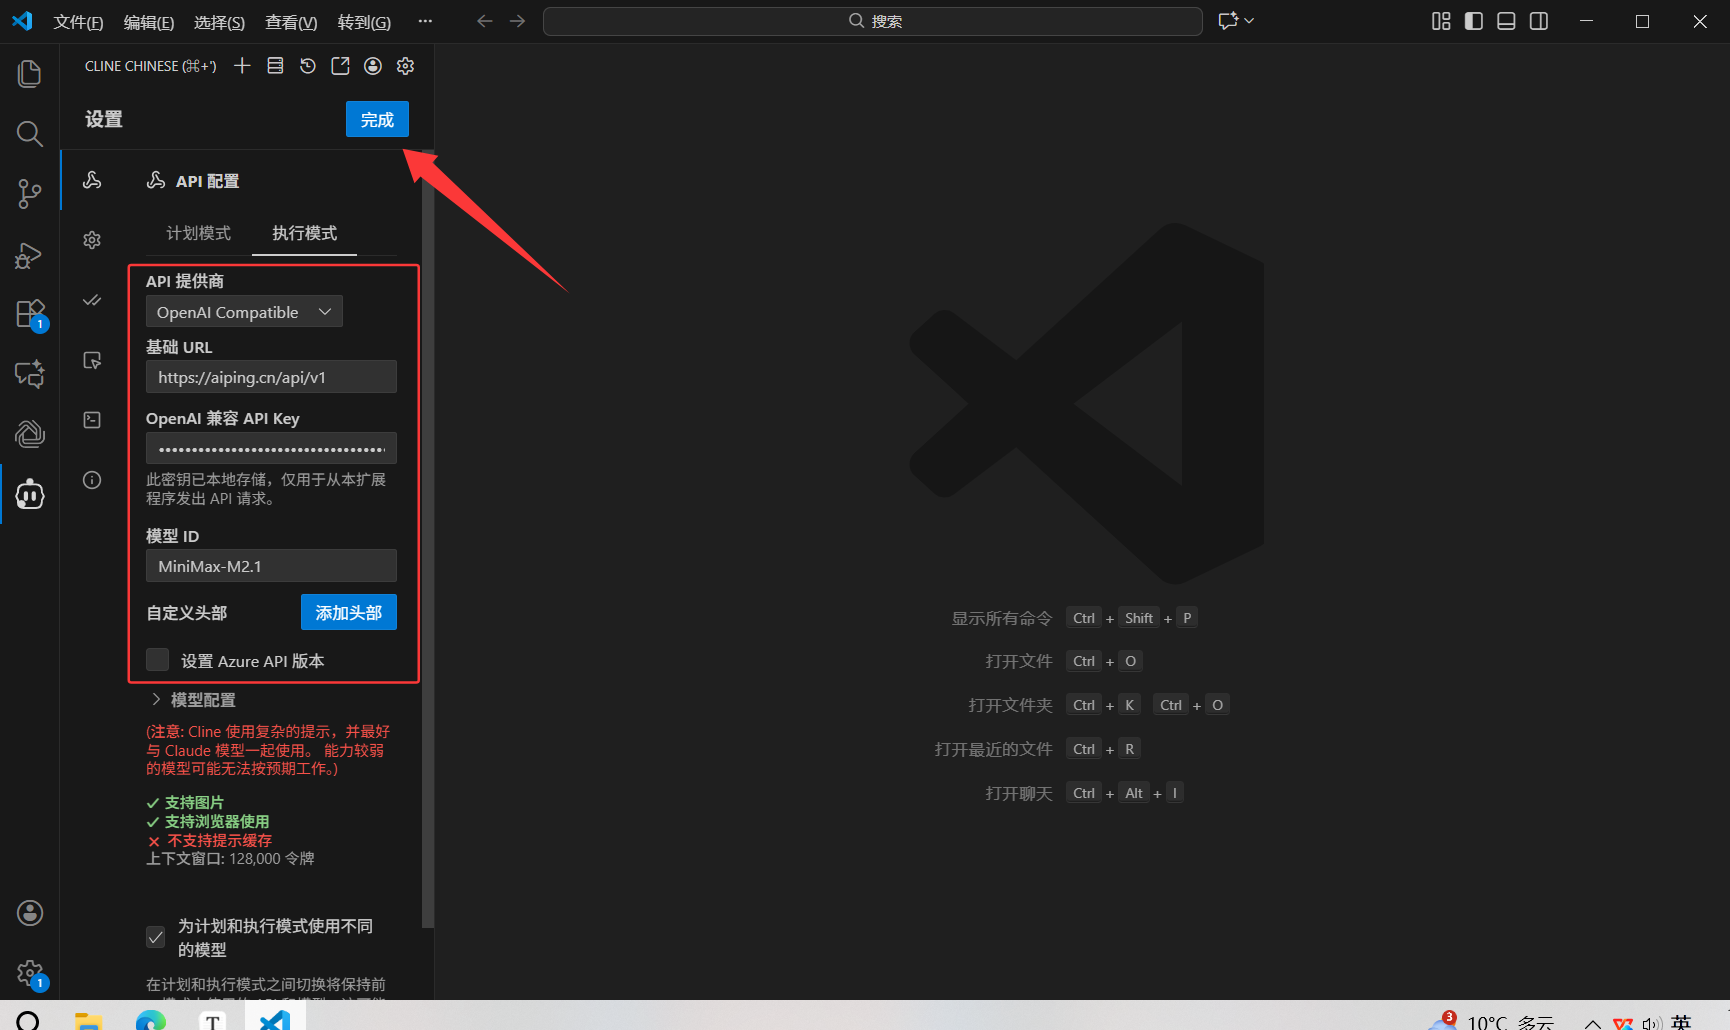
在VSCode中集成AI Ping的流程非常直观。首先安装Cline插件,然后在设置中选择“OpenAI Compatible”作为API提供商。接着,填入AI Ping提供的Base URL和API Key,并将模型ID设置为“MiniMax-M2.1”或“GLM-4.7”。保存配置后,Cline即可直接调用这些模型进行代码生成、解释、重构甚至自动修复Bug。
这种集成带来的价值是巨大的。开发者可以在编写代码的同时,随时唤起AI助手询问最佳实践,或者让AI审查当前文件的潜在风险。由于Cline支持多轮对话和文件上下文引用,模型能够准确理解当前项目的结构,生成的代码更具针对性。同时,AI Ping后台提供的可视化看板,让开发者能够实时监控调用次数、Token消耗和费用情况,便于团队进行成本控制和资源优化。
结语:拥抱工程化,释放AI生产力
GLM-4.7与MiniMax M2.1的限免上线,不仅是两家厂商技术实力的展示,更是国产大模型在工程化道路上迈出的坚实一步。它们分别代表了“稳定可控”与“高效通用”两种不同的技术哲学,为不同场景下的应用提供了多样化的选择。而AI Ping平台通过聚合资源、统一接口和智能路由,消除了技术选型的壁垒,让开发者能够专注于业务逻辑本身,而非底层基础设施的搭建。
在这个AI赋能软件工程的新时代,掌握这些工具的使用技巧,理解其背后的技术原理,将成为每一位开发者的核心竞争力。无论是利用GLM-4.7处理复杂的系统重构,还是借助MiniMax M2.1加速多语言模块的开发,亦或是通过智能路由优化成本结构,都是通往高效开发之路的重要实践。随着技术的不断迭代,我们有理由相信,未来的软件开发将更加智能化、自动化,而这一切,始于当下的每一次尝试与探索。