AI数据赛道狂飙:年收暴涨百倍背后的底层逻辑与未来变局
在人工智能产业的宏大叙事中,聚光灯往往长期停留在算力芯片的军备竞赛与大模型的参数规模上。然而,当我们将视线移向产业链的深处,一个隐秘而庞大的市场正在悄然爆发。AI训练数据,这个曾经被视为一次性消耗品的环节,如今已演变为决定模型能力上限的核心资产。近期市场数据显示,部分头部数据公司的年化收入在短短一年内实现了惊人的百倍增长,这不仅是一个财务奇迹,更是AI产业底层逻辑发生根本性shift的信号。
这种爆发式增长并非偶然,而是源于数据在模型训练中角色的根本性重构。在大模型发展的初期阶段,数据采购呈现出典型的“项目制”特征。实验室通常在训练启动前集中采购数据集,一旦训练完成,便进入漫长的空窗期,直到下一代模型立项才会产生新的需求。这种脉冲式的消费模式限制了数据公司的收入稳定性。然而,随着模型迭代周期的急剧缩短,这一模式已被彻底颠覆。从GPT-4到GPT-4o,再到后续版本的快速跟进,模型更新的间隔从数月压缩至数周甚至数天。Anthropic等领先机构更是将旗舰模型的发布节奏提升至以天为单位。这种高频迭代意味着实验室随时都在发现新的能力缺口,从而催生了对针对性、高价值数据的持续性需求。
需求的频次提升只是表象,更深层的变化在于数据体量与信息密度的双重膨胀。以代码智能体为例,早期的训练基准仅覆盖有限的Python仓库,模型只需掌握单一语言的简单风格。而最新的基准测试已将范围扩展至多种编程语言和数十个复杂仓库,单个训练样本不再仅仅是几行代码的修改,而是包含需求理解、多文件定位、跨文件协作及测试验证的完整数据包。单条样本的Token数量从几百激增至数万,这意味着模型需要消化的信息密度呈指数级上升。采购频次更高、场景更复杂、单条数据更重,这三个因素的叠加,直接将训练数据的总需求量推高了一个数量级。
与此同时,数据定价机制也在经历深刻变革。传统的按件计酬模式正在被基于专家时薪的高价值定价所取代。随着任务难度的增加,数据标注的主力军已从普通众包工人转变为拥有博士学历或执业资格的领域专家。STEM领域的专家时薪大幅上涨,但这并非成本压力的简单转嫁,而是价值创造方式的升级。现代数据公司不再仅仅是劳动力的提供者,而是深度介入模型研发流程的服务商。它们通过先评测模型弱点,再定向设计训练任务,最后验证能力提升的闭环服务,赚取的是技术溢价而非单纯的人工费。这种模式的转变使得头部数据公司的毛利率显著高于传统人力外包行业,证明了其作为研发合作伙伴的核心价值。
在这一背景下,AI数据行业呈现出两个极具前瞻性的发展趋势。首先是真实工作流数据(Type 1 Data)的崛起。过去,行业主要依赖人工设计的任务数据(Type 2),这类数据虽然可控,但缺乏真实世界的复杂性。随着模型基础能力的增强,它们更需要学习真实世界中任务完成的完整链路。GitHub之所以成为代码大模型训练的宝库,正是因为它保留了从问题提出到代码评审的全流程记录。如今,这一逻辑正延伸至其他领域。Handshake等平台通过聚合职场人的真实文档、表格和代码仓库,构建了原生且高质量的数据源。Protege等新兴公司则专注于打通医疗等高壁垒行业的数据孤岛,通过前置合规审查和精细化筛选,将原本需要数年才能完成的数据采购周期压缩至一个月以内。这种连接数据持有方与模型厂商的中间层,正在成为不可或缺的基础设施。
第二个趋势是强化学习(RL)环境逐渐取代静态数据集,成为训练的新焦点。当AI从对话助手进化为能够自主执行任务的智能体时,静态的“课本知识”已不足以支撑其能力发展。模型需要在可控、可交互的模拟环境中进行试错学习。OpenAI和Anthropic等巨头纷纷投入巨资自建或采购RL环境,如浏览器操作界面、办公软件沙盒等。Mercor收购软件仿真公司Deeptune,正是看中了这一市场的巨大潜力。通过复刻Excel、Salesforce等常用软件的操作环境,数据公司为模型提供了逼真的训练场,使其能够在虚拟世界中磨练出稳定的任务执行能力。这标志着数据服务的边界已从内容生产扩展至环境构建。
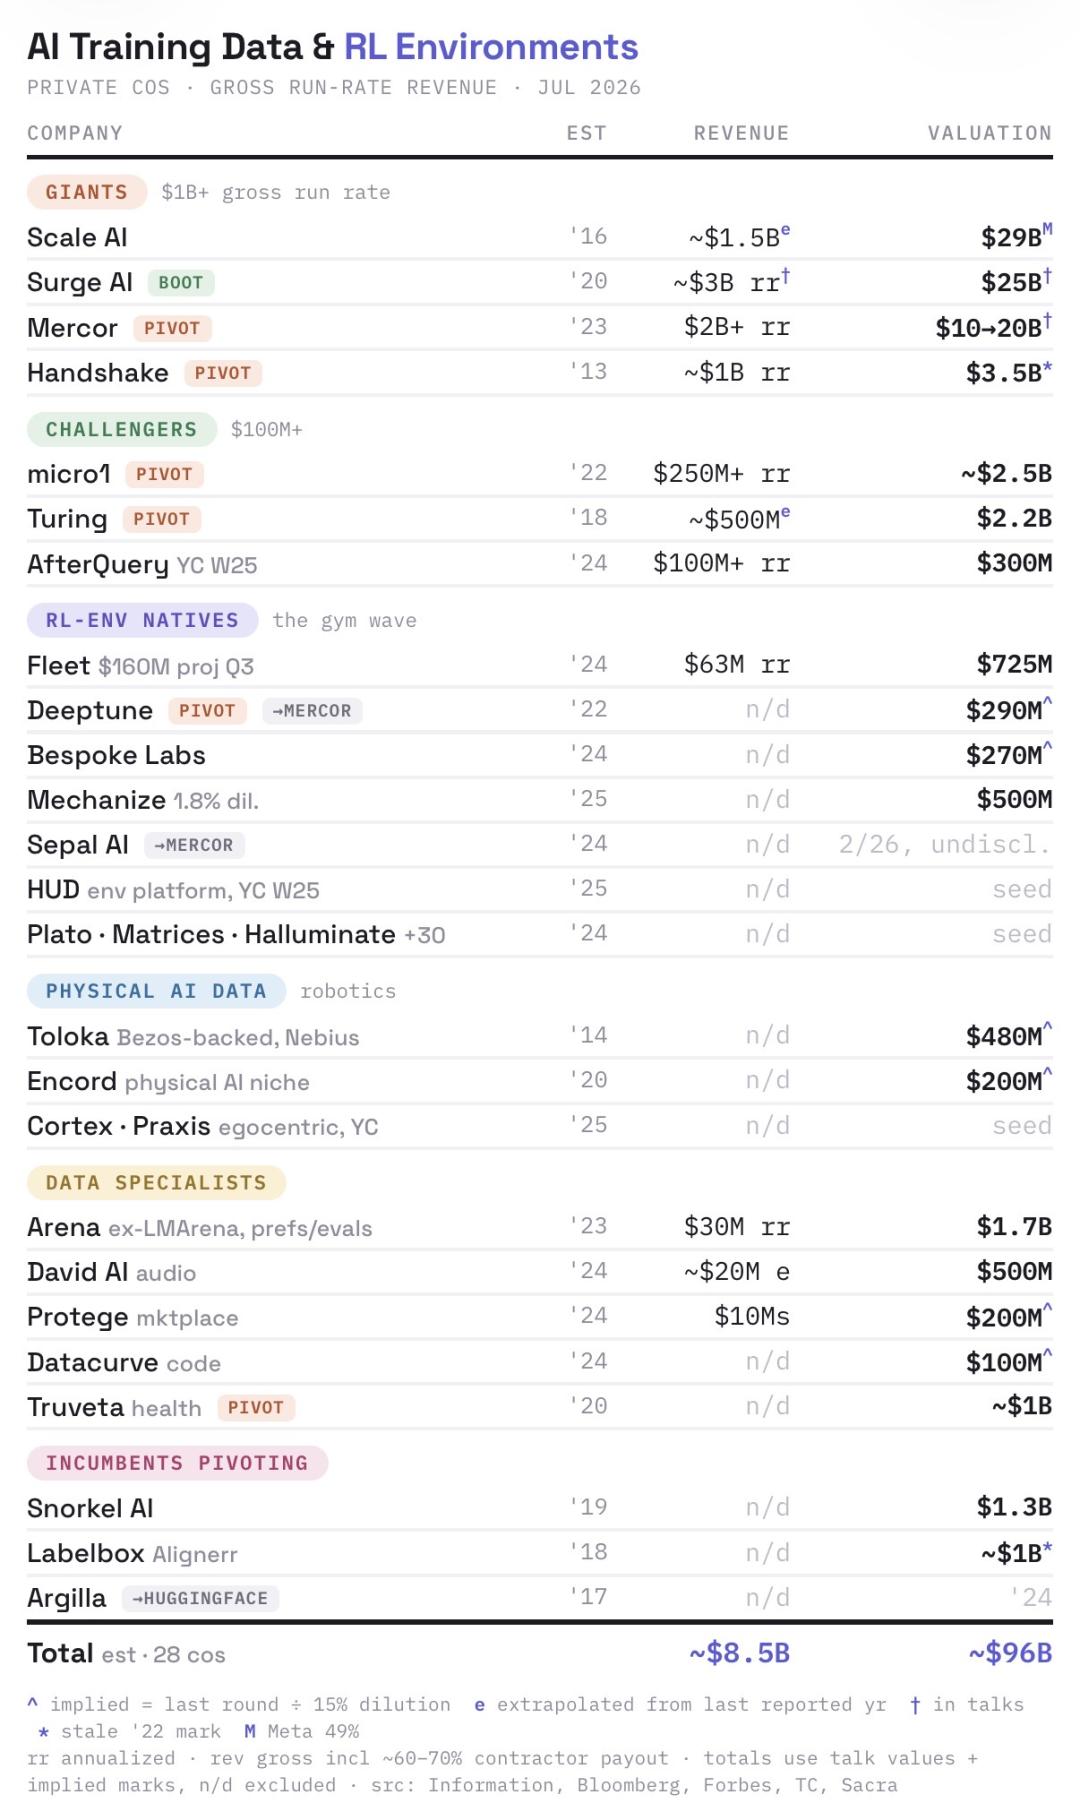
面对底层逻辑的变迁,头部玩家的战略路径也出现了明显的分化。Scale AI凭借深厚的积累,正向下游延伸,致力于成为政企AI应用的总包商,其企业级应用业务收入有望超越传统标注业务。Surge AI则选择向上游走,坚持小而美的精品路线,专注于为顶级实验室提供高难度的安全评估与反馈服务,拒绝规模化众包,以极高的专业壁垒维持高利润率。Mercor通过构建全球专家网络,横向扩张其人才储备,并押注RL环境业务,试图在专家知识与模拟环境两个维度同时建立优势。而Handshake则利用其在招聘领域积累的庞大用户与企业资源,扮演数据管道的角色,专注于真实工作流数据的搬运与整合。
这四条不同的演进路线揭示了一个共同的行业真相:单纯的数据标注正在迅速贬值,沦为价值链中利润最薄的一环。所有参与者都在努力向价值链更深处迁移,要么通过提供更深度的研发服务,要么通过掌握更稀缺的数据源,要么通过构建更复杂的训练环境。这一过程不仅重塑了数据公司的商业模式,也重新定义了AI产业的价值分配格局。
回顾互联网时代,巨头的能力边界往往由其掌握的数据规模决定。而在当前的AI竞赛中,数据不再是巨头内部产生的副产品,而是一门独立的、高度专业化的生意。随着智能体时代的到来,对高质量、高密度、真实场景数据的需求只会进一步加剧。那些能够高效连接数据供给与模型需求、并能提供深度技术赋能的公司,将在这一千亿美元的市场中占据主导地位。对于投资者和行业观察者而言,关注这些隐藏在幕后的数据基础设施构建者,或许比追逐前台的大模型更能洞察AI未来的真正走向。这场关于数据的争夺战,才刚刚拉开序幕,而其胜负将直接决定下一代人工智能的智慧高度。