Kimi K3开源破局:中国AI如何以算法重构全球算力博弈格局
算法突围:击穿算力霸权的低成本革命
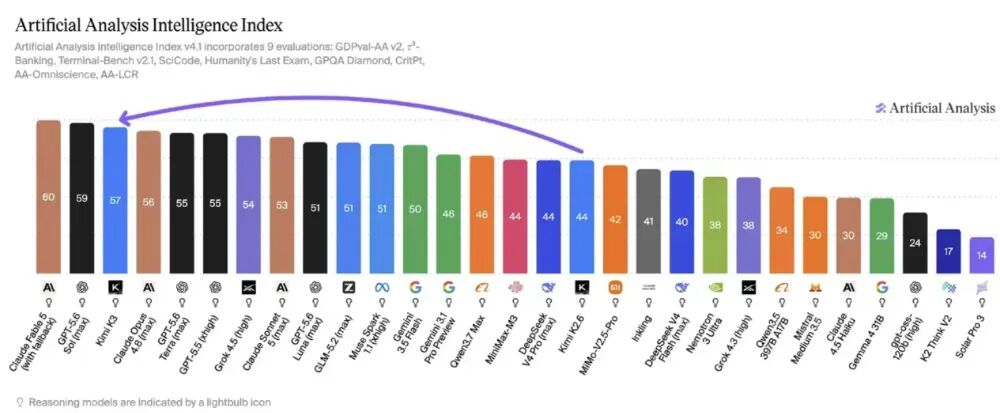
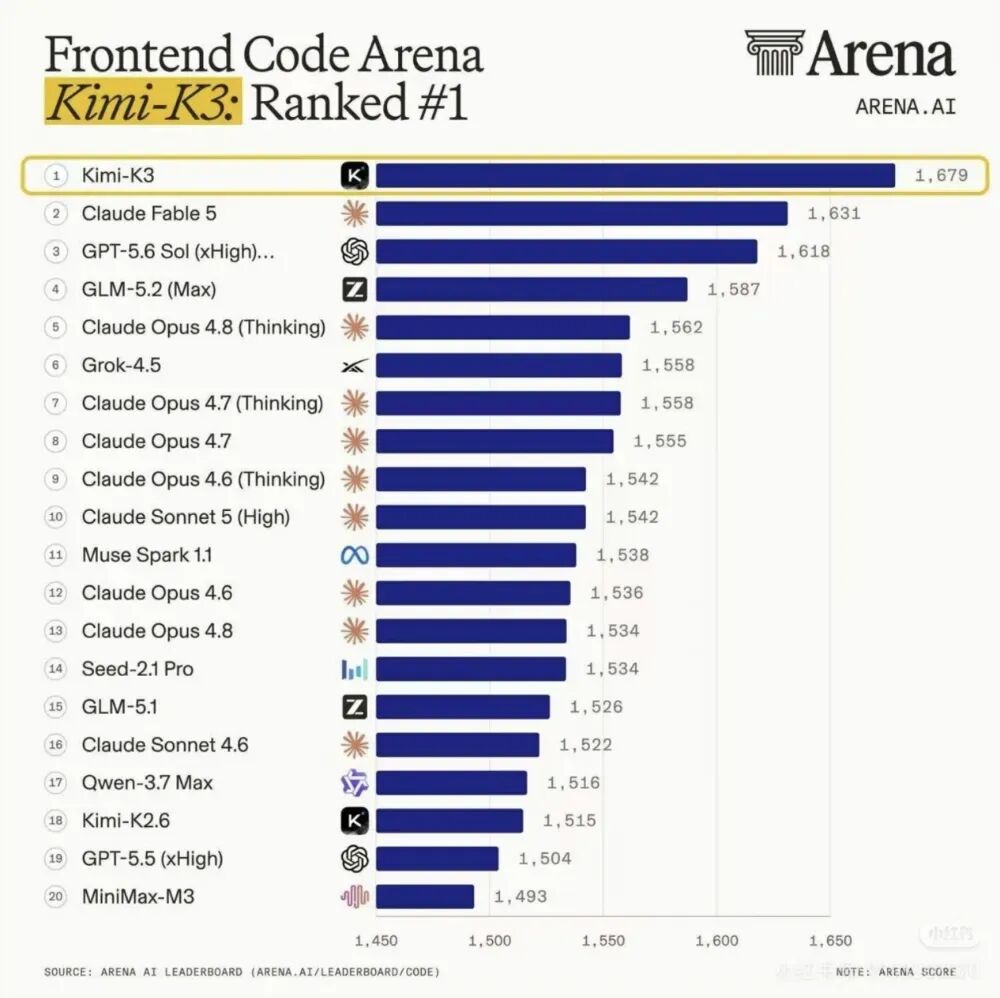
中国人工智能产业正经历一场从应用层套壳向底层硬核技术突破的关键转折。这一转折的核心标志,并非单纯的技术迭代,而是对全球既定AI叙事逻辑的根本性修正。当Kimi K3以2.8万亿参数规模的开源模型震撼发布时,其所引发的震动远超技术圈层,直接冲击了硅谷长期构建的“算力即正义”的商业闭环。
长期以来,以OpenAI和Anthropic为代表的头部企业,通过构建基于海量算力集群的闭源API护城河,确立了全球顶级AI能力的绝对定价权。这种模式本质上是一种排他性的“收租”逻辑:通过极高的资金门槛和复杂的硬件壁垒,将全球中小开发者垂直行业应用者锁定在高昂的Token调用成本中。这种不透明的黑盒机制,不仅限制了技术的普惠性,更扼杀了应用层的微创新活力。
中国AI企业的破局之道,在于拒绝盲目复刻十万张H100暴力堆砌的路线,转而走上了极限工程优化的道路。K3的成功证明,通过高度优化的混合专家(MoE)架构与高质量数据清洗,完全可以在部分核心场景实现对头部闭源模型的全面对标。这种从“拼硬件规模”向“拼工程效率”的转变,标志着中国AI正式进入以算法创新对抗算力垄断的新阶段。
架构革新:MoE与数据飞轮的极致协同
K3模型在性能上的突围,首先得益于对MoE架构的深度定制与动态路由机制的创新。传统稠密模型在推理时需激活所有参数,这在算力受限环境下是难以承受之重。K3通过高精度的动态路由技术,确保在处理特定任务时仅激活全网极小比例的相关专家网络。这一机制使得模型在保持同等甚至更优推理表现的同时,将显存占用与动态计算开销降低了数个数量级。
这意味着,原本只有顶级科技巨头才能负担的庞然大物,如今可以在有限规模的算力集群上高效运转。这种架构上的“瘦身”,不仅降低了训练成本,更大幅压缩了推理阶段的资源消耗,为大规模商业化落地提供了可能。
与此同时,中国AI产业在高熵高质量数据清洗与合成数据飞轮领域的积累,已从初期的粗放爬取迈入精密制造阶段。在模型全生命周期中,训练仅是固定成本,推理部署才是无休止的消耗战。国内基础设施服务商如硅基流动、无问芯穹等,通过重构底层推理引擎,广泛普及vLLM投机采样、PagedAttention显存管理机制以及低比特量化技术,将大模型的单次推理成本逼近物理极限。
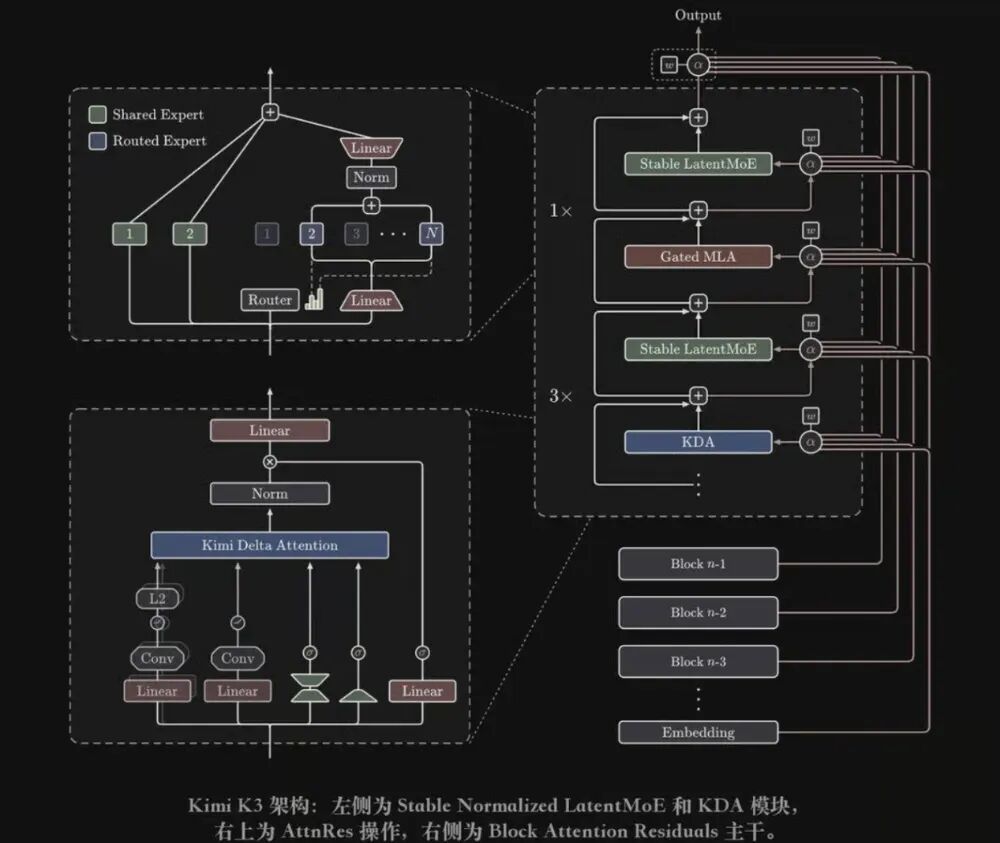
这种对底层算力的极致榨取,使得国产Infra玩家能够将不同品牌、不同代际的计算芯片池化调度,最大限度地利用闲置算力。开源生态的繁荣,正以极高的性价比分流全球中长尾开发者,从应用端倒逼闭源巨头让出高昂的溢价空间。
认知升维:从快思考到慢思考的范式转移
K3的发布仅是序章,真正决定终局的是国产模型在认知能力上的深层突破。随着Scaling Law在纯无监督预训练阶段触及高质量语料枯竭与算力效率拐点,行业共识正迅速转向:真正的智力突破不再依赖参数规模的盲目扩张,而是决胜于强化学习与复杂问题的推理时间扩展。
这标志着模型能力必须从基于直觉的“快思考”,向深入剖析、多步推演的“慢思考”深水区挺进。阿里Qwen3.8、DeepSeek R系列以及智谱GLM等国产模型的接连发力,展示了中国在推理平权赛道上的强劲势头。尽管在超长视频生成等原生多模态领域中美仍有代差,但在极度考验强化学习与合成数据质量的推理赛道,中国头部企业如月之暗面、百川智能等正在迅速缩小差距。
在B端Agent商业化落地的关键逻辑验证中,绝对算力的垄断正在失效。拥有反思能力与自我纠错机制的“慢思考”模型,能够自行拆解步骤、验证对错并推翻重来,从而拉平由于基础显卡集群数量不同造成的表层差距。一旦中国大模型将高级认知智力的单次消耗成本压缩至海外对手的十分之一甚至百分之一,欧美巨头在高端推理领域的高昂溢价将被彻底碾碎。这种平权化,正是全球企业级AI应用爆发的唯一前提。
底层重构:全栈国产化的生死攻坚
然而,没有物理底座的支撑,再卓越的算法也只是空中楼阁。当前,国内绝大多数AI企业的繁荣,仍依赖于海外高端GPU与国产算卡的混合部署过渡态架构。在极端的外部技术封锁背景下,当存量硬件寿终正寝,若本土产业链无法完成彻底替代,中国AI产业的根基将面临致命风险。
在这场没有退路的战役中,HBM(高带宽内存)与底层软件生态是真正的阿喀琉斯之踵。重构HBM链条的艰辛,不亚于在荒漠中重建特高压电网。我们需要面对从半导体材料、纳米级封装工艺,到内存颗粒堆叠良率、散热控制及集群互联通信协议的全方位突围。长鑫存储在HBM量产上的死磕,以及华为昇腾、壁仞科技等国产GPU在CANN等独立软件栈上的血泪攻坚,揭示了底层重构的残酷真相。
英伟达的壁垒不仅在于芯片,更在于二十年来数百万开发者构建的CUDA生态。面对这堵高墙,中国异质芯片产业必须抛弃舒适区,深入硬件指令集底层,重新手写算子、定制内存分配架构、调优分布式通信原语。这是一条需要全行业共同忍受数年寂寞的生死天险,也是彻底拔除卡脖子暗雷的必经之路。
产业共振:韧性构建新的全球竞争格局
上层的工程极限压缩、中层的推理平权突围、底层的硬件血泪攻坚,共同构成了中国AI最真实的产业切面。中国科技产业最迷人的特质,不在于编织宏大叙事,而在于极其强悍的韧性:在极端约束条件下,通过一砖一瓦的积累,拼凑出属于自己的算力底座。
资本市场的目光终将穿透浮躁的应用层泡沫,向这批真正啃硬骨头的硬核基础设施提供商致敬。随着国产半导体良率的稳定与软件生态的汇聚,中国AI底座在物理层面实现安全循环的拐点必将到来。这场科技角力,不仅是技术的竞争,更是产业链完整度与创新效率的较量。中国AI通过全栈重构,正在重塑全球人工智能产业的权力版图,为构建一个更加多元、开放且普惠的智能未来奠定坚实基础。