OpenAI连续17天异常:Agent时代宕机成本重构与架构启示
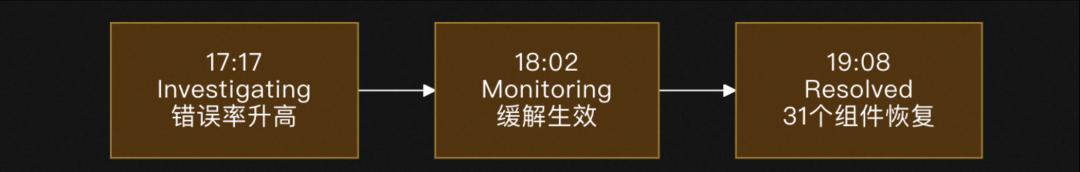
在人工智能深度嵌入企业核心业务流程的今天,基础设施的稳定性已不再仅仅是技术指标,而是直接关乎商业存续的生命线。2026年7月25日傍晚,全球AI领域的标杆OpenAI经历了一次极具警示意义的系统性震荡。其API接口、ChatGPT对话服务以及面向开发者的Codex代码生成工具同时出现大规模报错,涉及31个服务组件的性能严重下降。这次持续1小时51分钟的故障,并非孤立事件,而是揭开了一场更为严峻的持续性危机序幕:在此之前的17天内,OpenAI没有任何一天处于“完全正常”的运行状态。
这一现象标志着AI行业正在经历从“能力优先”向“可靠性优先”的范式转移。当大语言模型从聊天机器人进化为能够自主执行复杂任务的智能体(Agent)时,任何微小的服务中断都可能引发连锁反应,导致整个自动化流水线的瘫痪。对于依赖AI进行代码编写、客户服务或数据审计的企业而言,这111分钟的断连不仅仅是用户体验的降级,更是真金白银的生产损失。我们需要重新审视在Agent时代,如何计算宕机的账单,以及如何重构我们的技术架构以应对日益脆弱的基础设施环境。
回顾此次故障的时间线,北京时间7月25日17时17分,OpenAI官方状态页首次显示“调查中”,随后错误率迅速攀升。受影响范围之广令人咋舌:API端12个组件、ChatGPT端15个组件以及Codex端4个组件全部受到波及。第三方监测数据证实,故障始于UTC时间09时17分,与官方记录高度吻合。对于普通用户来说,这可能只是刷新几次页面后恢复正常的短暂不便;但对于正在运行大型项目代码生成的开发者,或是处理高并发客服请求的企业系统,这种中断往往是灾难性的。Codex服务的卡顿尤其致命,因为编程任务通常具有长上下文依赖,一旦中间环节断裂,此前生成的代码片段可能全部失效,导致项目整体进度烂尾。
将视角拉长至过去一个月,数据的密集度揭示了更深层的结构性问题。根据第三方状态监测平台Bifrost的记录,自7月9日起,OpenAI的服务质量便在“部分中断”和“性能降级”之间反复横跳,期间还发生了两次重大停机事故。另一监测站incidenthub的数据同样显示,仅在7月23日一天内就记录了四起独立事故。这种高频次的波动表明,OpenAI的基础设施长期处于压线运行状态。合理的推演指向两个核心因素:一是夏季全球推理负载的持续爬坡,二是新模型与新功能发布节奏过快带来的工程压力。在算力需求指数级增长的背景下,现有的基础设施扩容速度似乎难以匹配业务扩张的步伐,导致系统冗余度被极度压缩。
在传统的SaaS时代,宕机主要影响的是信息获取的效率;而在Agent时代,宕机切断的是执行链条。当前的AI应用架构中,API背后连接的是客服机器人、自动代码流水线、财务审计脚本等生产系统。当这些系统依赖单一供应商时,服务商的任何波动都会直接传导至企业的核心业务。监测页下方出现的“自动路由到健康替代模型”的广告语,恰恰反映了市场痛点的转移:多模型容灾已经从一种高级优化手段,变成了维持业务连续性的必需品。企业开始意识到,模型能力的细微差距可以通过提示词工程弥补,但服务可用性的归零则是无法通过软件层面修复的硬伤。
这种认知的转变正在重塑企业AI选型的决策逻辑。过去,CTO们关注的是基准测试分数、上下文窗口长度或推理速度;现在,服务等级协议(SLA)的可靠性指标被推到了台前。能力差距按百分比计算,而宕机损失按100%计算。如果一家供应商每月有17天处于非完美状态,那么无论其模型多么聪明,它在企业级架构中的权重都必须被重新评估。这意味着,单家依赖的风险敞口正在被市场重新定价,那些能够提供更高可用性保证的供应商,即便在智力上略逊一筹,也可能因其稳定性而获得更大的市场份额。
面对这一趋势,多云多模型路由架构将从加分项变为企业AI基础设施的标配。这种架构的核心思想是不将鸡蛋放在同一个篮子里。通过构建一个抽象层,企业可以将请求动态分发到多个不同的模型供应商。当主供应商出现故障或延迟过高时,流量可以无缝切换到备用供应商。这不仅降低了单点故障的风险,还赋予了企业在谈判中更强的议价能力。然而,实现真正的无缝切换并非易事,它要求不同模型的输出格式、响应延迟和语义理解能力具有高度的一致性,这对工程团队提出了极高的技术要求。
此外,每次海外旗舰模型的故障,都是国产模型承接溢出需求的窗口期。随着国内大模型技术的快速迭代,其在中文语境下的理解能力和特定行业的适配性已具备相当竞争力。然而,要真正承接住这些溢出的高端需求,国产模型厂商必须首先解决自身的稳定性问题。如果在海外巨头宕机时,国内服务也因负载激增而崩溃,那么这种替代效应将大打折扣。因此,提升基础设施的弹性、优化推理集群的资源调度算法、建立完善的熔断机制,成为国产模型厂商下一步竞争的关键高地。
从技术演进的角度看,这次连续17天的异常也暴露了当前大模型部署模式的局限性。目前的集中式推理架构在面对突发流量时显得笨重且缺乏弹性。未来,边缘计算与小模型结合的模式可能会得到更多重视。通过将部分轻量级任务下沉到边缘设备或本地服务器,可以减少对云端中心节点的依赖,从而降低整体系统的脆弱性。同时,模型蒸馏技术的发展使得在保持较高性能的同时大幅降低算力需求成为可能,这为构建更具韧性的分布式AI网络提供了技术基础。
对于企业而言,应对这一新常态需要采取务实的策略。首先,必须建立独立的监控体系,不依赖供应商的状态页,而是通过实时探测关键接口的响应时间和错误率来感知服务健康度。其次,制定详细的应急预案,包括故障发生时的自动切换逻辑、数据一致性校验机制以及人工介入的流程。最后,在合同谈判中,应将SLA条款细化,明确不同级别故障的赔偿标准,并将历史稳定性数据纳入供应商评估体系。
OpenAI的工程团队或许会在短期内给出技术复盘,解释错误率升高的具体原因。但市场需要的不仅仅是一个技术解释,而是一个关于如何在不确定性中构建确定性的战略答案。17天的连续异常是一个明确的信号:AI基础设施的成熟度尚未跟上应用爆发的速度。在这个过渡期内,唯有那些能够正视风险、主动构建冗余架构、并将可靠性置于能力之上的企业,才能在Agent时代的浪潮中站稳脚跟。宕机的账单不仅由服务商支付,更由每一个缺乏准备的依赖者承担。重构架构,已刻不容缓。