大模型价格战下半场:推理成本为何成为AI商业化的最大拦路虎?
从“性能军备竞赛”到“成本生死线”
2026年的AI大模型行业,正经历一场深刻的范式转移。如果说过去几年是“工程师时代”,各家厂商争相展示模型在逻辑推理、代码生成等基准测试中的极限性能,那么现在,行业正式进入了“工业时代”。在这个新阶段,核心竞争力不再仅仅是“谁能做出更聪明的模型”,而是“谁能以更低廉的成本提供稳定服务”。
这种转变的标志性事件,是2026年5月至6月间国内大模型厂商集体发起的“价格战”。DeepSeek宣布将V4-Pro模型的API调用价格永久降至2.5折,甚至引入类似电力的峰谷定价机制;小米旗下MiMo-V2.5全系列接口大幅下调资费,部分场景降幅逼近99%;腾讯云平台内的DeepSeek-V4全系列模型最高降幅达97.5%。这些举措并非简单的营销手段,而是基于底层算力成本重构后的战略选择。
然而,在这场看似激烈的降价潮背后,隐藏着一个更为严峻的现实:随着AI应用从边缘探索走向核心业务,曾经被边缘化的“推理”环节,正在取代“训练”,成为大模型厂商最大的成本黑洞。正如DeepSeek创始人梁文峰在投资会上所言,芯片价格过高已成为制约其低成本战略的最大痛点,甚至促使公司秘密启动自研推理芯片项目。这揭示了一个行业共识:推理芯片的价格,决定了大模型商业化的生死线。
推理芯片:被忽视的成本巨兽
要理解为何推理芯片成为焦点,首先需要厘清AI算力消耗结构的根本性变化。在传统的大模型开发周期中,训练阶段占据了绝大部分算力资源。数据显示,早期约70%-80%的AI算力用于训练,仅20%-30%用于推理。然而,随着模型逐渐落地应用,这一比例正在发生剧烈倒转。
联想集团董事长杨元庆在2026年5月的业绩发布会上明确指出,未来用于推理的AI算力将占到70%以上。这一趋势在头部企业的资本开支中得到了印证。阿里云在“2026年算力倍增计划”中,将推理芯片采购预算提升至总预算的60%;Meta则计划到2026年底建立等效60万张GPU算力的推理集群,占比达55%。
这种结构性变化源于推理业务的特性。训练是一次性投入,而推理是持续性、高频次的消耗。在生产环境中,推理芯片投入占大模型全生命周期计算成本的80%至90%。这意味着,即使模型训练成本大幅下降,如果推理成本居高不下,大模型的规模化盈利依然遥遥无期。
对于DeepSeek这类主打低价策略的厂商而言,推理芯片的成本控制能力直接决定了其市场竞争力。当百万Token的推理价格降至0.025元时,每一分钱的节省都意味着巨大的利润空间或用户增长潜力。因此,降低推理芯片价格,已从技术优化问题上升为企业战略核心。
降价背后的双轮驱动:算法与硬件
DeepSeek等厂商之所以能在保持低价的同时维持运营,主要得益于“软件算法优化”与“硬件国产替代”的双轮驱动。
在软件层面,精妙的算法和工程优化大幅降低了算力消耗。以DeepSeek V4系列为例,在处理百万级Token长上下文时,其算力消耗仅为上代产品的27%。通过引入高效的缓存机制,推理延迟降低了10%,真题训练成本也降低了10%。这些优化并非简单的代码调整,而是对模型架构、注意力机制、内存管理等底层逻辑的深度重构。
在硬件层面,摆脱对英伟达的依赖成为关键。DeepSeek等国内厂商积极采购国产算力芯片,如华为昇腾节点已全面支持V4系列模型。国产芯片在性价比上的优势,使得大模型厂商能够在保证性能的前提下,显著降低硬件采购成本。这种“软硬结合”的策略,不仅降低了短期采购成本,更增强了供应链的安全性。
然而,这种双轮驱动的效果正在逐渐减弱。随着算法优化的边际效益递减,以及国产芯片性能与英伟达差距的缩小,单纯依靠现有手段已难以进一步压低推理成本。DeepSeek、小米等厂商已触及价格天花板,必须寻找新的突破口。
自研芯片:看似诱人实则凶险的捷径
面对推理成本的压力,自研芯片成为众多大模型厂商的首选方案。OpenAI与博通联合开发的首款定制推理芯片Jalapeño,旨在替换英伟达芯片,降低约50%的推理成本;Anthropic从OpenAI挖来核心芯片团队成员,加速自研进程;DeepSeek也将自研AI推理芯片列为510亿元融资的重要用途。
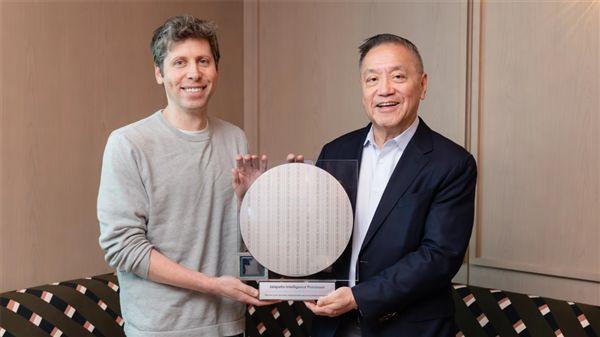
然而,自研之路远比想象中艰难。对于擅长算法架构的大模型企业而言,跨界进入硬件领域面临着三重巨大挑战。
首先是研发难度。AI芯片设计涉及复杂的物理层、电路层、架构层优化,需要深厚的硬件技术积累。大模型企业此前仅将芯片视为上游工具,如今需从零开始构建硬件研发团队,这在人员、技术、流程上均需重新积累,周期长、风险高。
其次是迭代速度。芯片厂商如华为昇腾、寒武纪、英伟达,对接整个大模型行业,能够根据市场需求快速研发生产。而大模型厂商仅针对自身需求定制芯片,研发能力与专业芯片厂商存在差距。这可能导致芯片出厂即落后,无法跟上模型算法的快速迭代,造成资源浪费。
最后是生态缺失。这是自研芯片最大的难题。英伟达的成功不仅在于算力性能,更在于其拥有超过400万开发者的CUDA生态。庞大的开发者群体愿意适配芯片框架,进而增加采购量,形成规模效应,摊薄研发成本。而智普AI、DeepSeek等自研芯片,缺乏外部生态支持,只能内部使用,无法依靠数量均摊成本,导致单颗芯片成本居高不下。
破局之道:从产品公司向基础设施公司转型
2026年的AI大模型行业,正处于从“能不能做出好模型”向“能不能把成本降到足够低”转型的关键节点。自研推理芯片不仅是技术选择,更是战略定位的分水岭。
对于大模型企业而言,能否推出并使用自研推理芯片,决定了其是一家AI产品公司,还是一家AI时代的基础设施公司。产品公司关注模型性能与应用场景,而基础设施公司关注算力效率与成本控制。
要解决自研芯片的难题,大模型企业需在四个方面取得突破:算法迭代需与芯片架构深度耦合,实现软硬协同优化;芯片流片需与先进制程紧密合作,确保技术先进性;产能排期需与代工厂建立长期稳定关系,保障供应稳定;用户生态需逐步开放,吸引第三方开发者适配,形成良性循环。
只有解决这四大难题,大模型企业才能真正实现用自研推理芯片降低每百万Token推理成本的目标,从而在激烈的市场竞争中占据主动。
结语:成本优势即生存优势
AI大模型的普及,最终取决于成本能否降至大众可接受的范围。推理芯片作为成本的核心构成,其价格战的下半场,将是技术、生态、供应链的综合较量。
DeepSeek等厂商的低价策略,虽在短期内赢得了市场份额,但长期来看,唯有通过自研芯片等深层技术手段,真正降低推理成本,才能实现可持续的商业闭环。这不仅是DeepSeek的挑战,也是整个AI行业的共同课题。
未来,AI大模型行业的竞争,将不再是单纯的模型性能之争,而是算力效率与成本控制之争。谁能以更低的成本提供高质量的推理服务,谁就能赢得用户,赢得市场。在这场没有硝烟的战争中,成本优势将成为最终的生存法则。