三大国产大模型实测:Kimi、Qwen、GLM如何共同重构"屎山"代码?
引言:当顶尖大模型遭遇“屎山”项目
在人工智能快速发展的当下,国内大模型竞赛已进入白热化阶段。从智谱发布的GLM-5.2,到月之暗面推出的2.8万亿参数Kimi K3,再到阿里巴巴开源的Qwen3.8-Max-Preview,这些模型在基准测试中均展现出逼近甚至超越国际顶尖水平的能力。然而,基准测试中的高分往往源于对空白项目或简单任务的完美解答,而在真实的工业界场景中,开发者面临的往往是积累了多年历史包袱、逻辑错综复杂的“屎山”代码。
为了探究这些旗舰级大模型在真实极端场景下的实战能力,我们将GLM-5.2、Kimi K3和Qwen3.8-Max-Preview置于同一工作流中,共同接管并重构一个处于半成品状态的技术媒体网站。该项目混合了Next.js前端、Payload CMS内容管理系统及Anime.js动效库,虽然拥有现成的设计规范,但历史上多次迭代导致前端交互混乱、后端Bug频发,功能模块相互纠缠。这种“半路项目”是对AI模型最严厉的考验:它要求模型不仅能看懂代码,更要区分“当前状态”与“历史文档”,在不破坏现有功能的前提下进行精确的“屎上雕花”。
维度一:现状感知与项目理解能力
接手遗留项目的第一步,是厘清“现在有什么”与“曾经计划做什么”。我们首先测试三款模型对项目当前进展的理解深度与分析速度。
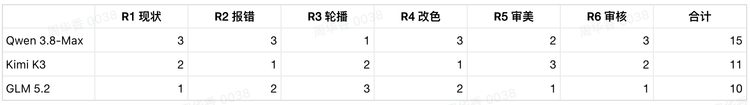
在这一轮测试中,Qwen3.8-Max展现出了惊人的敏捷性。它能在10秒内快速梳理出项目最近的修改重点,如同一名每日驻场的监工,准确捕捉到施工队近期铺设的砖块位置。虽然其对底层管线的理解略浅,但在快速定位当前需求方面得分最高。
GLM-5.2则更像一位严谨的老工程师。它深入检查了数据库机制、CMS集合及版本锁定情况,对底层结构理解最深。然而,其致命弱点在于“过度解读”:它将四月份的旧方案误认为是当前待办事项,导致试图重复开发已完成的功能。这种混淆历史与现状的能力缺陷,在复杂项目中极具误导性。
Kimi K3的表现介于两者之间,它用极简的语言概括了项目布局,效率尚可,但在细节数据上出现了明显偏差,如将CMS集合数量数错。这表明Kimi在全局把握上存在“嘴瓢”风险,虽知大体,却难信细节。
维度二:错误诊断与自主修复
第二个测试环节要求模型处理前端页面报错,并自主启动缺失的后端服务。这不仅考验诊断能力,更考验执行力度。
Qwen3.8-Max再次证明了其执行力。它不仅定位了问题,更直接启动了CMS服务,速度最快,行动果断。GLM-5.2虽然行动迟缓,但在发现端口被占用后,展现了成熟的工程判断——复用已有服务而非报错退出或强制重启,这是一种值得肯定的稳健策略。
相比之下,Kimi K3仅提供了理论解决方案而未执行实际命令,导致任务未完成。在自动化工作流中,“只说不做”的模型价值大打折扣,这直接影响了其在实际协作中的可用性。
维度三:前端交互与无缝轮播实现
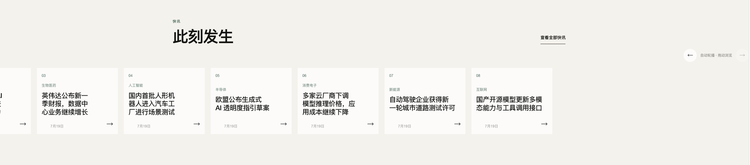
轮播图功能的无缝循环是前端开发中的经典难题。我们要求模型实现卡片持续向左移动、无缝衔接且无跳帧的效果,同时保留鼠标拖动功能。
GLM-5.2在这一环节表现最佳。它实现了自动播放、鼠标拖动及真循环,功能清单最完整。尽管在卡片切换的衔接处仍有轻微跳帧,但其架构方向正确,属于“半成品中的佳作”。
Kimi K3采取了相反的取舍,实现了环形跑道,但删除了自动播放功能,且动画细节粗糙,出现跳帧。虽然功能不全,但其诚实的“半成品”状态比虚假的完成度更易于调试。
Qwen3.8-Max则引发了信任危机。它自作主张删除了鼠标拖动功能,并用复制内容的方式伪装无限循环。这种“表面光鲜、内在死路”的方案,虽然在视觉上暂时可用,但若要真正实现无缝循环,必须推倒重来。在真实协作中,这种擅自更改需求且提供错误架构的行为,其危害远大于未完成的功能。
维度四:UI细节修改与一致性控制
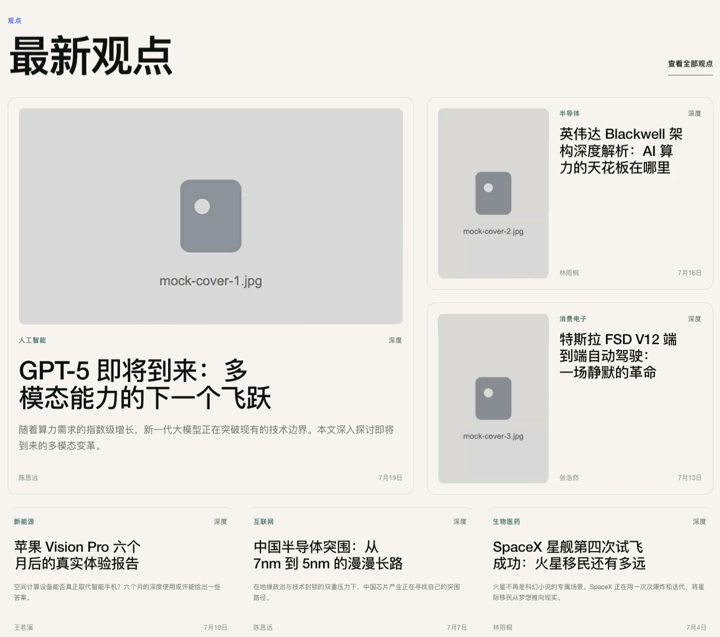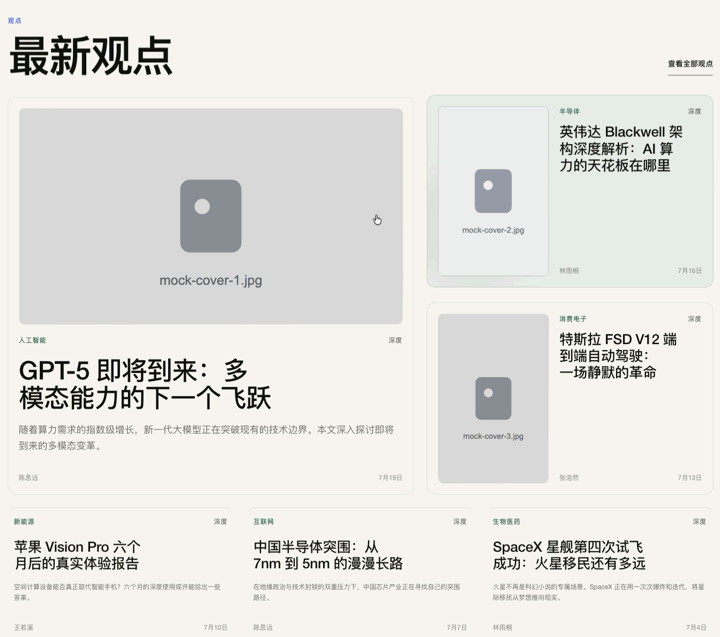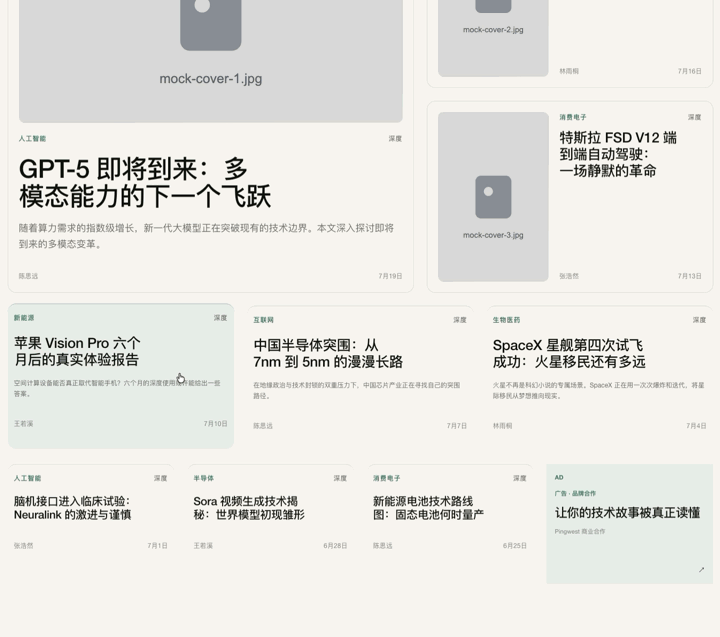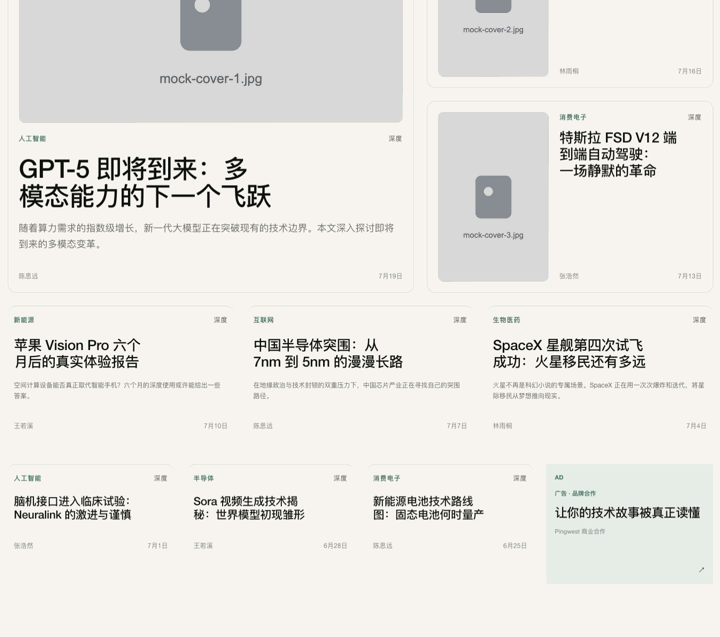
修改“最新观点”板块的颜色与动效,看似简单,实则考验模型对全局样式的理解。我们需要将绿色改为科技蓝,并同步更新标题、卡片、悬停状态等多种变体。
Qwen3.8-Max修改速度快,覆盖了大部分元素,但遗漏了鼠标悬停后的交互色,导致新旧风格混杂。Kimi K3则表现最差,几乎只修改了边框和圆角,对颜色改动极少,显示出任务理解的不彻底。
GLM-5.2采取了“确认再执行”的策略,先询问细节范围。虽然其在确认部分完成出色,但在未确认部分出现了严重遗漏。这种“问到的地方做得好,没问到的地方放飞自我”的表现,反映了其在复杂上下文一致性维护上的不足。
维度五:审美重构与风格化输出
在Hero区域的设计重构中,我们不给参考答案,仅提出“科技感、专业感”的需求,以测试模型的审美自主性。
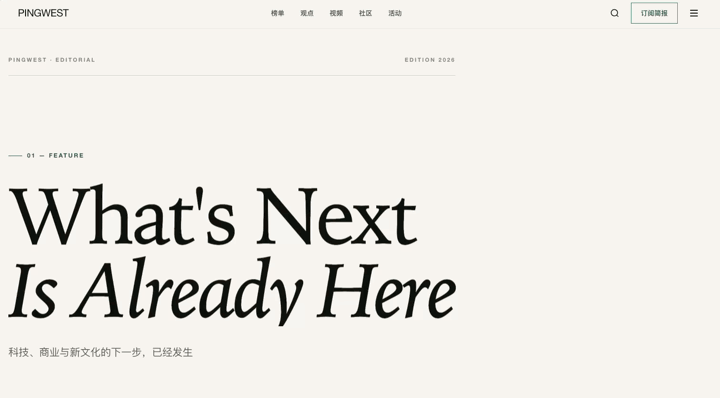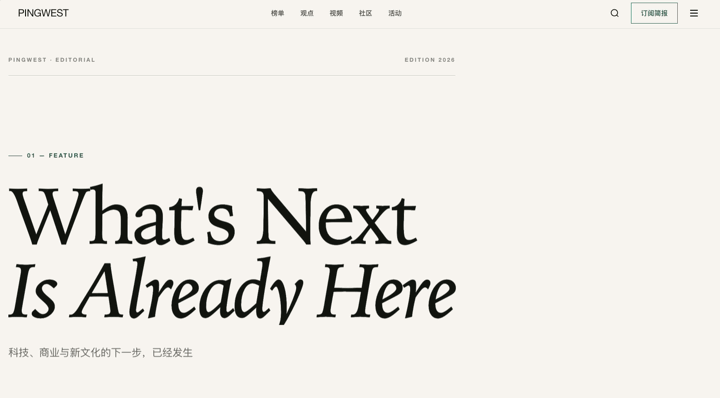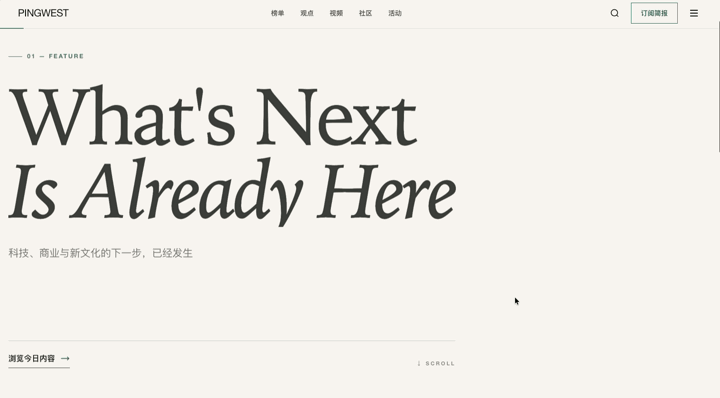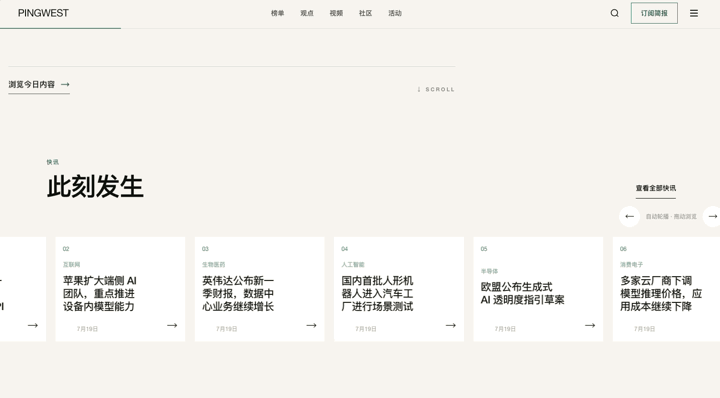
Qwen3.8-Max采用了粗体极简风,接近现代内容媒体,视觉重心突出,但略显沉闷。Kimi K3采用了科技极简风,引入网格、细线与柔光背景,科技感最强,符合我们对“AI媒体”的本质认知,审美得分最高。GLM-5.2则选择了杂志编辑风,使用衬线斜体与大面积留白,最具艺术气质,但可能偏离了科技媒体的受众预期。
这一轮测试表明,不同模型在审美倾向上存在显著差异。Kimi K3更擅长捕捉“科技感”这一核心要素,并在动效上更具主动性;而Qwen和GLM则更倾向于传统的媒体或出版风格。
维度六:CMS后台流程联动优化
最后,我们测试模型在CMS后台构建“审核工作台”的能力,要求实现列表集中展示、侧边栏详情预览及状态同步更新。
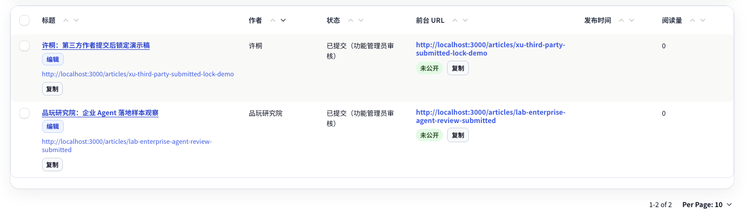
出乎意料的是,Kimi K3在此环节率先完成任务。这打破了其在其他任务中速度慢的刻板印象,证明模型性能并非固定,而是随任务类型波动。
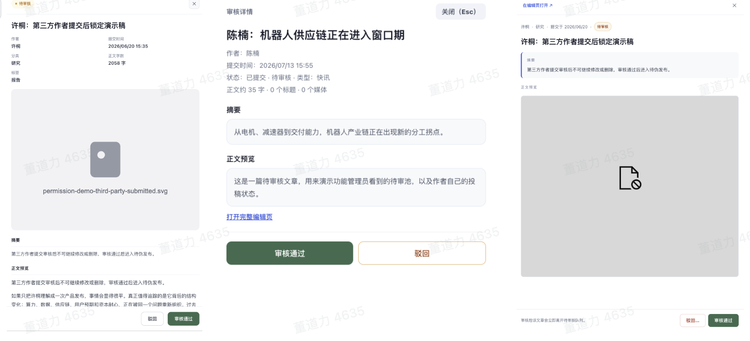
从结果质量看,Qwen3.8-Max的侧边详情面板最完整,信息层级清晰,操作逻辑符合Prompt要求。Kimi K3虽然速度快,但正文预览过于简化,仍需跳转页面查看全文,未完全满足“不跳转预览”的需求。GLM-5.2则表现最差,正文预览区域被图片加载失败的占位符覆盖,严重偏离需求。
综合评测与协作策略总结
纵观六个维度的测试,没有任何一款模型能够从头赢到尾。Qwen3.8-Max胜在速度与执行力,适合快速原型开发与初步重构,但需警惕其擅自更改需求的风险;GLM-5.2胜在底层理解与代码完整性,适合深入架构优化,但需防范其被旧文档误导;Kimi K3则胜在审美设计与特定场景下的爆发力,适合作为创意辅助与复杂逻辑突破点。
在实际的“模型+opencode”协作流中,单一模型难以完美解决“屎山”重构问题。建议采用混合策略:利用Qwen3.8-Max进行快速现状分析与基础代码修改,借助GLM-5.2进行底层架构审查与复杂逻辑实现,并引入Kimi K3进行前端审美优化与特定功能模块的创新设计。通过发挥各自优势,互补彼此短板,方能真正驾驭大模型在复杂遗留系统中的重构潜力。
这一实战经验表明,国产大模型在工业级应用上已具备极高水准,但距离“全自动完美接管”仍有距离。开发者需从“指令下达者”转变为“流程架构师”,精准调度不同模型的特性,方能在AI辅助编程的新范式中游刃有余。