Gemini三连发与4代预训练:AI Agent成本革命与未来架构解析
在人工智能技术快速迭代的当下,大语言模型的竞争焦点正从单纯的参数规模竞赛,转向更为务实的工程化落地与成本控制。谷歌DeepMind近期的一系列动作,清晰地揭示了这一行业风向的转变。通过一次性发布三款针对性极强的新模型,并同步启动下一代旗舰模型的预训练,谷歌不仅在技术层面展示了其深厚的研发储备,更在商业逻辑上向市场传递了明确信号:AI应用的普及,必须建立在可负担的成本基础之上。
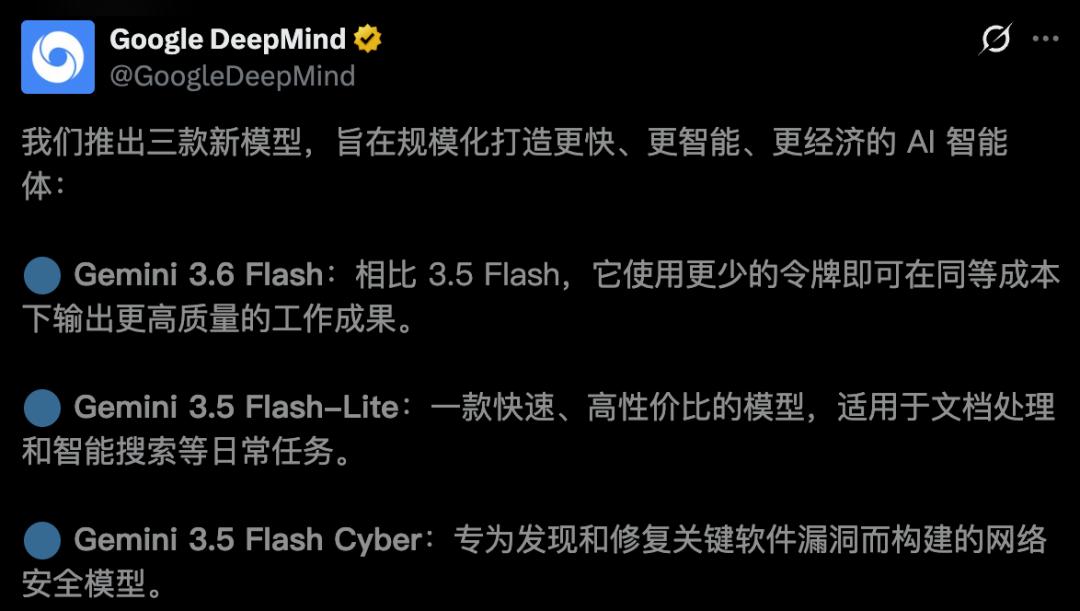
此次发布的三款模型——Gemini 3.6 Flash、Gemini 3.5 Flash-Lite以及Gemini 3.5 Flash Cyber,并非简单的版本迭代,而是针对特定应用场景进行的精细化切割。这种产品策略反映了当前AI开发者的核心痛点:如何在保证智能水平的同时,最大限度地压缩推理延迟与Token支出。对于正在构建复杂AI Agent系统的企业而言,这意味着底层基础设施的重大利好。
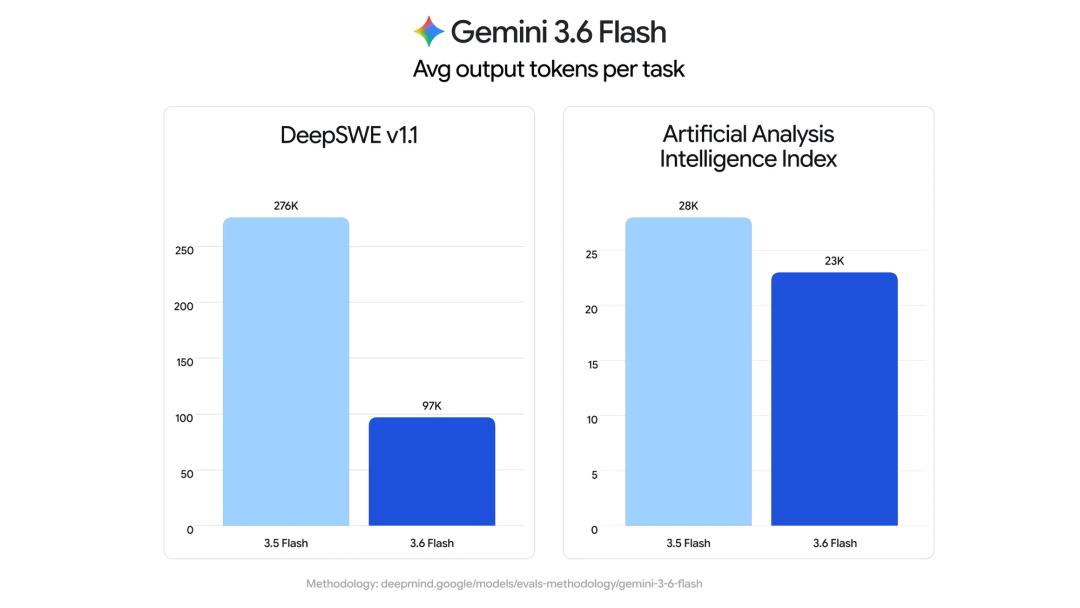
首先来看作为本次发布核心的Gemini 3.6 Flash。这款模型的设计哲学非常明确,即在保持高性能的前提下,极致优化资源利用率。根据第三方权威评测机构Artificial Analysis Index的数据,相较于前代3.5 Flash,3.6 Flash在输出相同质量内容时,Token消耗量减少了17%。而在更为复杂的编码任务基准DeepSWE中,这一节省比例甚至高达65%。这种显著的效率提升,主要得益于模型在推理路径上的优化。它能够在执行多步任务时,减少不必要的中间推理步骤和工具调用次数,从而缩短“思考”路径,直接输出更精准的结果。
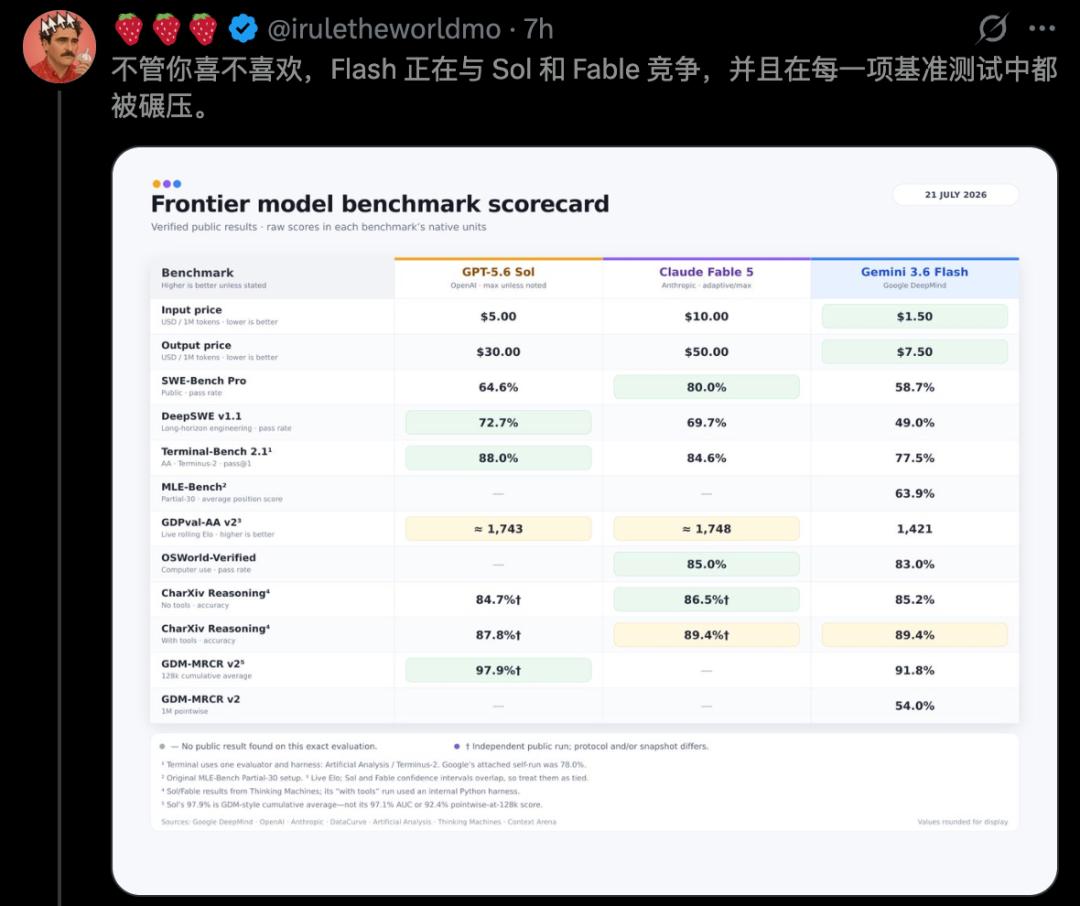
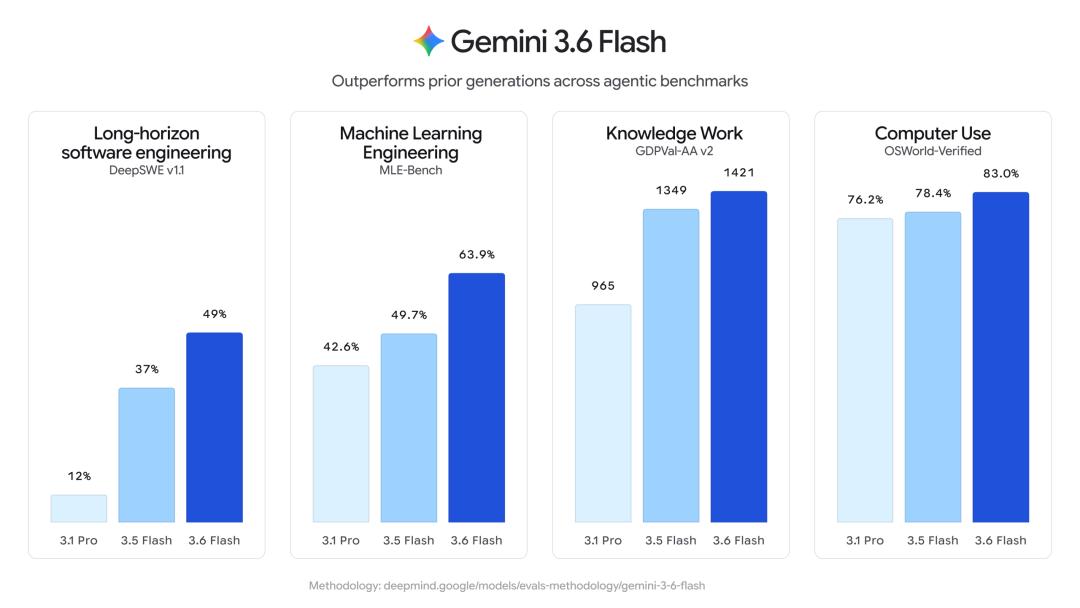
除了效率的提升,价格的调整同样引人注目。Gemini 3.6 Flash的输入价格定为每百万Token 1.5美元,输出价格为7.5美元。这一价格体系不仅低于其前代产品,更在同类高性能模型中具备极强的竞争力。在性能表现上,3.6 Flash实现了全面超越。在编程测试DeepSWE中,其得分从37%提升至49%;在机器学习研究基准MLE Bench中,得分从49.7%跃升至63.9%;而在模拟真实电脑操作环境的OSWorld-Verified测试中,成功率也从78.4%提高到了83%。这些数据表明,3.6 Flash不仅仅是一个“省钱”的模型,更是一个在专业领域具备更强解决能力的智能体。
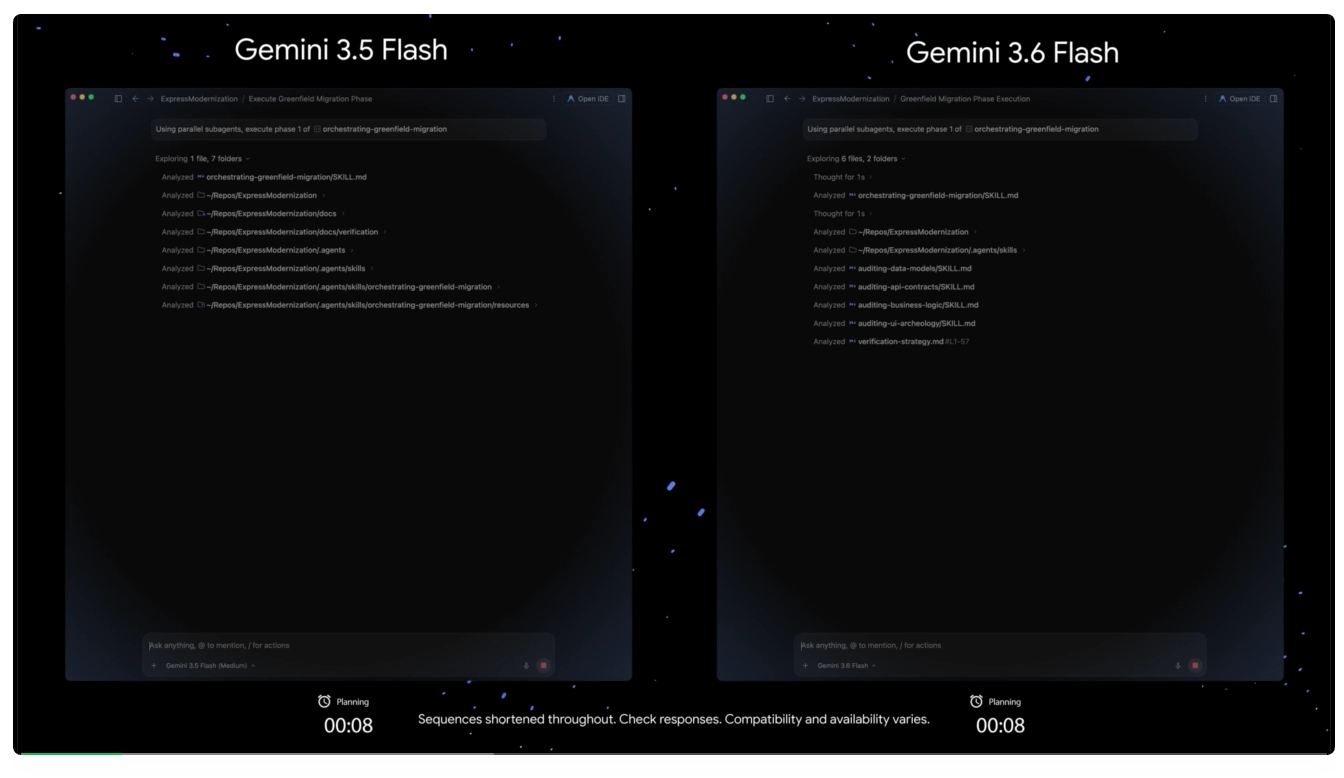
值得注意的是,Gemini 3.6 Flash在多智能体编排方面展现出了独特的优势。通过结合Gemini Canvas功能,它能够高效地打通3D工作流,快速完成如摄影级纹理提取等复杂任务。在实际演示中,该模型能够轻松应对代码迁移等高难度工程挑战,并在响应速度和代码质量上对前代模型形成降维打击。这种能力使其成为构建复杂自动化工作流的理想选择,特别是在需要高精度和多步骤协调的场景中。
如果说3.6 Flash是全能型选手,那么Gemini 3.5 Flash-Lite则是专为速度与规模而生的特种兵。这款轻量级模型的输出速度达到了惊人的每秒350个Token,是整个3.5系列中最快的成员。其定价策略更是极具颠覆性,输入价格仅为每百万Token 0.3美元,输出价格为2.5美元。如此低廉的成本和极高的速度,使其天生适合处理海量文档解析、大规模Agent搜索等高并发、走量的场景。
令人惊讶的是,尽管定位为“轻量级”,Flash-Lite在多项关键测试中却击败了体量更大的Gemini 3 Flash。在SWE-Bench Pro编程基准中,Flash-Lite取得了54.2%的成绩,优于3 Flash的49.6%;在OSWorld-Verified测试中,其74.0%的得分也远超3 Flash的65.1%。这一现象揭示了一个重要的技术趋势:通过针对性的架构优化和数据蒸馏,小模型在特定垂直领域的表现完全可以超越通用大模型。
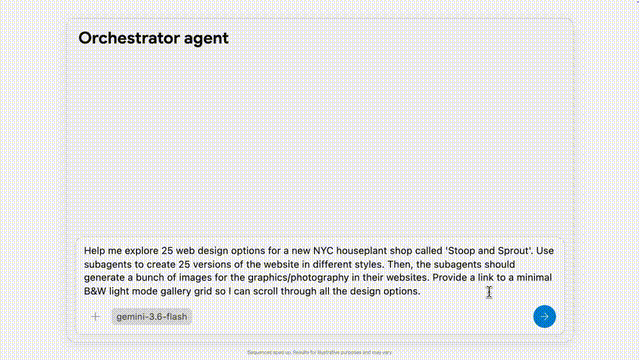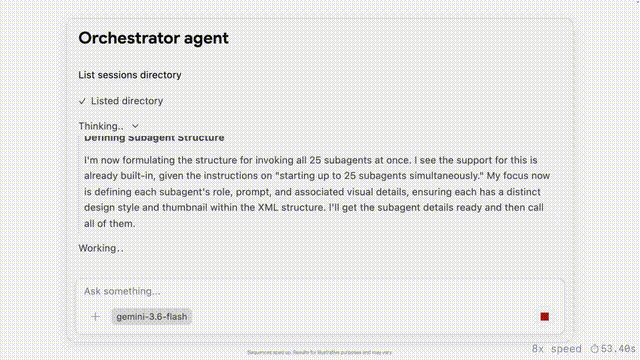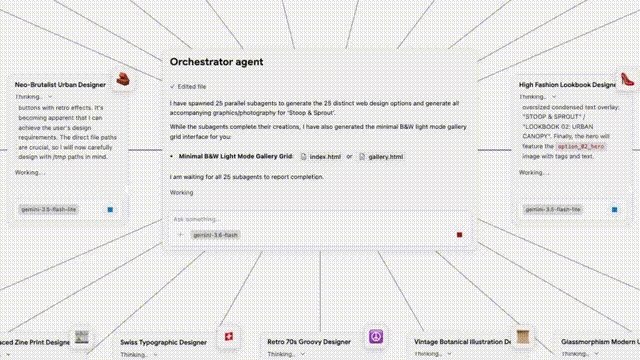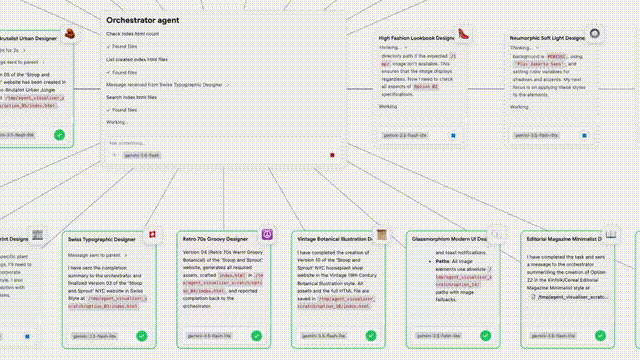
在实际应用架构中,3.6 Flash与Flash-Lite可以形成完美的互补组合。3.6 Flash作为“主脑”,负责复杂任务的拆解、逻辑规划和关键决策;而Flash-Lite则作为“分身”,负责批量执行标准化、高频次的子任务。这种分层架构能够有效抹平高并发带来的压力,显著提升整体系统的吞吐量和稳定性。官方演示显示,在这种组合模式下,系统能够快速生成数十套高可用的网页设计方案,实现了从“想”到“做”的无缝衔接。
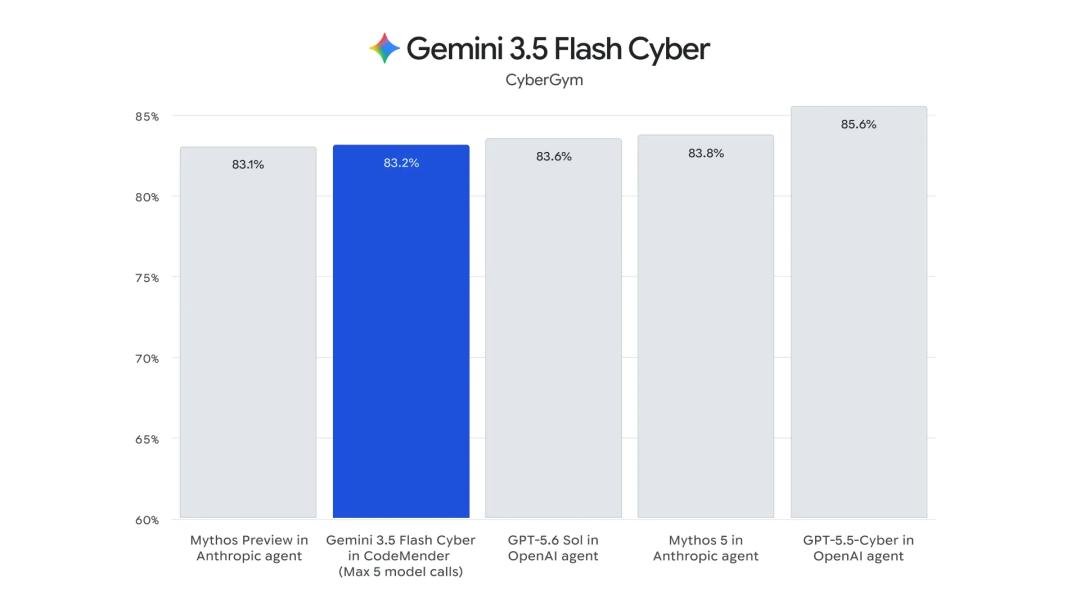
第三款模型Gemini 3.5 Flash Cyber则聚焦于一个日益严峻的领域:网络安全。随着AI生成代码的普及,软件漏洞的产生速度也在加快,传统的安全审计手段已难以应对。Flash Cyber专为查找和修复代码漏洞而设计,被集成在CodeMender代码安全智能体中。通过多个Cyber智能体的协同作战,该模型在CyberGym安全基准测试中刷新了最佳成绩(SOTA),且成本远低于传统的大型安全模型。
然而,由于涉及敏感的安全领域,Flash Cyber目前并未向公众开放,主要服务于特定的企业级安全需求。这一举措体现了谷歌在推动AI普及的同时,对安全风险的高度警惕。利用专用模型处理高风险任务,既能保证精度,又能控制潜在的安全隐患,是未来AI安全治理的重要方向。
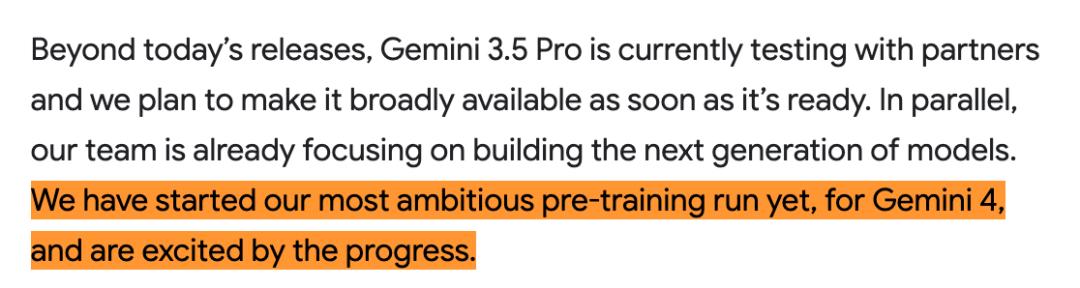
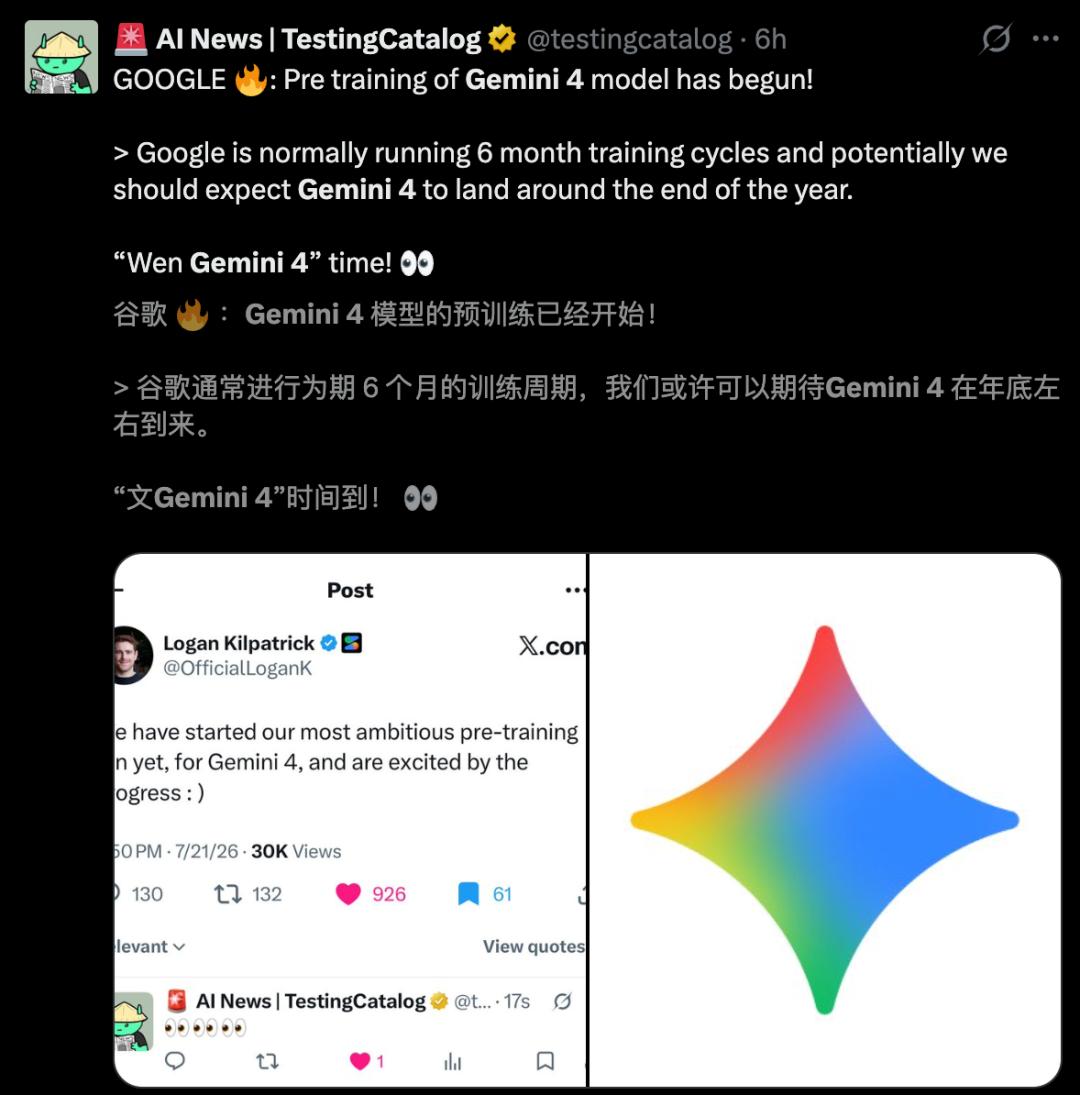
在三款新模型发布的背后,谷歌还透露了一个更具震撼力的消息:Gemini 4的预训练已经正式启动。谷歌DeepMind将其描述为“史上最激进的一次预训练”。按照谷歌通常的六个月训练周期推算,Gemini 4有望在今年年底与公众见面。这一消息意味着,当前的Gemini 3系列可能只是过渡性的产品,真正的技术飞跃还在后面。
Gemini 4的激进预训练,预示着下一代模型可能在架构、多模态理解能力或长上下文处理上取得突破性进展。对于开发者而言,这既是一种期待,也是一种挑战。一方面,更强的模型将解锁更多以前无法实现的应用场景;另一方面,技术的快速迭代要求开发者必须具备更高的敏捷性,能够迅速适应新的API接口和最佳实践。
从宏观视角来看,谷歌的这一系列动作标志着AI行业进入了“效能为王”的新阶段。过去,市场往往被模型的参数量和榜单排名所吸引,而现在,企业和开发者更关注的是实际运行成本、响应速度以及在具体业务场景中的落地效果。Token成本的降低,直接降低了AI应用的门槛,使得更多中小企业和个人开发者能够参与到AI创新的浪潮中来。
此外,专用模型的兴起也反映了AI技术的成熟。通用大模型虽然强大,但在特定领域往往存在效率低下或精度不足的问题。通过推出如Flash-Lite和Flash Cyber这样的专用模型,谷歌正在构建一个更加细分、更加高效的模型生态系统。这种生态系统允许用户根据具体需求选择最合适的工具,而不是盲目追求最大的模型。
对于正在构建AI Agent的企业来说,当前的策略应当是充分利用现有低成本、高效率的模型组合,快速验证商业模式和技术可行性。同时,密切关注Gemini 4等下一代技术的发展动态,为未来的技术升级预留接口。在这一过程中,数据的积累和业务流程的数字化改造同样重要,因为无论模型多么强大,最终的价值都体现在对实际业务的赋能上。
综上所述,谷歌此次发布的三款新模型及Gemini 4的预训练计划,不仅是技术层面的更新,更是行业战略的调整。它强调了成本控制、效率优化和场景适配的重要性,为AI技术的规模化落地铺平了道路。随着技术的不断演进,我们有理由相信,AI将从一种昂贵的实验性技术,转变为像电力一样普及且廉价的基础设施,深刻改变各行各业的生产方式。