智谱自建1GW算力底座:从买卡到造芯,大模型企业的硬核突围战
在人工智能浪潮席卷全球的今天,算力已不再仅仅是支撑模型运行的底层资源,而是决定大模型企业生死存亡的核心战略资产。长期以来,国内大模型厂商高度依赖英伟达的高端GPU集群,这种依赖在供应链波动和地缘政治风险加剧的背景下,逐渐演变为一种难以忽视的战略隐患。近期,智谱AI的一系列动作揭示了行业风向的重大转变:从被动采购转向主动构建,从单一的软件算法竞争延伸至硬核算力基础设施的全面掌控。
智谱正在构建的是一套完全脱离传统英伟达生态的自主算力体系。这一体系并非单点突破,而是涵盖了物理基础设施、中间件软件栈以及上游芯片设计的三维立体布局。首先引人注目的是其自建的1GW级别数据中心。这一规模的数据中心,其供电能力足以支撑数十万户家庭的日常用电,标志着智谱已跻身中国拥有最大型自有算力基础设施的独立模型企业行列。更重要的是,该中心全部采用国产AI芯片,这不仅是对供应链安全的回应,更是对国产硬件生态的一次大规模实战验证。
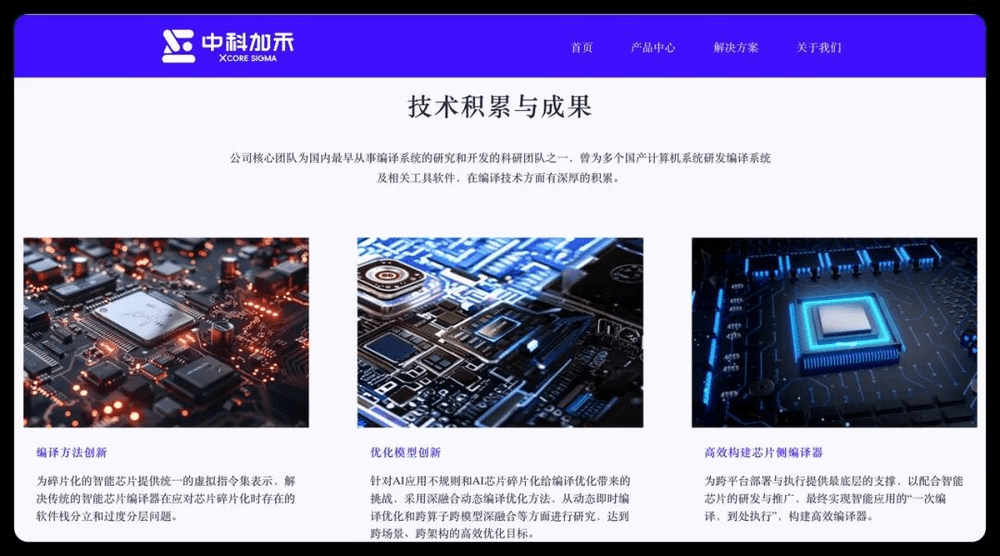
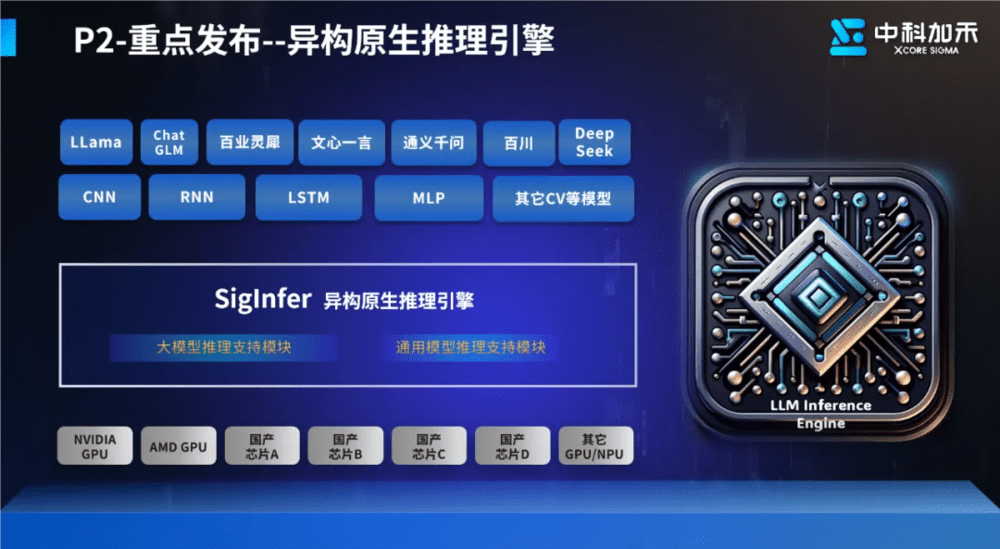
然而,拥有硬件只是第一步。国产芯片种类繁多,架构各异,如何将分散在不同硬件平台上的理论算力转化为模型真正可调用的有效算力,是摆在所有大模型厂商面前的难题。智谱斥资数亿元收购中科系 Infra 企业“中科加禾”,正是为了解决这一痛点。中科加禾的核心能力在于编译器、虚拟指令集、Runtime 和推理引擎,其技术价值在于充当模型与芯片之间的“翻译官”和“优化器”。通过统一的软件接口,降低模型在不同国产芯片间迁移、部署的性能损耗,从而提升整体集群的计算效率。
据测试数据显示,其 SigInfer 推理引擎在特定场景下能显著降低推理时延并提升吞吐率。虽然实验室数据不能完全等同于生产环境的实际表现,但即便只有部分效果兑现,对于日均 Token 消耗量巨大的智谱而言,也意味着数以亿计的成本节约。这种软硬协同的深度优化,是单纯依靠堆砌硬件无法实现的竞争优势。
除了基础设施和软件栈,智谱的目光还投向了更上游的芯片设计领域。虽然目前仍处于评估合作阶段,但这一动向表明智谱开始思考一个根本性问题:能否让未来的芯片架构反过来适应 GLM 模型的负载特征?与训练场景相比,推理工作负载更加稳定且可预测,这为定制专用芯片(ASIC)提供了绝佳的机会。通过针对特定模型结构、内存访问方式和计算精度进行专项优化,定制芯片有望在长期推理成本上实现数量级的下降。
智谱之所以如此急切地补齐底层算力短板,直接驱动力来自于业务爆发带来的巨大压力。随着 GLM Coding Plan 等产品的用户量激增,智谱曾多次面临算力承载上限的挑战。在高并发场景下,模型不仅会出现响应速度下降,甚至会出现输出质量波动,如乱码、复读等现象。经过排查,这些问题往往并非模型权重本身的问题,而是高负载下推理状态管理、KV Cache 错配等系统工程问题所致。
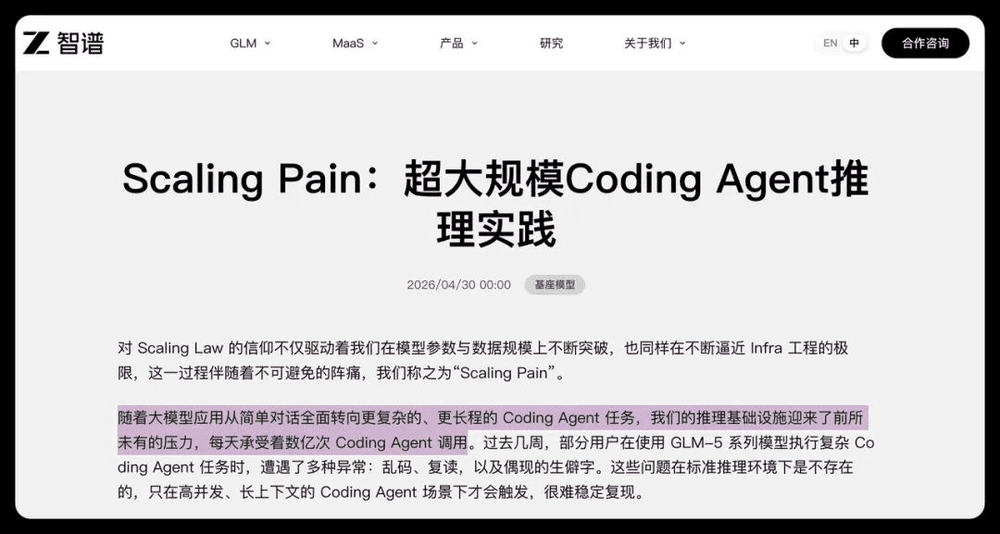
这一现象揭示了一个常被忽视的事实:大模型的能力不仅取决于参数规模,更受制于推理系统的工程化水平。当日均 Token 使用量增长数十倍时,任何微小的系统瓶颈都会被放大,直接影响用户体验。因此,构建稳定、高效、可扩展的推理基础设施,已成为大模型产品竞争力的重要组成部分。
从商业逻辑来看,大模型公司的成本结构与传统的软件公司截然不同。传统软件边际成本极低,而大模型每生成一个 Token 都需要消耗真实的电力、芯片算力和内存资源。智谱的财务数据显示,其收入虽然大幅增长,但销售成本和研发支出的增速更快,其中大部分增量流向了算力采购。如果长期依赖外部供应商,模型公司的利润空间将被不断挤压,且受制于外部价格波动和资源排期。
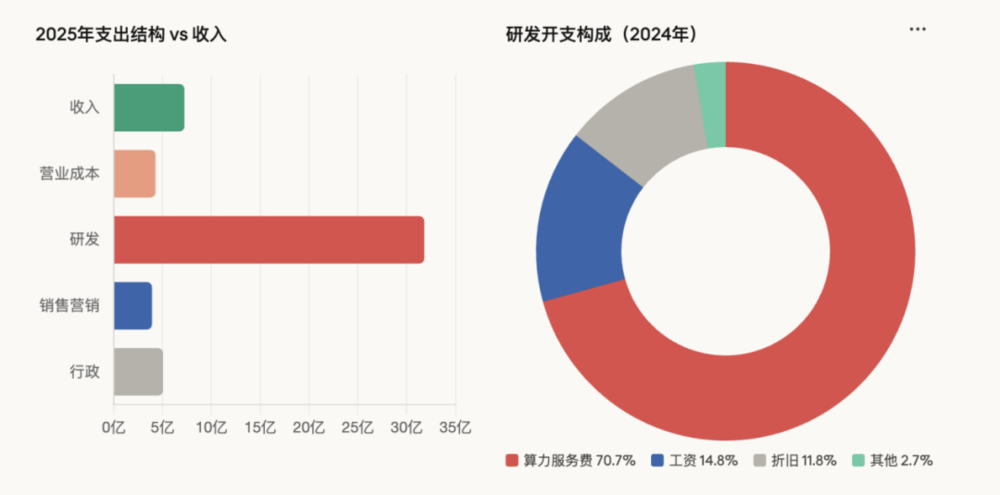
自建数据中心虽然前期投入巨大,且面临设备折旧和技术迭代的风险,但在规模效应显现后,它能提供更高的算力供应确定性和更优的成本控制能力。这是一种用资本换时间、换空间的战略选择。对于智谱这样的头部企业而言,控制算力意味着掌握了未来扩张的主动权。
与此同时,政策层面的支持也为这一趋势提供了强劲动力。国家正在推进“全国一体化算力网”建设,将算力视为像水电一样的基础公共资源。相关补贴政策也从芯片研发延伸至算力项目的实际采购环节,鼓励新建数据中心使用国产 AI 芯片。这意味着国产芯片将进入长期、成规模的基础设施采购体系,为智谱等企业的自主算力布局提供了良好的宏观环境。
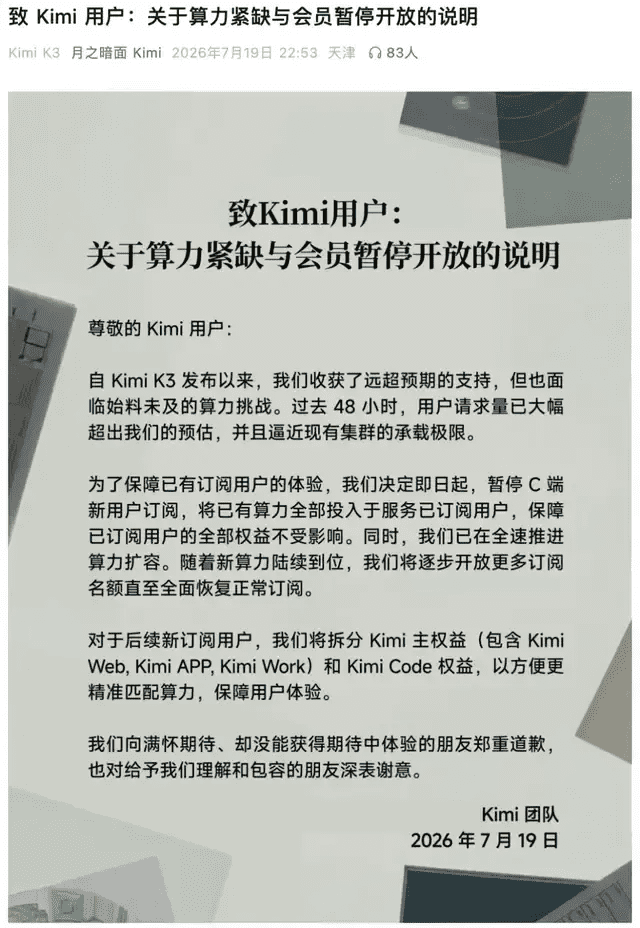
值得注意的是,智谱并非孤例。DeepSeek、月之暗面等独立大模型企业也在采取类似策略,通过组建算力运营团队、增设芯片设计人员等方式,向产业链上游延伸。这表明,中国的大模型竞争已进入深水区,单纯的算法创新已不足以构建护城河,具备全栈技术能力、能够自主掌控算力基础设施的企业,将在未来的竞争中占据更有利的位置。
当然,这条道路充满挑战。自建算力体系需要深厚的工程技术积累、庞大的资金投入以及对国产硬件生态的深刻理解。不同国产芯片之间的兼容性、大规模集群的稳定性、定制芯片的研发周期等问题,都需要逐一攻克。但正如历史经验所示,核心技术的自主可控往往是产业成熟的必经之路。
智谱的算力野望,实际上是中国 AI 产业从“应用驱动”向“基础驱动”转型的一个缩影。在这个过程中,大模型企业不再仅仅是算力的消费者,而是成为了算力基础设施的建设者、优化者和定义者。这种角色的转变,将深刻影响未来几年中国人工智能产业的格局。
随着 1GW 数据中心的全面投运和中科加禾技术的深度融合,智谱有望在国产算力环境下建立起一套高效、稳定的模型训练与推理范式。这不仅有助于降低自身的运营成本,更能为整个国产 AI 芯片生态提供宝贵的反馈和优化方向,推动上下游产业的协同发展。
在未来,我们可能会看到更多大模型企业推出针对自身模型优化的专用芯片,或者形成基于特定硬件架构的专属软件生态。这种垂直整合的趋势,将使大模型服务变得更加高效、廉价和普及。而对于用户而言,这意味着更稳定的服务体验、更低的调用成本以及更丰富的应用场景。
总之,智谱在算力领域的深耕,不仅是为了应对眼前的供应链压力,更是为了在未来的 AI 竞争中占据制高点。通过构建自主可控的算力底座,智谱正在为 GLM 系列模型的持续进化提供坚实的能量源泉,也为中国大模型产业的独立自主发展探索出一条可行的路径。这场关于算力的硬核突围战,才刚刚拉开序幕。