后发大模型突围:模思智能如何以语音重构情境智能?
从文本红海到声学蓝海:一种差异化竞争策略
在人工智能领域,通用大语言模型(LLM)的赛道早已是一片血红的竞争高地。当各大科技巨头和初创企业都在拼命卷参数量、卷上下文长度、卷多模态融合时,模思智能(Musi AI)却走出了一条截然不同的路径。作为源自复旦大学MOSS团队的衍生公司,模思智能没有选择在拥挤的文本领域与巨头正面硬刚,而是将目光投向了看似传统、实则正在经历剧烈范式转移的语音领域。
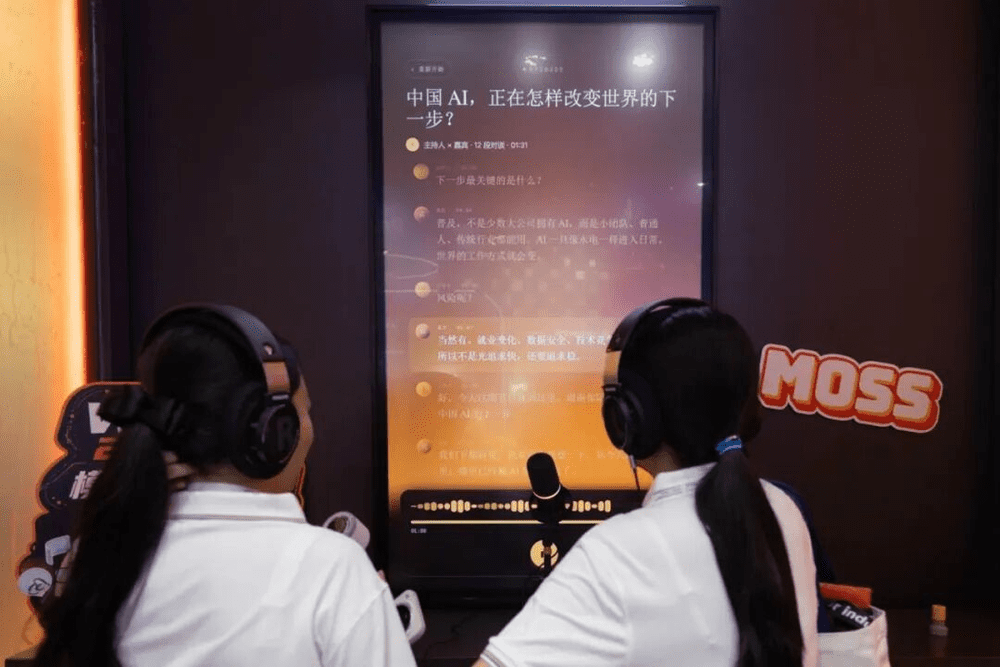
这一决策并非简单的“退守”,而是一种基于对技术瓶颈深刻洞察的战略迂回。传统的语音交互系统通常由自动语音识别(ASR)、大语言模型(LLM)和语音合成(TTS)三个模块串联而成。这种级联架构虽然成熟,但存在致命的信息损耗和低时延问题。每一次语音信号在转化为文本、再被模型处理、最后还原为语音的过程中,说话人的情绪、语调细微变化、环境噪音等丰富信息都会被过滤掉。
模思智能的核心主张是:真正的智能交互不应止步于文本理解,而应回归到声音本身所携带的全维度信息。通过端到端的语音交互模型,模型可以直接接收声音信号并输出声音,从而保留语义、音色、情绪、语速甚至环境声景等关键要素。这种从“处理文本”到“处理信号”的转变,正是模思智能构建情境智能的基石。
情境智能:超越全模态的深层定义
在行业普遍谈论“全模态”的背景下,模思智能提出了“情境智能”这一概念,并将其作为长期技术愿景。许多人误以为情境智能只是简单地将视觉、听觉等多种模态堆砌到一个模型中,但这只是表象。
真正的难点在于,如何让模型理解人所在的物理环境,并在此基础上进行持续、自然的交互。模思智能所定义的情境智能,要求模型不仅能听懂“说了什么”,还要理解“谁在说”、“带着什么情绪说”、“在什么样的环境中说”。这种对声学信号和物理场景的全面建模,使得AI能够像人类一样,在复杂动态的环境中实时感知并做出反应。
例如,在嘈杂的餐厅或活动现场,传统的ASR模型往往难以准确识别特定说话人的内容。模思智能推出的MOSS-Transcribe-Diarize模型,旨在解决这一痛点。它在端到端架构下,同时完成语音转写、说话人分离和时间戳标注。这意味着模型不仅能提取文本,还能从混乱的多人语音中剥离出不同个体的声音特征,实现精准的声源定位和内容归属。这对于具身智能机器人进入公共场景至关重要,因为它们不仅需要“听见”,更需要“听懂”并“分辨”。
需求导向的反向工程:从用户痛点推导技术架构
作为一家后发创业公司,模思智能在成立之初就确立了一个关键原则:从技术导向转向需求导向。早期的学术研究往往是从一个技术问题出发,寻找解决方案;而商业化团队则需要先收集用户对能力、时延、速度的具体需求,再反推数据、架构和训练方案。
这种转变在实时视频理解模型MOSS-Video-Preview上得到了充分体现。以往的视频模型通常将视频切割成片段,逐个处理后再输出结果,导致交互滞后。模思智能的目标是让模型持续接收流式视频输入,在生成回答的同时继续观看新画面。如果画面发生突变,模型能够即时调整输出,甚至支持被用户打断。这种能力对于需要与物理世界持续互动的AI终端来说,是不可或缺的基础设施。
此外,深度思考与低时延之间的冲突也是模思智能重点攻关的技术壁垒。当前提升模型智能的常见手段是延长思维链,但这不可避免地增加了响应时间。模思智能正在探索新的模型架构,试图在保持模型深度思考能力的同时,实现连贯、流畅的实时交互。这不仅是算法层面的优化,更是对计算效率与智能水平平衡点的重新定义。
商业化路径:模型即服务与垂直产品的双轮驱动
在商业模式上,模思智能采取了“MaaS(模型即服务)”与垂直产品并行策略。一方面,通过API向B端客户提供原子化能力,如实时视频流理解、多说话人转写等,服务于车企、AI硬件厂商等内容创作者及具身智能公司。另一方面,公司推出了面向内容创作者的Mossland平台,提供集短剧制作、配音、播客生成于一体的一站式AIGC解决方案。
这种双轮驱动模式具有显著的协同效应。API业务能够帮助公司快速积累真实场景下的用户反馈,验证模型在极端环境(如高噪声、多人混响)下的稳定性;而Mossland等产品则作为技术落地的试验田,通过用户的使用习惯和数据回流,进一步迭代底层模型。目前,模思智能已与多家AI玩具厂商、智能硬件企业以及汽车座舱供应商开展早期合作,尽管大规模规模化收入尚未完全显现,但其验证阶段的反馈已为后续优化提供了宝贵数据。
开源生态与端侧部署:降低门槛与构建壁垒
考虑到自身作为后发者的市场地位,模思智能采取了积极的开源策略。通过开放0.9B参数量的MOSS-Transcribe-Diarize等模型,公司旨在降低开发者使用门槛,扩大社区影响力,并获取来自一线用户的真实反馈。开源并非放弃商业化,而是作为一种获客和反馈渠道,与闭源的高级API和定制化服务形成互补。
在部署层面,模思智能提供了灵活的选择。轻量级版本支持端侧部署,满足具身机器人、智能家居等设备对低延迟和本地隐私保护的需求;而Pro版本则通过云端服务提供更强性能和更高实时性要求的场景支持。这种弹性架构设计,使得模型能够适配从边缘计算到云端的广泛场景,为未来语音、视觉与机器人“大脑”的融合奠定了坚实基础。
终局思维:在碎片化中构建统一的情境交互
尽管目前模思智能的产品线仍分散在语音、视频等不同模块,但其终极目标是将这些能力汇聚为一个统一的端到端全模态模型。李世民指出,当前各个单项能力尚未完全成熟,强行整合可能导致性能折损。因此,分阶段深化单一模态能力,待技术瓶颈突破后再进行融合,是更为务实的技术演进路线。
随着具身智能、车载座舱和新形态AI硬件的兴起,物理交互将成为AI落地的核心场景。在这一背景下,模思智能所坚持的“情境智能”路径,或许正是后发者在巨头林立的大模型时代中,撕开缺口、建立独特壁垒的关键钥匙。通过深耕声学信号与物理环境的深层理解,模思智能正在重新定义人机交互的边界,让AI不再仅仅是信息的处理者,而是环境的感知者与参与者。