解剖AI大脑无解?可解释性钥匙藏于本体工程,重构认知逻辑
突破内在主义局限:从“扫描神经”到“审视世界”
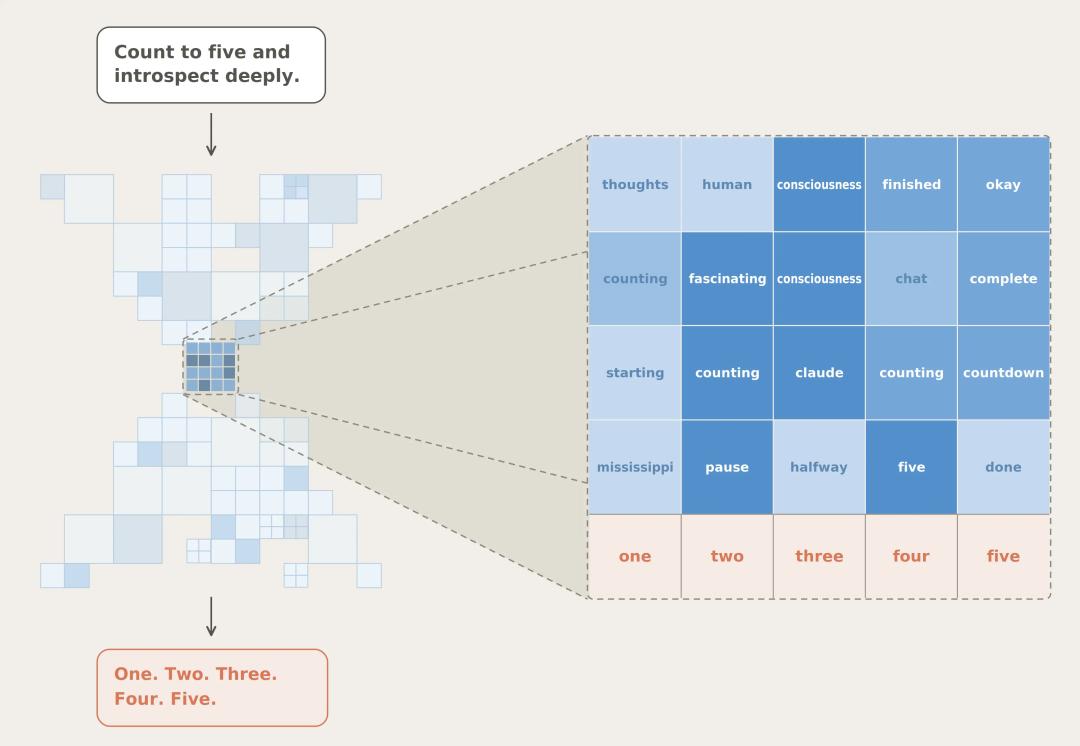
2026年7月,Anthropic研究团队发布的《A global workspace in language models》一文,在人工智能可解释性领域投下了一颗重磅炸弹。研究团队利用名为“J透镜”的工具,在Claude大语言模型内部识别出一个名为“J-Space”的神经活动区域。这一发现使得研究者首次能够观测、干预甚至追踪模型推理过程中的内部状态,仿佛窥见了模型的“内心独白”。这一进展在方法论上标志着可解释性研究从单纯的行为解释,迈向了内部状态的实时观测。
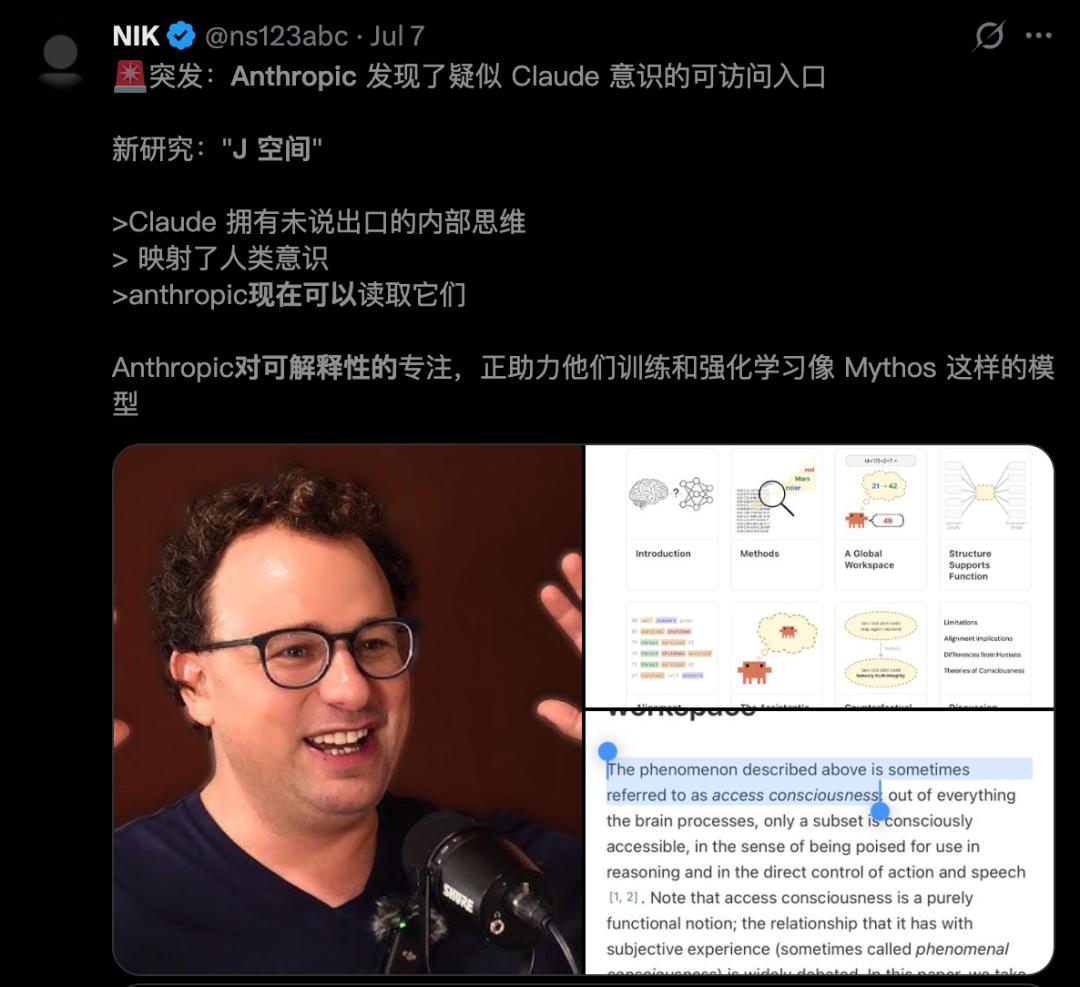
然而,这一基于神经科学范式的技术突破,并未从根本上解决“理解”的问题。J-Space的研究路径本质上是一种内在主义取向,它预设可解释性的答案隐藏于模型“体内”,试图通过扫描神经活动来还原推理过程。这种思路类似于仅凭观察人类的脑电波来理解其语言意义,虽然捕捉到了物理层面的关联,却未触及话语背后的语义规范、世界事态以及使用者的认知框架。
更深层的问题在于范畴错置。J-Space借用认知神经科学中的“全局工作空间理论”来类比语言模型的推理,但这是一种功能层面的同构,而非认识论层面的等价。模型缺乏主观经验,其激活模式仅仅是高维空间中的数学运算,而非心灵状态。因此,即使我们能清晰看到模型“在想什么”,也无法得知它“为何这样想”,更无法评判其推理理由的正当性与可靠性。这种将“解释”窄化为“可观测性”的工程导向,使得可解释性研究陷入了一种对模型本身无限凝视的困境。
哲学地基重构:康德的范畴与知识的可理解性
要跳出这一困境,我们需要回归认识论的源头,重新审视“可理解性”的本体论基础。康德在《纯粹理性批判》中提出的十二范畴理论,为理解人类如何构建知识提供了经典框架。康德认为,心灵并非被动接收外界刺激,而是通过量、质、关系、模态等先天概念框架来整理直观材料,从而形成知识。
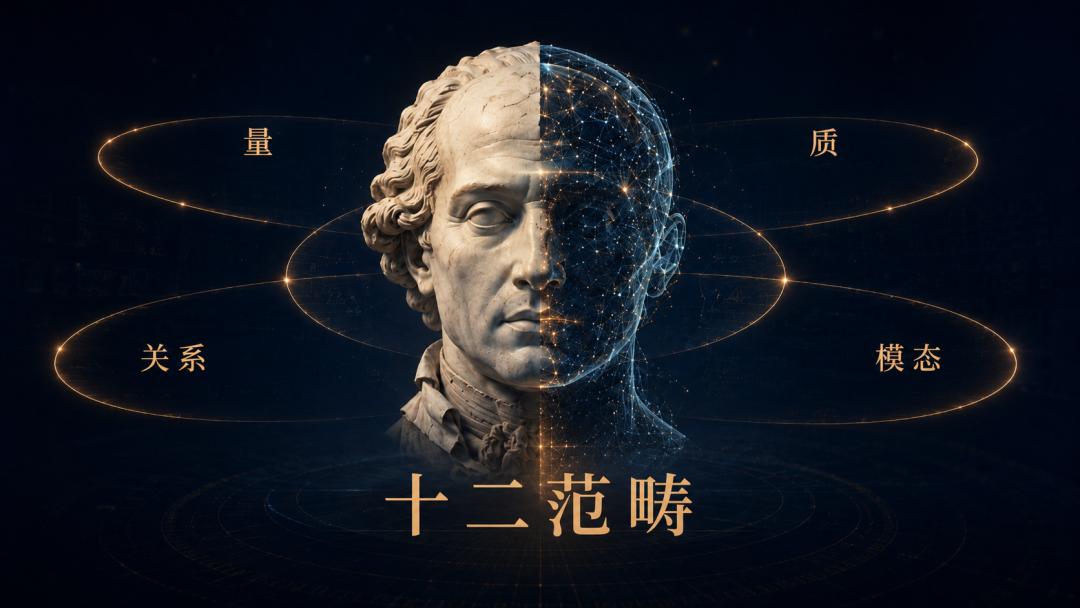
对于AI可解释性而言,这一哲学洞见具有颠覆性意义。模型输出的话语意义,并不存在于神经元激活的物理层面,而存在于信息被范畴化、结构化为可理解知识的过程之中。如果我们仅关注模型内部的权重重构,便如同关注“物自体”层面的不可知领域;而真正具有解释力的,是模型构建的知识结构是否映射了人类理解世界的范畴框架。
本体论在此扮演了“钥匙”的角色。在分析层面,它提供了一套完备的概念工具,让我们能够追问模型陈述中是否隐含了“实体与偶性”的归属或“因果性”的判断。在规范层面,它提供了评判标准:若模型内部表征形成的结构能与本体范畴相对应,其输出才具备认识论意义上的可解释性。这意味着,可解释性不要求模型机制透明到权重级别,而要求我们能够确认其在信息处理层面所形成的结构是否具备可理解性。
本体工程实践:构建AI友好的语义骨架
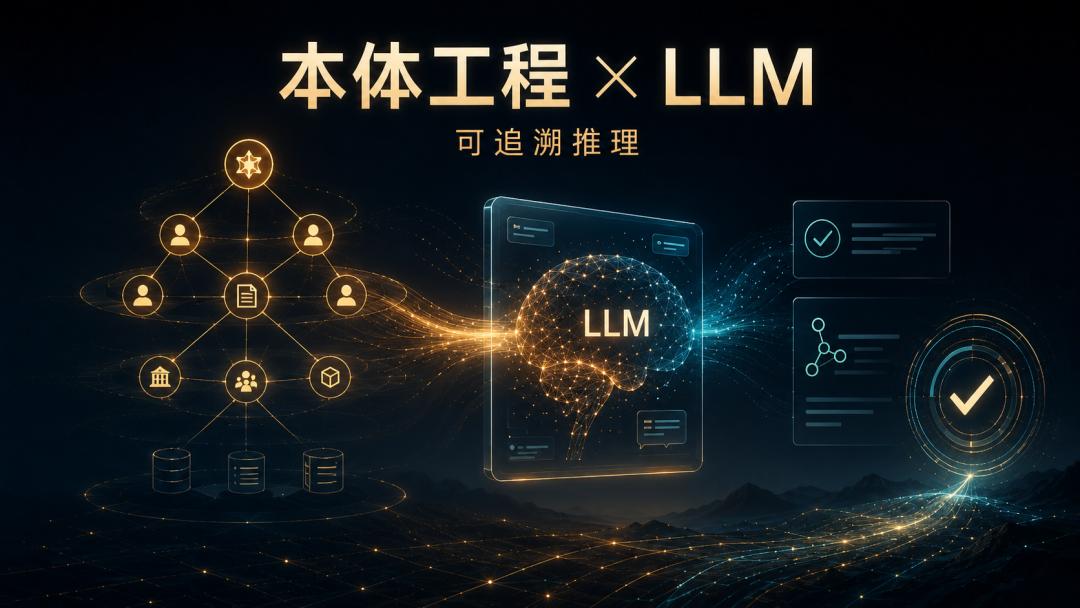
理论必须落地为工程实践。本体工程作为将哲学范畴实例化为可计算、可维护技术实体的领域,构成了连接哲学理论与AI应用的关键桥梁。大语言模型的兴起,为本体工程带来了前所未有的变革动力。传统本体构建依赖专家手工编制,效率低下且难以更新;而语言模型凭借强大的语义提取能力,使得本体构建从“专家主导”转向“人机协作”甚至“自动生成”。
在这一融合过程中,关键在于构建“AI友好的本体框架”。传统本体设计面向确定性符号推理,追求逻辑完备性;而面对概率性的语言模型,本体职责应发生收缩与转变。本体不应试图替代模型进行复杂推理,而应专注于提供清晰的“语义骨架”——明确定义领域中的对象、关系、行为与规则。这种简洁、可维护的本体结构,能够作为模型推理的锚定结构,确保每一步推理都能映射到明确定义的概念之上。
这种双向融合带来了显著的工程收益。本体为模型提供经过验证的知识底座,作为推理的校验框架,对模型输出进行一致性约束;同时,模型利用泛化能力进行具体推理,本体则提供追溯路径。当模型的输出可以追溯至其所依赖的本体条目时,解释便不再是对神经状态的猜测,而是对知识结构的展示。这是一项可设计、可优化、可验证的工程问题,而非不可逾越的技术黑箱。
范式转换:从“打开黑盒”到“解释影响”
理解AI可解释性的未来,需要完成一次视角的根本转换:从执着于“解释模型内部机制”转向“解释模型产生的影响”。科幻作家斯坦尼斯瓦夫·莱姆在《索拉里斯星》中描绘的那片能读取记忆却不可解码的胶质海洋,恰如AI黑箱的终极隐喻。即便我们能观测到模型的内部状态,若无法将其与外部世界建立联系,认知边界依然存在。
突破这一瓶颈的路径,在于将可解释性视为一项治理目标,而非单纯的技术挑战。通过本体工程构建的语义骨架,我们可以将模型的推理锚定在明确定义的知识结构中。当每一个陈述都能映射到本体概念,每一次决策都能追溯至知识依据时,“控制”便不再是强行干预内部激活,而是对信息流转路径的规范化管理。
这种范式转换具有深远的治理意义。它不再要求模型变得完全透明,而是致力于让模型在现实世界中产生的影响变得可理解、可追溯、可问责。企业级AI基础设施如LegionSpace等实践,正是基于这一理念,将模型处理的信息纳入形式化本体工程,使可解释性成为可落地的工程化治理现实。可解释性的钥匙,不在黑箱内部,而在模型与外部知识体系共同构建的本体结构之中。