GPT-5.6上线后Codex为何不可见?八步排查法彻底解决模型缺失难题
模型发布与本地可见性的时差困境
GPT-5.6的正式推出标志着OpenAI在智能代理与代码生成能力上的又一次重大跨越。官方公告明确指出,该模型现已在ChatGPT、Codex CLI以及OpenAI API中全面开放。然而,在技术圈的实际反馈中,一个普遍存在的痛点迅速浮现:尽管官方宣称全球逐步上线,但大量开发者在更新本地Codex客户端后,依然无法在交互界面或模型选择器中找到GPT-5.6的身影。
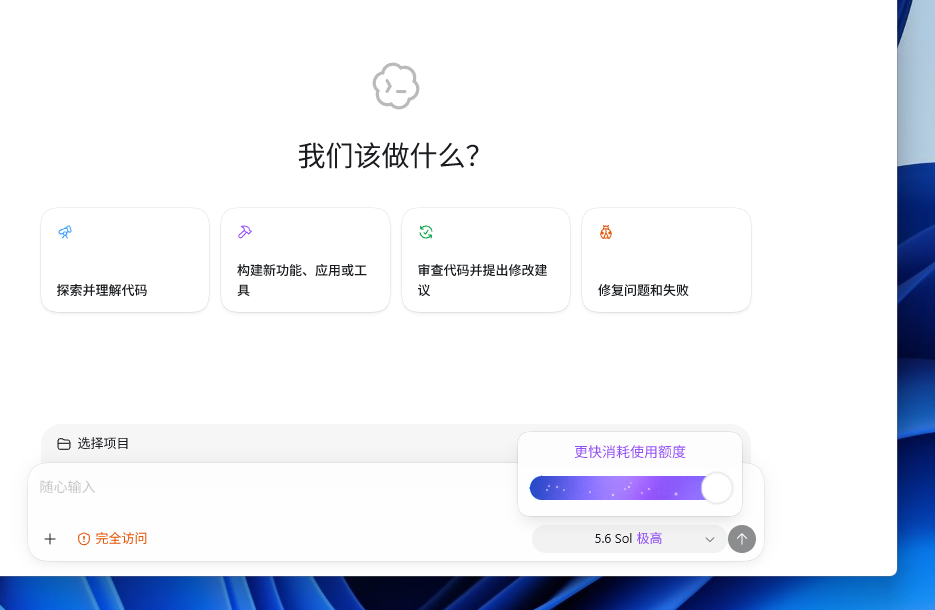
这种现象并非个例,而是分布式系统中常见的“最终一致性”延迟问题。模型的发布是一个多层级的系统工程,涉及云端模型权重的部署、API网关的权限配置、第三方代理服务的同步,以及本地客户端的缓存刷新。对于开发者而言,简单地更新软件往往不足以解决所有问题,因为本地环境可能仍指向旧的配置路径或缓存数据。理解这一背后的技术逻辑,是高效使用新模型的关键。
诊断先行:明确“不可见”的技术属性
在着手修改配置之前,首要任务是精准定位问题所在。笼统地认为“模型没上线”往往会导致无效的操作循环,如反复重装或清理用户目录。有效的排查应基于具体的报错现象进行分类。
如果问题表现为ChatGPT界面内不可见,通常涉及账号层级、地区限制或渐进式发布(Rollout)策略,这与本地CLI工具关联较小。若问题集中在Codex CLI的/model选择器中,则更可能与客户端版本、远端模型目录同步或本地配置覆盖有关。而若在使用Codex++、CC Switch等第三方管理工具时出现异常,则需考虑工具自身的缓存机制是否未与新模型列表同步。
此外,还需区分“选择器中不可见”与“实际调用失败”两种情况。前者多为UI渲染或配置加载问题,后者则直指API Key权限、Base URL路由错误或模型分组限制。通过观察终端输出的错误代码(如401认证失败、403禁止访问、429频率限制或Model Not Found),可以迅速缩小排查范围,避免盲目操作。
环境基线检查:版本与路径确认
排查的第一步是确保本地运行环境处于最新状态,并确认执行路径无误。在Windows PowerShell环境中,执行codex --version是验证当前实例版本的基础操作。若版本滞后,可能无法识别新发布的模型标识符。
对于通过npm安装的用户,执行npm install -g @openai/codex@latest是标准的更新路径。值得注意的是,Windows系统存在多路径环境变量优先级问题。执行Get-Command codex和where.exe codex有助于揭示系统中可能存在多个Codex安装实例的情况。若发现多个路径,需确保终端当前指向的是最新更新的目录,否则可能出现“更新成功但旧版本仍在运行”的错觉。更新完成后,务必关闭并重新打开终端窗口,以清除环境变量缓存,确保新路径生效。
核心诊断:深入模型目录底层
当基础版本确认后,核心排查点在于Codex客户端实际拉取的模型目录。许多开发者仅依赖UI界面中的/model命令,但这往往受到前端缓存或同步延迟的影响。更具诊断价值的是使用codex debug models命令,该命令直接读取Codex当前视角的原始模型清单(Raw Model Catalog)。
在PowerShell中,可通过管道筛选查看特定模型是否存在:codex debug models | Select-String -Pattern "gpt-5.6|5.6"。若输出中包含gpt-5.6-sol、gpt-5.6-terra等变体,则证明后端模型目录已成功同步,问题并非出在“模型缺失”,而是配置或选择器的显示层面。
为进一步确认数据来源,可引入--bundled参数执行codex debug models --bundled。该命令仅读取二进制文件内置的静态模型列表,不请求远端同步。通过对比两条命令的输出:若远端命令显示有新模型而bundled命令没有,说明客户端已通过API拉取到最新数据,UI未刷新可能是暂时性缓存问题;若两者均无新模型,则需回溯版本更新或网络连通性。
配置层排查:优先级与陷阱
Codex的配置加载机制具有明确的优先级,理解这一层级是解决“配置不生效”的关键。配置文件通常位于用户主目录的.codex/config.toml(macOS/Linux)或%USERPROFILE%\\.codex\\config.toml(Windows)。
常见误区在于将model = "gpt-5.6-sol"错误地放置在[model_providers.xxx]分组内。正确的做法是将其置于配置文件的根级别。此外,项目级配置(如项目根目录下的.codex/config.toml)优先级高于用户级配置。若项目中存在此类文件,它可能会覆盖用户的默认设置。使用/debug-config命令可以可视化当前生效的配置层级,帮助开发者确认哪一份文件正在起作用。
对于使用Codex++、CC Switch等第三方管理工具的用户,这些工具往往维护独立的模型列表缓存。即使Codex CLI已更新,管理工具内部的模型数据库可能尚未同步。此时,需在管理工具界面内手动触发“刷新模型列表”或“同步后端”操作,并确保当前激活的Provider正确指向了支持GPT-5.6的服务端点。
连通性验证:API与Provider路由
即使本地配置无误,若API路由或Key权限受限,模型依然无法调用。通过直接测试Provider的/v1/models端点,可以验证Key的可见性。例如,若使用KKFlow等第三方聚合服务,可执行curl命令测试:curl.exe "https://kkflow.org/v1/models" -H "Authorization: Bearer <Your_Key>"。
若返回的JSON列表中未包含GPT-5.6相关标识,说明当前Key所属的分组或套餐未获得该模型的访问权限。此时,无论本地如何配置,调用必然失败。需检查供应商后台的模型权限设置,或确认Base URL是否指向了支持该模型的特定端点。需要注意的是,ChatGPT Web端的模型可见性与Codex CLI调用的Provider链路是解耦的,前者不直接决定后者的可用性。
高级调试与隔离验证
若上述步骤均无法解决问题,可采用隔离法进行深度诊断。设置临时环境变量$env:CODEX_HOME指向一个空的临时目录,然后启动Codex。这种做法剥离了历史配置、旧Profile及残留缓存的干扰。若在新环境中能正常识别GPT-5.6,则原配置文件或数据目录中存在冲突项。此时,应逐一排查旧目录下的配置文件、日志及缓存数据,而非盲目删除整个.codex目录,以免丢失重要的会话历史或认证令牌。
此外,codex doctor命令提供了全面的系统健康检查,涵盖安装路径、配置语法、认证状态及Git环境等。其输出结果为寻找深层配置冲突提供了系统性线索。
标准化操作清单
为简化排查过程,建议遵循以下标准化流程:
- 版本核验:执行
codex --version及路径检查,确保运行最新实例。 - 目录探测:运行
codex debug models并筛选新模型标识,确认后端同步状态。 - 捆绑对比:执行
codex debug models --bundled,区分静态包与动态拉取数据。 - 配置审查:检查
config.toml根级别设置,排除项目配置覆盖。 - Provider验证:通过API端点测试Key权限及模型可见性。
- 手动调用:若选择器不可见但目录已同步,使用
codex -m gpt-5.6-sol强制指定模型进行验证。 - 工具同步:刷新第三方管理工具的模型缓存。
- 系统诊断:运行
codex doctor获取最终诊断报告。
通过这一套逻辑严密、层层递进的排查方案,开发者可以高效地解决GPT-5.6在Codex环境中不可见的问题,确保新技术能力迅速转化为生产力。这一过程不仅解决了具体报错,更深化了对AI工程化工具链运行机制的理解。