ZONOS3-Mini开源:1亿参数实现实时语音克隆与精细控制
告别“机器味”:ZONOS3-Mini 的登场
在语音合成(TTS)领域,我们长期面临一个两难选择:要么追求极致的自然度和情感表现,但这通常意味着巨大的模型体积和高昂的计算成本,难以在本地设备实时运行;要么为了速度牺牲音质,得到那种听起来平淡、带有明显电子味的“机器音”。
Zyphra 最新发布的 ZONOS3-Mini 试图打破这个僵局。这不是一个仅仅在实验室里跑分的模型,而是一个真正面向边缘计算、旨在让高质量语音克隆走进浏览器和手机的开源项目。
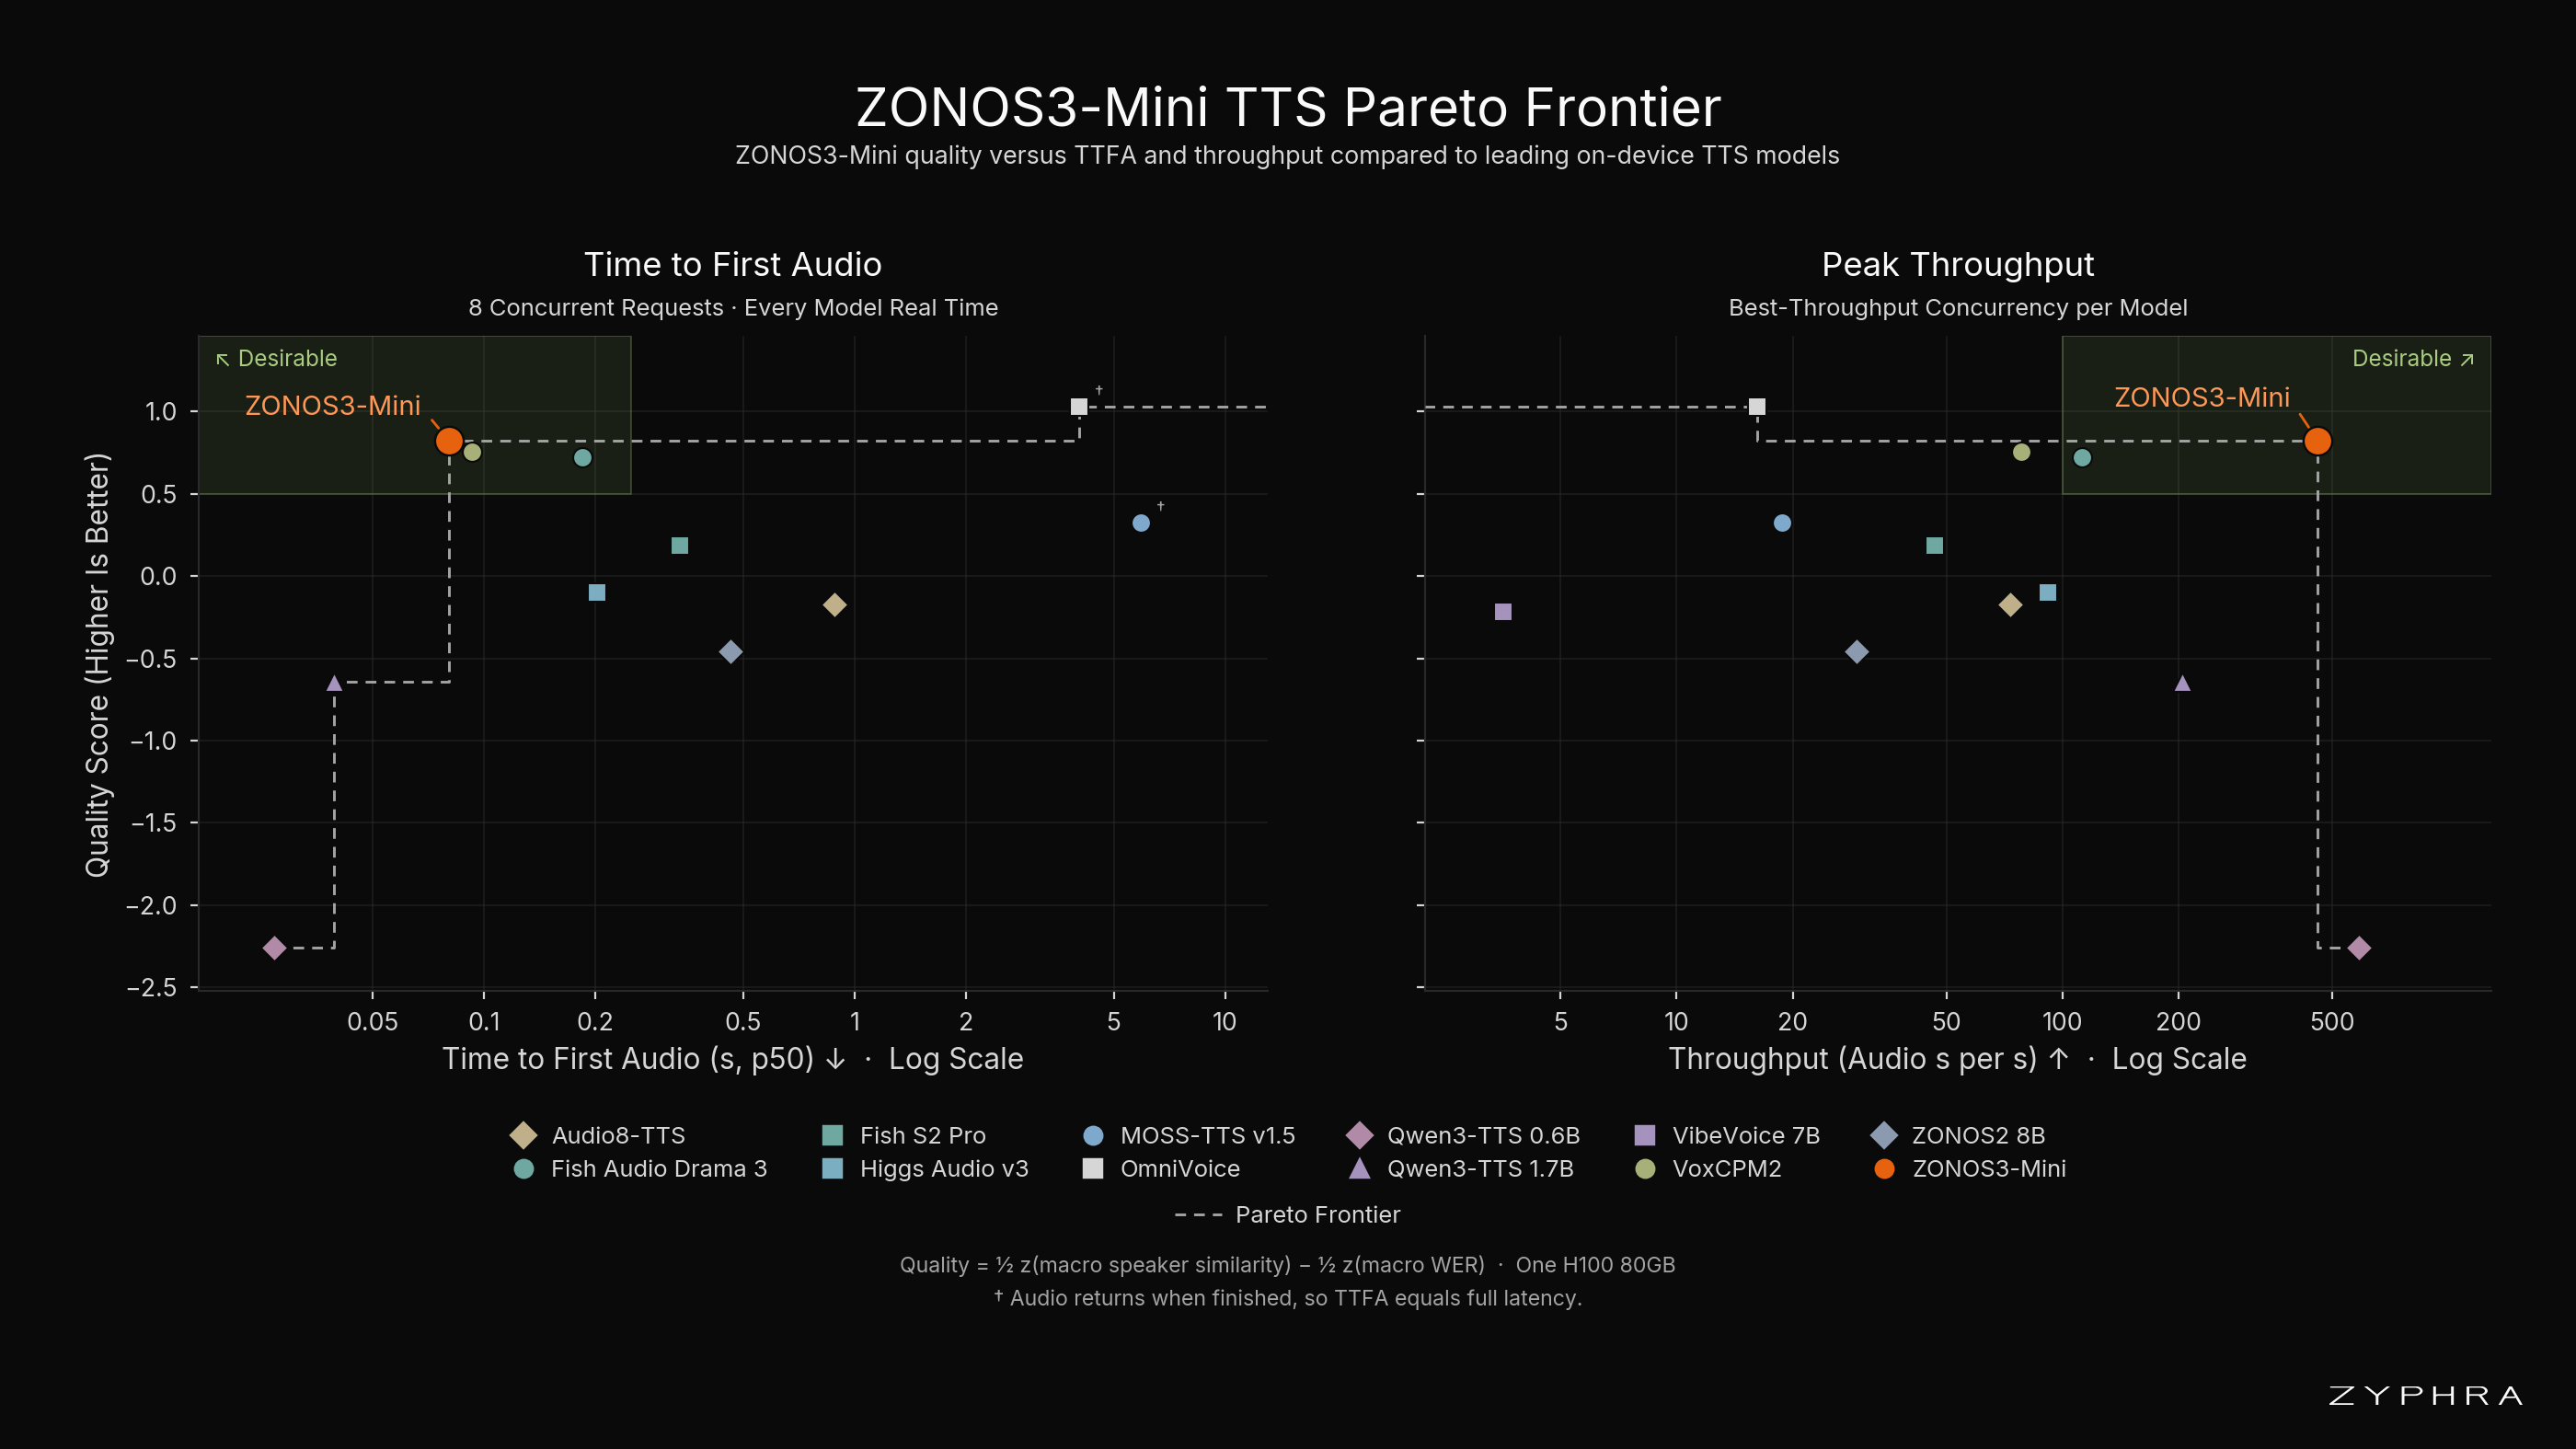
最引人注目的是它的“瘦身”效果。ZONOS3-Mini 只有 1 亿个激活参数(总参数量 8 亿),相比前代 ZONOS2 的 80 亿参数 backbone,体量大幅缩小。但别被数字迷惑,它在多项基准测试中击败了 Fish Audio、Qwen TTS 等知名开源模型,甚至在某些指标上逼近专有商业模型。更重要的是,它支持 43 种语言,并且允许用户对声音进行像素级的精细控制——从调整口音到改变说话时的情绪张力,无需重新训练模型。
为什么它能跑得这么快?
ZONOS3-Mini 的速度优势并非来自简单的模型剪枝,而是源于底层架构的重构。团队在音频表示、序列建模和说话人表征三个关键环节做了大量工作。
1. 更聪明的音频编码器:ZAC-1
传统的神经音频编解码器(如 DAC)虽然重建音质好,但帧率高达 86 Hz,这对自回归模型来说负担太重,导致生成延迟高。Zyphra 为此专门训练并开源了 Zyphra Audio Codec 1 (ZAC-1)。
ZAC-1 将帧率降低到 15 Hz,同时保持 44.1 kHz 的输出采样率。它采用双重编码策略:第一个码本量化语义特征,其余九个码本处理声学残差。这种设计让后续的 Transformer 骨干网更容易建模。数据显示,在相同数据约束下,基于 ZAC-1 训练的 TTS 模型,其词错误率(WER)比基于 DAC 的模型降低了 10 倍,同时声学相似度更高。
2. 混合架构:Gated DeltaNet + Latent MoE
ZONOS3-Mini 没有盲目堆叠注意力机制,而是采用了一种混合序列混合器。在 11 层网络中,9 层使用 Gated DeltaNet (GDN),这是一种循环结构,擅长处理长序列且计算效率高;另外 2 层使用全局多头注意力机制,用于捕捉长距离依赖。这种组合让模型能在 32,768 个位置的上下文窗口中高效工作,足以处理长达 10 分钟的连续音频。
此外,模型引入了潜在混合专家(Latent MoE)机制。每个令牌只激活 64 个专家中的 2 个,这使得模型在保持 8 亿总参数容量的同时,每次推理仅动用 1 亿参数。这种稀疏激活策略是其在消费级硬件上实现实时推理的关键。
3. 双模说话人表征
为了让语音克隆更像“本人”,ZONOS3-Mini 放弃了之前的 Qwen3-TTS 编码器,转而使用 MECT-B2 说话人验证模型。它提供两种克隆模式:
- 上下文参考模式:输入一段最多 60 秒的参考音频,模型会提取其韵律特征,生成自然且不僵硬的语音。
- 直接嵌入模式:使用 192 维的 MECT-B2 嵌入向量。这种方式更紧凑,适合构建语音预设,并且为后续的“机械可控性”打下了基础。
像调音台一样控制声音
大多数 TTS 模型只能做到“像某人说话”,但 ZONOS3-Mini 进一步做到了“让某人以某种方式说话”。这得益于其机械可控性(Mechanistic Controllability)设计。
通过激活 steering(Activation Steering)技术,用户可以在推理过程中直接干预模型的内部状态,从而调整声音的各种属性,而无需重新训练或微调。
声音设计:定制你的角色
你可以像调节均衡器一样调整声音的物理特征:
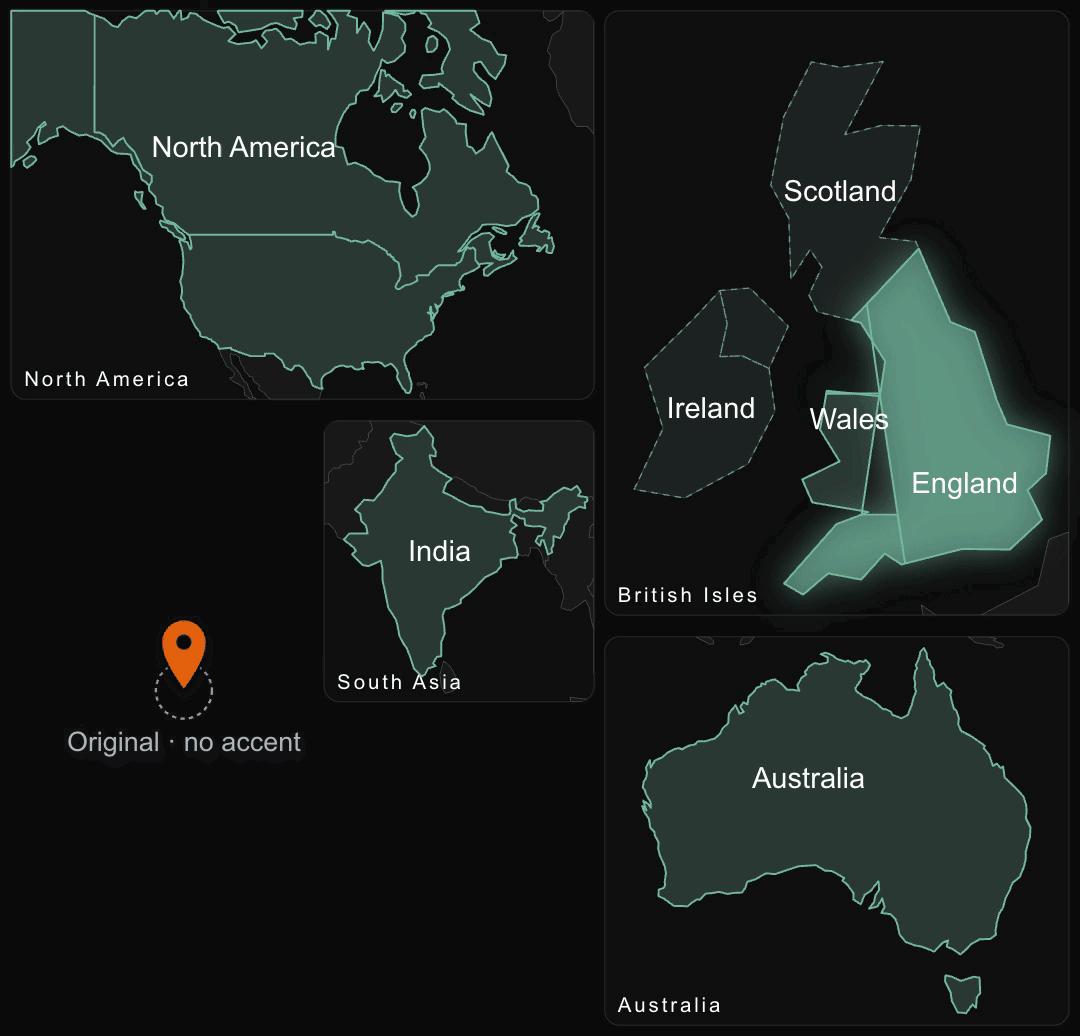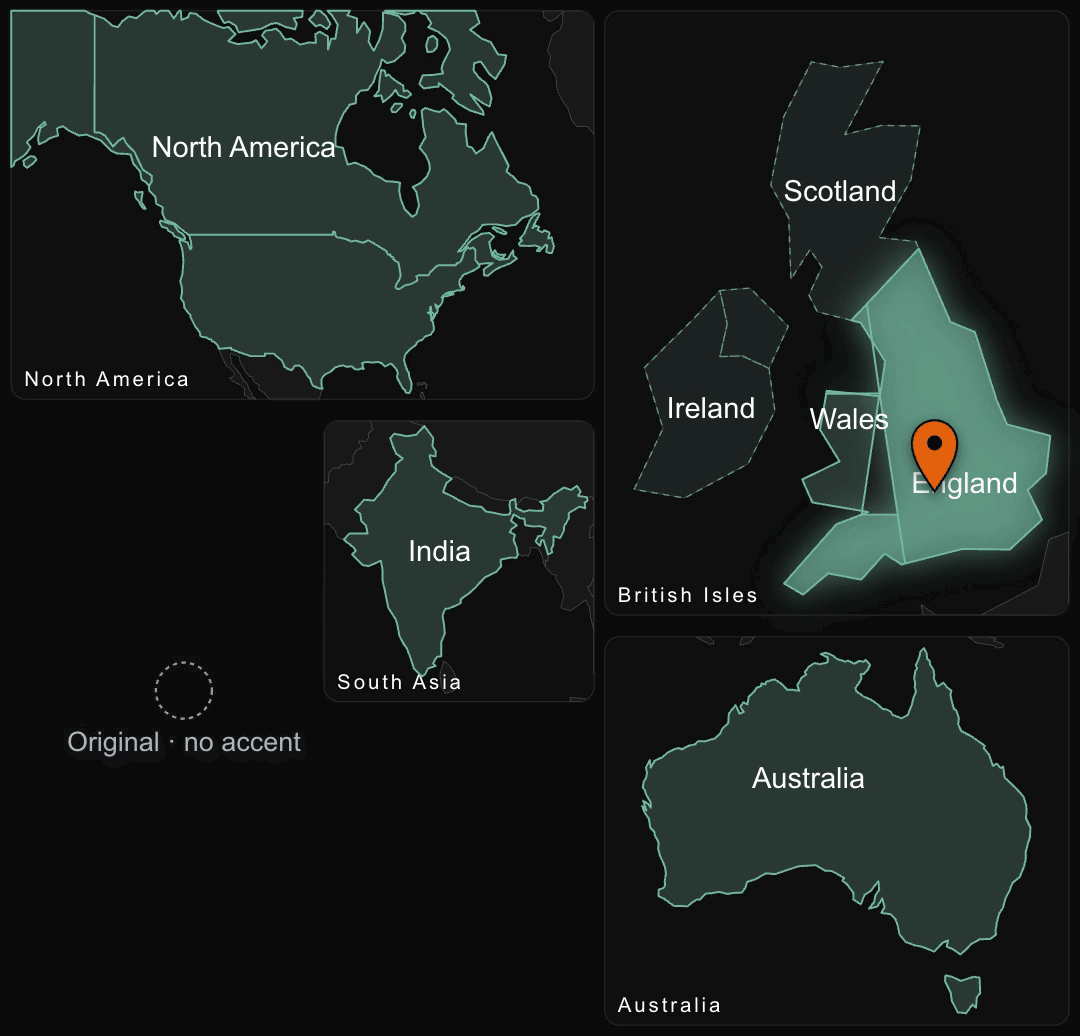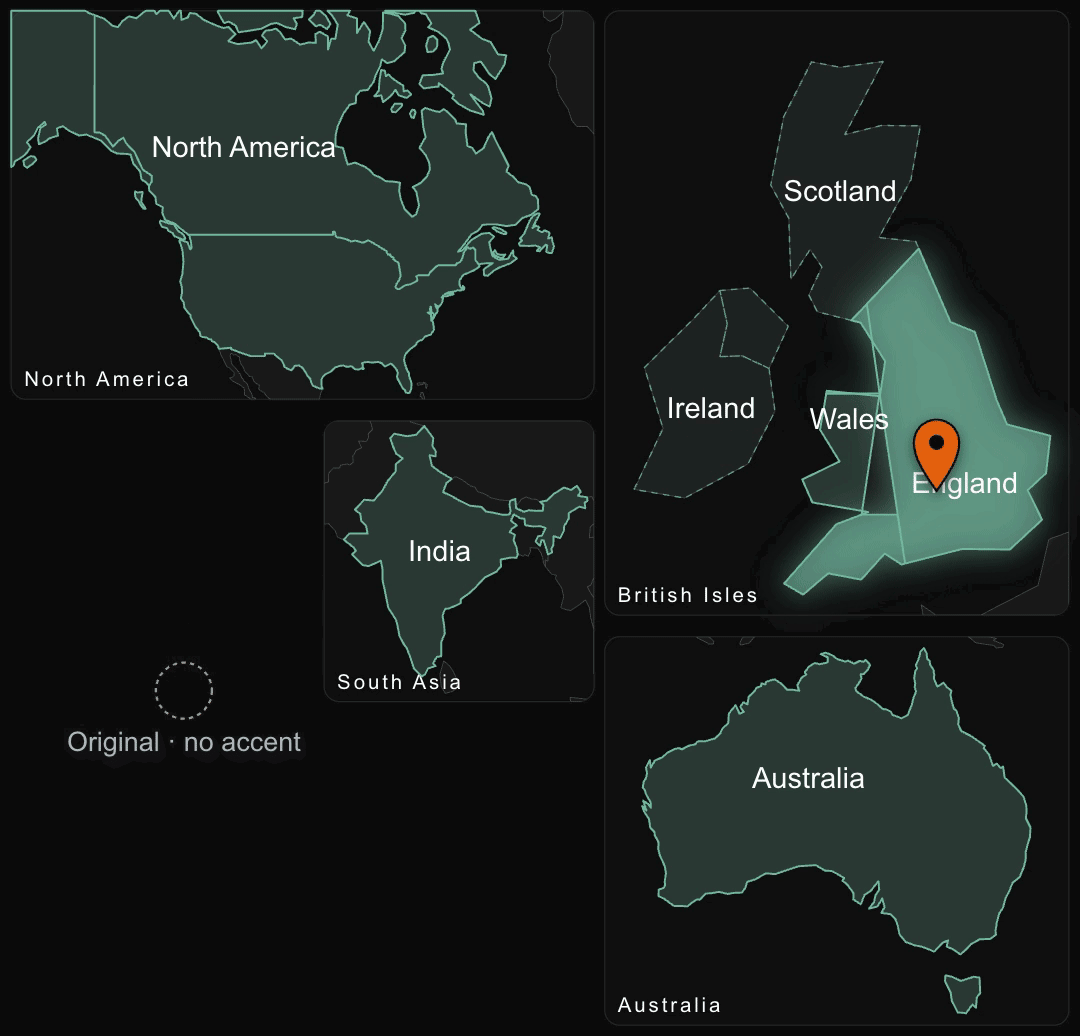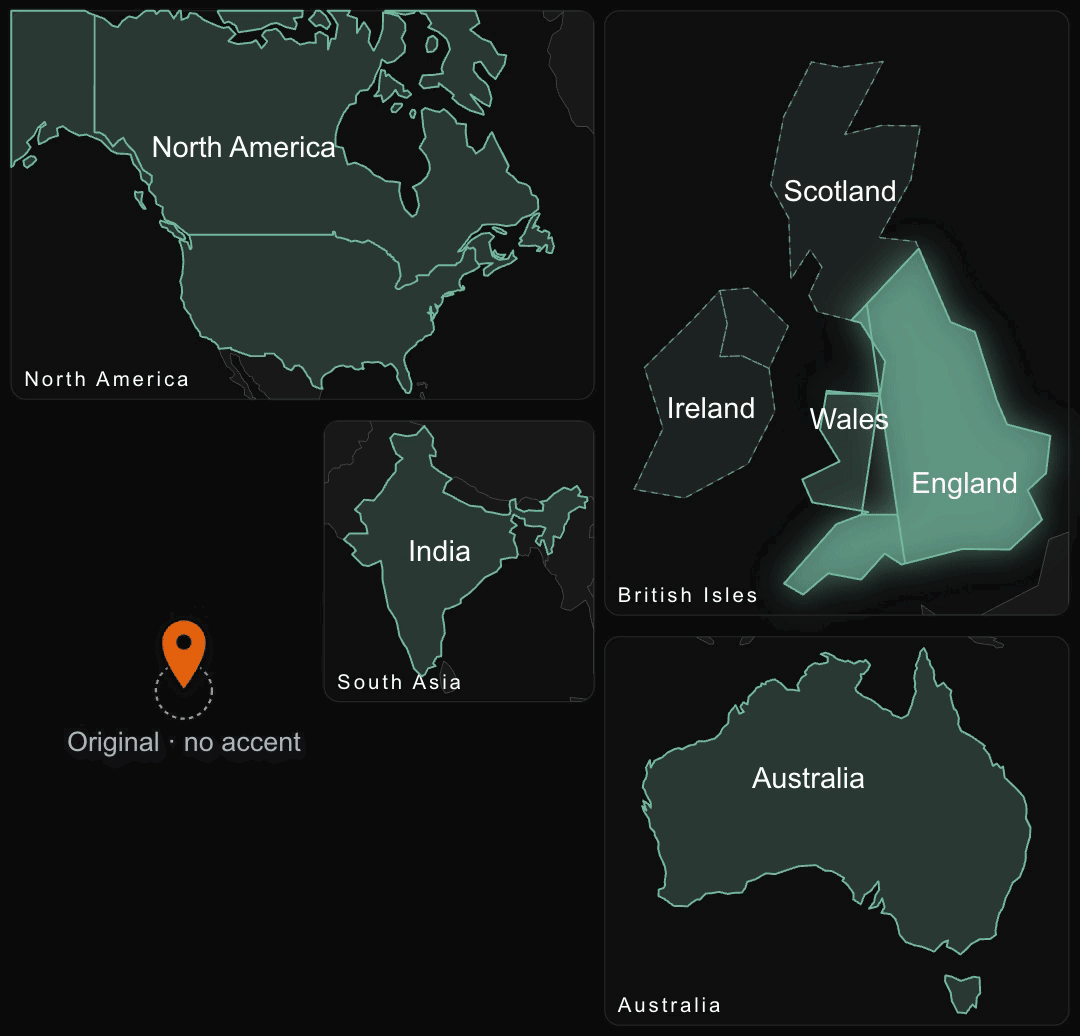
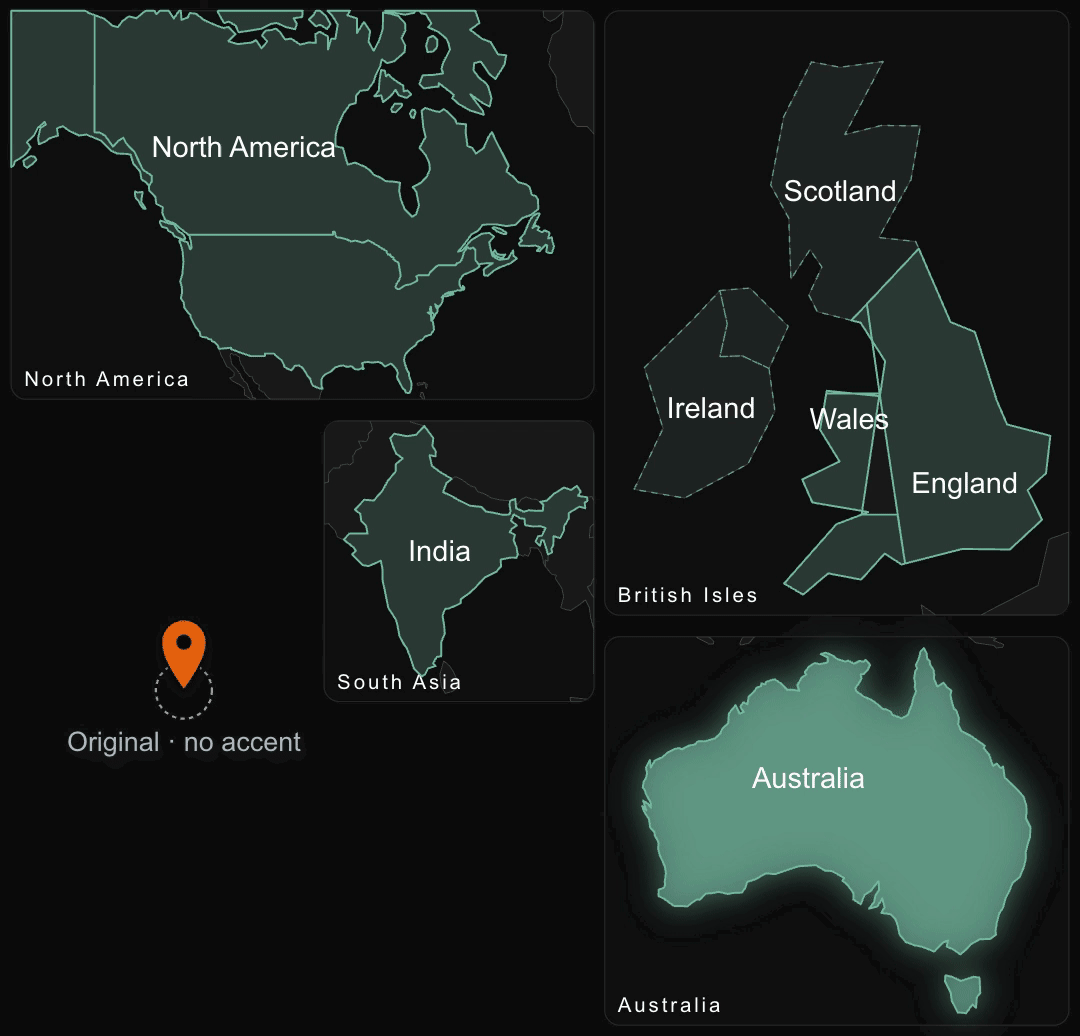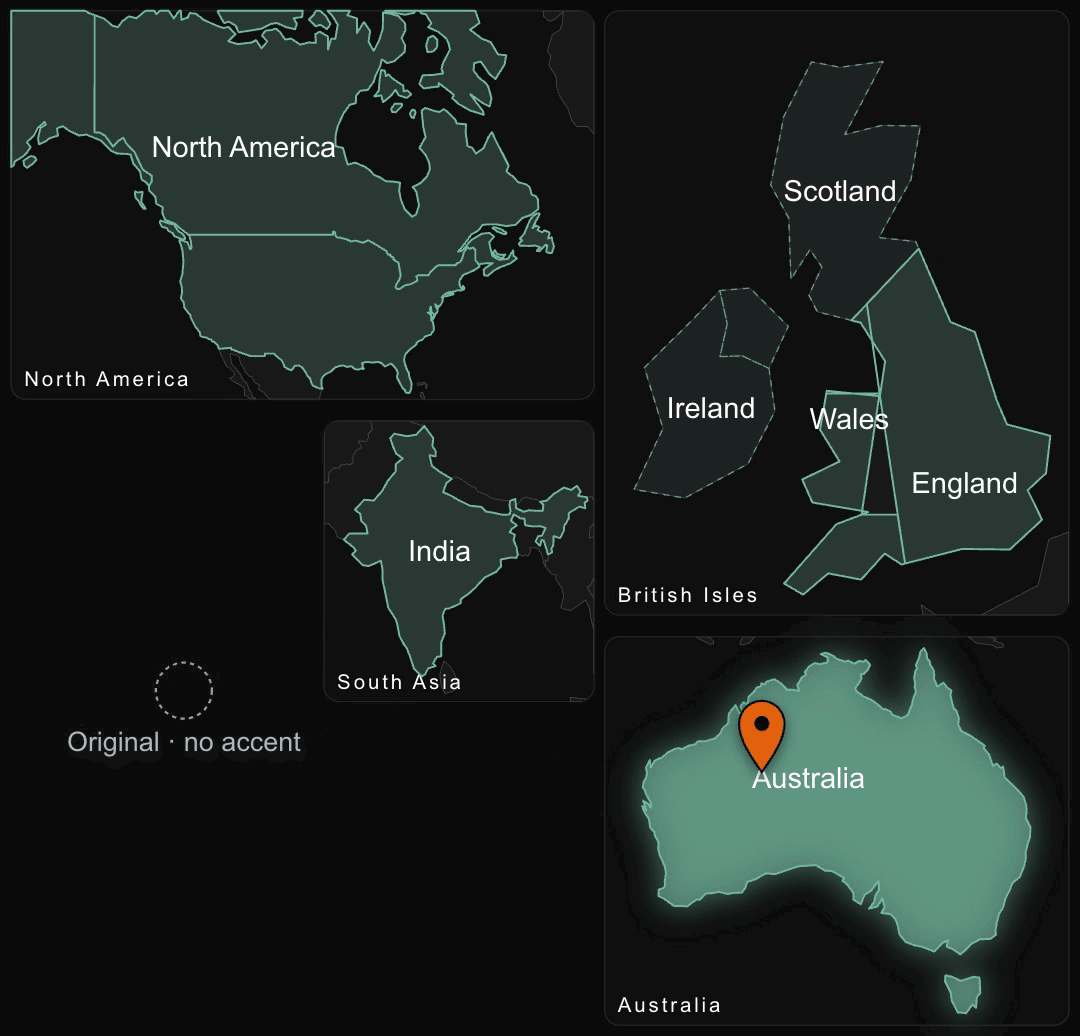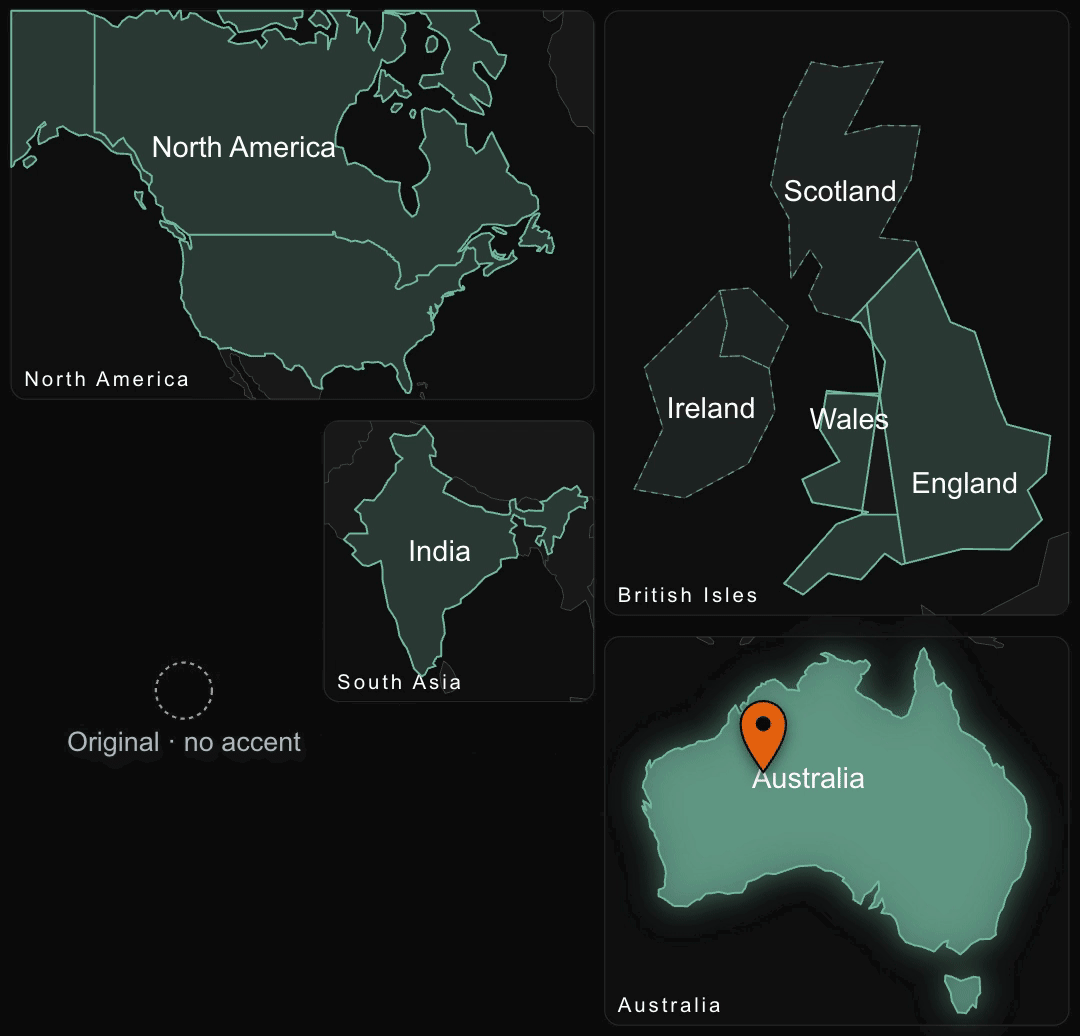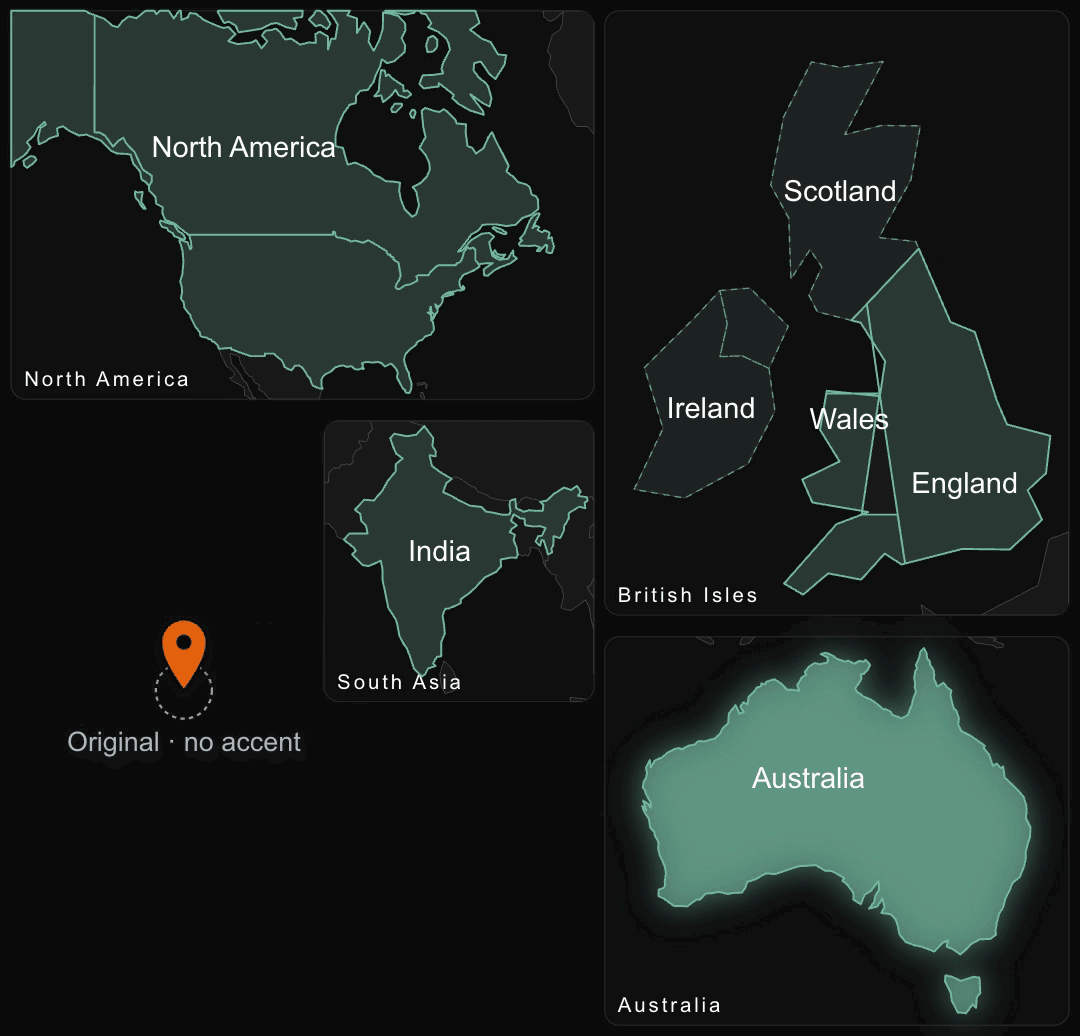
- 口音切换:保持同一个说话人的音色,但将其口音从美式英语切换到英式南部口音,甚至澳大利亚口音。测试显示,发音变化明显,但身份特征保持一致。
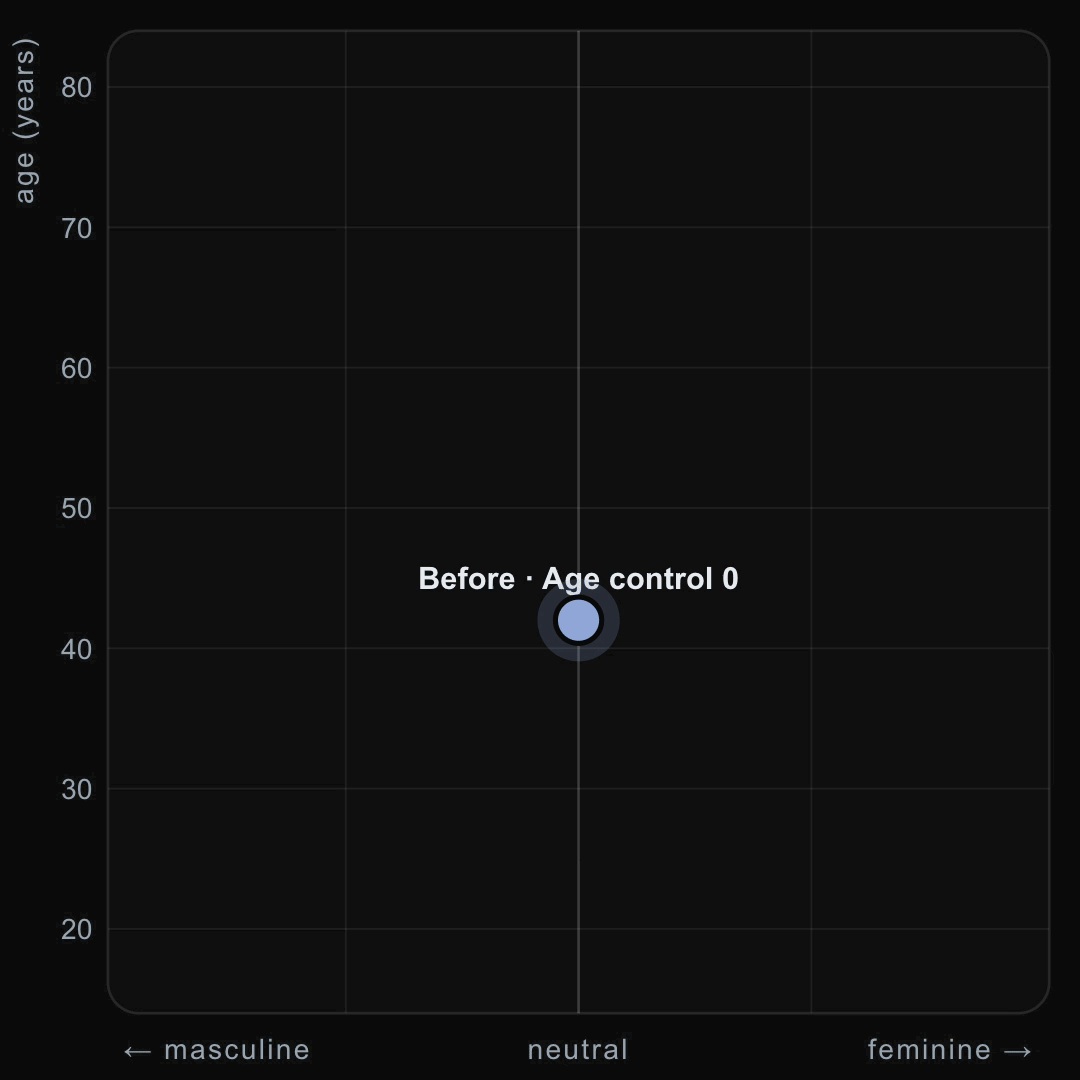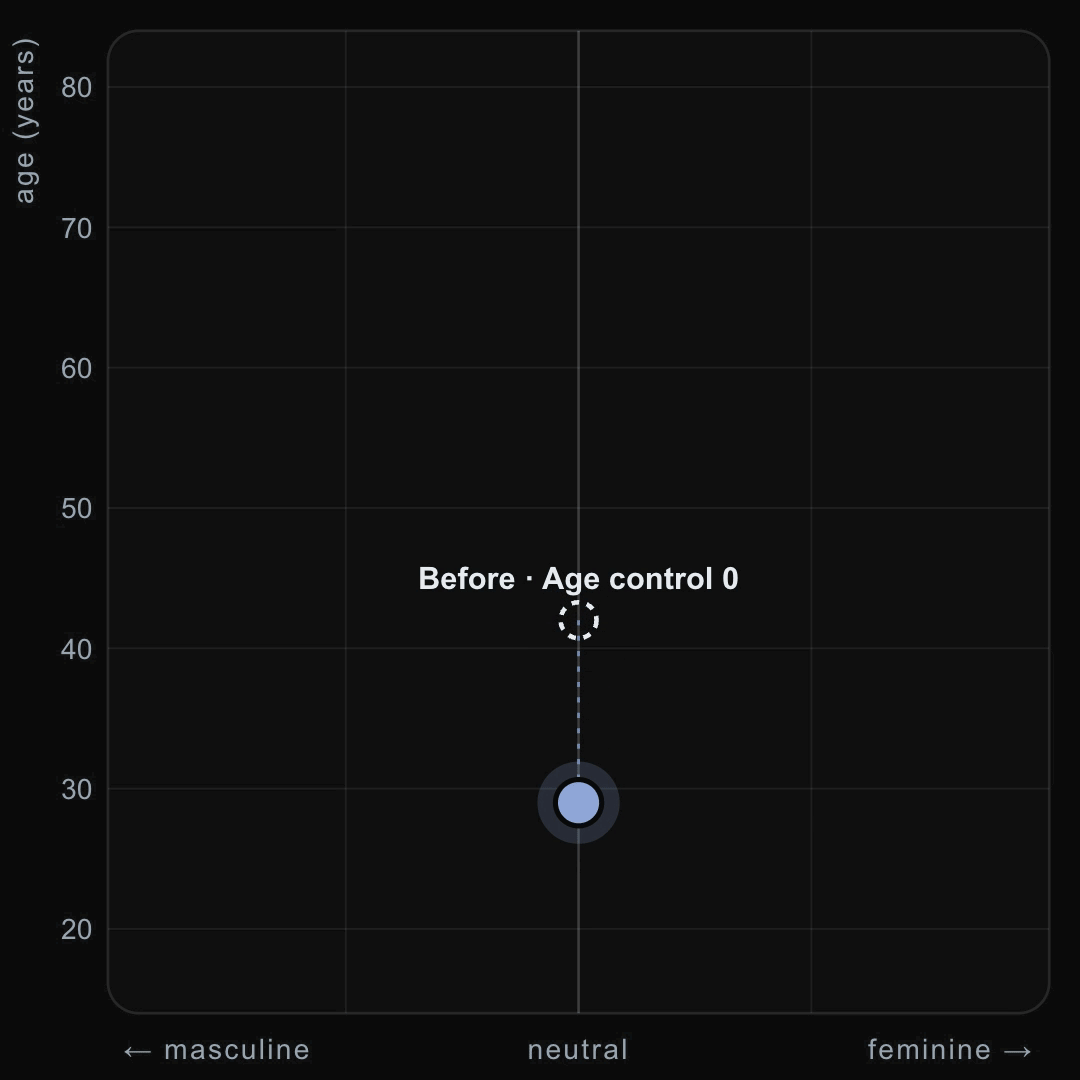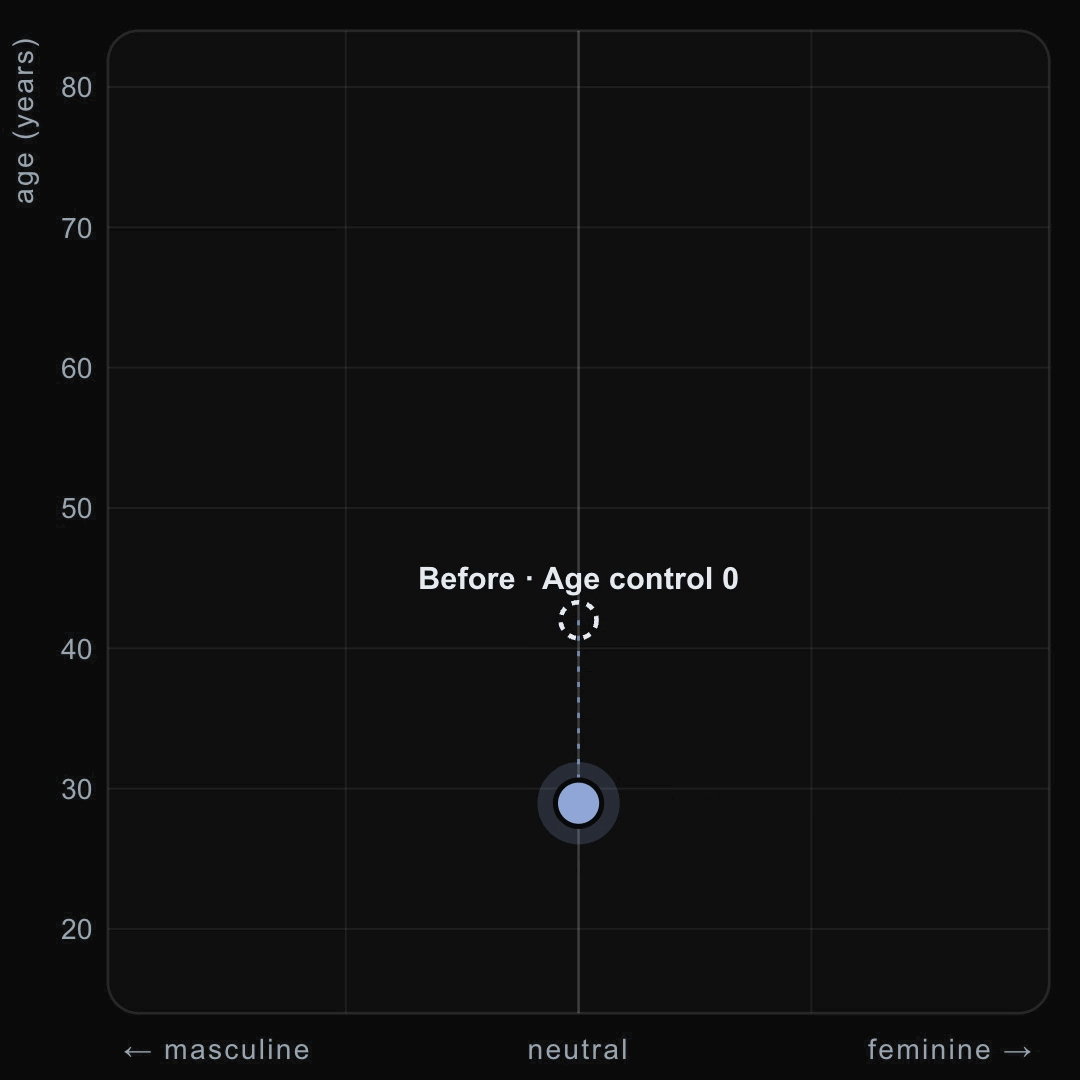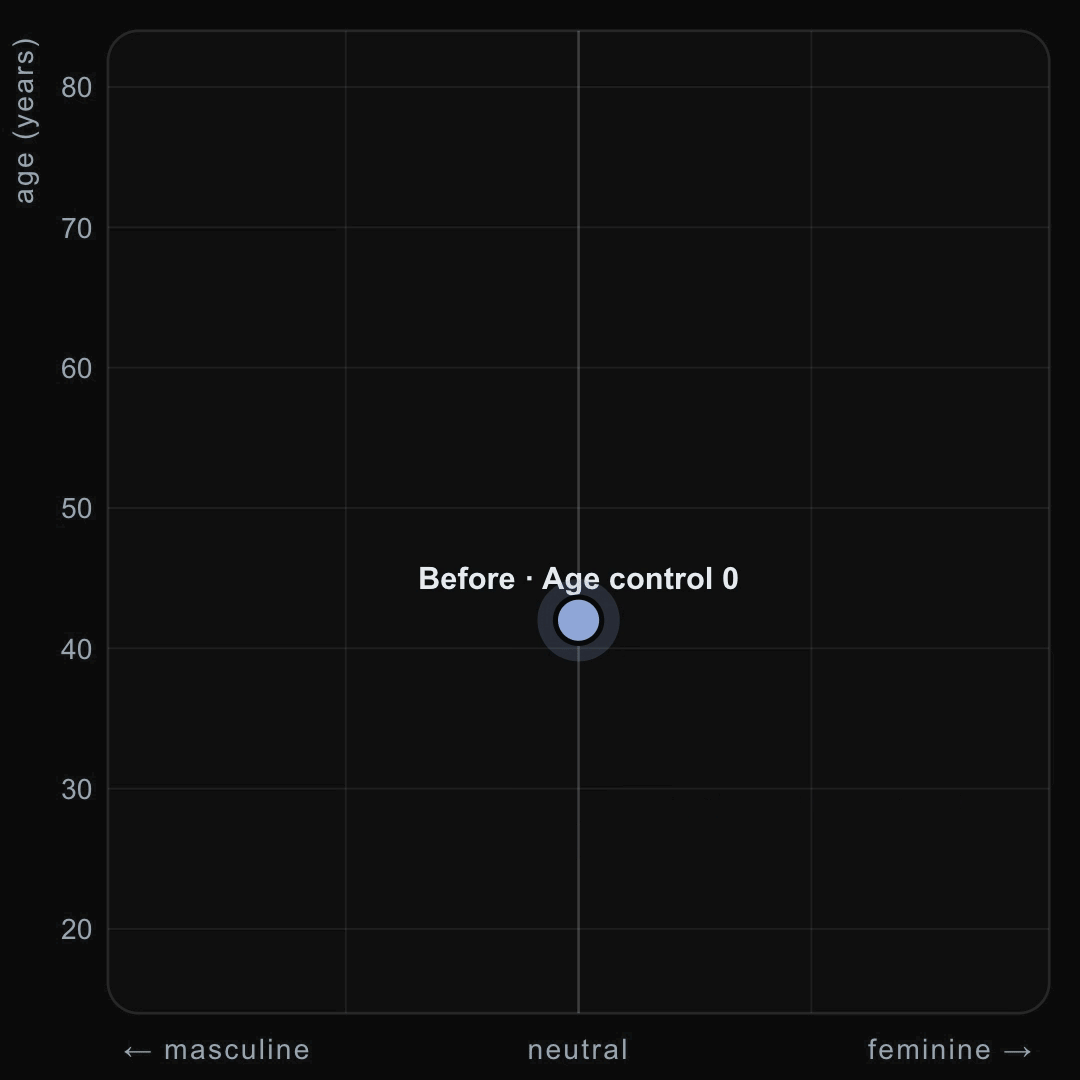
- 年龄模拟:通过调整年龄向量,可以让同一个声音听起来像 25 岁的青年、45 岁的中年人或 75 岁的老人。这主要通过改变共鸣和音色纹理实现。
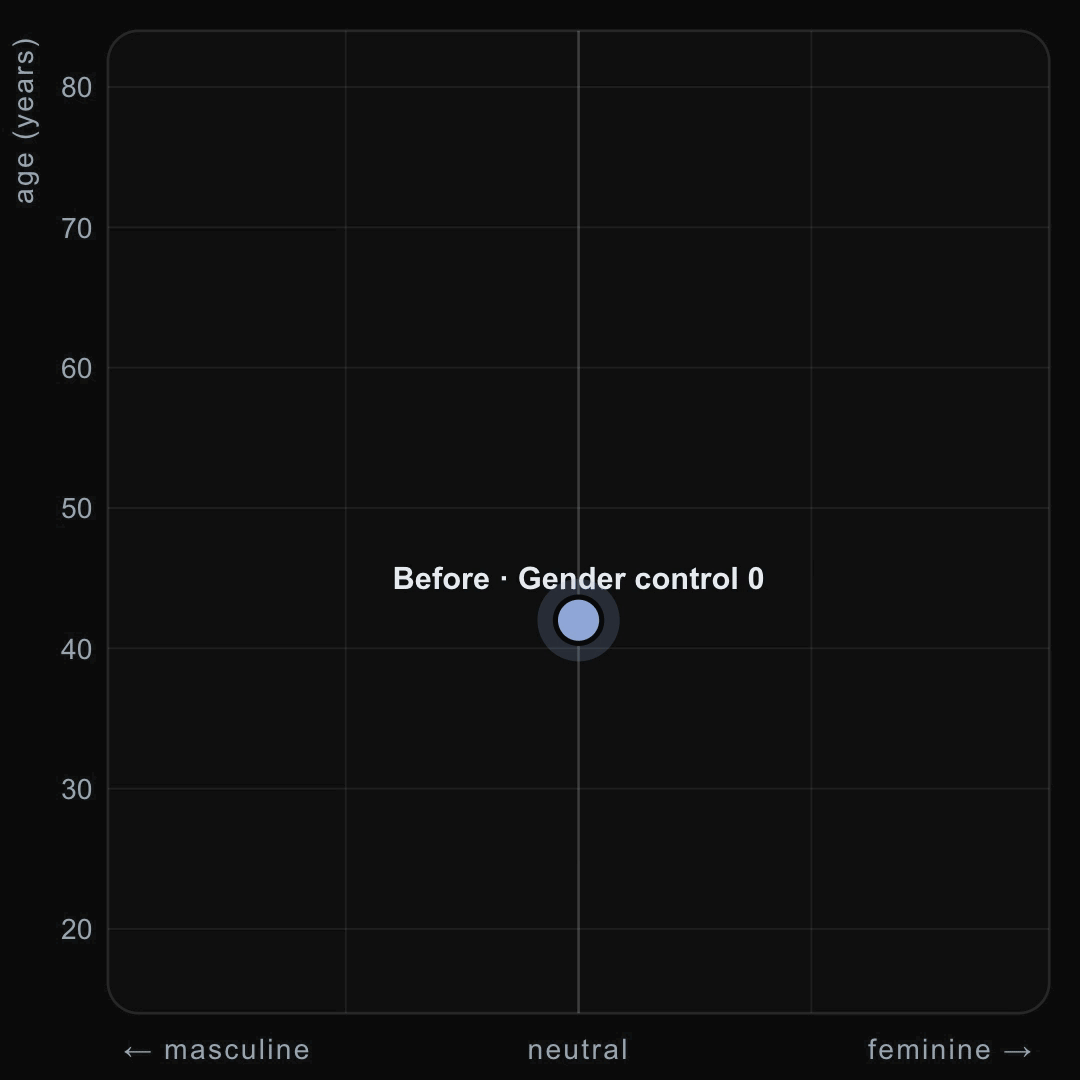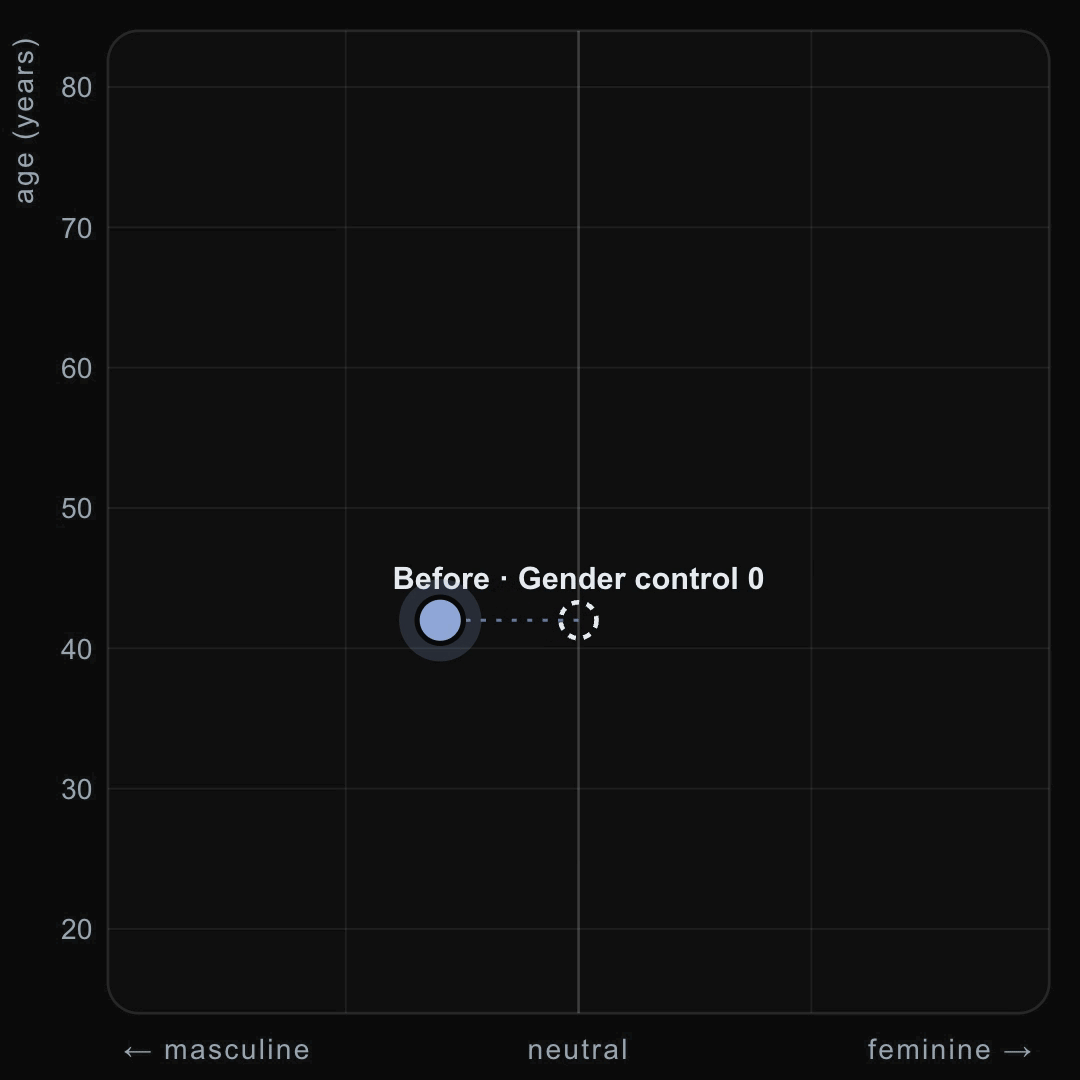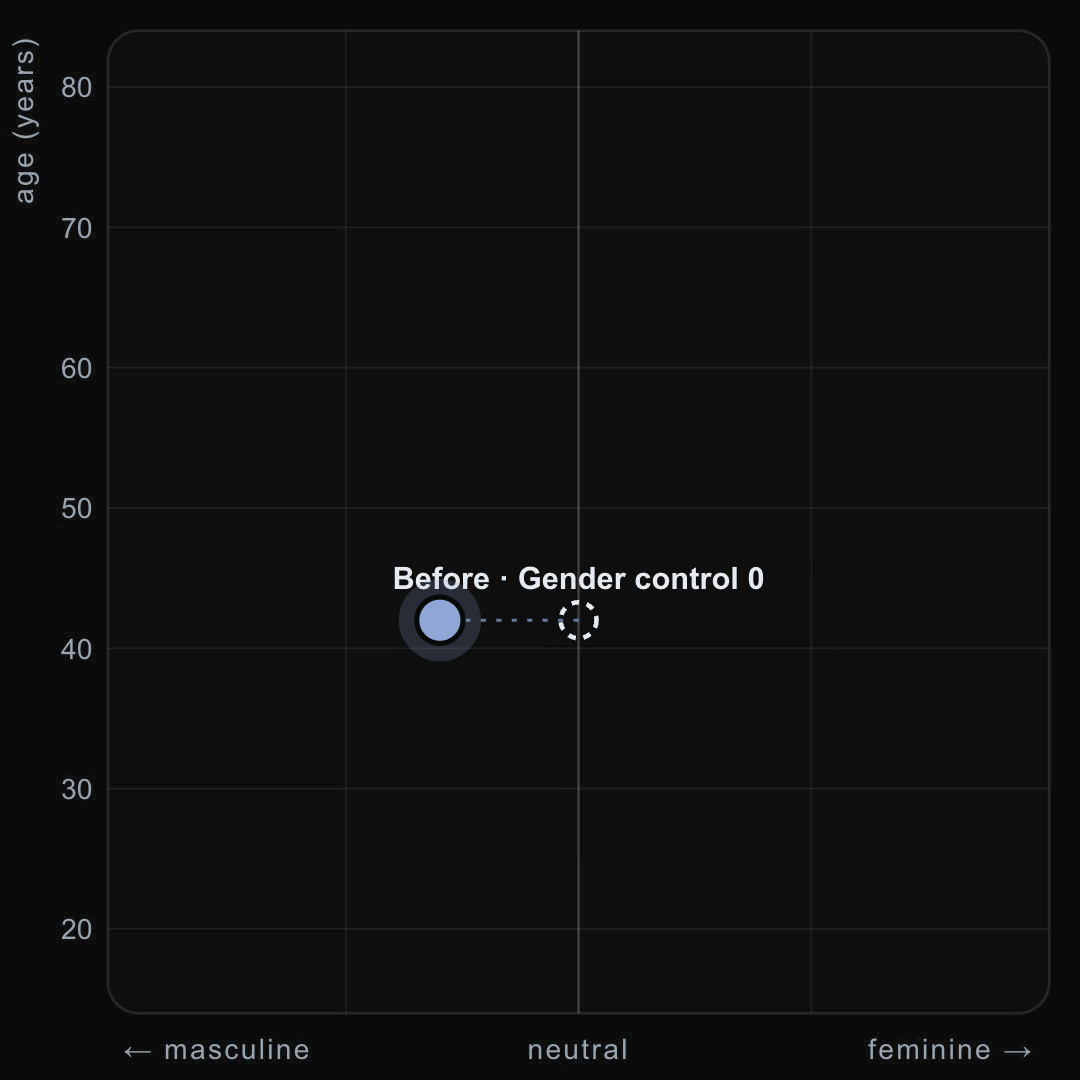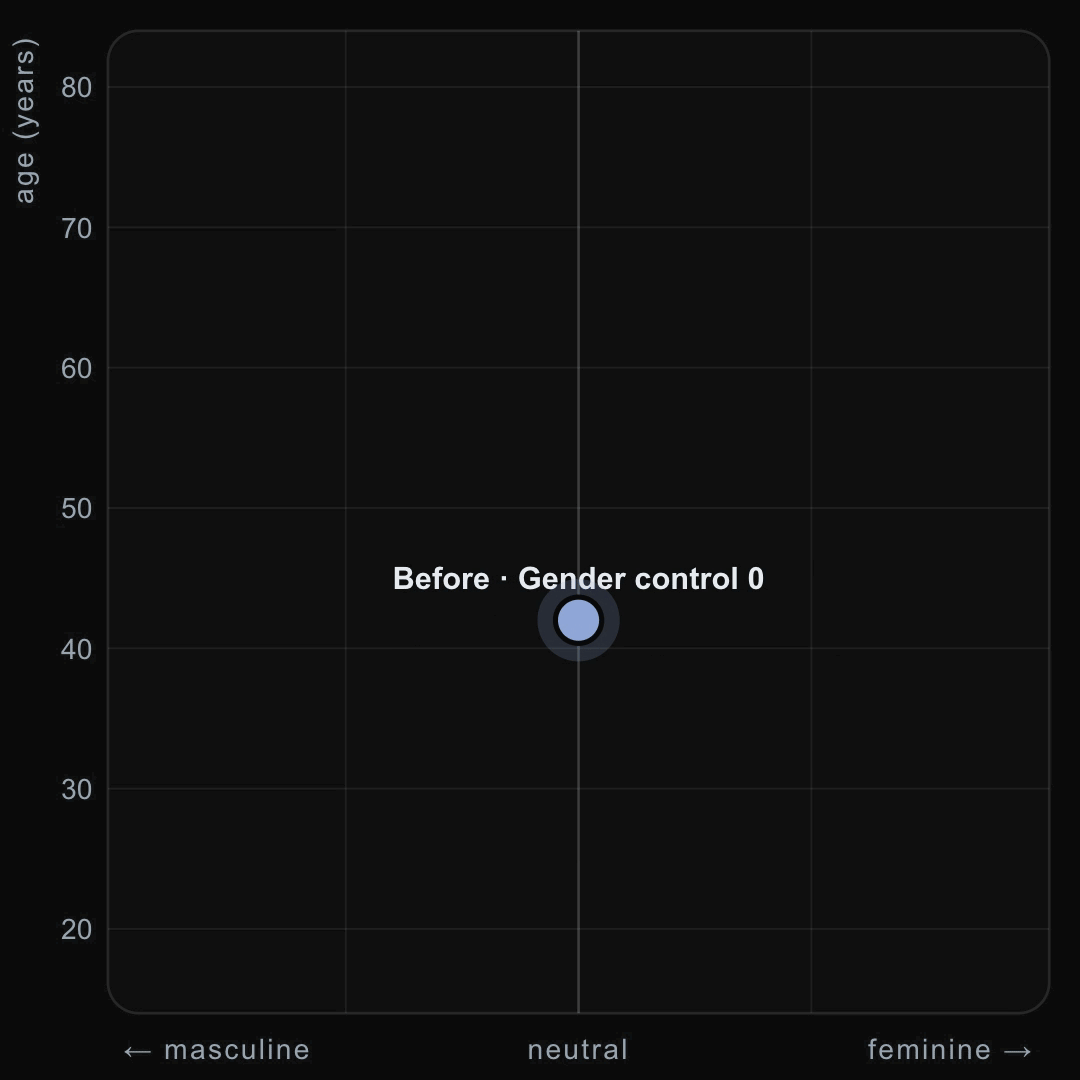
- 性别呈现:在男性化、女性化和中性之间平滑过渡,调整共振峰和音高。
- 音色纹理:增加“柔和度”可以模拟气声,增加“沙哑度”则带来粗糙感。这些控制是连续的,允许细微的混合。
表达控制:注入情绪与节奏
除了物理特征,ZONOS3-Mini 还能控制说话的方式:
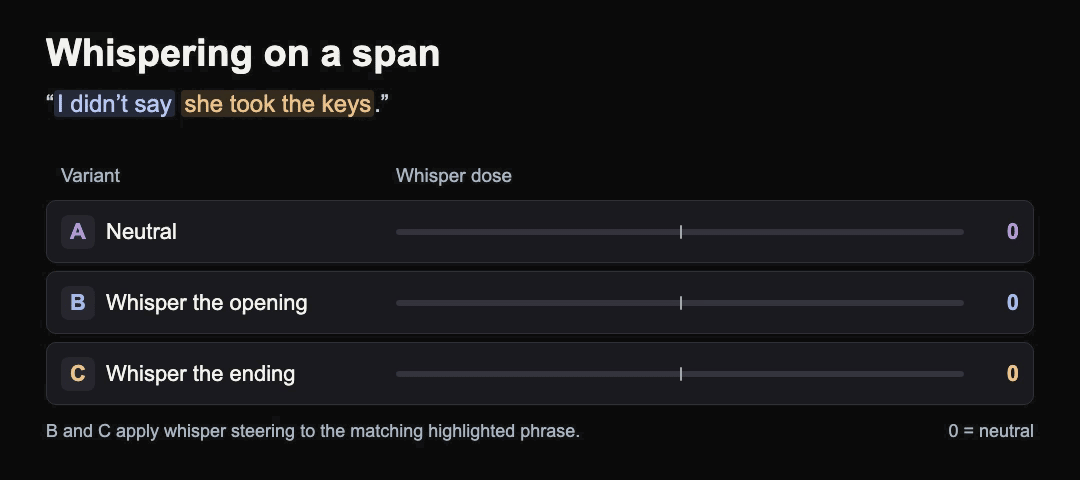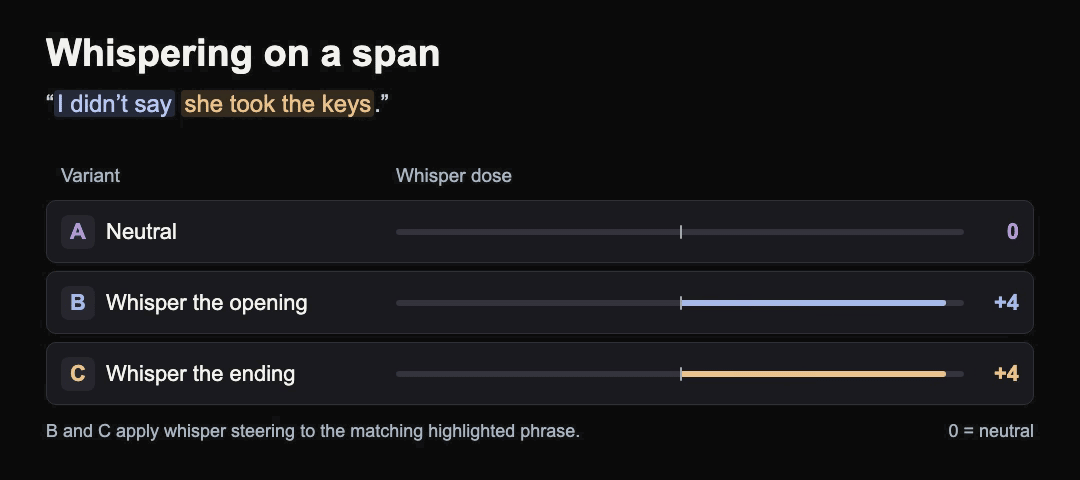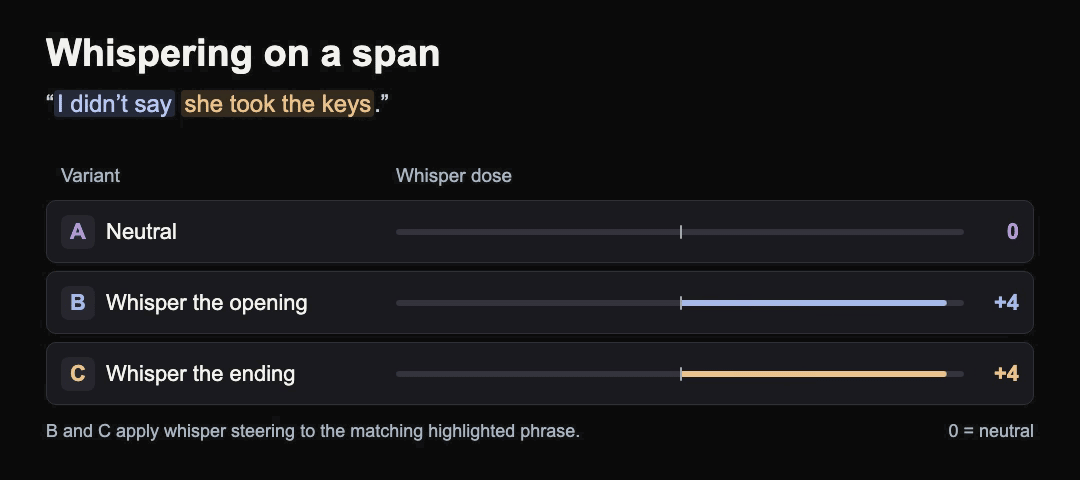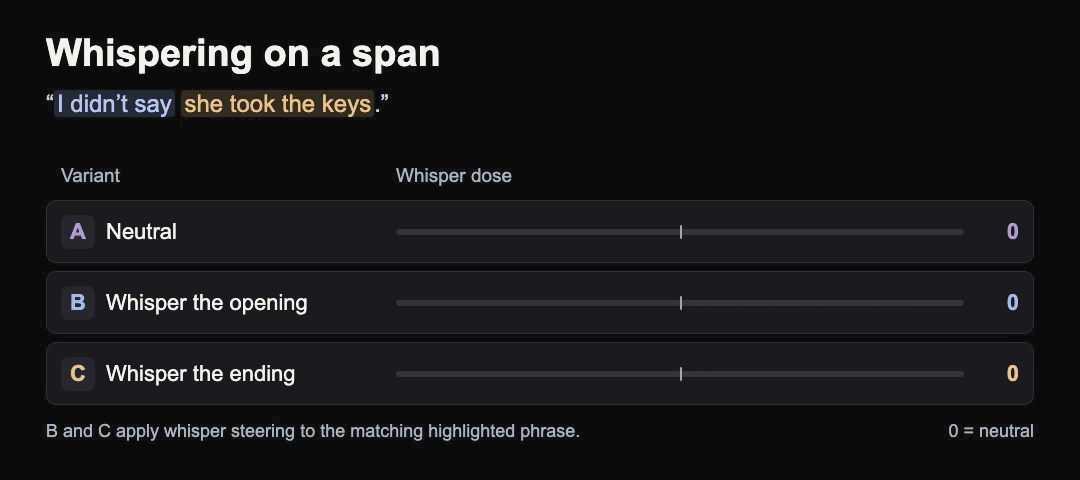
- 局部耳语:你可以指定句子中的特定片段(如“我没说”)以耳语方式读出,而其余部分保持正常音量。这是通过监控对齐注意力头实现的。
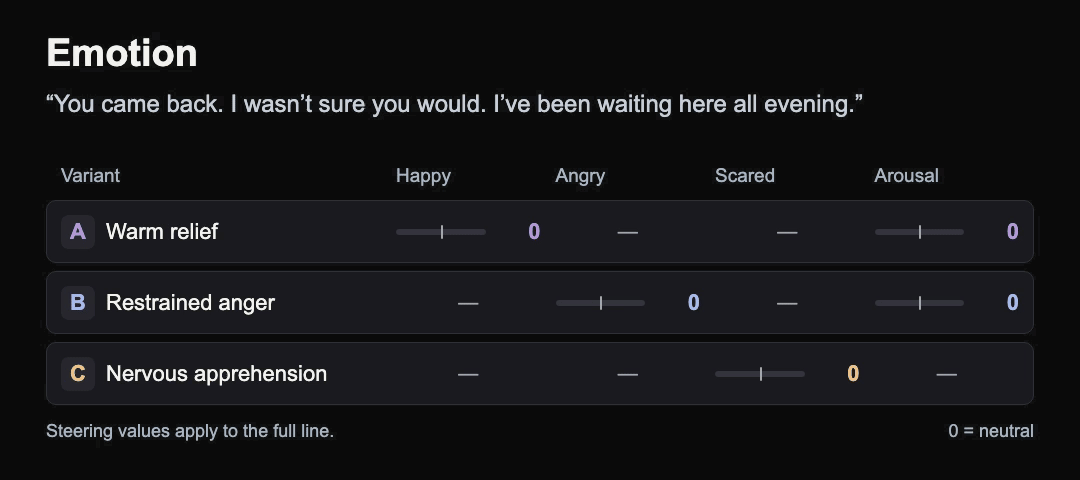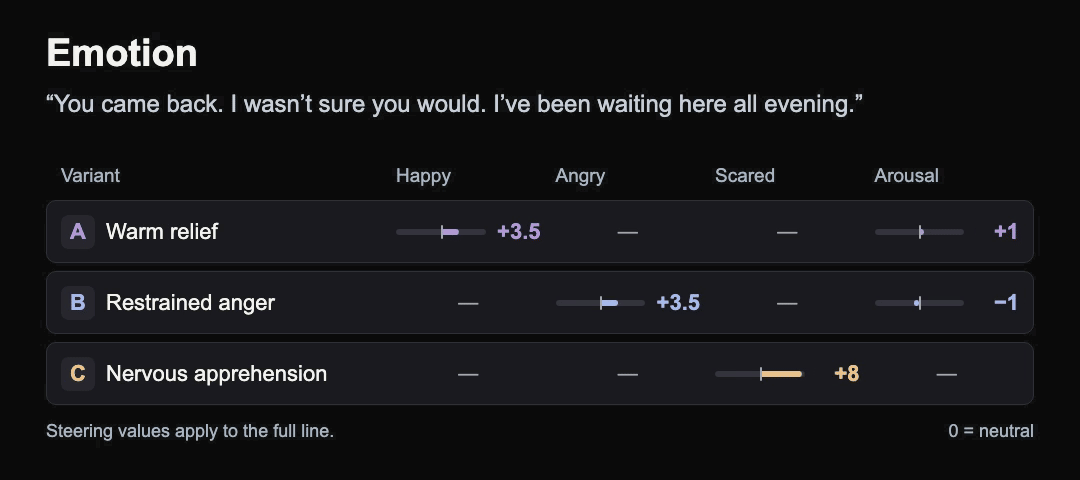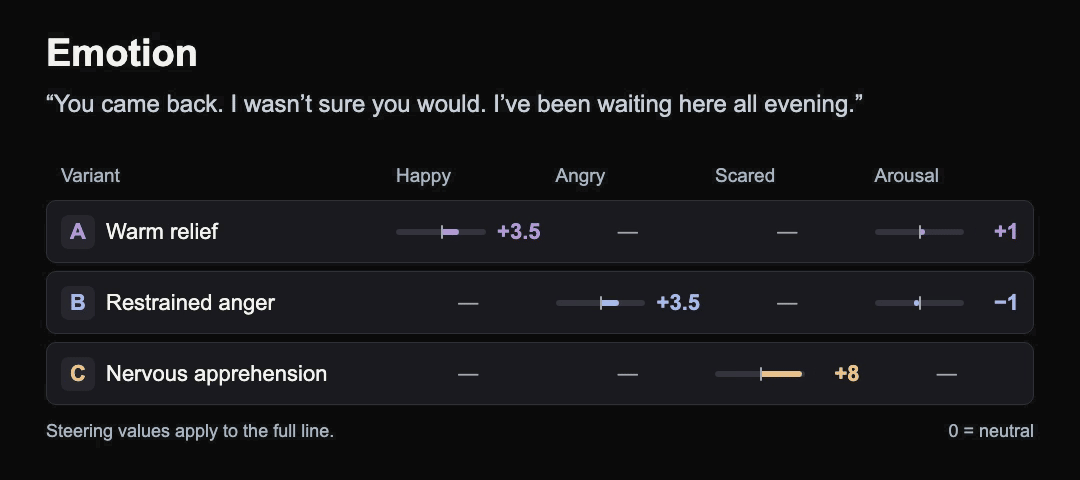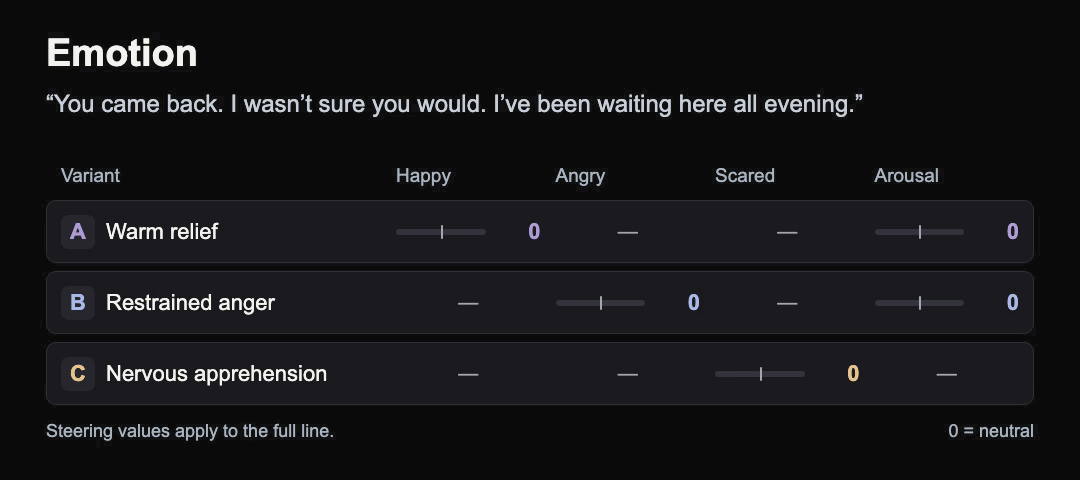
- 情绪意图:同一句话,“你回来了。我不确定你会来。我整晚都在等。”可以被演绎出温暖的释然、克制的愤怒或紧张的焦虑。通过调整快乐、愤怒或恐惧等情绪向量,模型能捕捉到微妙的情感色彩。
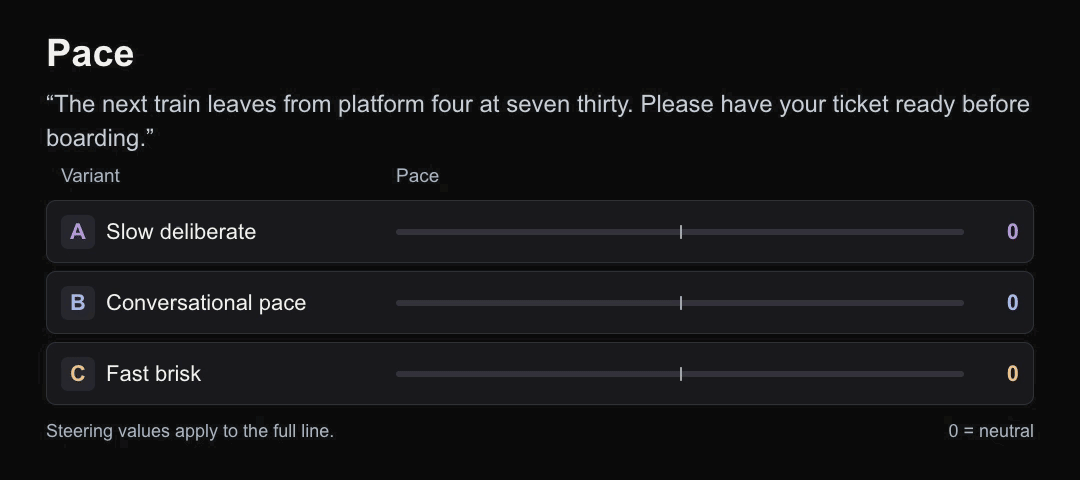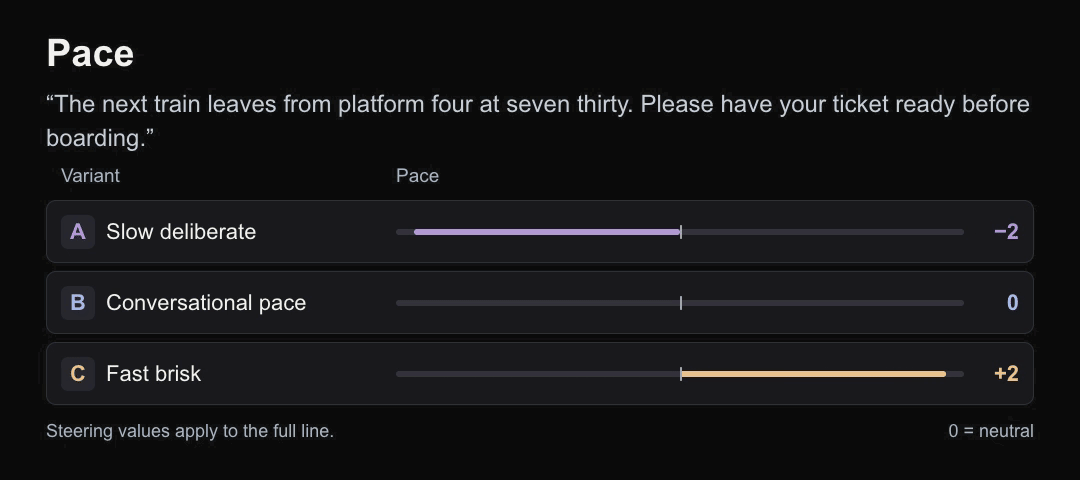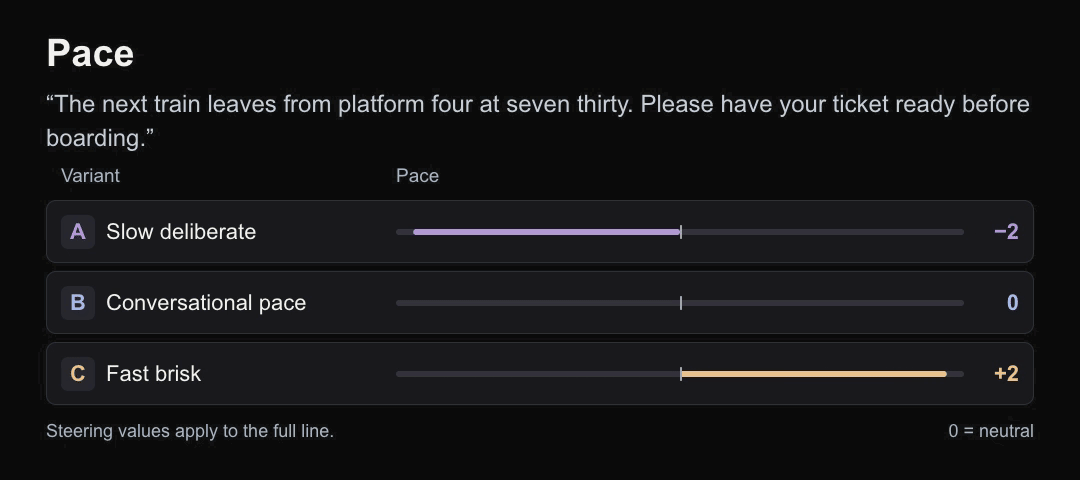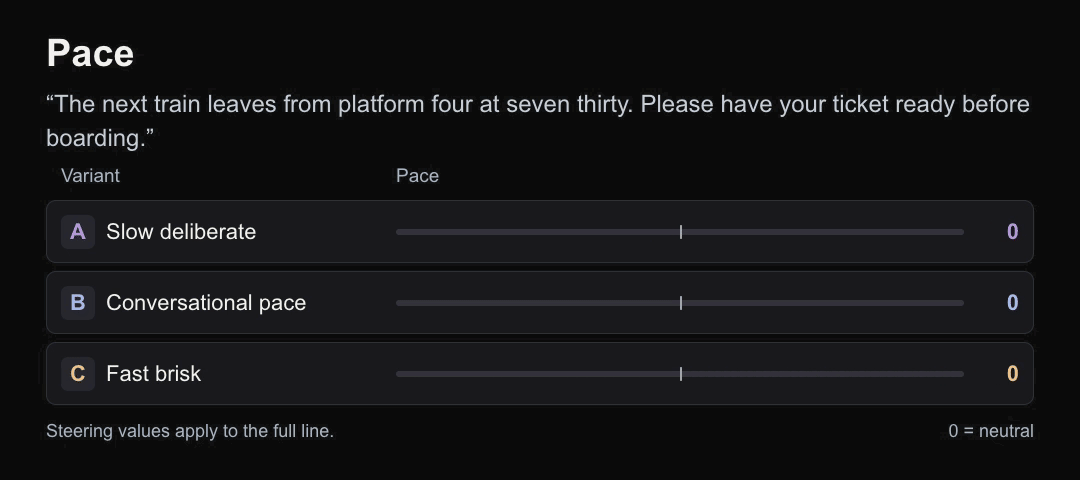
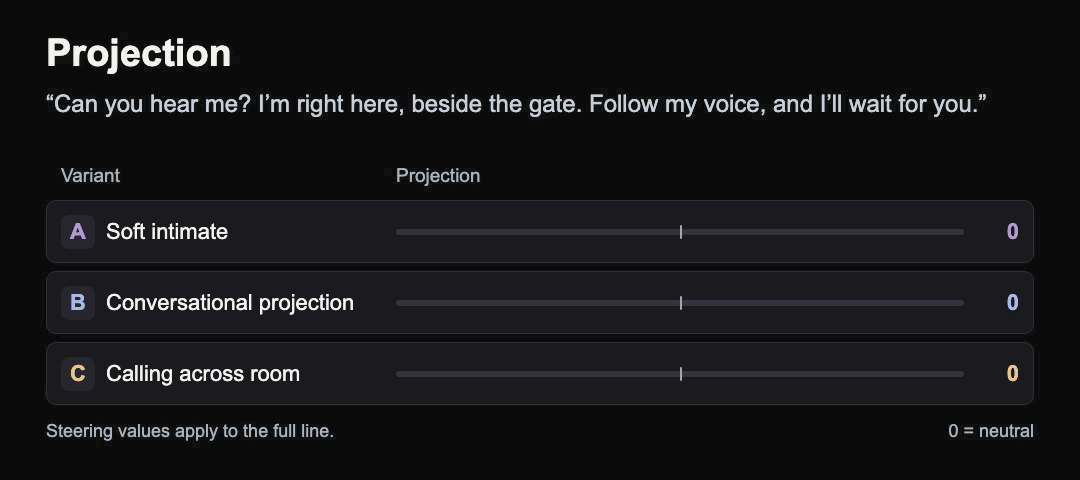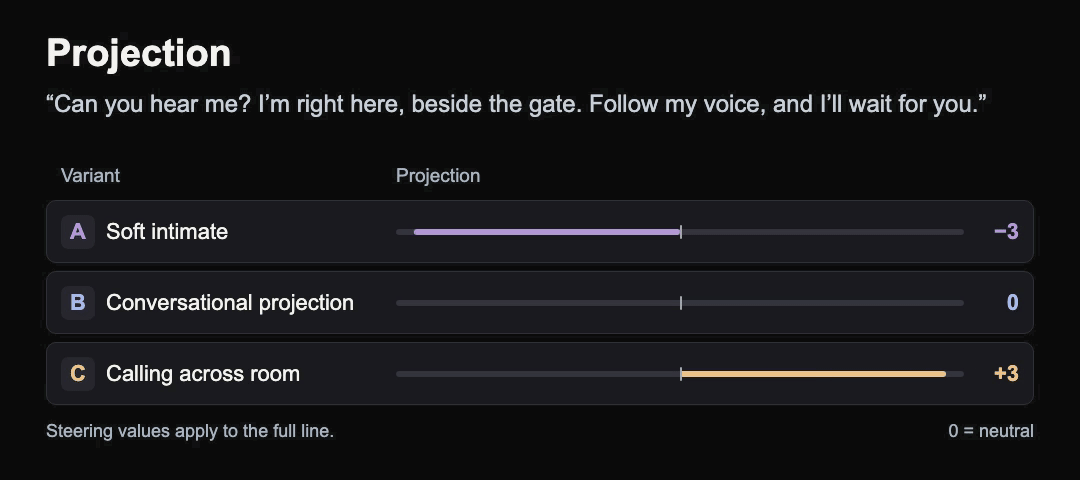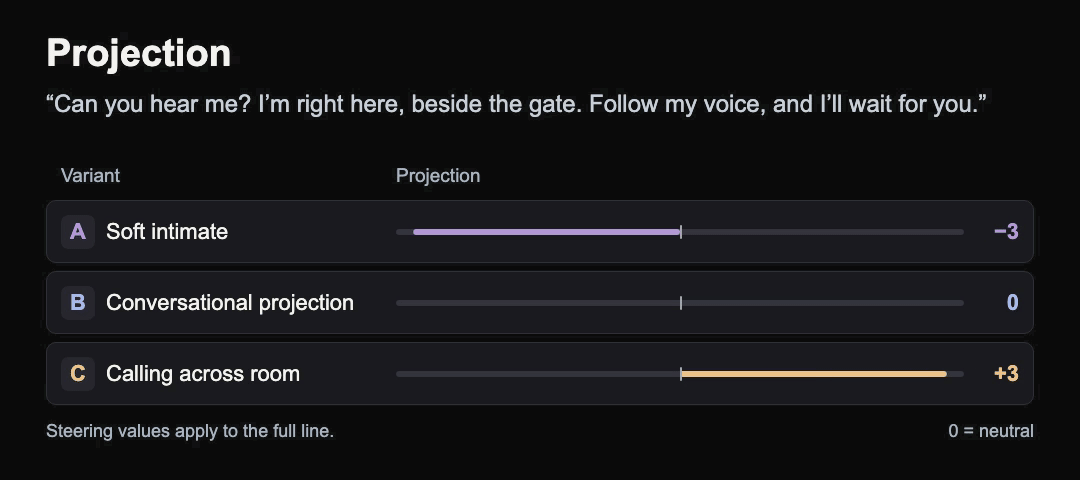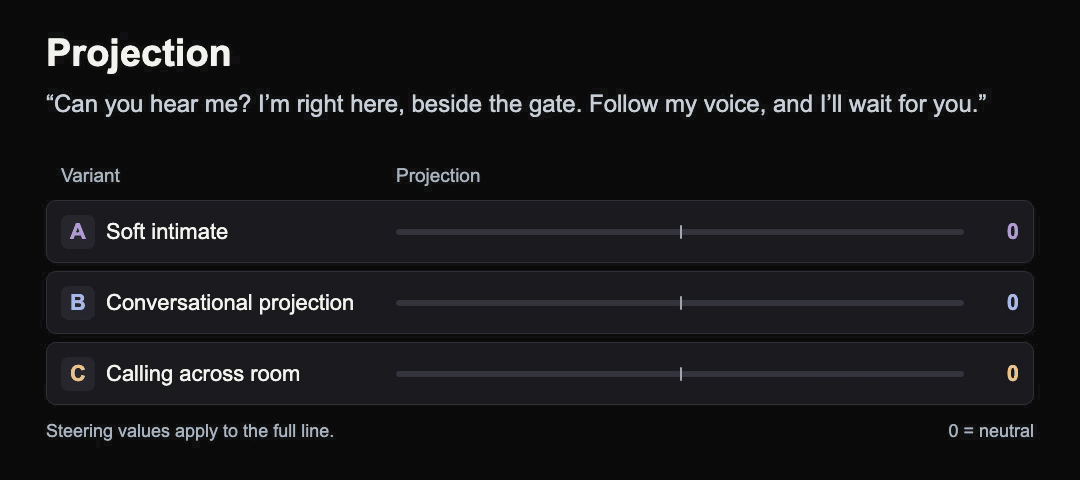
- 语速与投射:从缓慢刻意到快速轻快,语速调整不会牺牲清晰度,平台号和出发时间等关键信息依然准确。投射控制则能模拟从耳边低语到隔房间呼喊的距离感。
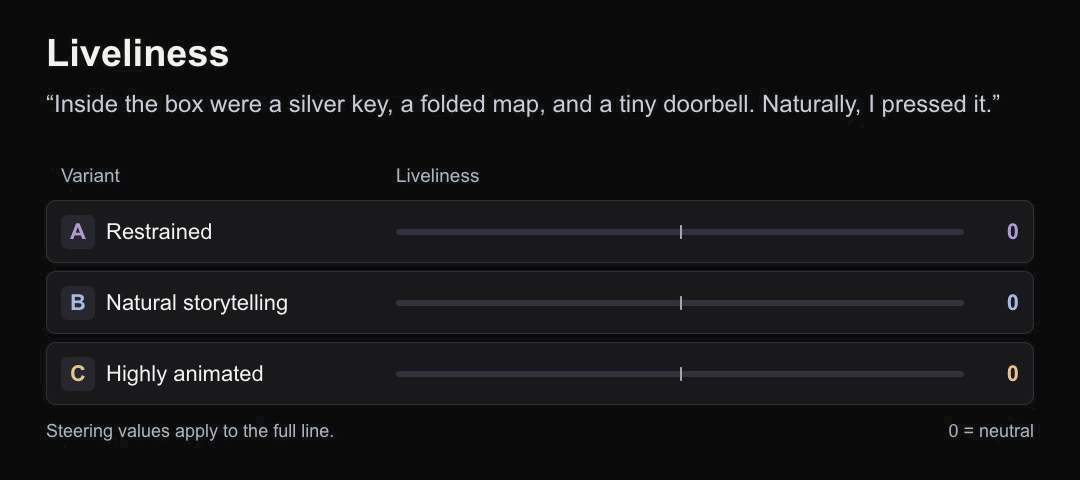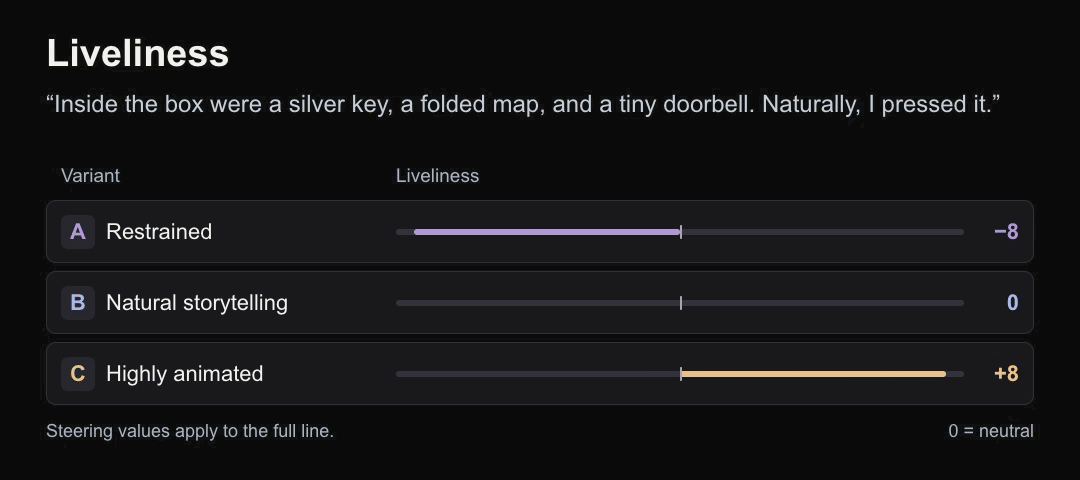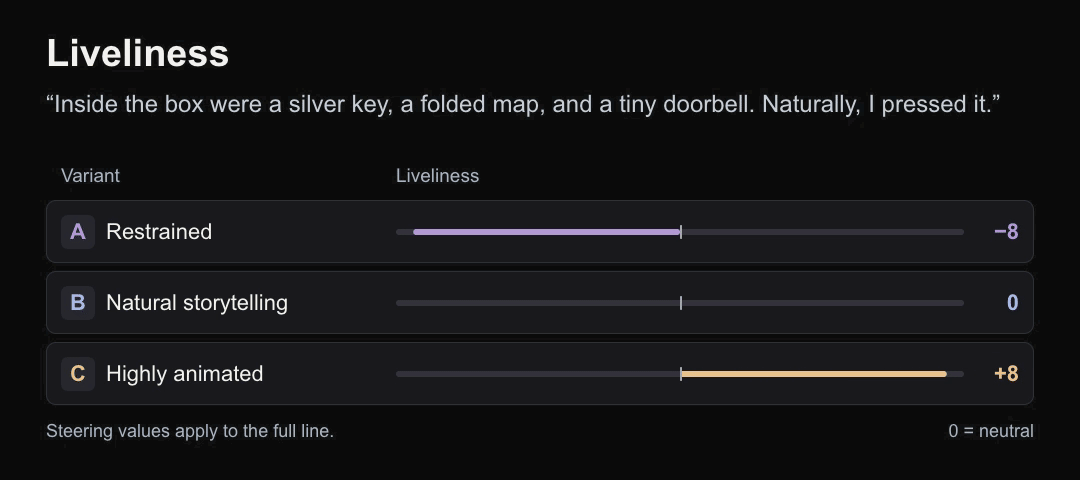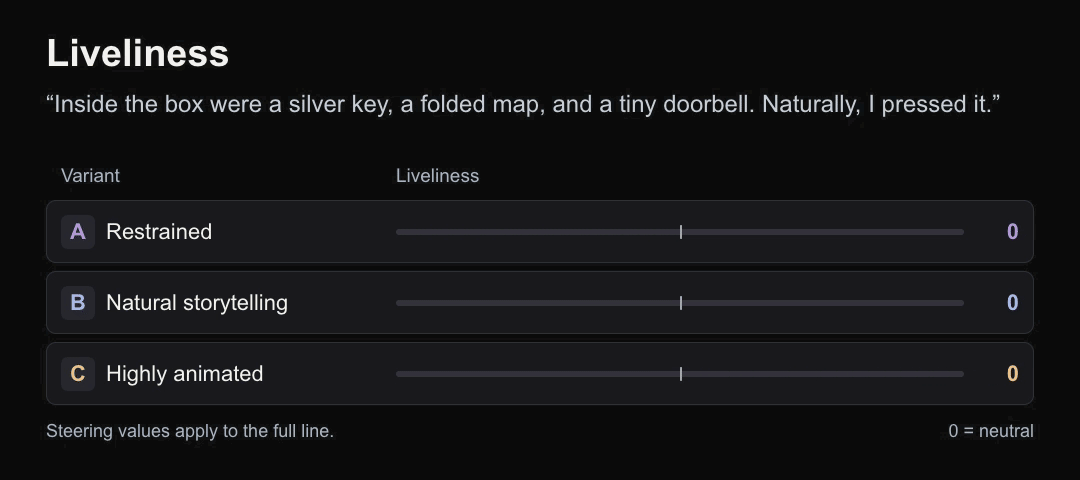
- 生动性:调整音调变化和节奏兴趣,让叙述从 restrained(克制)变得 highly animated(生动活泼)。
性能实测:在手机上也能动起来
理论再好,落地才是硬道理。ZONOS3-Mini 在多种硬件上的表现令人印象深刻:
- Pixel 9 手机:在浏览器中运行,首字音频延迟(TTFA)低于 570 毫秒。
- M3 MacBook Air:TTFA 低于 150 毫秒。
- 单张 H100 GPU:中位 TTFA 仅为 80 毫秒,峰值吞吐量达到实时的 457 倍。
这意味着它不仅可以部署在服务器上提供低成本 API,还可以完全在客户端运行,保护用户隐私。Zyphra 提供了多种推理后端支持,包括 SGLang-Omni、Apple Silicon 的 MLX、C++/ggml(支持 CPU、CUDA、Metal、Vulkan)以及 WebGPU。
开源生态与评估基准
Zyphra 此次开源的内容非常全面,包括 Apache 2.0 许可的模型权重、MIT 许可的运行时代码,以及全新的评估基准 ZTTS2-Eval。
ZTTS2-Eval 覆盖了 35 种语言的干净语音评估和 20 种语言的野外说话人克隆评估。为了避免单一评估器的偏差,它结合了 Qwen3-ASR 和 Whisper Large v3,并引入了基于项目反应理论(IRT)的能力指数。在 ZTTS2-Eval 排行榜上,ZONOS3-Mini 在开源加权模型中排名第一,超越了 Fish S2 Pro 和 MOSS TTS v1.5。
对于开发者而言,上手门槛极低。你可以通过 Hugging Face Space 直接体验零样本克隆,或者通过一行命令启动本地服务:
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000
随后即可通过标准的 OpenAI 兼容接口调用:
curl -X POST http://localhost:8000/v1/audio/speech \
-H "Content-Type: application/json" \
-d '{"input": "Hello from ZONOS3-Mini!"}' \
--output output.wav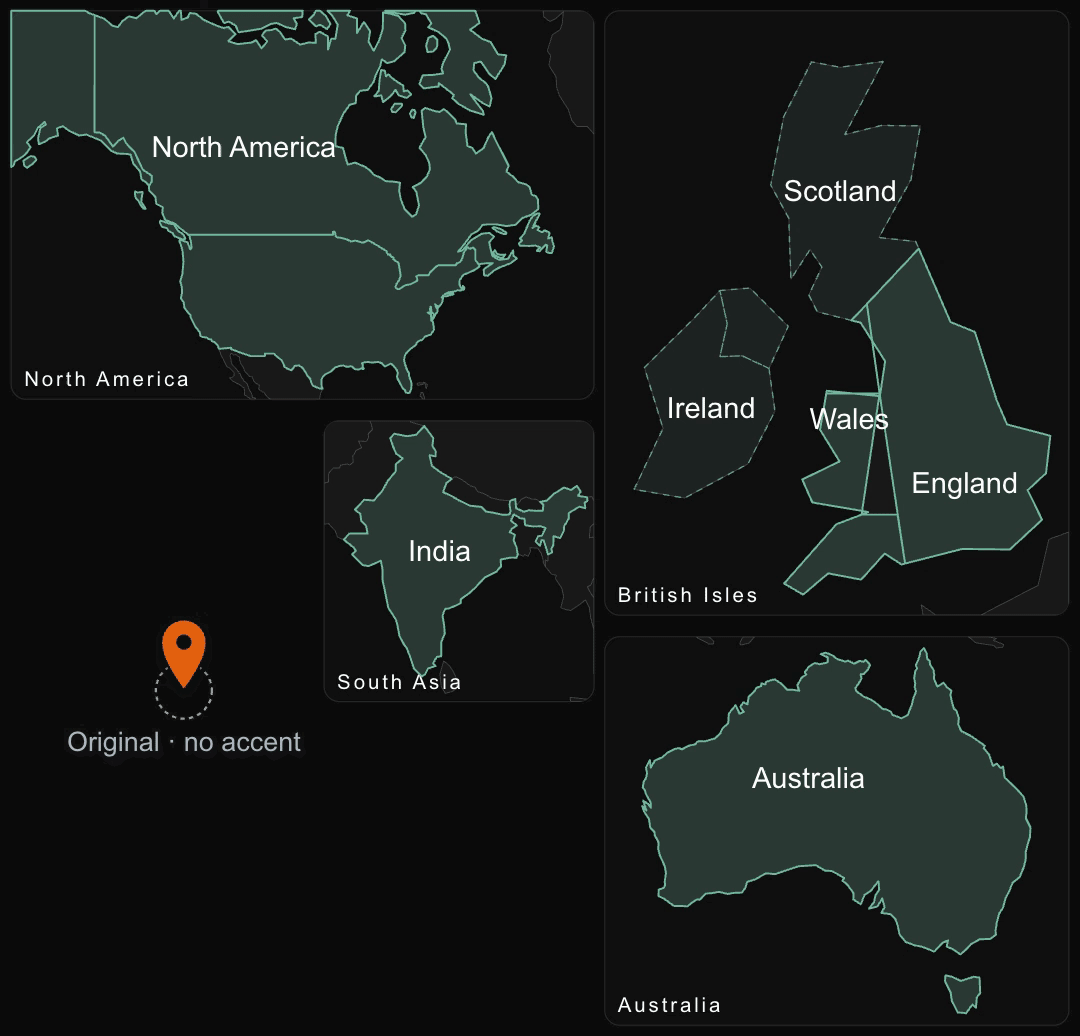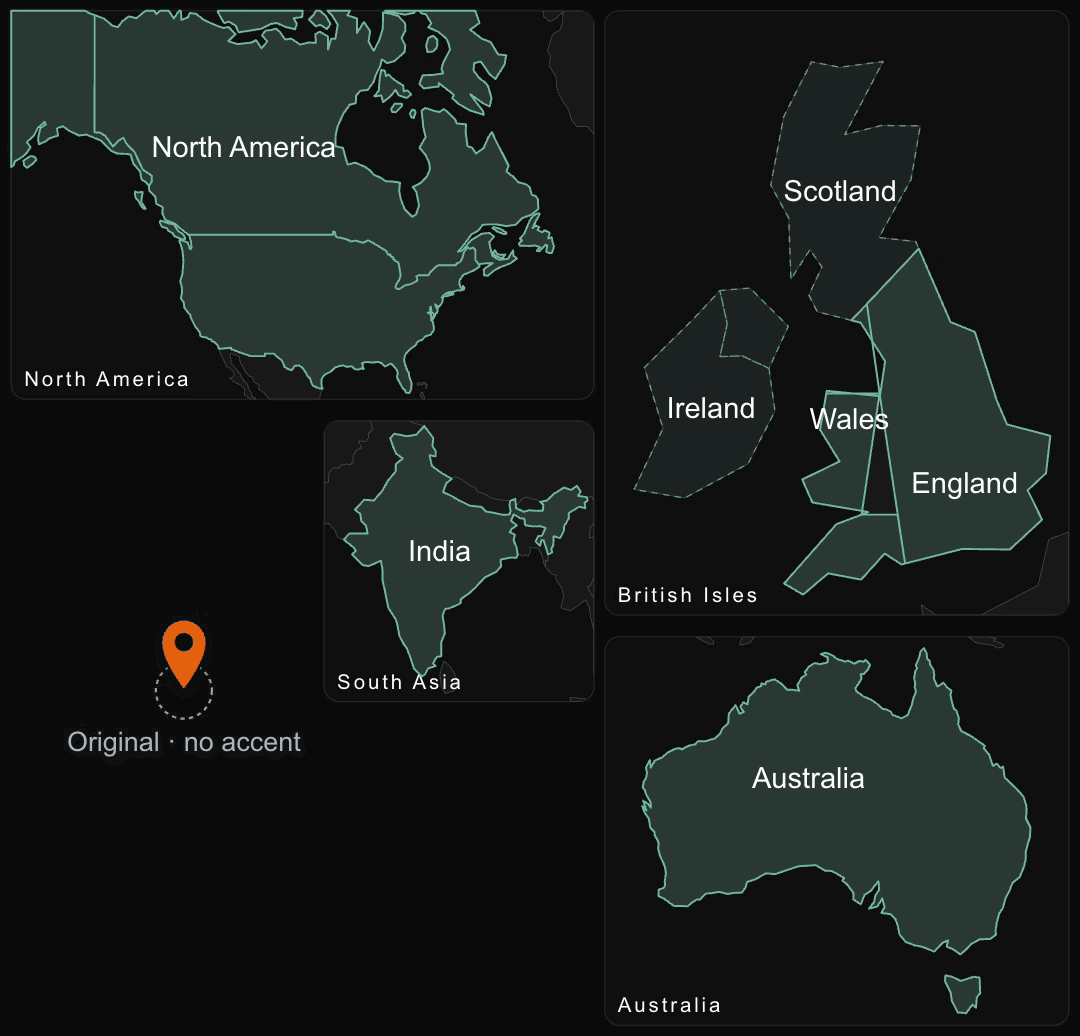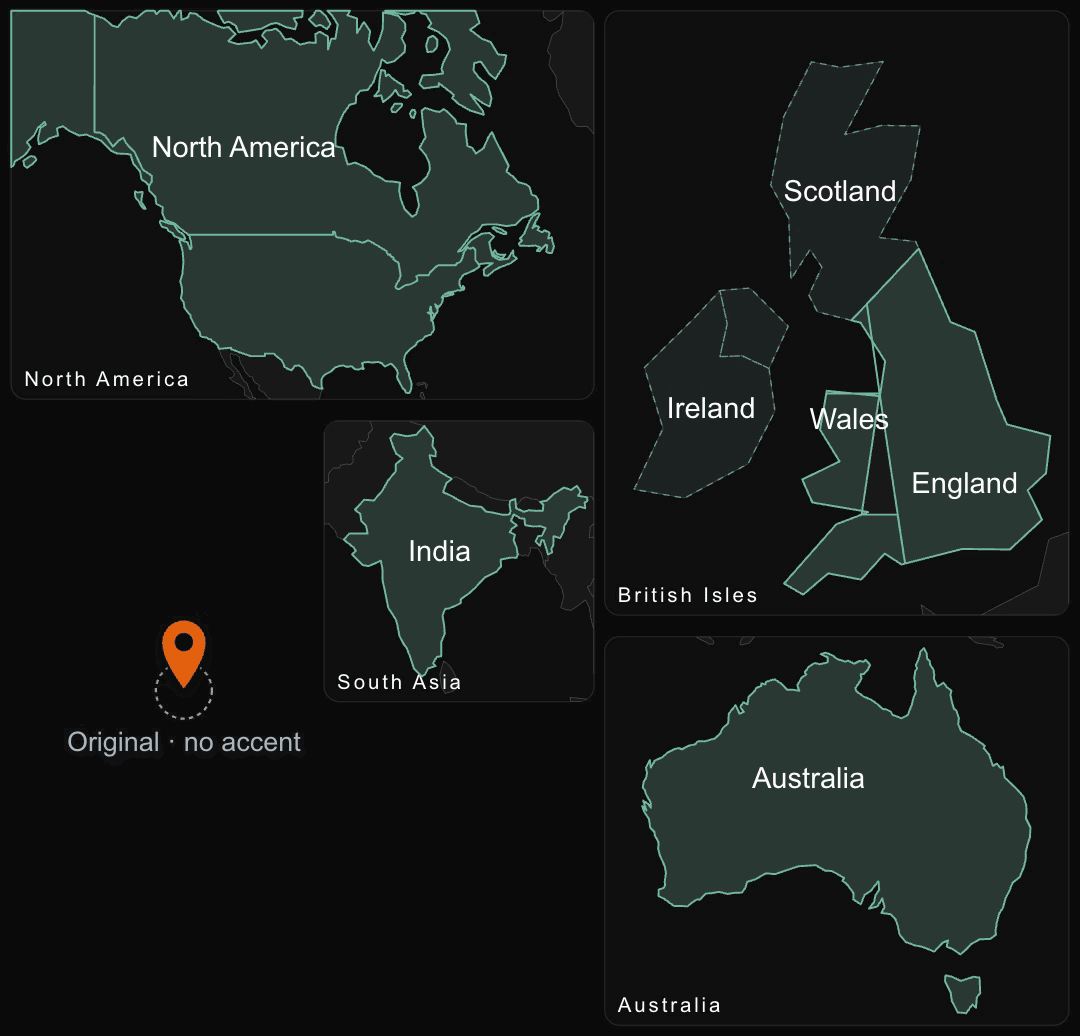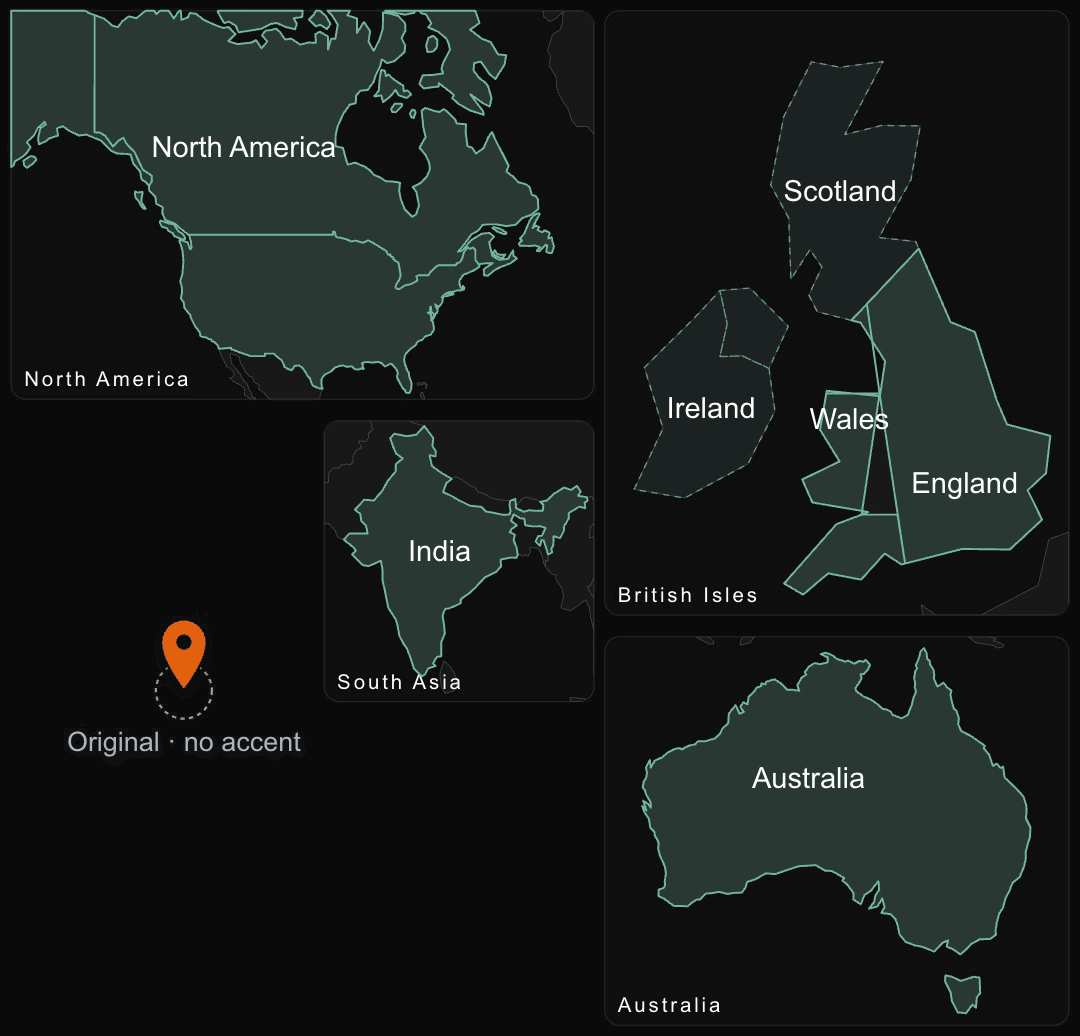
结语
ZONOS3-Mini 的出现标志着 TTS 技术的一个转折点:高质量语音合成不再是大模型的专利。通过高效的架构设计和精细的控制机制,它让实时、个性化、可控制的语音交互成为可能。无论是用于游戏 NPC 的动态配音、有声书的个性化朗读,还是辅助沟通工具,ZONOS3-Mini 都提供了一个强大且灵活的开源基座。
随着 WebGPU 和本地 AI 推理能力的普及,我们或许很快就能看到更多应用在端侧运行如此复杂的语音模型,为用户提供真正私密、即时且富有表现力的语音体验。