离线语音交互新方案:Google AI Edge Gallery 端侧 ASR 与 TTS 实践
为什么语音交互需要“离线”
在手机或可穿戴设备上,语音往往是最自然的交互方式。但过去的语音功能大多依赖云端,一旦没网或者信号不好,体验就会大打折扣。现在情况变了。随着紧凑型语音架构的进步,我们终于能在设备本地运行准确的多语言自动语音识别(ASR)和富有表现力的文本转语音(TTS)模型。
Google 最近在 Google AI Edge Gallery 中引入了这两项端侧能力。这意味着开发者可以把轻量级的语音模型和本地小语言模型(SLM),比如 Gemini Nano 或 Gemma 4 结合起来。用户说话时,应用能实时转录;模型生成回复后,也能直接在本地合成自然的语音回答。整个过程不需要联网,内存占用小,延迟也极低。
这次更新主要涵盖两个方向:一是针对 Android 旗舰设备,通过 ML Kit 提供更快速、更准确的系统级语音模型;二是面向 Web、桌面等多平台,利用 MediaPipe Tasks 和 LiteRT 支持开源权重的语音模型。下面看看这些技术具体是怎么落地的。
实战案例:XR 语言教师
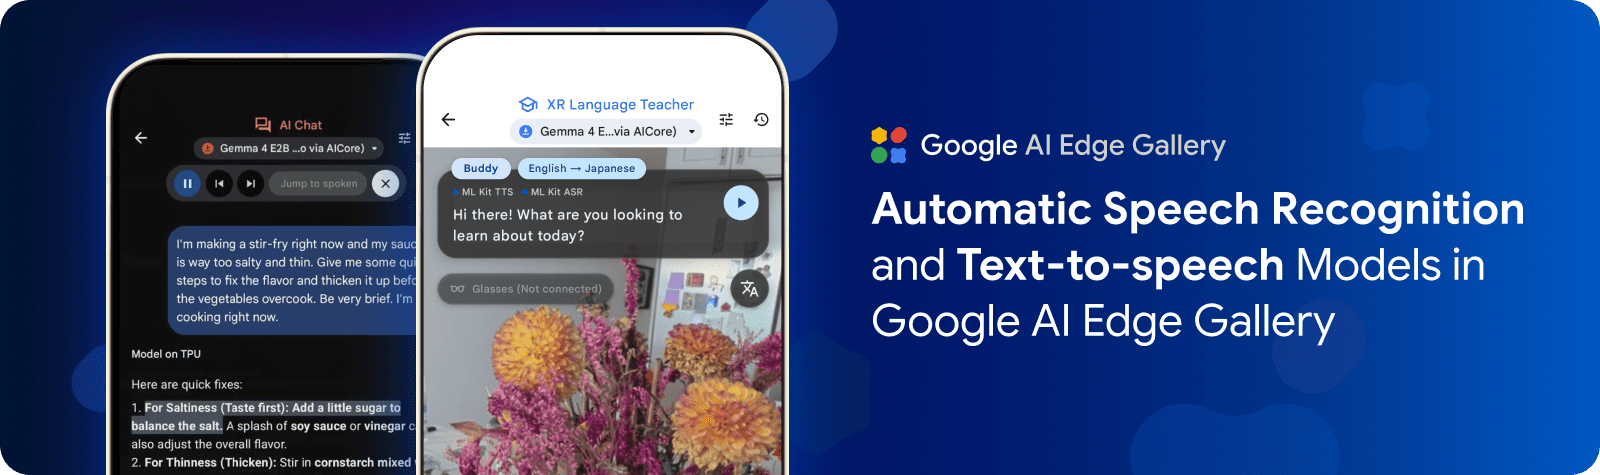
学外语最头疼的场景是什么?大概是在国外的地铁站、嘈杂的市场,或者对着全外文菜单发呆的时候。这时候往往没有 Wi-Fi,漫游数据又贵又慢。为了展示视觉、语言和语音模型如何在不联网的情况下协同工作,Google 团队构建了一个名为“XR Language Teacher”的演示应用。
看、说、学,全部在本地完成
这个应用的逻辑很直观:举起手机摄像头对准陌生的物体或菜单,直接问:“那是什么?用当地语言怎么说?”
- 实时视觉与语音输入:当你对着街牌或菜单提问时,端侧 ASR 会实时流式传输你的语音,同时摄像头画面也会传入。在 Android 设备上,这些数据会被一次性送给 Gemini Nano;在其他平台上,则交给 Gemma 4 处理。
- 结构化输出与双语切换:模型不仅理解画面,还会按照预设的结构化格式输出结果。它会用你的母语解释场景,同时单独标记出需要翻译的外语短语。TTS 引擎接收到这些标签后,能在同一句话里无缝切换口音和语种——前半句是中文解释,后半句就是地道的当地语言发音,屏幕上还会同步显示词汇卡片。
适配智能眼镜
既然推理过程完全在配对的手机上进行,这套逻辑自然也能延伸到免智能眼镜上。在最近的 Android Dev Summit 上,团队展示了如何将这一体验适配到音频优先的智能眼镜设备中,让用户在双手被占用时也能通过语音获取实时信息。
AI Chat 的语音升级
除了专门的演示应用,Google AI Edge Gallery 的主打功能“AI Chat”也集成了端侧 ASR 和 TTS。这让 Gemini Nano 和 Gemma 4 等本地小模型拥有了真正的离线语音界面。
句子同步播放与可配置设置
为了让语音交互更像真人对话,团队在细节上下了不少功夫:
- 统一的管理中心:在“模型管理”中,用户可以一站式选择 ASR 和 TTS 管道、预设音色以及下载的语言包。
- 实时高亮朗读:开启“自动播放 TTS”或点击回复旁的扬声器图标,会出现一个浮动的播放条。它不仅会朗读内容,还会实时高亮当前正在说的句子。如果某句没听清,直接点击该句子就能跳转重听。
- 参考实现:开源代码库展示了如何处理这些细节。例如,系统会自动剥离 Markdown 语法,跳过代码块和表格等非口语内容,并在句子级别调度合成任务。这样做是为了避免在 LLM 生成 token 时造成计算和内存冲突,保证流畅度。
技术底层:ML Kit、MediaPipe 与 LiteRT
虽然像 Gemma 4 这样的多模态模型可以直接处理音频输入,但为了优化延迟和灵活性,Google 提供了一套模块化方案:将语言模型与独立的轻量级语音模型串联起来。根据目标设备和需求不同,开发者可以选择不同的技术栈。
Android 首选:ML Kit
对于 Android 开发者,ML Kit 的 GenAI 语音识别和 TTS API 是最省事的选择。底层的语音模型由 AICore 和 Google 的端侧语音服务管理,这意味着你不需要操心模型下载,也不会让 APK 体积膨胀。应用还能自动利用 NPU 和 TPU 进行硬件加速,并在后台无缝更新模型。
- 语音识别(ASR):支持从内置麦克风或外部音频流(如智能眼镜)接收音频。最新的端侧模型支持 100 多种语言,在 FLEURS 基准测试上的词错率低至 8.0%–9.0%。转录速度达到实时音频的 10 倍(每 3 秒音频仅需约 300 毫秒处理),端到端的语音翻译等待时间减少了 35%–44%。
- 文本转语音(TTS):基于紧凑的几步扩散模型,并在 NPU 上加速。首字延迟仅约 100 毫秒,能以高达 50 倍实时速度生成 24 kHz 的自然语音。相比传统的自回归 TTS 模型,它还能降低超过 50% 的设备活跃功耗,并内置了提示音支持。
跨平台通用:MediaPipe Tasks
如果你需要覆盖 iOS、macOS、Windows、Linux 或 Web,MediaPipe Tasks 提供了统一的接口。它抽象掉了底层的音频帧处理、语音活动检测(VAD)和复杂的解码管道。
- 语音识别任务:自动处理音频帧和 VAD,支持实时流式、整句批量和混合转录模式。开箱即用的开源模型包括 Parakeet-TDT 0.6B。你可以直接在浏览器中尝试它的 Web 演示。
- TTS 任务:提供即插即用的合成接口,支持低延迟流式音频输出。支持的开源模型包括多语言的 PocketTTS 100M 和 Kokoro-82M,以及超轻量的英文模型 Phonon 31M。在大多数设备上,Phonon 的首音频时间(TTFA)低于 100 毫秒。
核心引擎:LiteRT
ML Kit 和 MediaPipe Tasks 的底层动力来自 LiteRT,这是 Google 高性能端侧 AI 推理基础设施。对于需要更精细控制或自定义模型架构的开发者,可以直接基于 LiteRT 构建。
语音模型通常包含多个子图和辅助资产,比如 ASR 的编码器/解码器和分词器,或者 TTS 的音素字典、语音嵌入和声码器。LiteRT 将这些组件打包成单个 .litertlm 文件,方便部署。
目前可用的模型包包括:
- ASR:Parakeet-TDT-0.6B-v3(多语言)、Whisper、Qwen3-ASR、Moonshine。
- TTS:PocketTTS 100M(多语言)、Phonon 31M(超轻量英文)、Kokoro-82M(多语言)、Qwen3-TTS、Matcha。
Hugging Face 上的 LiteRT 社区已有超过 1 万名关注者, catalog 还在不断增长。Google 也提供了丰富的多模态模型示例,帮助开发者上手自定义实现。
如何开始
端侧语音管线让本地小模型超越了单纯的打字聊天,实现了随时随地、完全离线的自然语音交互。如果你想体验或集成这些功能,可以从以下几步入手:
- 体验新功能:在 Android 或 iOS 上下载最新版的 Google AI Edge Gallery app,亲自试试“XR Language Teacher”和带语音功能的“AI Chat”。
- 研究开源代码:访问 Google AI Edge Gallery 的 GitHub 仓库,查看参考实现。你也可以让编码助手(如 Google Antigravity)分析代码,快速适配流式 ASR、双语 TTS 切换和句子同步播放管线。
- 动手开发:
- Android 集成参考 ML Kit GenAI 文档。
- 跨平台开发使用 MediaPipe Tasks。
- 需要底层控制或自定义模型时,遵循 LiteRT 开发者指南,并从 Hugging Face 社区下载
.litertlm包。 - 利用 Google Cloud 的 Developer Device Platform,在 200 多台真实物理设备上测试和基准测试你的语音管线。
- 观看技术分享:回顾 Android Dev Summit 的相关 session,了解 Language Teacher 如何适配智能眼镜,以及构建这一管线的工程技巧。
端侧语音技术的成熟,意味着 AI 应用不再受限于网络连接。对于注重隐私、延迟和可用性的场景来说,这是一个重要的转折点。