上海AI Lab提出“下一个概念预测”,用51.3%的Token追平主流大模型训练效果
从逐字预测到概念规划:大模型训练的新路径
自现代大语言模型兴起以来,“下一个Token预测”(Next-Token Prediction, NTP)几乎成了唯一可行的预训练范式。模型被要求一个字一个字地猜下去,仿佛写作就是一场永无止境的填空游戏。但问题来了:如果人类写文章是先有大纲、再填充细节,为什么模型不能也学会这种“宏观规划”?

最近,一篇来自上海人工智能实验室与上海交通大学人工智能学院LUMIA Lab团队的技术报告《NCP-ArchPreview Tech Report》悄然出现在arXiv上。没有发布会,没有营销稿,却迅速在开源社区引发热议——登顶HuggingFace Daily Papers榜首,被多位海外技术博主深度解读,甚至有评论称它“可能构成未来AI的第一块基石”。
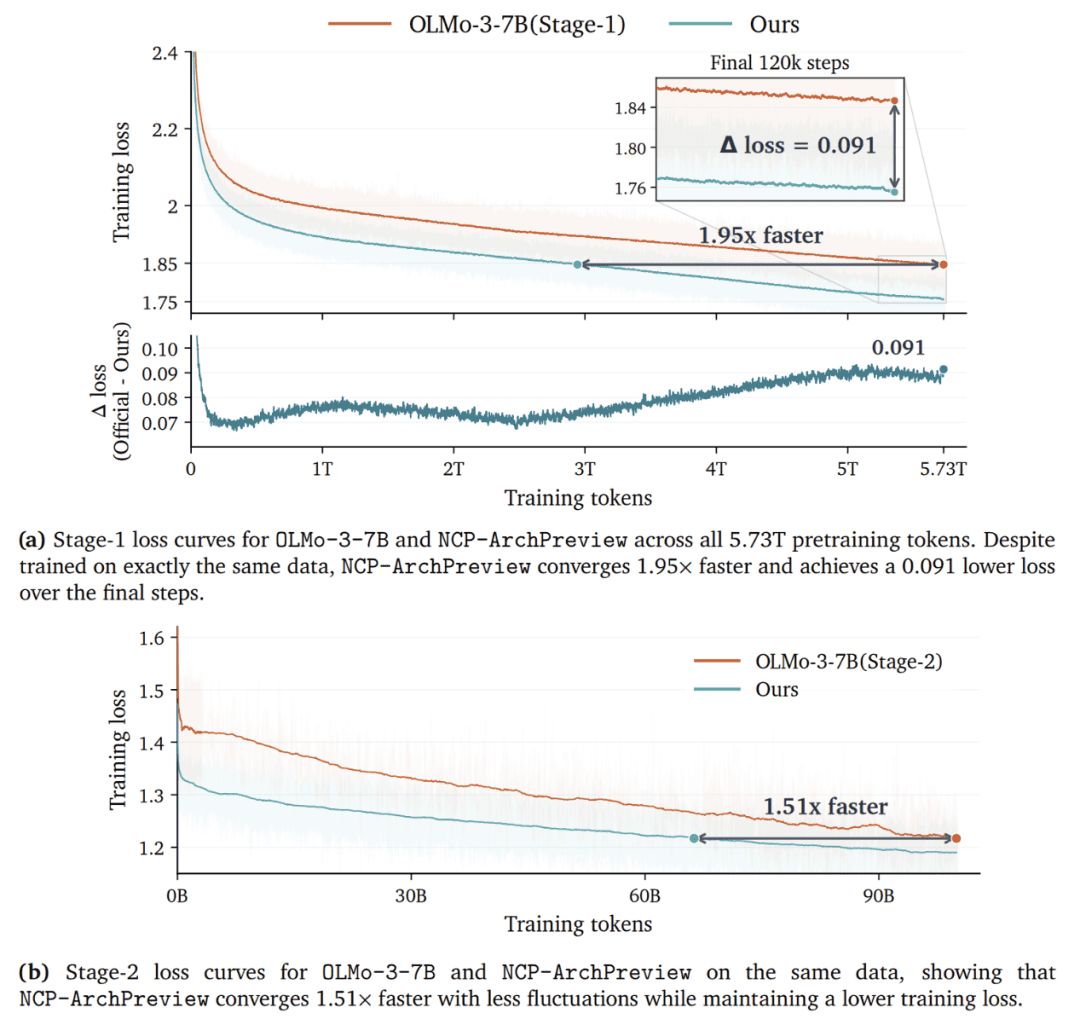
核心突破在于:他们没再让模型死磕每一个Token,而是引入了一个全新的任务——“下一个概念预测”(Next Concept Prediction, NCP)。简单说,模型不再只盯着下一个字,而是同时学习预测接下来要表达的“语义概念”。在8.9B参数规模、5.73T Token的Dolma-3语料上,这一方法仅用51.3%的训练量就追平了OLMo-3-7B的最终Loss,等效收敛速度提升1.95倍。
更让人意外的是,这种架构还带来了“副产品”:只需微调1700万参数就能在数学任务上超越LoRA,且完全不遗忘通用能力;还能为推测解码提供免费加速。目前,团队已将数十个训练阶段的Checkpoint、评估代码和权重全部开源。
效率翻倍:万亿Token下的真实验证
过去很多新架构只能在小模型或玩具数据集上跑通,一放到真实的大规模训练就崩盘。但NCP-ArchPreview直接挑战了工业级预训练——8.94B参数,基于完全开源的Dolma-3语料(5.73T Token),全程对齐OLMo-3-7B的训练设置。
结果令人惊讶:
- 预训练效率翻倍:在第一阶段训练中,NCP模型仅用51.3%的Token预算就达到了OLMo-3-7B跑完全程的Loss水平,最终Loss还低了0.091。第二阶段退火时,收敛速度仍是基线的1.51倍。
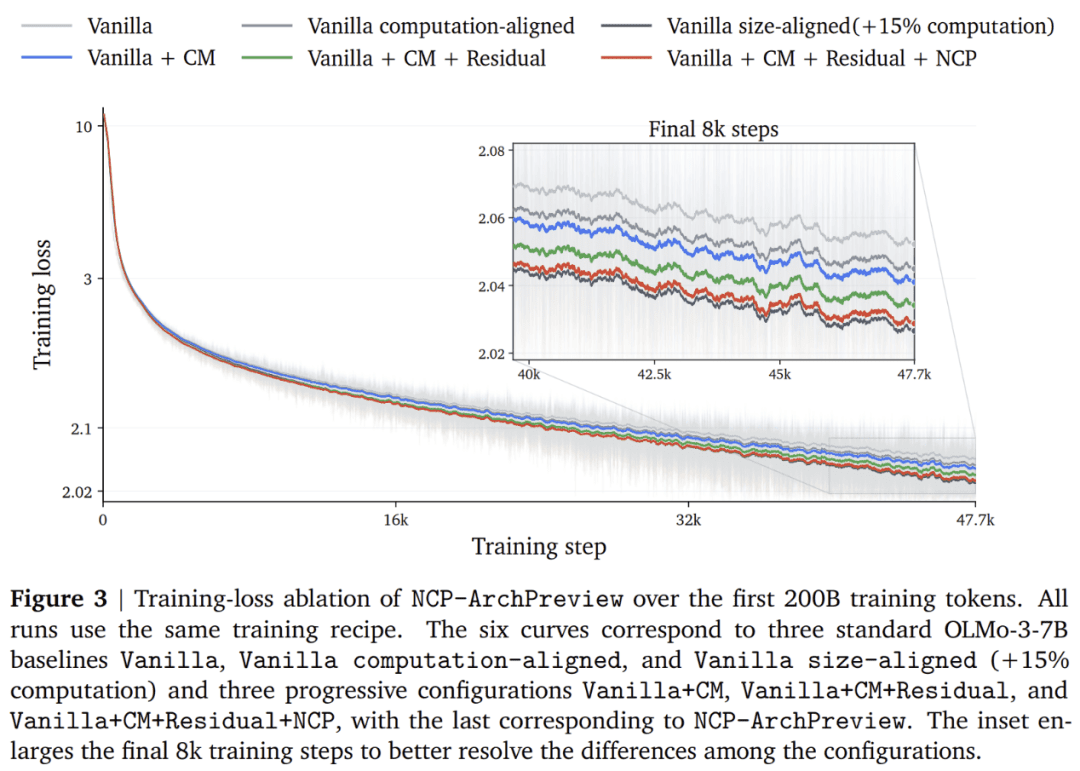
- 计算效率系统性提升:由于概念序列长度被压缩,模型在仅消耗85%算力的情况下逼近了40层Transformer基线的Loss。Scaling Law分析显示,其计算帕累托效率整体提升1.74倍。
效率优势直接转化为下游性能:
- 在涵盖30个基准的综合评测中,Stage-1平均分高出OLMo-3-7B达2.45分。
- 数学推理暴涨:GSM8K从39.27提升至45.26(+5.99),GSM-Symbolic +3.95,Minerva +3.11。
- 代码生成同样亮眼:HumanEval从27.10升至31.38(+4.28),MultiPL-E MBPP +5.29。
这些不是实验室里的数字游戏,而是在真实万亿Token训练中跑出来的结果。
架构拆解:如何让模型“边想大纲边写字”
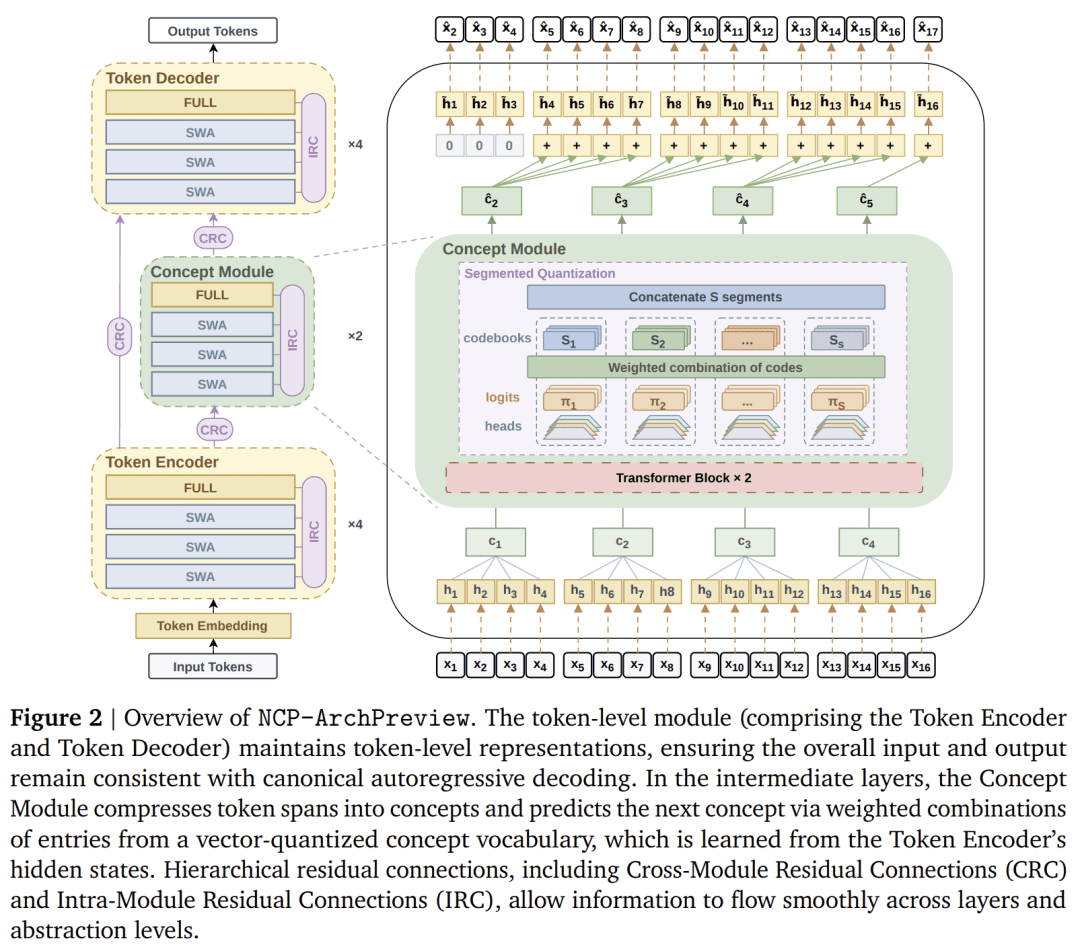
NCP-ArchPreview的核心是在经典Transformer中嵌入一个“三段式”隐空间处理流水线:Token Encoder → Concept Module → Token Decoder。整个设计围绕一个目标:让模型在预测具体词的同时,也能规划高层语义。
概念提炼与超大离散空间
首先,底层16层的Token Encoder处理输入后,每连续4个Token的隐藏状态被平均池化,形成一个“概念单元”。这样,概念序列长度缩短为原来的1/4。
但如何表示这些概念?团队没用连续向量,而是构建了一个离散码本。为了避免维护一个天文数字的扁平码本,他们采用乘积量化(Product Quantization):将每个概念向量切分为32段,每段匹配一个128大小的子码本。组合起来,等效概念空间高达128^32,而参数开销极小。
可微的下一个概念预测
中间8层的Concept Module负责自回归预测“下一个概念”。关键在于,团队没有用硬采样(如argmax),而是让每个预测头输出码本的概率分布,再加权求和得到可微的连续向量。这样既约束了潜空间的漂移,又保证了梯度能端到端回传。
因果防泄漏的反馈机制
预测出的概念不会闲置。它会被复制扩展回Token分辨率,并在时间轴上向前移动4个位置(因果位移Δ=4),然后作为残差信号注入顶层16层的Token Decoder。这意味着,当模型生成第t个词时,它可以合法参考“未来”的宏观概念方向,但绝不会看到未来的具体Token——杜绝了信息泄露。
分层残差路由打通信息流
为了让底层细节和高层概念顺畅交互,团队设计了IRC(模块内残差)和CRC(跨模块残差)机制。每一层都能动态融合之前所有层的表征,模块之间也有直连通道。消融实验显示,这套机制仅增加0.051%的计算量,却带来0.0323的Loss下降。
意外红利:微调不遗忘,推理还加速
如果说预训练效率提升是NCP的“本职工作”,那它在下游任务中展现的能力则完全是惊喜。
17M参数微调,通用能力反而涨了
常规微调要么全参数更新(成本高、易遗忘),要么用LoRA(仍可能掉点)。NCP提供了一个新选项:冻结全部8.9B参数,只微调VQ码本和概念预测头(约1700万参数)。
结果出人意料:
- 在GSM8K和MATH-500上,VQ微调平均分从30.56升至34.83(+4.27),优于同等参数量的LoRA(+3.15)。
- 最关键的是零遗忘:全参数微调导致通用能力下降0.97分,LoRA降0.42分,而VQ微调后通用能力反而上涨0.39分。
- 工程效率也大幅提升:训练吞吐量是全量微调的2.02倍、LoRA的1.50倍;显存占用比LoRA再降34%。
推测解码“免费提速”
在推理加速方面,团队尝试将NCP生成的概念表征注入DFlash2草稿模型。整个过程只为1.1B的草稿模型增加了约4万参数,未给主模型增加任何负担,却让平均接受长度(MAL)提升4.17%,在HumanEval上更是暴增7.59%。
这说明,隐空间学到的不只是抽象特征,更是具有前瞻性的逻辑规划能力,能直接用于加速推理。
坦诚的工程实践:踩坑与开源
这篇40多页的技术报告难得地展现了高度透明的工程态度。
团队详细记录了使用Moonlight Muon优化器配合QK-Norm时遇到的Logit爆炸问题,并发现根源在于全矩阵更新耦合了多头比例,而层归一化无法约束单头离群值。最终,他们验证了Per-head QK-Norm能完美解决这一问题,并将机理完整公开。
针对退火阶段“Loss下降但下游任务掉点”的行业难题,他们构建了一个基于1亿Token专家轨迹的轻量代理指标。仅凭单次前向计算,就能以R²=0.999的相关度预测下游能力,为训练策略提供了可靠风向标。
更重要的是开源方式:团队在HuggingFace上发布了ArchSpace集合,包含从100K步到1.2M步的全程Checkpoint、评测框架、草稿模型权重,甚至消融数据。这种“全透明”做法,让社区能深入研究非经典架构的演化过程,而非只拿到一个黑盒权重。
结语
当行业陷入“更大模型、更多数据”的军备竞赛时,NCP-ArchPreview提供了一条新思路:回到基础机制本身做创新。从被动模仿Token,转向主动规划概念,不仅提升了训练效率,还打开了微调、推理、长序列建模的新可能。这或许正是大模型下一阶段突破的关键方向之一。