LLM 和 Jev 到底有什么区别?为什么这个“不说话的AI”突然爆火?
LLM 和 Jev 到底有什么区别?为什么这个“不说话的AI”突然爆火?
2026年9月,一个“不会写句子”的AI突然刷屏开发者社区。它不聊天、不写代码、不写诗,只干一件事:给你一个判断。TypeSafe AI 给它起名叫 Jev,定位是“System One Model”。它的口号很直白:“Decisions, not strings”——要决策,不要文本。
这听起来有点反直觉。过去几年,我们一直在追求更会说话、更能写的 AI。怎么突然冒出个“哑巴”还火了?原因很简单:很多场景根本不需要 AI 说话,只需要它快速、准确地做个判断。而用大语言模型(LLM)来做这种事,又贵又慢还容易出错。
痛点场景:你是不是也在为这些事头疼?
先看几个真实的企业场景,看看你有没有中招。
客服系统用 GPT 做分类,每月账单十几万。某电商公司每条用户消息都扔给 GPT-4 做意图分类。10万条/天的工单,分类一次平均消耗800 token,每月 API 费用超过12万。更离谱的是,分类任务明明只需要一个“是/否”或者“选A还是B”,GPT 却要输出一大段解释,还时不时格式跑偏,程序解析失败率5%以上。
Agent 每走一步都要调一次大模型,成本爆炸。某创业公司做 AI Agent,每执行一步都要问 LLM:“下一步该做什么?”一个用户任务平均要调15次 LLM。Token 费用加起来,单次任务成本3块钱,根本不敢规模化。
内容审核批量处理,GPU 成本扛不住。某内容平台要审核每天500万条UGC。用大模型审核,延迟2秒,成本高到无法接受;用传统 BERT 分类器,又理解不了“这条投诉是不是真的”这种需要语义推理的判断。
这些痛点背后,其实是同一个问题:我们一直在用“会说话的模型”去干“只需要做判断”的活,大材小用,又贵又慢。
是什么:LLM 和 Jev 到底是什么?
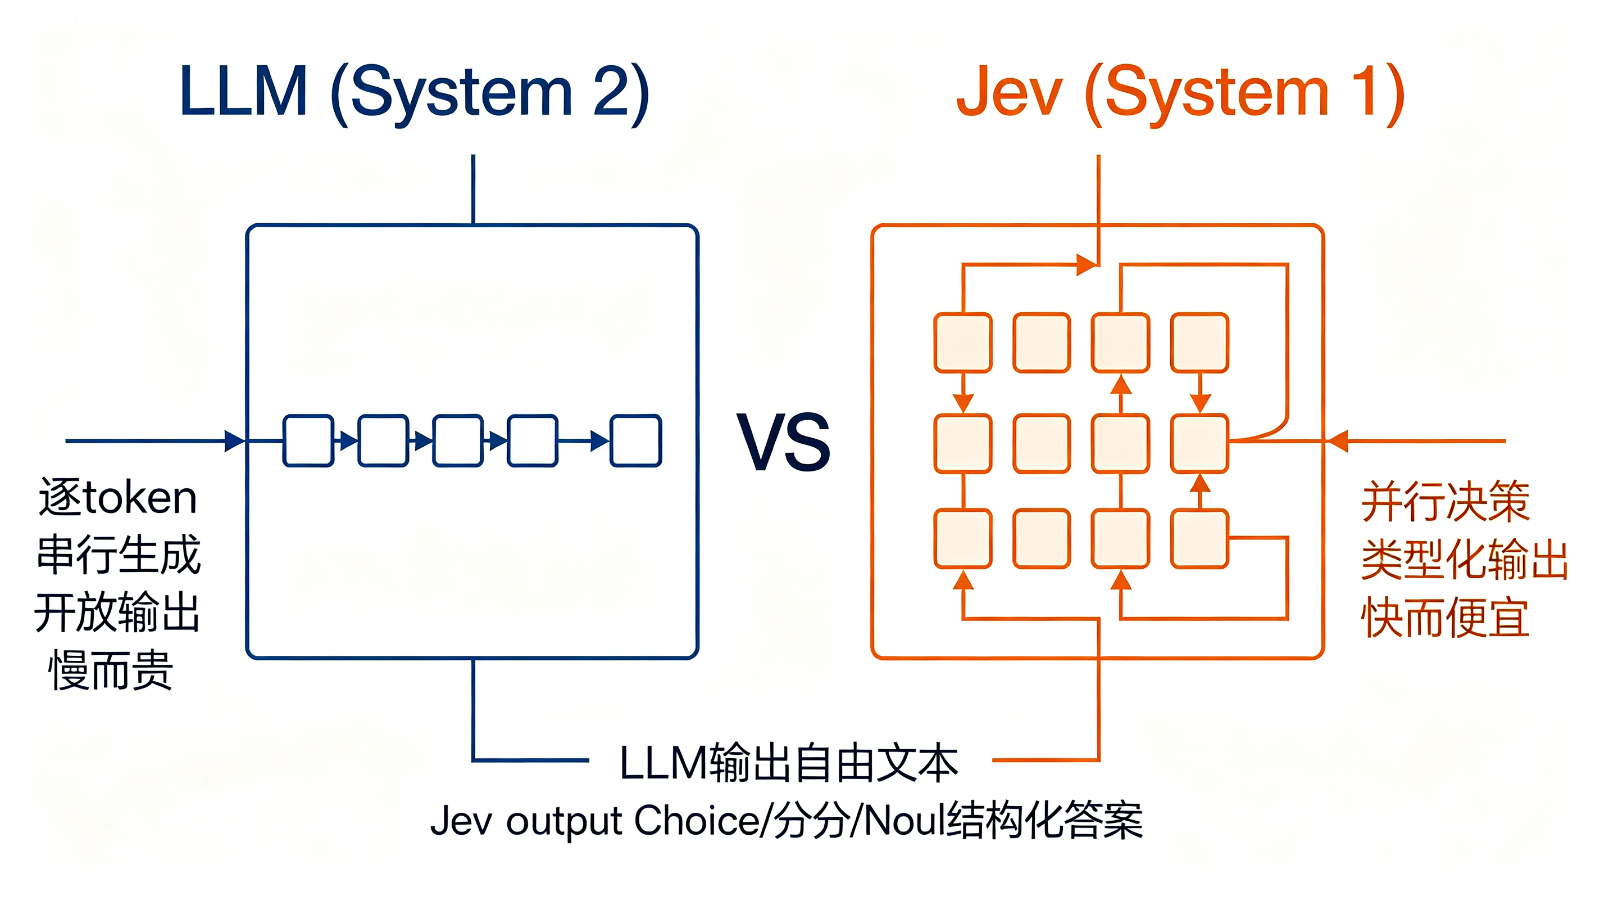
LLM(大语言模型),比如 GPT、Claude、Qwen,是以 Transformer Decoder 为架构,通过自回归方式逐 token 生成文本的通用语言模型。它擅长理解、生成、推理、对话,是当前 AI 应用的主力。
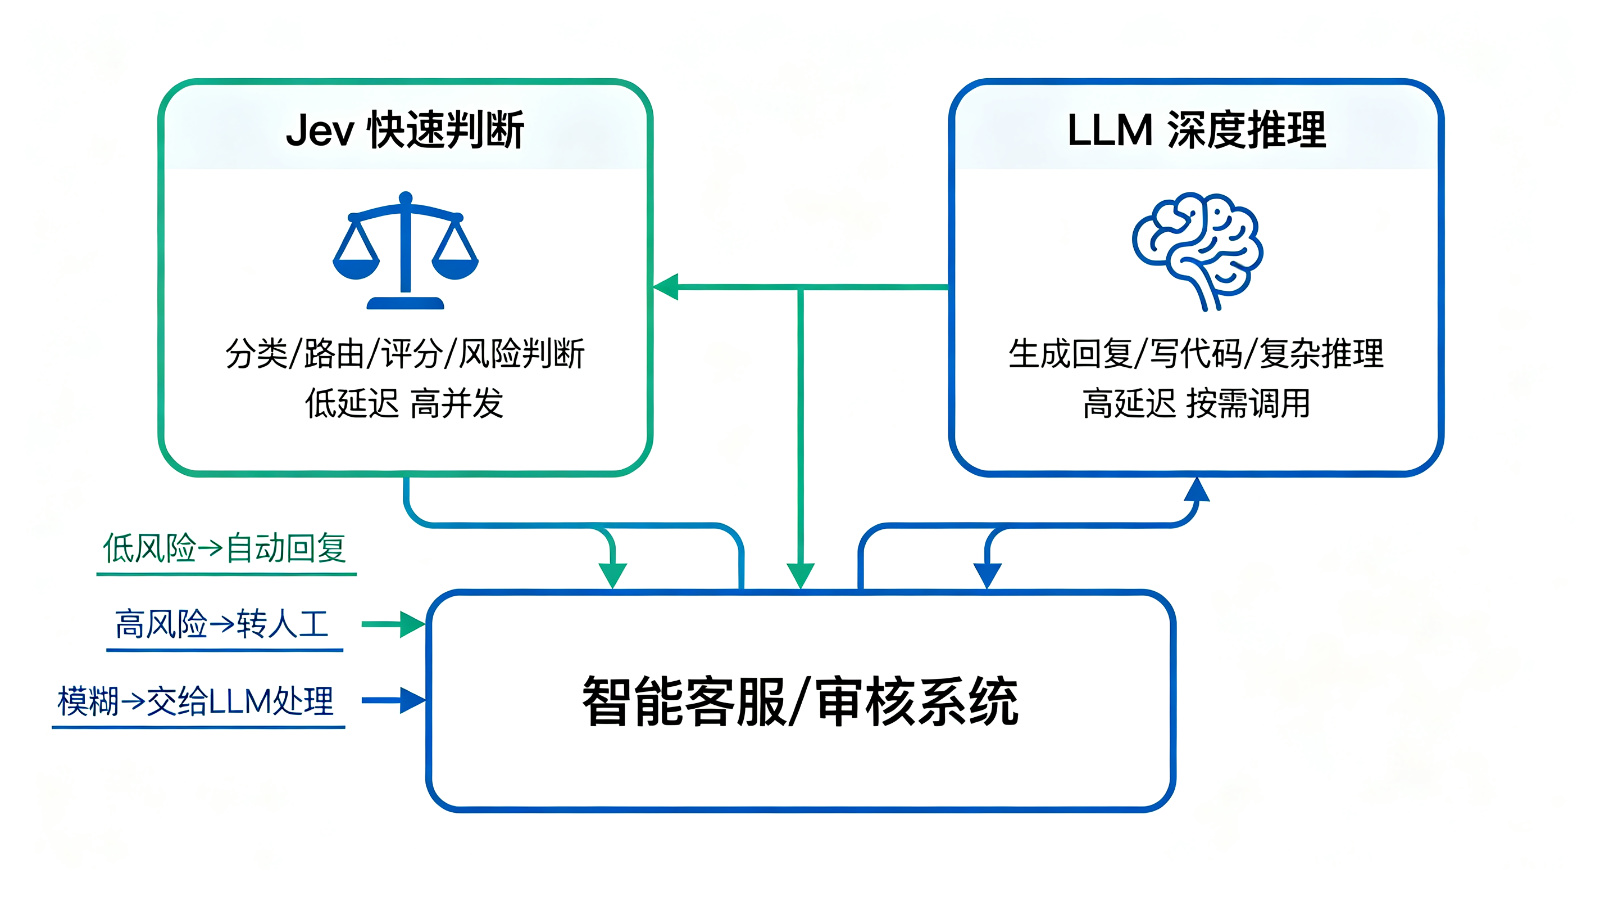
Jev 则完全不同。它不生成任何自由文本。你给它一段状态(state)和一组结构化问题,它直接返回带概率的类型化答案。你可以把它想象成一个反应极快的裁判,你不用让他写报告,直接问:“这个球出界了吗?”他一秒钟举手:“出界,95%概率。”没有废话,只有判断。
Jev 只支持三种操作,没有别的花活:
- Choice(选择):从候选项里选一个,返回选中的选项和每个选项的概率分布。
- Score(评分):按标准打分,返回分数和置信区间。
- Noul(二元判断):回答是/否类问题,返回0到1之间的概率。
为什么用:为什么需要 Jev?LLM 不够吗?
LLM 做决策有三个“原罪”。
第一,串行生成太慢。LLM 必须一个 token 一个 token 地生成。你问一个是/否问题,它也要先想“嗯……”、然后“这个问题……”、最后才说“是”。生成50个 token 才给你答案,延迟和成本都浪费在这些废话上。Jev 用的是并行采样(Parallel Sampler):把多个问题同时丢进去,一次前向传播全部出结果。官方数据是比同类 LLM 快20-200倍。
第二,自由输出容易翻车。你让 LLM 输出 JSON,它可能多写一句“好的,这是结果”;你让它输出1到5的评分,它可能输出“我觉得大概是3分左右”。程序没法稳定解析。实测中,某些模型的结构化输出格式错误率高达45.5%。Jev 的输出空间是你在请求里定义死的,返回的就是类型化结果,程序直接用,格式错误率为0。
第三,太贵。一次分类任务,LLM 要消耗几百 token,成本约0.03−0.18;Jev 输入 token 定价42/十亿,输出token永久免费,单次任务成本约0.0004,差了两个数量级。
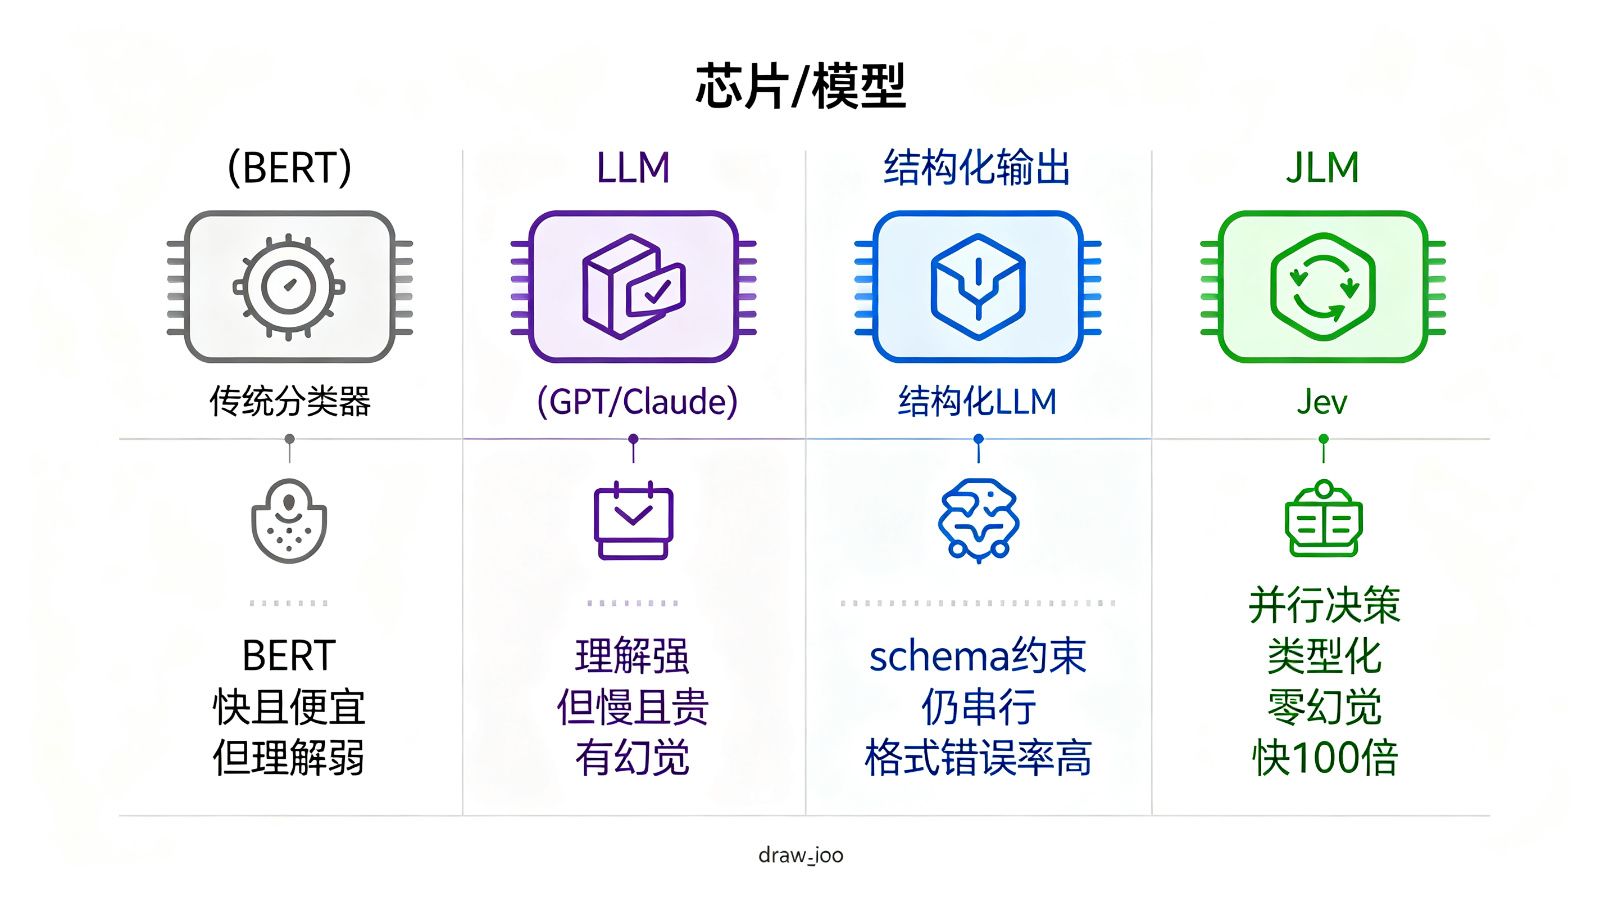
那为什么不直接用 BERT 小分类器?问题在于 BERT 需要针对每个任务微调,维护成本高;理解能力有限,听不懂需要上下文推理的话;而且输出的概率没有校准,你不知道这个0.8是不是真的有80%把握。
Jev 用 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习)训练,输出的概率是校准过的——它说90%,长期来看90%的时候确实是对的。这对工程系统至关重要,因为你需要根据概率设阈值:“概率超过0.8就自动处理,低于0.5就转人工。”
怎么演进过来的:从 Prompt 到 System One
Jev 的出现不是偶然,而是 AI 工程化演进的必然结果。
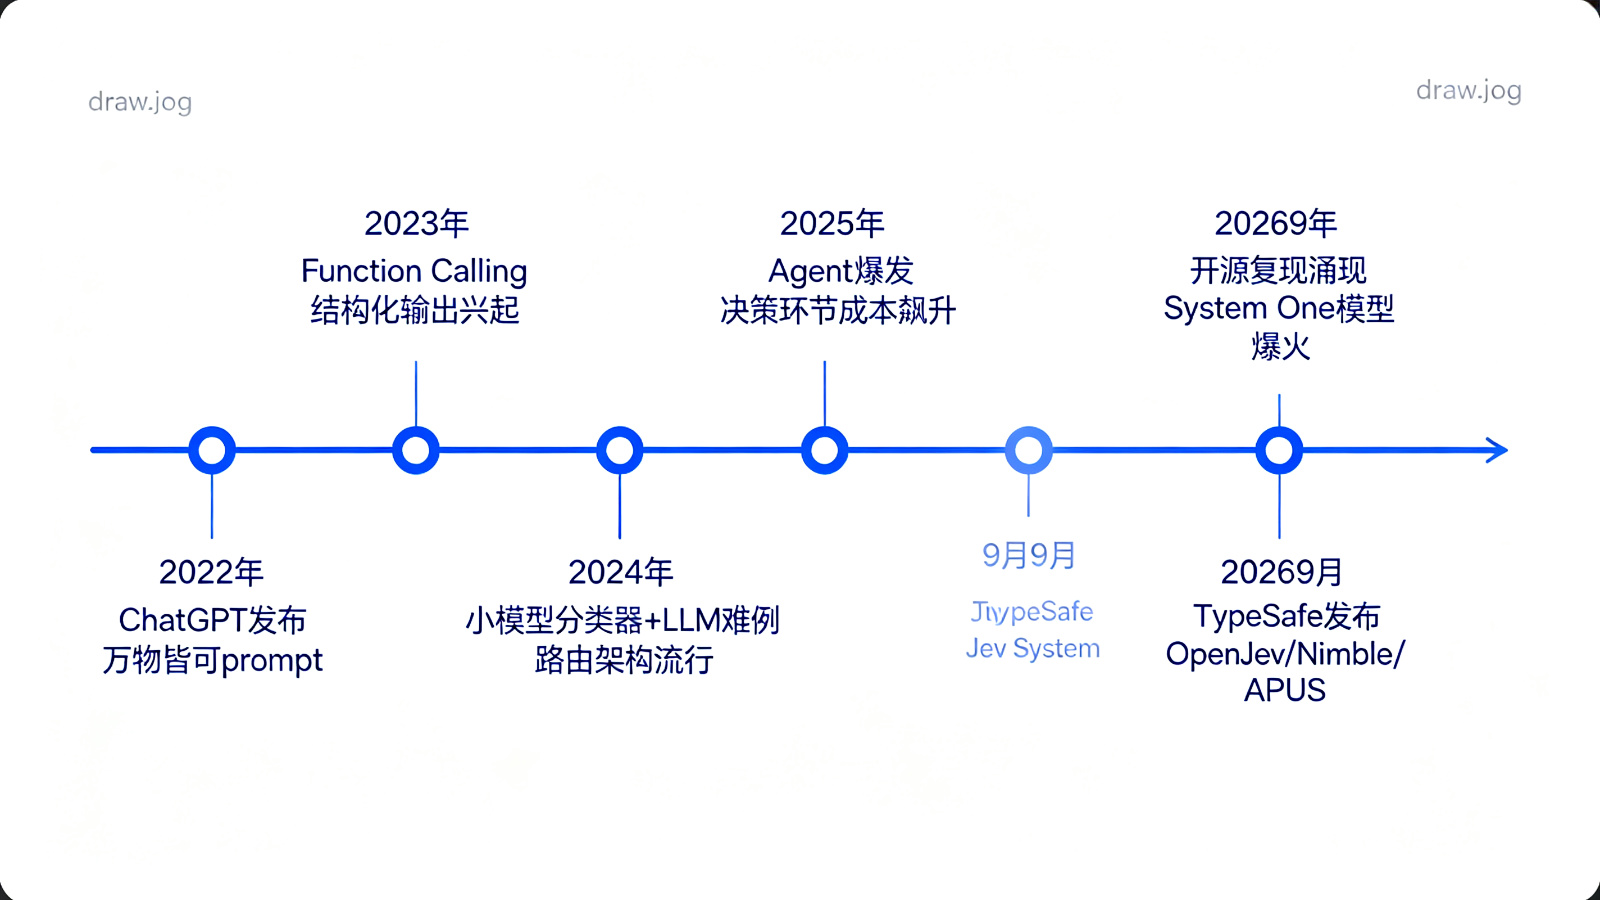
2022年,ChatGPT 刚出来时,什么任务都用 prompt 解决。分类就是:“请判断这条评论是正面还是负面,只回答正面或负面。”能用,但慢、贵、格式不稳定。
2023年,OpenAI 推出 Function Calling,各家 LLM 跟进,模型可以按 schema 输出 JSON。这解决了一部分格式问题,但本质还是自回归生成,速度和成本没有质变。
2024年,工程团队开始实践“大小模型路由”:简单问题用小模型,难问题才上 GPT-4。但小模型理解力不够,路由准确率上不去,而且每个分类任务都要单独训练和部署,维护成了噩梦。
2025年,Agent 应用井喷。一个 Agent 任务要执行十几步,每步都要做决策:“该不该调用工具?”“这个结果满意吗?”每步都调 LLM,token 费用爆炸,延迟也不可接受。行业开始呼唤专门的“决策层”。
2026年9月,前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI 发布 Jev,首次把“只做决策、不生成文本”做成一个独立模型品类。发布几天内 X 上原帖浏览量破3700万,14万开发者关注。
Jev 发布后仅4天,开源社区就出现多个复现,如 OpenJev、Nimble、NanoJev 等,甚至中国 APUS 公司也推出了全球首批跨平台开源复现。
演进逻辑一句话:从“让 LLM 什么都干”,到“让 LLM 只干它擅长的事,判断交给专门的快模型”——这是 AI 工程化从玩具走向生产的必然一步。
怎么用:企业项目实战代码
光说不练假把式。下面看几个真实企业场景的代码示例。
示例1:客服意图分类(Noul + Choice)
这是最典型的用法——用户进线后,先用 Jev 判断意图,决定路由到哪个队列。一次调用可以同时问两个问题,并行返回。
from typesafe_sdk import TypesafeClient, Choice, Noul
client = TypesafeClient()
def classify_ticket(user_message: str):
state = {
"message": user_message,
"channel": "web_form",
"user_tier": "premium"
}
decisions = client.ask(
state=state,
questions=[
Choice(
question="用户的主要意图是什么?",
options=["refund", "technical_issue", "billing", "general_inquiry"]
),
Noul(
question="这条工单是否需要在1小时内人工处理?"
)
]
)
intent = decisions[0].selected
is_urgent = decisions[1].answer
urgency_prob = decisions[1].probability
return {
"intent": intent,
"is_urgent": is_urgent,
"urgency_probability": urgency_prob
}示例2:内容审核批量评分(Score)
某内容平台每天要审核海量 UGC,用 Jev 做批量风险评分,高分才转 LLM 详查。Jev 单次调用可以并行处理多个问题,比逐条调 LLM 快几十倍。
示例3:Jev + LLM 混合路由(企业级 Agent)
这是最有工程价值的模式:Jev 做快速门控,不确定时才上 LLM。
def handle_user_query(user_query: str) -> str:
# 第一步:Jev 快速判断
decisions = jev.ask(
state={"query": user_query},
questions=[
Noul(question="这个问题需要详细解释或生成大段文本吗?"),
Choice(question="如果这是分类问题,属于哪类?", options=[...])
]
)
need_llm = decisions[0].answer
category = decisions[1].selected
# 第二步:根据 Jev 的判断分流
if not need_llm and category != "other":
# Jev 直接路由,不调 LLM
return auto_replies[category]
else:
# 复杂问题才动用 LLM
return llm.chat.completions.create(...)竞品对比:BERT / LLM / 结构化输出 LLM / Jev
| 对比维度 | 传统分类器(BERT) | LLM(GPT/Claude) | 结构化输出LLM | Jev |
|---|---|---|---|---|
| 输出形式 | 固定类别概率 | 自由文本 | schema 约束的 JSON | 类型化决策+概率 |
| 生成方式 | 单次前向 | 逐token自回归 | 逐token自回归 | 并行采样,一次前向 |
| 速度 | 极快(ms级) | 慢(秒级) | 慢(秒级) | 快(<500ms) |
| 成本 | 几乎为零 | 高 | 中高 | 极低 |
| 格式稳定性 | 稳定 | 差 | 中等 | 100%类型化,零格式错误 |
| 概率校准 | 未校准 | 不提供 | 不提供 | RLCD训练,校准过 |
选型一句话:
- 任务简单固定、量极大:BERT 微调仍然最便宜。
- 需要理解+生成:用 LLM,别犹豫。
- 需要理解但只要结构化结果:试 Jev,它就是为这个生的。
常用场景:Jev 和 LLM 分别用在哪里?
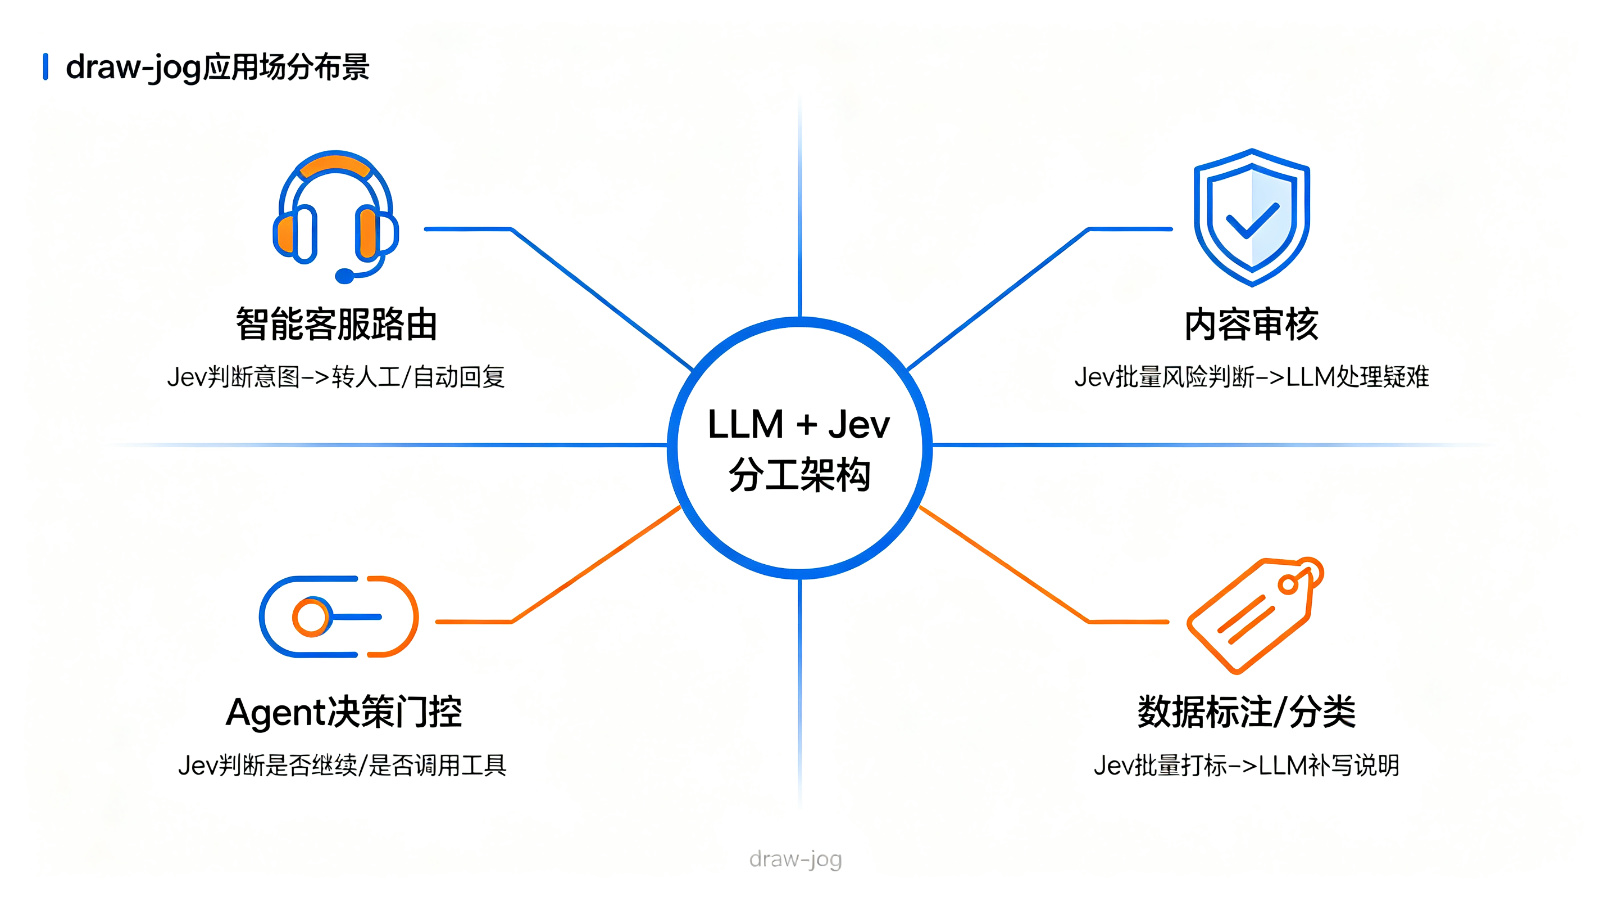
Jev 最适合干的活:
- 智能客服路由
- 内容审核初筛
- Agent 决策门控
- 数据标注打标
- 风险/合规筛查
- 模型输出质检
- 搜索结果排序
LLM 仍然不可替代的活:
- 写文章、写代码、写方案
- 复杂推理
- 开放对话
- 长文总结、翻译、改写
- Unknown 任务
什么时候必须用 Jev?满足以下任意一条:
- 单次决策量大(日调用十万次以上),LLM 成本扛不住。
- 延迟敏感(要求 <500ms),LLM 太慢。
- 输出必须 100% 结构化,不能容忍格式错误。
- 需要概率做门控(“超过 0.8 自动通过”)。
面试官高频面试题
Q1:Jev 到底是不是一个 LLM? 严格说不是。Jev 不是自回归生成模型,不输出 token 序列。它是一个“System One Model”,输入状态+结构化问题,直接返回类型化决策和概率。
Q2:Jev 为什么比 LLM 快这么多? 两个原因:一是不做自回归逐 token 生成,二是用并行采样一次前向传播回答多个问题。LLM 生成100个 token 要100次前向;Jev 一次前向出所有答案。
Q6:Jev 会取代 LLM 吗? 不会。它们是互补关系,不是替代。Jev 不生成文本、不做复杂推理,这些活还是 LLM 干。未来趋势是“LLM + System One 模型”的混合架构。
总结
记住这句话:LLM 负责“想”,Jev 负责“判”。
在 AI Agent 时代,决策频率远高于生成频率。一个完整的 AI 系统应该是:Jev 在前面做高频、原子化的判断(路由、分类、评分、风险筛查),只有当 Jev 不确定或者遇到复杂任务时,才把请求交给 LLM。这样80%的请求用便宜快速的 Jev 处理,20%复杂请求才动用 LLM,整体成本降一个数量级。
Jev 会不会是终局?不一定。但它指明了一个方向:AI 模型正在从“一个模型干所有事”走向“多种模型分工协作”。看懂这个趋势,比记住 Jev 这个名字更重要。