智能体式视觉生成:从单次出图到持续积累经验的设计系统
让AI不只是“出图”,而是“做事”
现在让AI生成一张海报已经不难。真正难的是让它围绕同一个设计目标持续工作:理解品牌调性与产品要求,先出初稿;发现标题位置不对、产品主体太小或整体风格偏离后,知道该改哪里、怎么改;同时保留用户已经确认的部分。等到下一次活动,它还能延续之前确定的设计偏好和有效做法。

这种能力远超“输入一段提示词就出图”的模式。它涉及一系列连续决策:选什么工具、如何检查结果、做局部还是全局修改、哪些经验值得保留。这些决定由谁来做、做到哪一步,正是 Agentic Visual Generation(智能体式视觉生成)要研究的问题。
复旦大学、Wan 和香港中文大学多媒体实验室(mmlab)的研究团队在综述《Agentic Visual Generation: From Generative Models to Agentic Control》中,为这个快速发展的方向建立了一套清晰的分类框架——核心不是看画质多高,而是看控制器能影响多远的决策。
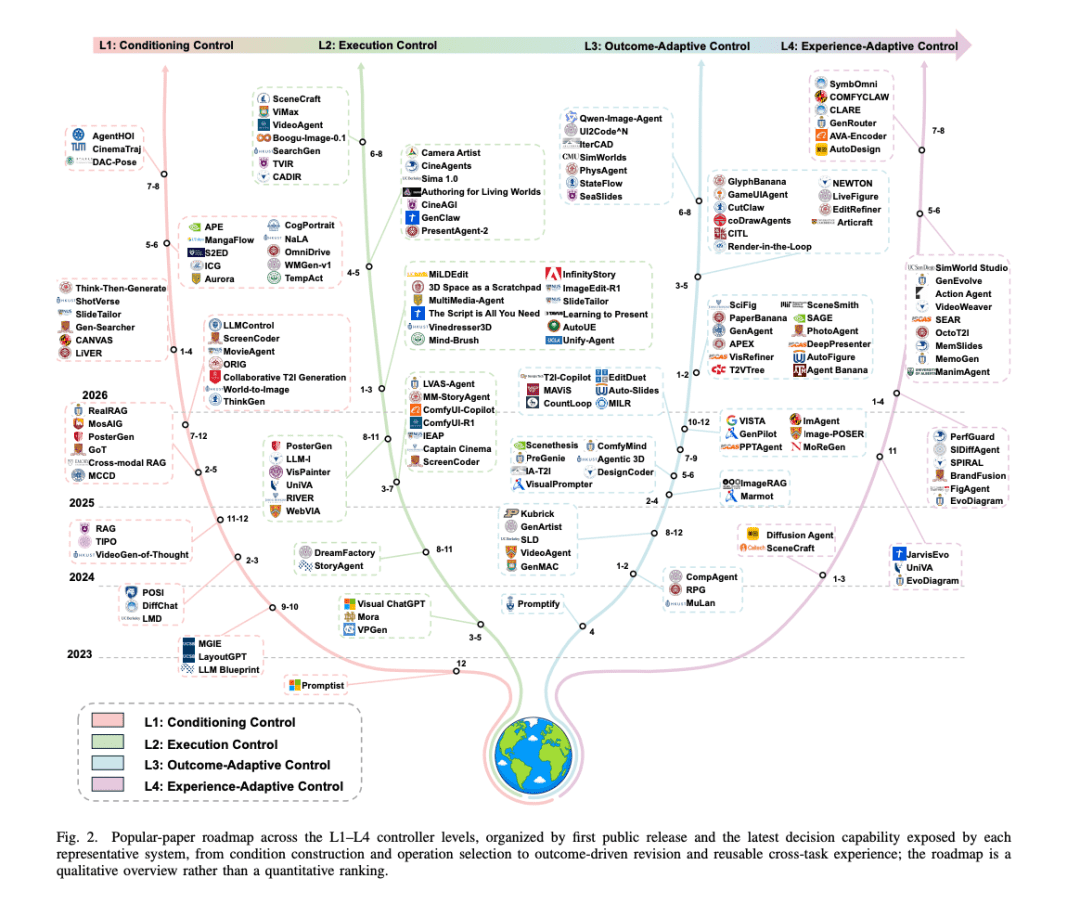
论文梳理了覆盖图像生成、编辑、视频、幻灯片、用户界面、3D 乃至世界模型的系统,并把它们放到同一组问题下考察:系统在生成前能决定什么?执行时能选择什么?看到结果后能改变什么?任务结束后又能留下什么?
其中特别值得注意的一点是:目前大多数系统已经能做到“根据结果修正当前任务”,但能把已完成任务的经验用于后续独立任务的系统,仍然相对少见。
一套分类,先把“自主到哪一步”讲清楚
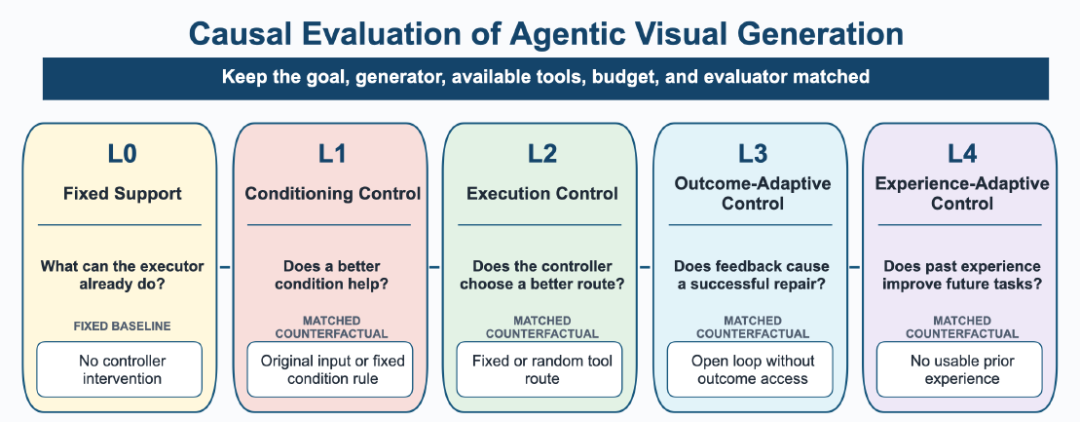
在现有系统中,控制器通常由大语言模型(LLM)或视觉语言模型(VLM)担任,负责理解需求、规划步骤并选择行动;而图像/视频生成模型、编辑器、渲染器等,则作为“执行器”完成具体的视觉操作。
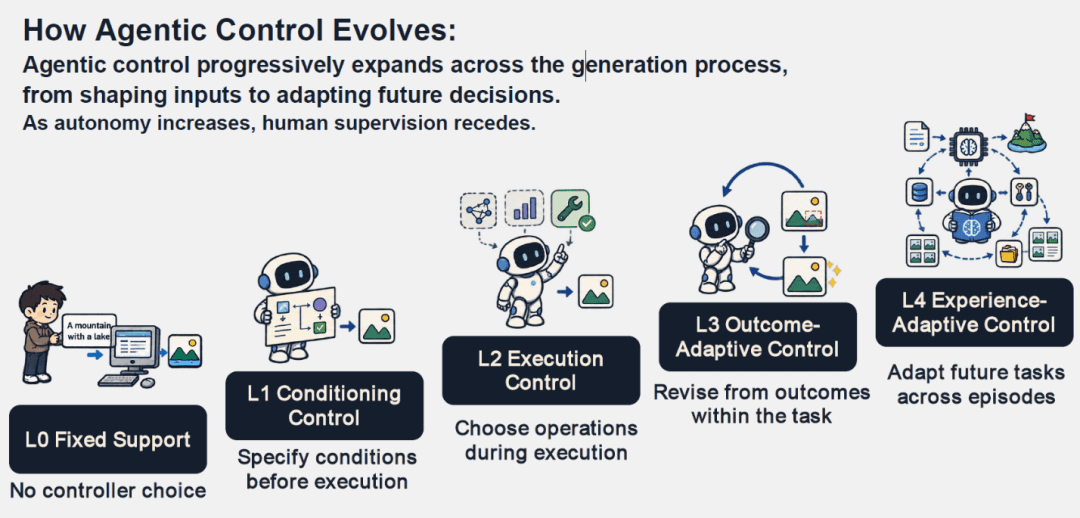
基于这一分工,综述按照控制器能够影响的最远决策边界,将相关系统划分为 L0 至 L4 五个层级。L0 是固定支撑组件与流程,界定讨论起点;L1 到 L4 则对应逐步扩展的四级控制能力。
L0:固定支撑(Fixed Support)
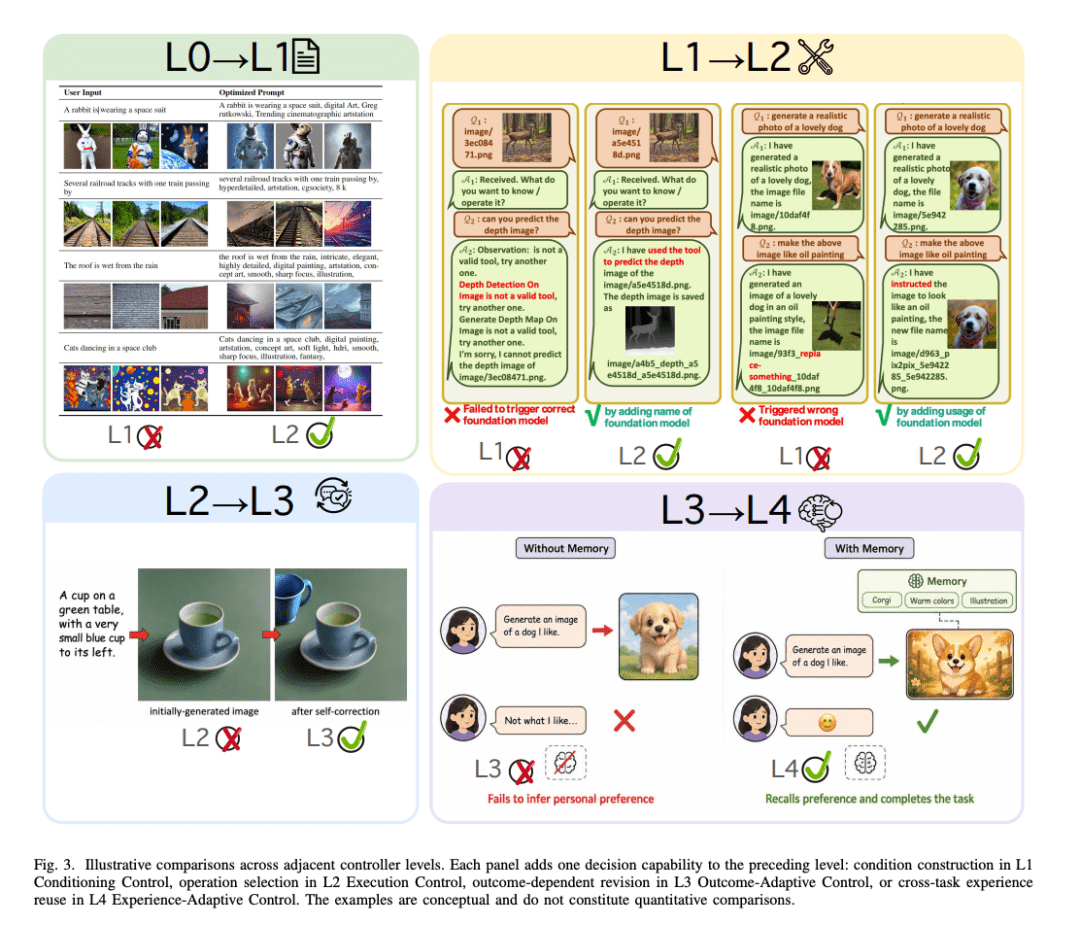
L0 不涉及任何动态决策。生成器、编辑器、检索器、评估器和整个流水线都按预设路径运行,提供基础能力,但没有控制器来决定“下一步该用哪种操作”。比如一个只接受固定格式提示词、自动出图的Stable Diffusion WebUI,就属于L0。
需要注意,L0描述的是决策方式,与最终画质高低无关。高画质系统也可能只是L0,只要它的流程完全固定。
L1:条件控制(Conditioning Control)
到了L1,控制器开始发挥作用——但它只负责“准备输入条件”,不干预执行过程。典型操作包括:
- 改写或结构化提示词
- 规划物体位置(如生成边界框)
- 选择参考图或风格样本
- 检索外部知识(如产品参数)
- 设计分镜脚本或相机运动轨迹
例如,LLM-grounded Diffusion 将“一只戴墨镜的猫坐在红色沙发上”拆解为对象描述和空间布局;LayoutGPT 生成2D或3D场景布局;World-To-Image 则从知识库中检索定义和参考图。这些条件最终交给一个预先确定的生成器执行,控制器不再介入后续步骤。
L2:执行控制(Execution Control)
L2 的控制器开始“动手”了。它不仅准备条件,还选择并编排实际的视觉操作。这意味着它可以:
- 决定使用哪个图像生成模型
- 调用局部编辑工具(如Inpainting)
- 在多个模型间切换(如换风格模型)
- 编排节点式工作流(如ComfyUI)
- 组织视频生成的多个阶段(角色、镜头、动作)
Visual ChatGPT 把各种视觉模型封装成工具,由LLM按需调用;ComfyUI-Copilot 能生成可执行的节点图;ViMax 则组织剧本、镜头序列、角色风格和片段生成。控制器在这里真正成为“导演”,决定用哪些能力、以什么顺序完成任务。
L3:结果自适应控制(Outcome-Adaptive Control)
L3 引入了反馈闭环。系统会查看已经生成的图像、视频、PPT页面或3D场景,再根据问题调整后续行动。常见反馈包括:
- 物体缺失或重复
- 空间关系错误(如手穿过桌子)
- 动作不连贯(视频卡顿)
- 代码报错(UI生成)
- 物理仿真失败
- 用户直接意见(“logo太小”)
面对这些问题,控制器可以选择:局部编辑、重新生成某部分、调整输入条件,甚至提前终止任务。SLD、GenPilot 和 PPTAgent 分别展示了图像修正、视觉细化与幻灯片编辑中的结果驱动调整。
截至2026年8月,L3收录了202项工作,是增长最快的层级,说明“根据结果修正当前任务”已成为主流研究方向。
L4:经验自适应控制(Experience-Adaptive Control)
L4 把适应能力延伸到未来的独立任务。系统会把已完成的生成过程保存为长期记忆,形式包括:
- 能力档案(记录各模型在不同任务的表现)
- 可复用的工作流模板
- 提炼出的技能(如“电商海报标题放大1.5倍”)
- 成功/失败轨迹日志
OctoT2I 根据历史表现动态更新生成器能力档案;GenEvolve 从轨迹中提炼可复用过程;COMFYCLAW 则把验证过的工作流构建方法沉淀到技能库。下次遇到类似任务,系统可以直接调用或微调这些经验。
然而,L4目前只有25项工作,远少于L3。经验并非存得越多越好——它是否相关、是否过时、会不会把旧错误带入新任务,都需要机制验证。
300+份工作背后,下一个突破在哪里?
综述统计了截至2026年8月24日的300多项相关工作,按层级分布如下:
- L1:49项
- L2:33项
- L3:202项
- L4:25项
2025年后的增长明显集中在L3,说明研究者普遍认同“结果反馈”是提升生成质量的关键。相比之下,L4的跨任务经验复用仍处于早期阶段。
这里有几个深层挑战:
- 经验的有效性:旧任务的经验在新场景下可能失效。比如为节日促销设计的红金配色,用在科技发布会可能不合适。
- 负迁移风险:错误的经验如果被固化,反而会污染新任务。
- 记忆成本:存储和检索大量历史轨迹需要高效机制,否则会拖慢响应。
- 用户意图漂移:品牌策略可能变化,系统需要识别“这次不要沿用上次风格”。
这些问题意味着,L4不仅是技术问题,更是对“什么是可靠经验”的定义问题。
怎样测出Agent的贡献?先把比较条件对齐
生成效果变好,可能来自更强的生成器、更多次采样,也可能是控制器确实做出了更有效的决定。如果不控制变量,很容易高估Agent的作用。
论文据此提出按控制级别设计评估:固定生成器、可用工具、计算预算和评估器,再逐次增加一类决策能力,观察性能变化。
- 评测L1:用同一个生成器,比较“原始提示词”和“控制器优化后的条件”哪个效果更好。
- 评测L2:给定同一组工具,比较不同控制器能否选到更合适的执行路线,并将路线选择的收益与工具本身的能力区分开。
- 评测L3:让两个版本使用相同的初始计划、工具和总预算,一个能读取中间结果并修改,另一个只能按既定路线执行,看前者是否显著提升质量。
- 评测L4:在新的独立任务上,比较保留、移除或打乱历史经验后的表现,并检查是否存在负迁移或遗忘。
此外,评估还需记录每次修正的代价:
- 是否破坏了用户已确认的内容?
- 是否满足硬性约束(如品牌色、logo尺寸)?
- 系统是否在合适时机停止,避免过度修改?
这些细节能真实反映Agent的实用价值,而非单纯追求指标提升。
生成器自己当控制器?可能更短的反馈链路
论文还讨论了一个有趣方向:generator-as-controller。传统架构中,控制器(LLM/VLM)和生成器是分离的,反馈需要跨模态传递。但如果生成器能直接依据视觉状态做决策,反馈链路可能更短,局部调整也会更精确。
例如,一个扩散模型在去噪过程中,如果能实时判断“手部结构异常”,直接在潜空间修正,可能比先输出图像、再由LLM分析、最后调用编辑工具更高效。
不过,这类系统仍需用同一套标准证明:中间结果确实改变了后续行动。否则,它可能只是隐式优化,而非真正的“决策”。
对研究者和开发者的实际意义
这篇综述的价值不仅在于分类,更在于提供了可操作的视角:
- 对研究者:它是一张按决策能力组织的文献地图,帮助定位自己的工作在L1–L4中的位置;同时提供了一套对齐条件后的评估方法,避免无效比较。
- 对开发者:它给出了检查系统能力的具体问题:
- 控制器能选择哪些操作?
- 生成结果能否改变下一步行动?
- 任务结束后,哪些经验会继续影响未来?
Agentic视觉生成的进展,最终需要落实到这些可以观察和验证的决定上。不是看它能不能出一张漂亮的图,而是看它能不能像一个有经验的设计师那样,持续学习、不断改进,并在新任务中复用有效策略。
这条路才刚刚开始。