Grok 4.7 发布:专注长任务编程与专业工作,价格不变性能提升
Grok 4.7 来了,这次不只拼跑分
今天一早,SpaceXAI 正式上线 Grok 4.7。发布页面开篇就甩出一句硬核定位:“面向编程与知识工作的最强模型,速度达到可比模型的两倍,价格只有一半。”
这显然不是一次常规迭代。Grok 4.7 换用了更大的基础模型,延长了强化学习训练周期,并把重点放在那些需要数小时才能完成的复杂任务上。它不再满足于写几行漂亮代码,而是试图在整套工作流中少走弯路,直接交出能用的结果。
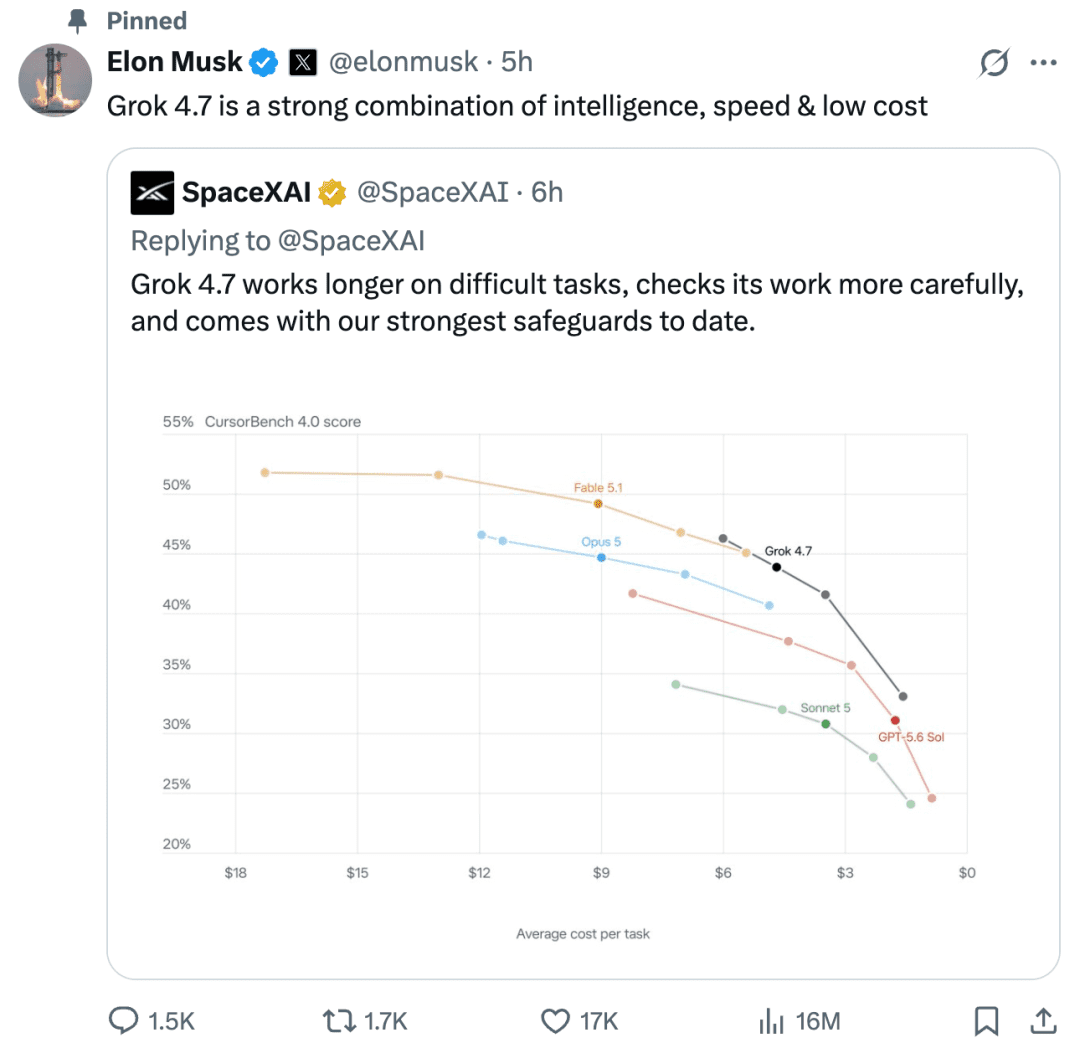
马斯克在 X 上简单评价:“Grok 4.7 在智能水平、运行速度和成本之间取得了很有竞争力的平衡。”
长任务,成了新战场
Grok 4.7 最大的变化,是把“长时间任务”作为核心优化方向。相比 Grok 4.6,新模型在训练时引入了更多耗时数小时的样本,要求模型在执行链中持续保持目标、识别错误、管理上下文。
这对编程智能体尤其关键。现实中的软件开发很少是“一句话生成函数”,更多是读完整个代码库、拆解模糊需求、修改多个文件、跑测试、发现 bug、再回头调整。整个过程可能跨越几十次交互。如果模型中途“失忆”或偏离目标,效率反而更低。
Grok 4.7 在这方面做了针对性改进。官方称,它在自我检查和长上下文管理能力上有显著提升。更关键的是,它被训练为原生理解 Grok Bot 的运行框架,这意味着模型与工具、环境之间的协作更顺畅——不再是孤立的问答机器,而是一个能持续工作的智能体。
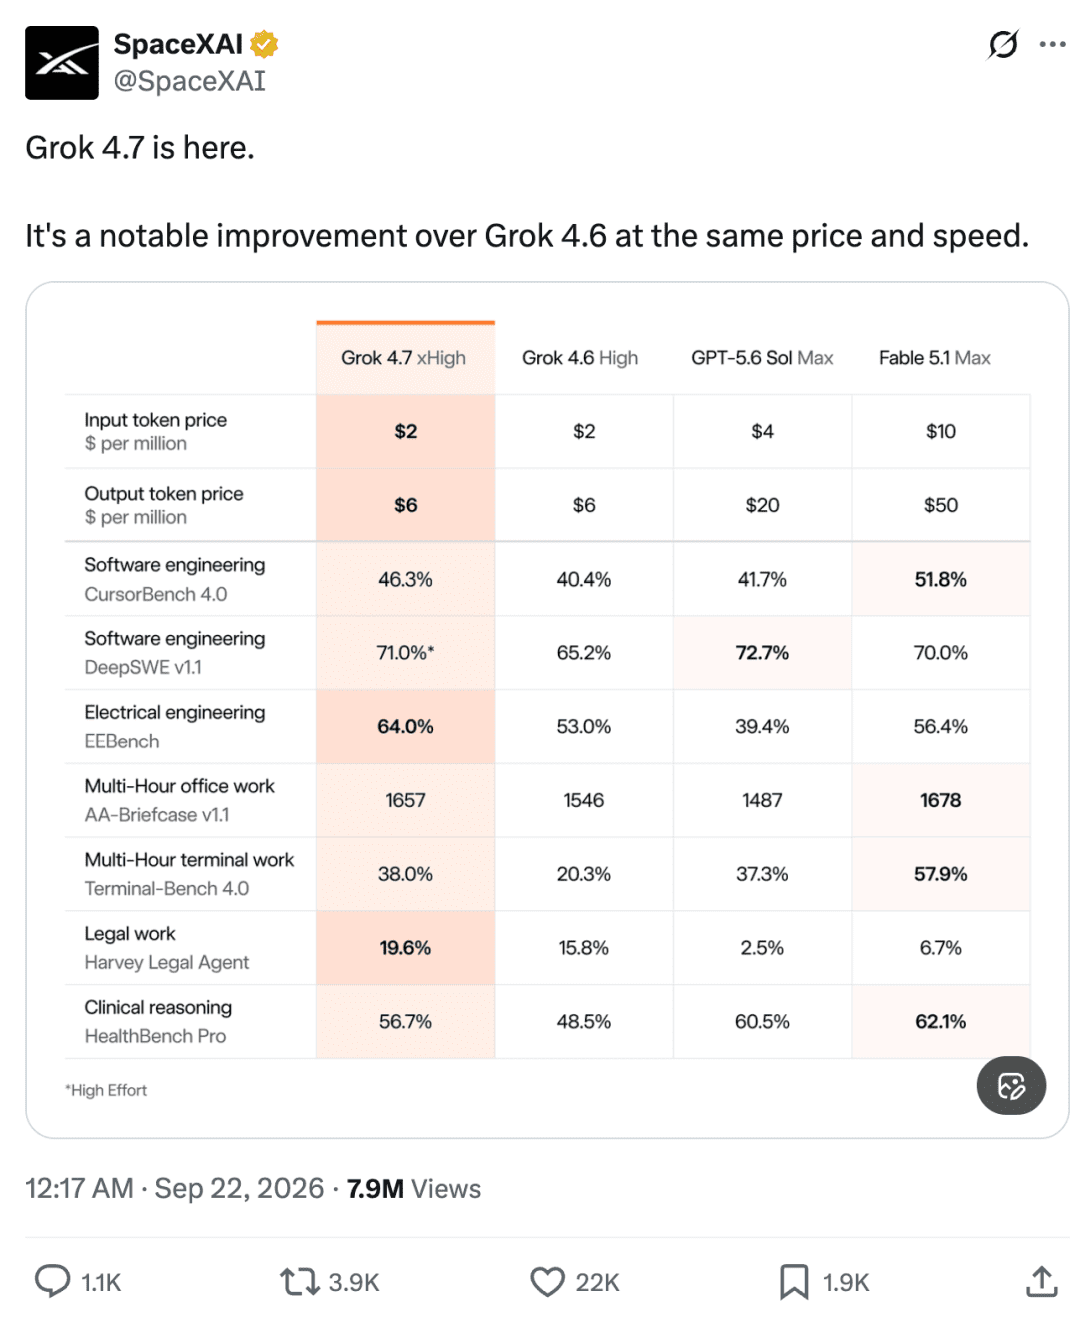
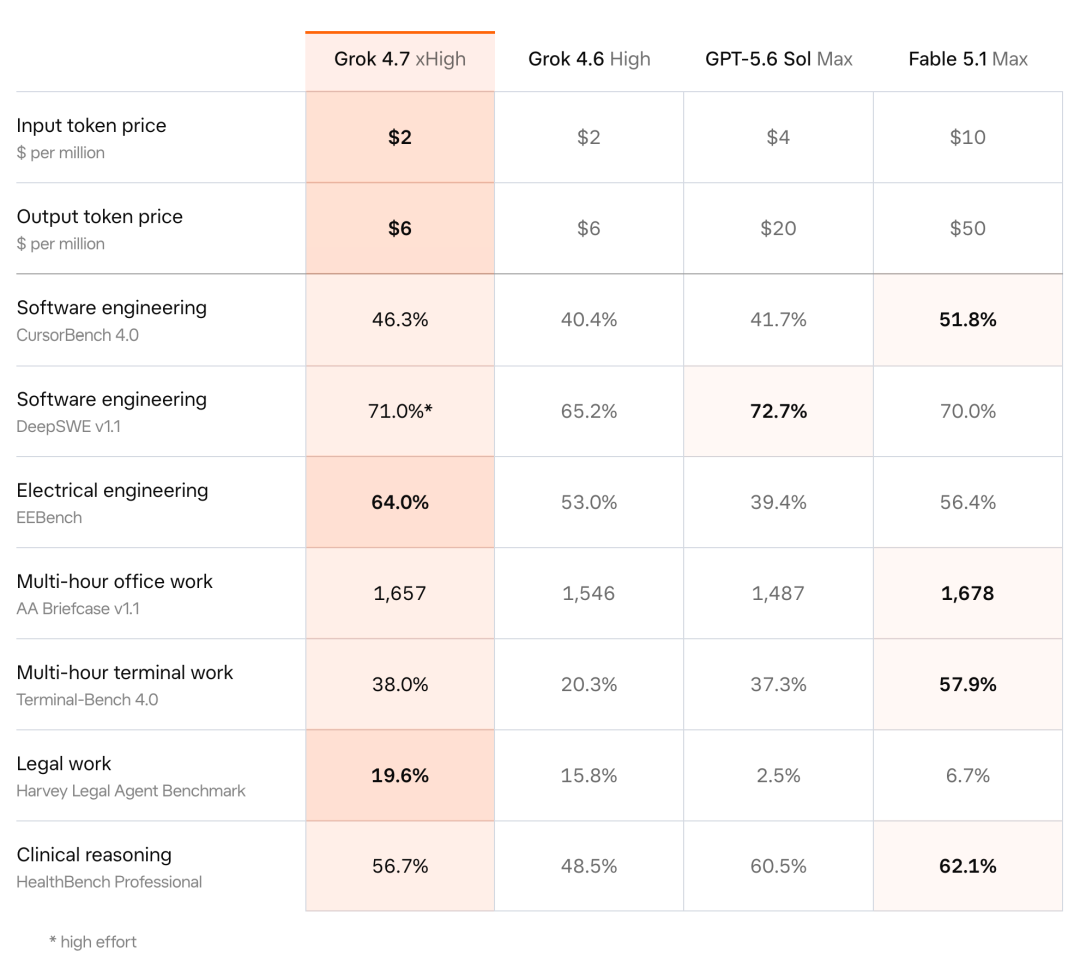
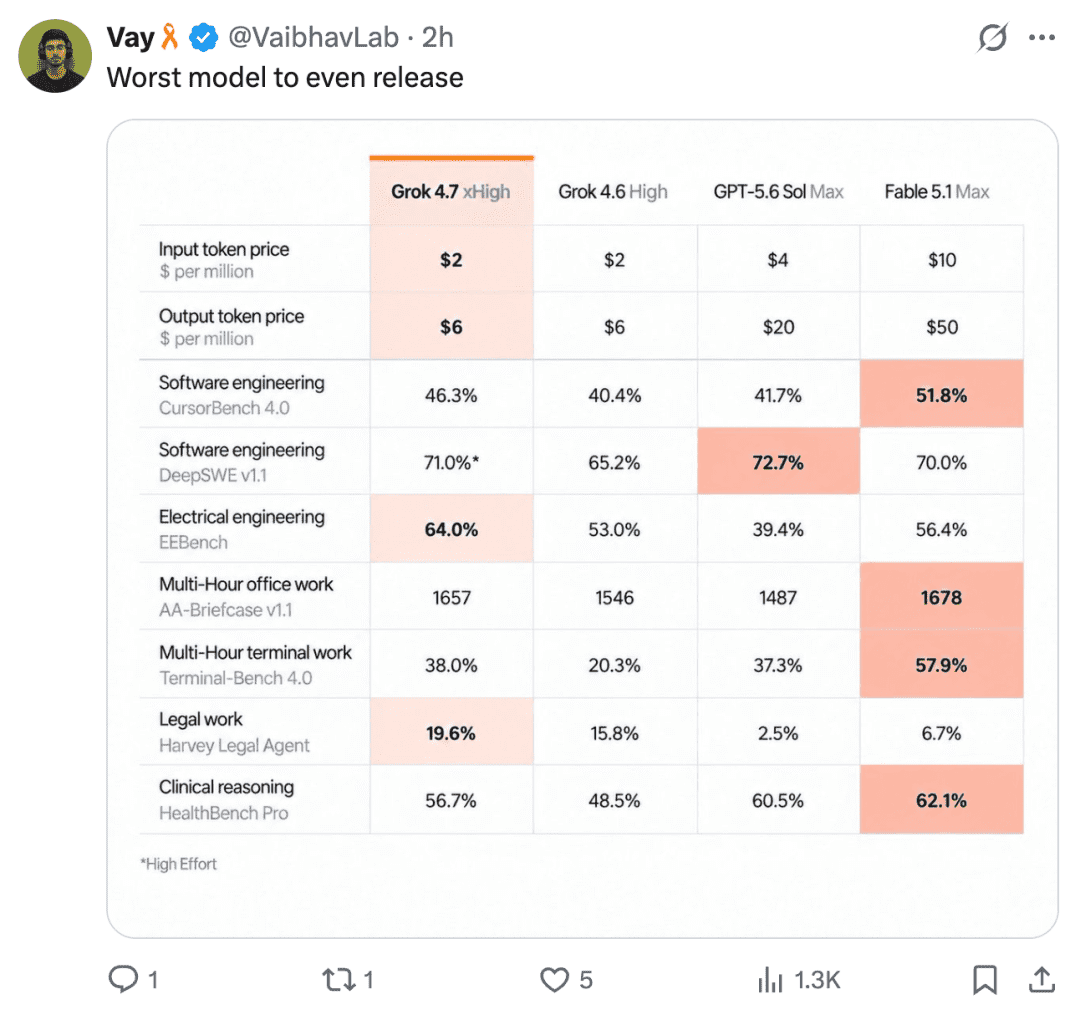
数据也支持这一说法。在专门评估长时间编码任务的 CursorBench 4.0 上,Grok 4.7 得分 46.3%,比 Grok 4.6 的 40.4% 提高了近 6 个百分点。在 Terminal-Bench 4.0(模拟终端操作)中,成绩从 20.3% 跃升至 38.0%。而在高推理强度的 DeepSWE v1.1 测试中,得分达到 71.0%。
这些数字背后,是模型能否在复杂任务中“坚持到底”的能力。SpaceXAI 甚至直接宣称:Grok 4.7 是目前在 CursorBench 4.0 上“价格与性能均处于前沿”的模型。
不只是写代码,还要做完整工作
虽然编程仍是 Grok 4.7 最突出的标签,但 SpaceXAI 明显在拓宽它的能力边界。这次评测覆盖了律师、护士、金融分析师等专业人士的日常任务,包括起草合同、整理病历、制作演示文稿、分析财报等多步骤工作流。
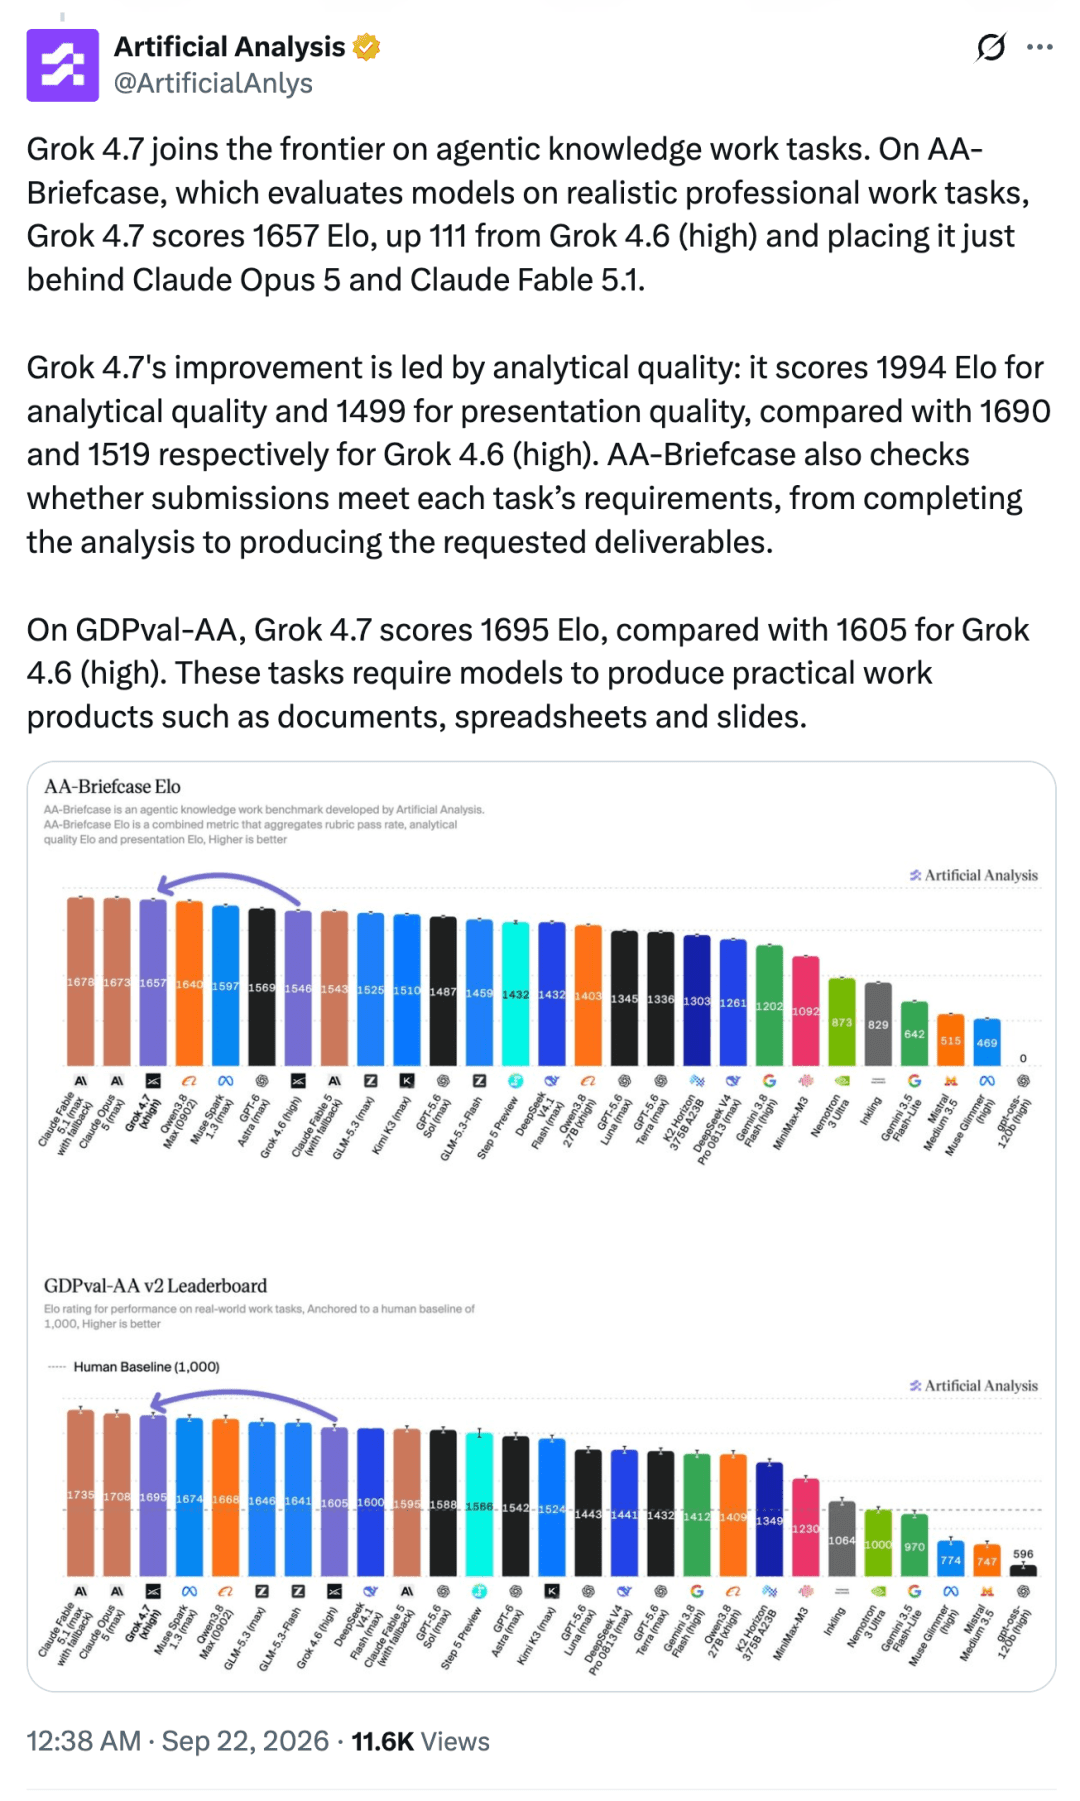
在 AA Briefcase v1.1(评估通用知识工作)中,Grok 4.7 得分 1657,高于上一代的 1546。在 GDPval(衡量实际工作产出质量)中,Elo 分数从 1605 升至 1695。官方图表显示,它已接近 Fable 5.1 的 1735 分,明显高于 GPT-6 Astra 的 1542 分。
专业领域的进步同样显著:
- EEBench(工程任务):53.0% → 64.0%
- Harvey Legal Agent Benchmark:15.8% → 19.6%
- HealthBench Professional(临床推理):48.5% → 56.7%
这些数据来自 SpaceXAI 内部对比,虽不能直接跨模型比较(因推理配置、工具调用等变量不同),但足以说明 Grok 4.7 相比前代的进化方向:从“回答问题”转向“完成整项工作”。
模型现在需要理解任务意图、调用合适工具、生成结构化文档、自行复核逻辑一致性——单一问答能力只是其中一环。Grok 4.7 延长训练任务时长、强化自我验证机制,正是为了补上这一课。
安全防护同步升级
能力增强的同时,Grok 4.7 也启用了全新的安全体系。SpaceXAI 称,这是其测试过“在拒答与抵抗越狱方面表现最强”的模型。
在生物安全基准 LatchBio 上,Grok 4.7 以 62.4% 的成绩登顶。而在网络安全测试 HackerBench v0.3 中,模型仅放行 3.3% 的高风险双重用途提示(如生成恶意代码),同时对正常的安全研究请求误拦率很低。
此外,SpaceXAI 开始向少数网络安全合作伙伴开放“邀请制红队能力”,用于防御性研究。目前这项功能仅限受控合作,尚未全面开放。
价格没涨,性价比更高
Grok 4.7 已上线 Cursor 和 Grok Build,并通过 Grok API、第三方编程框架、模型路由服务及主流云平台提供。
最关键的是定价策略:标准版维持 Grok 4.6 的价格——每百万输入 token 2 美元,每百万输出 token 6 美元。这意味着开发者无需为换代支付额外成本,就能获得更强的长任务处理能力、更稳定的上下文管理和更高的专业任务得分。
对知识工作类产品来说,模型单次调用价格固然重要,但真正决定成本的是“完成一项任务需要多少轮尝试”。如果 Grok 4.7 能减少返工次数、缩短任务周期,实际支出反而可能大幅下降。
快速版则进一步提速,官方称“速度达到可比模型的两倍”,适合对延迟敏感的场景。
用户反应两极
尽管官方数据亮眼,社区反馈却并不一致。有用户直言:“这种模型居然也敢发布,简直差到不该发布。”
这种批评或许源于过高期待,也可能反映实际体验与宣传存在落差。但 SpaceXAI 的回应很务实:Grok 4.7 的卖点并非“全面碾压竞品”,而是用远低于部分旗舰模型的 API 成本,换来相当接近、甚至在个别专业任务上领先的性能。
换句话说,它不是要当全能冠军,而是想成为那个“花一半钱,干八成活”的实用选择。
总结:把复杂工作做完
从训练方式到评测组合,Grok 4.7 的所有改动都指向同一个目标:长时间留在任务里,把复杂工作做完。
编程是它最先成熟的入口,但文档撰写、演示制作、法律分析、临床推理和工程设计已被纳入同一套能力版图。模型不再是“聪明的问答机”,而是“能干活的协作者”。
这场升级没有华丽口号,只有具体的分数提升、明确的价格锚定和对真实工作流的深入适配。至于它能否真正改变开发者和专业人士的工作方式,还得看接下来几个月的实际集成效果。