Anthropic 内部 26% 的 AI 研发已由 Claude 主导,3 万个 Agent 同时运行
AI 研发自动化的真实进展:Anthropic 给出了具体数字
过去我们讨论 AI 是否在“自我改进”,往往只能看一些间接指标:比如大模型在 HumanEval 上的得分、开发者用 Copilot 写代码的比例,或者某个 AI Agent 能连续跑多久。这些数据有用,但离真正的研发自动化还有距离。
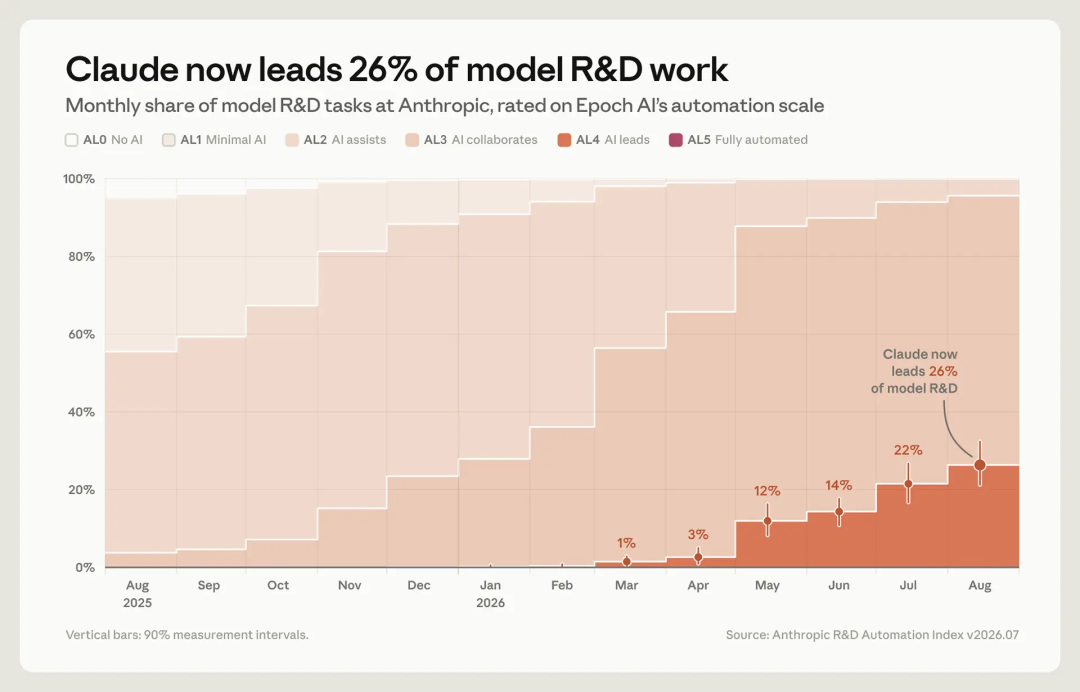
现在,Anthropic 直接给出了一个更贴近现实的答案:截至 2026 年 8 月,其内部 26% 的 AI 研发工作已经由 Claude 主导完成。与此同时,超过 90% 的研发任务至少进入了“AI 协作”阶段。这个比例在半年前还不到 1%。
这不是营销话术,而是基于一套明确的自动化等级划分。Anthropic 借用了 Epoch AI 提出的 AL0–AL5 六级框架,来衡量 AI 在研发中的参与程度:
- AL0:完全无 AI 参与
- AL1:AI 提供少量帮助(如查文档)
- AL2:AI 辅助(如补全代码片段)
- AL3:AI 协作(人类主导流程,AI 执行子任务)
- AL4:AI 主导(人类只给目标,AI 端到端完成)
- AL5:AI 完全自主(无需人类介入)
目前,Anthropic 明确表示没有任何任务达到 AL5。但 AL4 的快速普及,已经让研发模式发生了实质变化。
“把它修好”——AL4 的真实场景
Anthropic 举了一个很具体的例子来说明 AL4 和 AL3 的区别。
假设一个夜间运行的数据管道突然中断。在 AL3 阶段,工程师需要先查看日志、形成初步判断,再把上下文交给 Claude。如果过程中出现意外(比如权限问题或依赖冲突),Claude 很可能停下来,等人类决定下一步怎么做。
到了 AL4,工程师只需要把告警信息丢给 Claude,说一句:“把它修好。”
接下来,Claude 会自己:
- 分析日志,定位故障点
- 推断可能原因(如配置错误、资源不足)
- 编写修复代码
- 在沙箱中测试
- 处理测试中暴露的新问题(比如回滚机制缺失)
- 重新运行整个管道,验证修复效果
- 撰写故障复盘报告
人类最后只需审核结果,决定是否上线。整个过程不再需要“手把手指导”。
这种模式正在 Anthropic 内部快速铺开。从 2026 年 2 月到 8 月,AL4 占比从不到 1% 跃升至 26%。而 90% 以上的研发任务至少达到了 AL3,意味着 AI 已经能承担大块的具体工作。
3 万个 Agent 同时工作的“自动实验室”
比“26%”更有画面感的是另一组数据:截至 2026 年 8 月,Anthropic 使用最频繁的内部 Agent 平台上,任意时刻大约有 3 万个 AI Agent 正在执行研究或工程任务。
这些 Agent 不是孤立运行的。它们拥有持续的“身份”——即使底层模型升级,身份也不会重置。Agent 之间通过一个开放的消息系统沟通,所有消息都标明发送者,并尽量保留原始引用。
这种设计让 Agent 能像人类同事一样互动。当一个 Agent 收到另一个 Agent 的信息时,它不会盲目信任,而是将其视为“一项需要验证的主张”。这使得它们既能协作,也能互相纠错。
例如,一个负责训练监控的 Agent 发现异常指标后,可能会向推理服务团队的 Agent 发送诊断请求。后者收到后,会调用工具检查日志、分析流量,并返回结论。整个过程无需人类介入调度。
为了管理这个庞大的虚拟团队,Anthropic 建立了两层监控系统:
- 在线监控:每个 Agent 动作执行前都要通过 Monitor 检查,耗时通常几秒。2026 年 8 月,系统审查了超 10 亿次决策,仅约 0.002% 被阻止。
- 离线监控:事后分析完整行为记录,每周标记约 10 万条对话。经过多层分类器过滤,最高优先级的约 50 条/周会升级到人工审查。
Anthropic 表示,目前单个 Agent 出现严重问题的情况并不常见。
如何量化“AI 主导”的程度?
要得出“26%”这个数字,Anthropic 做了一套复杂的测量体系,称为 R&D Automation Index。
方法是从公司内部的 Slack 消息、文档、工单等数据源入手。在 2026 年 7 月的每一周,他们随机抽取 20% 参与模型研发的员工,让 Claude 分析这些人一周内做了哪些具体任务。
最终,Claude 整理出约 1.5 万项研发活动,并将它们组织成一棵包含 542 个节点的“研发任务树”。其中 378 个是最底层的具体任务,比如:
- 评测平台故障诊断
- RL 沙箱网络策略配置
- 推理服务事故复盘
- 数据集版本对齐
接着,另一个 Claude Agent 会调查每类任务的实际执行流程:哪些步骤由人做,哪些已交给 AI。最后,一个独立的 Claude Judge 读取所有证据,为每项任务打上 AL0–AL5 的标签。
Anthropic 承认这套方法存在主观性,尤其是 AL3 和 AL4 的边界。他们呼吁未来若多家公司公布类似数据,应统一标准并引入第三方验证。
算力分配:安全研究占 AI 研发算力的 12%
除了任务自动化程度,Anthropic 还公布了算力使用情况。他们抽样了 2026 年 7 月 13 日至 20 日这一周的数据,将用于 AI 研发的计算资源按用途分类。
结果显示:
- 整体 AI 研发算力中,约 6% 用于安全研究
- 在“由 AI 驱动的 AI 研发”部分,安全研究占比升至约 12%
这说明随着自动化程度提高,Anthropic 也在同步增加对安全的投入。毕竟,当数万个 Agent 同时运行时,哪怕极低的错误率也可能累积成风险。
人类的角色正在快速转变
这些数据共同描绘出一个正在成型的“人机混合研发体系”:
- 人类:提出问题、设定目标、审核结果、做最终决策
- AI Agent:执行实验、写代码、调试系统、互相委派任务、生成报告
- 监控系统:实时拦截异常行为,事后审计高风险操作
Anthropic 仍强调,目前没有任务达到 AL5——即 AI 完全自主发现、定义并解决新问题。但趋势已经很明显:从 AL4 占比半年增长 26 倍的速度看,到 2026 年底,这一比例可能接近 80%。
这直接关系到 AI 领域最核心的议题之一:递归自我改进(Recursive Self-Improvement, RSI)。如果 AI 能持续、高效地改进自身研发流程,那么技术进步的节奏可能不再由人类工程师的数量决定,而是由算力、数据和算法效率驱动。
Anthropic 自己就是最谨慎的观察者。作为一家长期担忧 AI 风险的公司,他们一边推进自动化,一边加强监控和安全投入。这种矛盾恰恰说明:RSI 的门槛正在被实际跨越,而不仅仅是理论讨论。
下一次他们更新这个数字时,或许我们会看到一个更接近“自动实验室”的图景——人类依然掌握方向盘,但油门已经交给了 AI。