TrOPD:用信任域让小模型更稳地学大模型推理能力
端侧智能的瓶颈:小模型怎么学得动大模型?
GPT-6 这类大模型的能力还在快速提升,但推理成本也水涨船高。当 AI 从云端走向手机、平板、智能家居这些终端设备时,光“聪明”不够,还得塞进有限的内存、满足功耗和延迟要求。

对拥有数亿终端的三星来说,这个问题更直接:怎么用更小的模型、更低的成本,把前沿 AI 能力带到更多设备上?这不仅关系到 AI 能覆盖多少场景,也直接影响服务成本和用户体验。
On-Policy Distillation(OPD)是解决这个问题的重要路径。它不像 GRPO 那样靠奖励让模型自己摸索,而是让小模型(学生)直接模仿大模型(教师)的每一步推理过程。理论上,这能更高效地传递复杂能力,比如多步数学推导或长代码生成。
但现实没那么理想。当教师和学生能力差距太大时,教师给出的监督信号可能失真,甚至导致训练崩溃。最近,三星大模型团队联合牛津大学、北京大学提出了 Trust Region On-Policy Distillation(TrOPD),试图从根源上解决这个问题。
OPD 的真实痛点:不是公式不对,是信号不可信
过去关于 OPD 的研究,常常在不同设定下比较方法,比如训练步数、KL 散度估计方式都不统一,很难判断哪种改进真正有效。这篇论文先把主流 OPD 方法拉到同一套实验环境下系统测了一遍,结果发现:
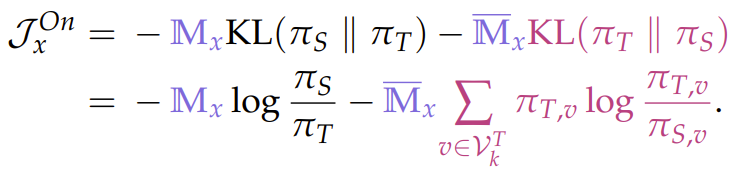
决定 OPD 成败的关键,不是用 FKL、RKL 还是 JSD,而是教师能否对学生生成的每一个 token 给出可靠监督。
一旦学生和教师的输出分布相差太远,监督信号本身就歪了,再精巧的散度公式也救不回来。
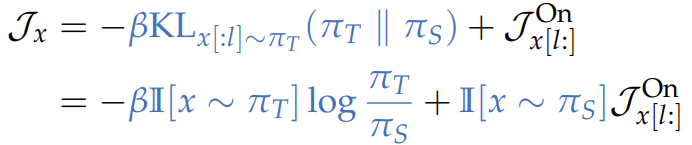
要理解这一点,得先看 OPD 怎么打分。全词表方法(如 GKD)在整个词表上算 KL 散度,信号完整但显存开销巨大(O(n·k),k 是十万级词表)。为省显存,Thinking Machines Lab 提出 K1 估计器:只在学生实际采样的那个 token 上计算一次 KL。
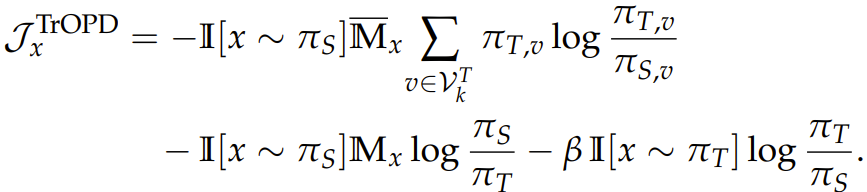
这确实把显存从 O(n·k) 压到 O(n),但带来了两个优化瓶颈:
第一,策略梯度离群点。 梯度更新幅度大致是“奖励 × 对数概率梯度”。如果学生采样到一个教师几乎不认可的 token(概率趋近 0),奖励会冲向负无穷,单次更新就可能被这个“倒霉”token 主导,压过成百上千个正常 token 的总和。
第二,监督信号失真。 当学生跑偏太远,教师给出的概率分布已经不能反映“正确方向”,此时继续用这个信号训练,等于在错误的方向上猛踩油门。
这两个问题说明:K1 估计器解决了显存问题,却把“监督是否可靠”这个隐患彻底暴露了出来。
现有方法都在改什么?效果如何?
面对这些问题,现有工作主要沿两条路修补:
一是换散度公式。 RKL(反向 KL)在学生分布上取期望,会惩罚“学生有、教师无”的区域,导致学生被牢牢锁在教师主模式里(mode-seeking)。有人因此改用 FKL,在教师 top-k 词上求和;也有人用 JSD 做对称折中。
二是筛 token,不改公式。 比如只保留熵最高的前 20% token(受高熵 GRPO 启发);或者像 REOPOLD 那样给奖励设下限,低于阈值 τ 就抬到 τ;更激进的是直接 mask 掉离群 token 的梯度。
这些方法听起来都合理,但没人把它们放在同一套教师、学生、训练配置下公平比较过。
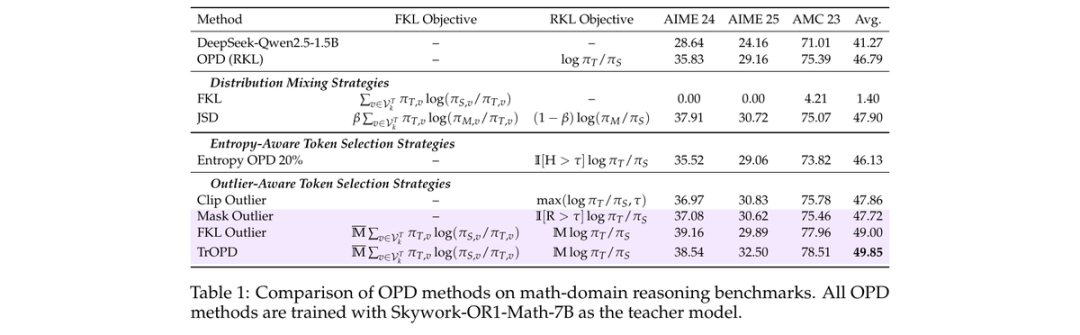
论文做了这个诊断实验:用 Skywork-OR1-Math-7B 当教师,DeepSeek-Qwen2.5-1.5B 当学生,在数学推理任务上跑一遍。结果很有意思:
- 单独用 top-k FKL 几乎训不动,说明截断估计仍有偏差;
- 按熵筛选 token 反而拖后腿(46.13 vs 基线 46.79),因为教师在低熵 token 上同样能提供有效监督;
- 奖励裁剪(Clip Outlier)和 mask(Mask Outlier)确实有效,平均分提升约 1 点,但依赖人工设定的阈值 τ,无法自适应。
三条现象指向同一个结论:判断监督是否可靠,不能看散度公式或熵,而应直接衡量教师和学生在该 token 上的分歧程度。 裁剪/mask 已经摸到了正确方向——用奖励大小筛选,值得深挖。
TrOPD:只在“信得过”的地方学
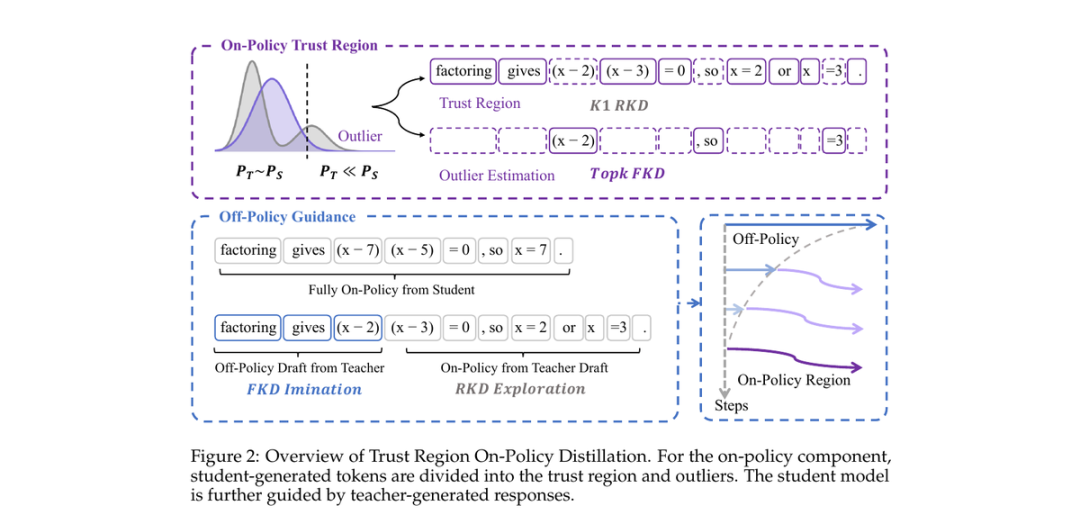
TrOPD 的思路很直接:借鉴强化学习里的信任域策略优化(TRPO),只在教师信得过的区域做常规在策略学习,离群区域换一套更保守的监督。
具体怎么做?首先定义一个信任域掩码 M:M=1 表示该 token 落在信任域内,M=0 表示离群。单个 token 的训练目标写成:
- 信任域内:继续用原来的 K1 反向 KL;
- 离群区域:换成基于教师 top-k 词表的前向 KL。
那怎么判断一个 token 是否可信?论文借用了投机解码的思路:把学生当“草稿模型”,教师当“目标模型”,用下面这个比值作为落入信任域的概率:
$$ \frac{\pi_T(x_t)}{\pi_S(x_t)} $$
比值越接近 1,说明教师越认可,留在信任域;比值越小,说明教师本就不认,换成前向 KL 更稳妥,避免引入破坏性梯度。
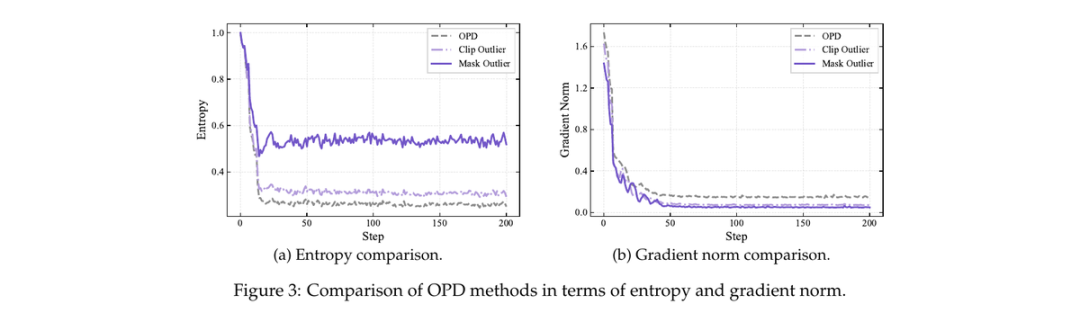
这个设计在训练曲线上效果明显:相比原始 OPD 和 Clip Outlier,Mask Outlier 的策略熵更高(探索能力保留更好)、梯度范数更低更稳。OPD 的熵几十步内就从 1.0 跌到 0.2~0.3,而 Mask Outlier 稳定在 0.5 左右。这说明“抑制离群梯度”确实减少了破坏性更新。
但 TrOPD 不止于此——它还给离群区域补了一个前向 KL 目标:
$$ D_{\text{FKL}}(\pi_T^{\text{top-k}} | \pi_S) $$
只要学生在教师 top-k 词上还留有一点概率,这一项就会产生梯度,推动学生朝教师最认可的方向靠拢;若完全不沾边,该项会趋向无穷大,但实现中会随学生概率趋于 0 自动被抑制,不干扰信任域内的正常训练。
再加一道“离策略引导”:主动把学生拉进信任区
前面的信任域划分是“事后诊断”:先让学生生成,再判断是否可信。但如果学生一开始就跟教师差很远,大量 token 会被划进离群区。
TrOPD 反过来在生成起点上做文章:学生的续写先接上教师生成的一段前缀,用前向 KL 做模仿学习;之后的部分才切回学生自己生成,继续走信任域机制。

这样,续写接着教师语境往下,后续 token 落入信任域的概率自然提高。不再是被动等离群 token 出现再补救,而是主动引导探索方向。

教师前缀长度 l 在训练初期设为最大长度,之后按余弦调度退火到 0,学生独立生成比例逐步提高,直到完全变成纯粹的在策略生成。这样既避开了初期“自由生成、信任域所剩无几”的高风险阶段,又能在后期放手让信任域机制自我调节。

把三部分合起来,就是 TrOPD 的完整目标函数:信任域内的反向 KL + 离群区域的前向 KL + 离策略引导的前向 KL。

实验结果:全面领先,尤其在难啃的场景

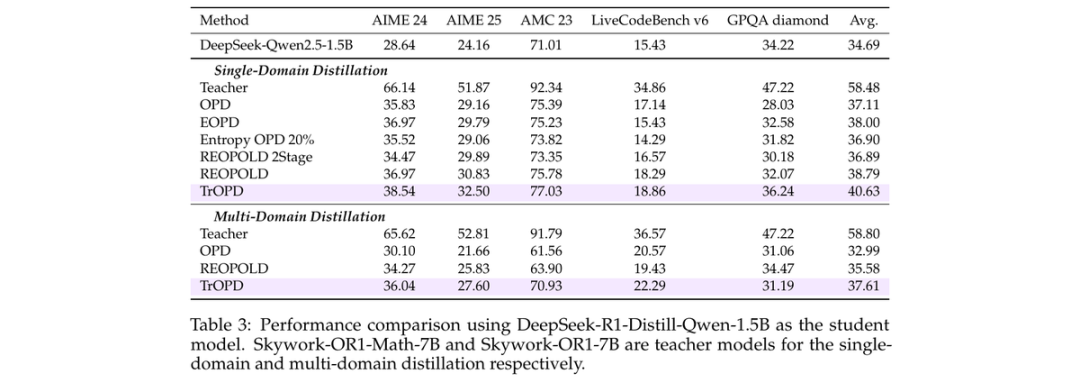
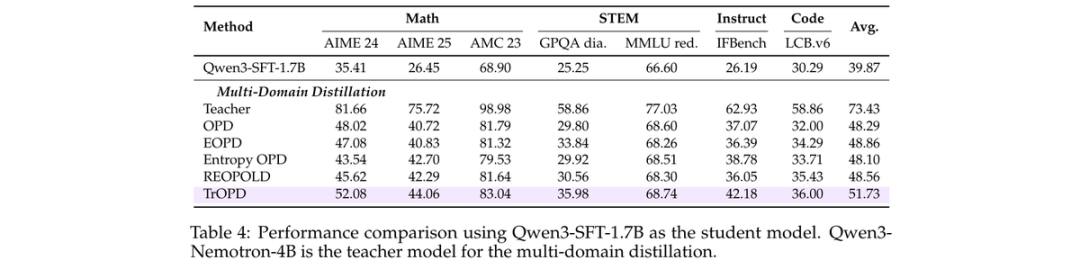
论文在单领域(仅数学)和多领域(数学+代码+科学)两种设置下做了系统评测,学生模型分别用 DeepSeek-R1-Distill-Qwen-1.5B 和更强的 Qwen3-SFT-1.7B。

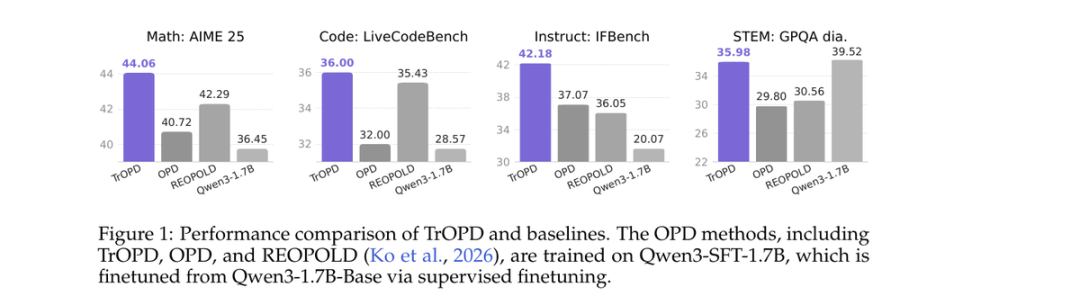
在 Qwen3-SFT-1.7B 上,TrOPD 在四个基准上全面超过现有方法:

- 数学(AIME 25):+3.34 分
- 代码(LiveCodeBench):+4.00 分
- 指令遵循(IFBench):+5.11 分
- STEM(GPQA):+6.18 分

有两个规律特别值得注意:

第一,提升能泛化到未训练领域。 单领域只用数学题训练,但 TrOPD 在完全没练过的代码和 STEM 任务上提升幅度反而更大(+2.63 vs +3.06)。这说明信任域机制提升了监督信号的整体可靠性,这种优化质量自然泛化到其他任务。
第二,教师学生差距越大,TrOPD 优势越明显。 多领域设置下,OPD 基线平均分从 37.11 掉到 32.99(跌 4.12 分),而 TrOPD 从 40.63 掉到 37.61(只跌 3.02 分),相对优势从 +3.52 扩大到 +4.62。这正契合端侧部署的常态:小模型要在巨大能力鸿沟下尽可能承接大模型能力。
回归本质:监督信号的可靠性才是关键
TrOPD 的意义,不在于提出一个新公式,而在于把 OPD 的关注点从“用哪种 KL”转向“监督是否可信”。它用教师与学生的实际分歧程度作为判据,自适应调整学习策略,为 OPD 建立了一套有理论依据的稳定机制。
在端侧 AI 持续 Scaling 的背景下,这种对监督信号可靠性的重视,可能会成为未来高效蒸馏的核心方向。毕竟,当模型越来越小、任务越来越复杂,我们不能再指望“随便模仿”就能学到精髓——得知道什么时候该信老师,什么时候该自己小心试探。