AI Agent 的核心能力循环:感知、规划、执行、反思与记忆的工程实现
AI Agent 为什么需要一个循环?
传统的 LLM 应用是线性的:用户输入 → Prompt 拼接 → LLM 生成 → 返回结果。这本质上是把大模型当成一个“高级函数”来用。但现实任务往往复杂得多。
比如你让 Agent “帮我分析上个季度的销售数据,找出下滑最严重的区域,并生成一份包含建议的报告”。这个任务涉及多个步骤、状态传递、错误重试和结果判断。线性流水线无法应对这种复杂性,你需要的是一个持续运转的认知循环。
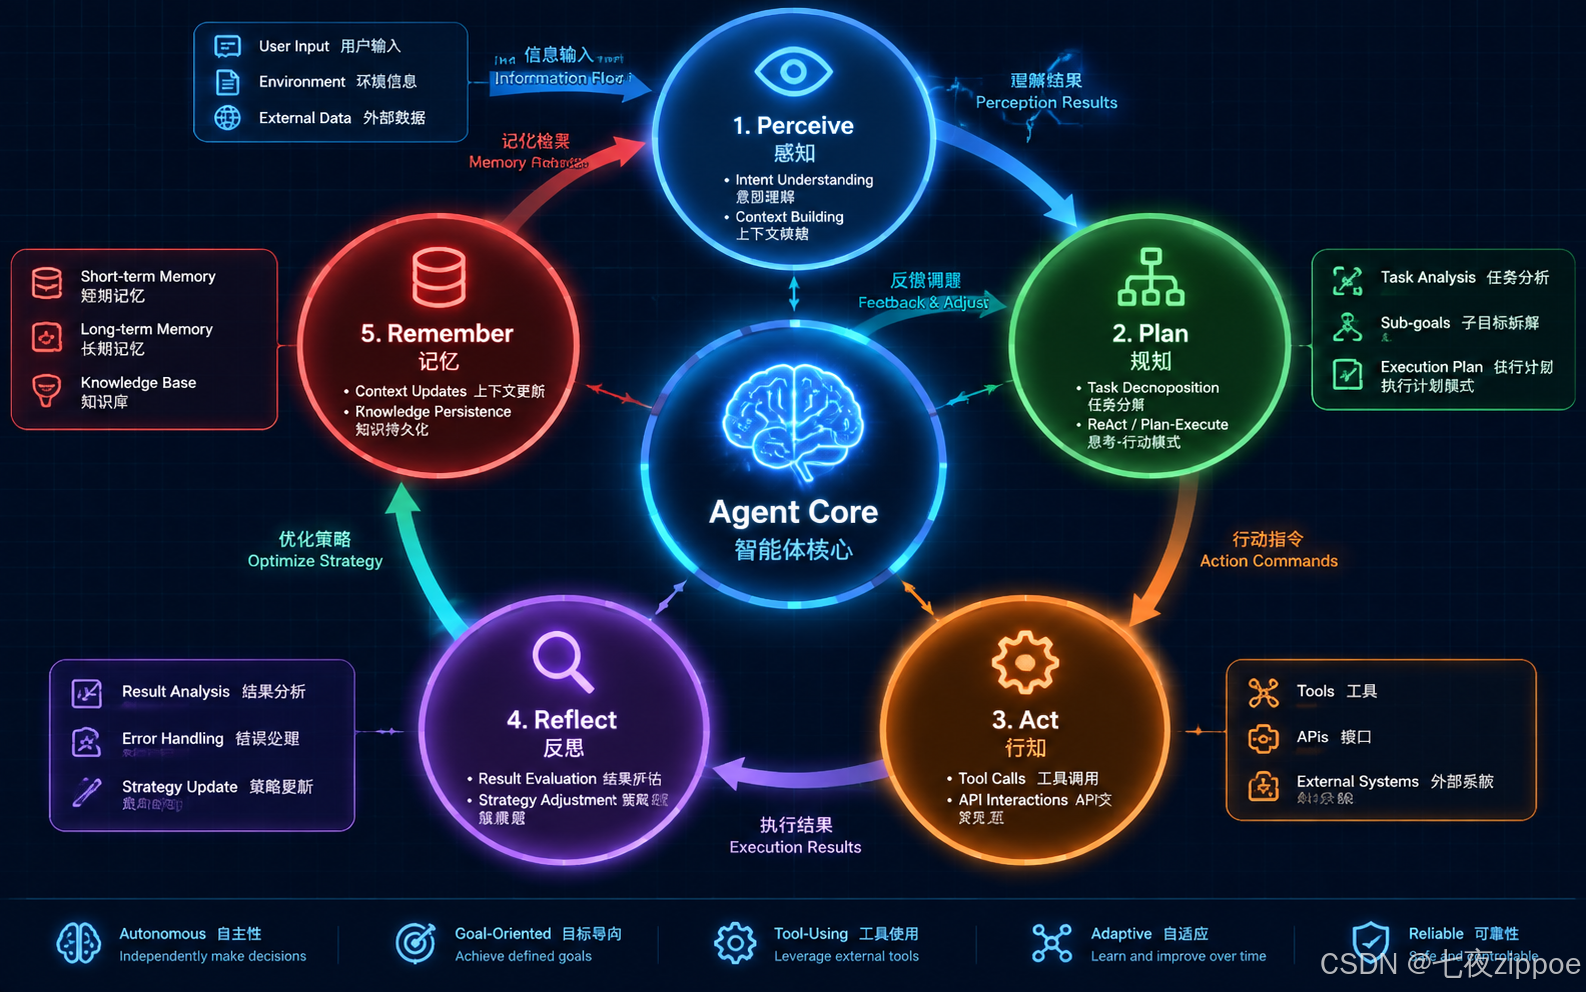
这个循环包含五个阶段:
- 感知(Perceive):理解用户意图与环境状态
- 规划(Plan):拆解任务路径,决定下一步做什么
- 执行(Act):调用工具完成具体操作
- 反思(Reflect):评估结果,分析失败原因
- 记忆(Remember):将经验沉淀为可复用的知识
这五个阶段不是单向流水线,而是一个闭环系统。每一次循环,Agent 都在更新上下文、调整策略、积累经验。循环的终止条件包括任务完成、达到最大迭代数、资源耗尽或人工干预。
感知:不只是“读懂用户说了什么”
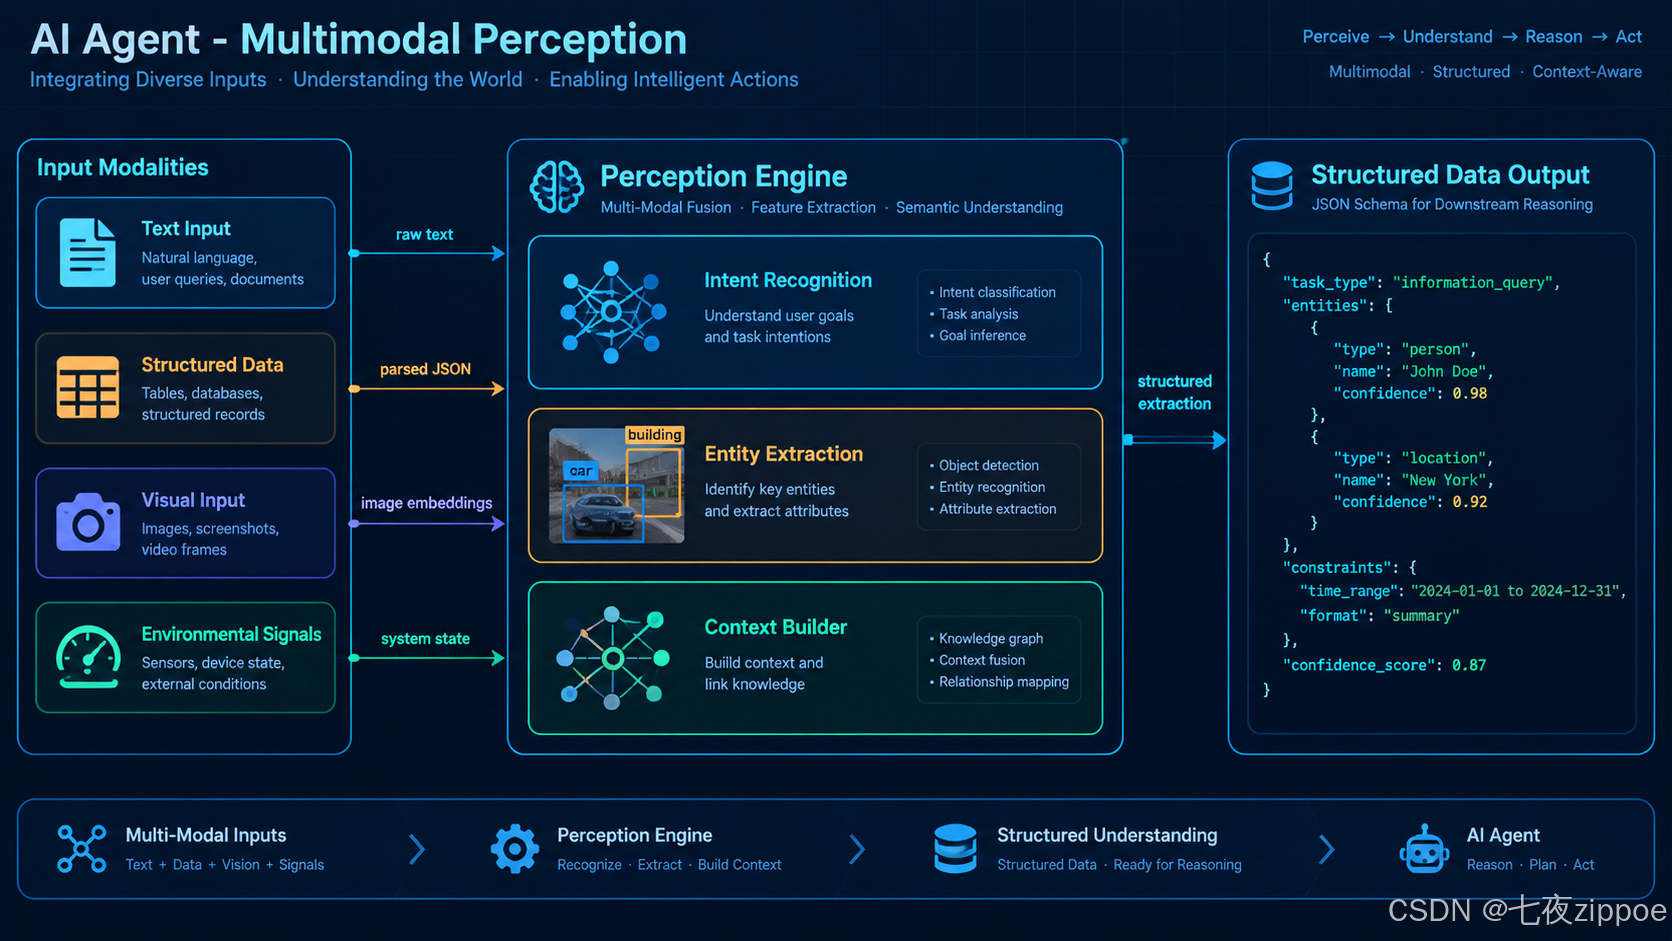
感知是 Agent 认知循环的入口,决定了它对问题的理解深度。一个优秀的感知模块需要完成三件事:
- 意图识别:用户想要什么?是查询、创建、分析还是混合任务?
- 实体提取:任务涉及哪些具体对象?文件名、时间范围、数据源等。
- 上下文构建:当前对话历史、用户偏好、环境状态是什么?
工程上,可以用 Pydantic 定义结构化输出,确保 LLM 返回的意图信息是强类型的、可验证的。例如:
from pydantic import BaseModel, Field
from enum import Enum
class TaskType(str, Enum):
QUERY = "query"
CREATE = "create"
ANALYZE = "analyze"
MODIFY = "modify"
MIXED = "mixed"
class PerceivedIntent(BaseModel):
task_type: TaskType
primary_goal: str
entities: list[str] = Field(default_factory=list)
constraints: list[str] = Field(default_factory=list)
confidence: float = Field(ge=0.0, le=1.0)
needs_clarification: bool = False
clarification_question: str = None当置信度低于阈值(如 0.6)时,自动触发澄清流程,避免 Agent 在错误理解的基础上空转。实际生产中,还应加入 RAG 检索结果作为额外上下文。
现代 Agent 的感知也不应局限于文本。一个完整的感知系统可能需要同时处理文本输入、结构化数据、视觉内容(如截图、图表)以及环境信号(时间、位置、系统状态)。
规划:三种主流模式对比
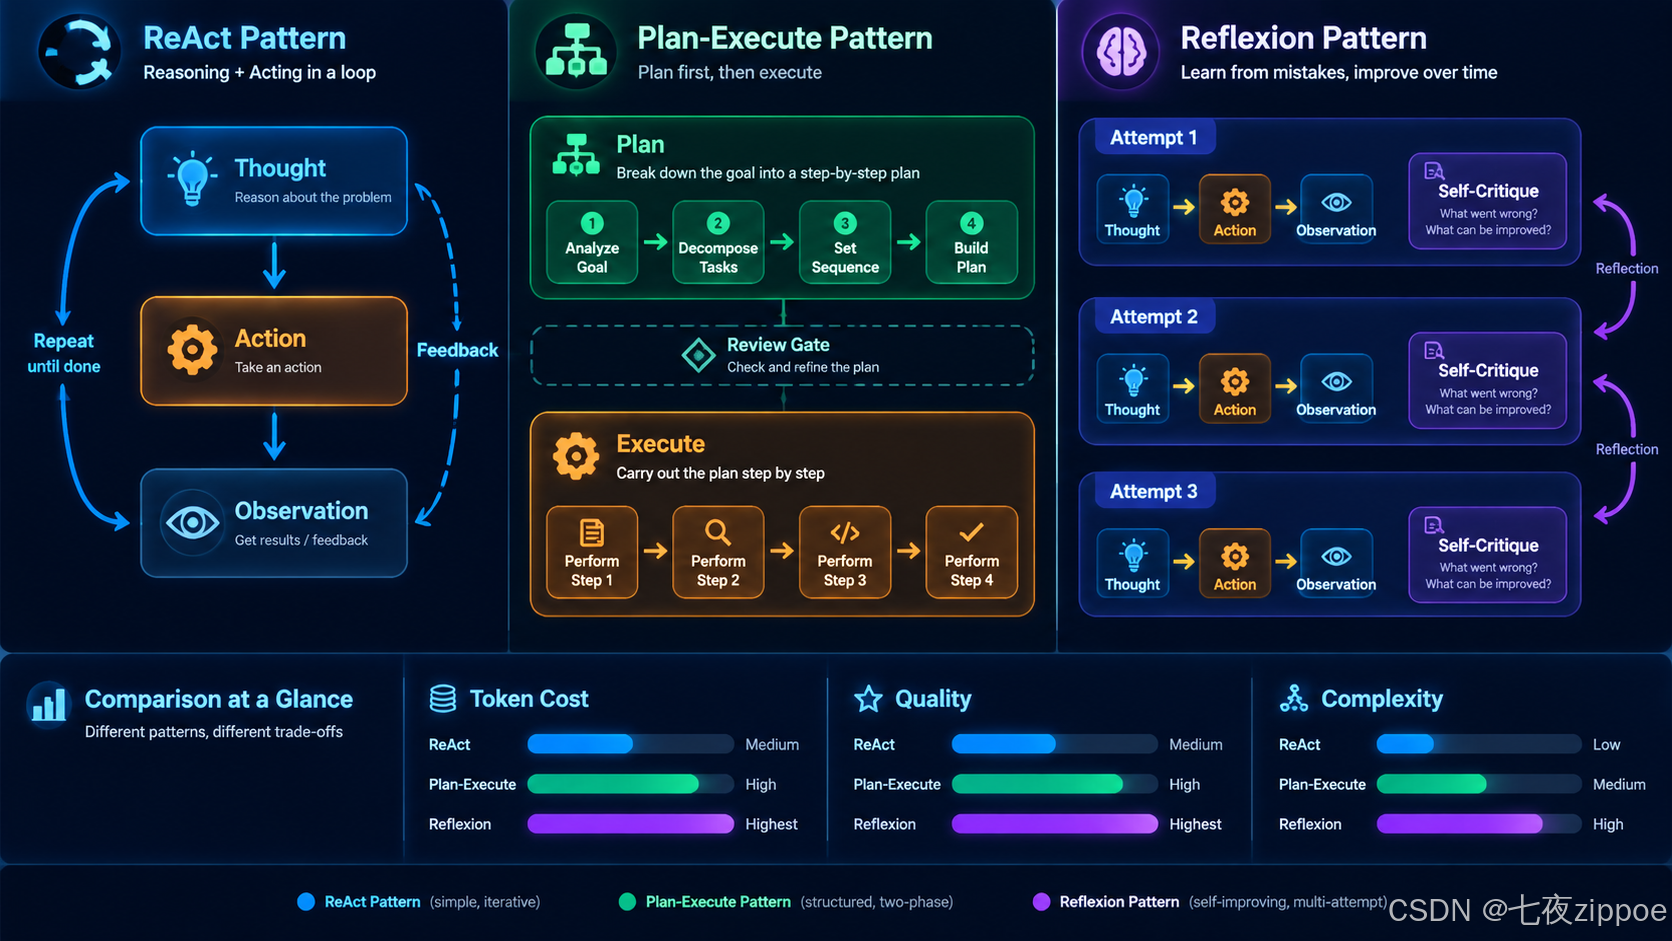
规划是 Agent 的“大脑”,决定如何从当前状态到达目标状态。当前主流有三种模式:
ReAct:边想边做
ReAct(Reasoning + Acting)是最经典的模式。LLM 在每一步都先“思考”再“行动”,交替进行推理与工具调用。适合简单工具调用和快速原型。
优势是实现简单,错误能即时调整;缺点是规划质量受限于单步推理,复杂任务容易迷失方向。
Plan-Execute:先规划后执行
将规划和执行解耦:先用一个 Planner LLM 生成完整多步计划,再用 Executor LLM 逐步执行。适合复杂多步任务,且计划可人工审查。
优势是规划质量更高,步骤间依赖关系清晰;缺点是 Token 消耗高(需两次 LLM 调用),且一旦计划错误,整个执行链都会偏离。
Reflexion:反思驱动的自我改进
在 ReAct 基础上增加显式的“自我反思”阶段。Agent 在每次尝试后评估表现,生成自我批评,并在下一轮利用这些批评改进策略。
这实质上是一种语言层面的梯度下降——用自然语言描述改进方向,而不是更新模型权重。适合对质量有高要求但成本可接受的场景。
选择哪种模式,取决于任务复杂度、成本预算和质量要求。没有绝对最优,只有最适合当前场景的方案。
执行:工具调用的健壮性设计
执行层是 Agent 与外部世界交互的唯一通道。无论规划多么精妙,最终都要通过执行层落地。一个健壮的执行层需要五大能力:
- 工具注册:通过装饰器自动从函数签名生成 JSON Schema
- 参数校验:确保输入符合工具要求
- 超时控制:防止长时间阻塞
- 重试退避:网络波动时自动重试,采用指数退避策略
- 并行执行:对无依赖关系的步骤并发调用,提升效率
例如,工具注册框架可以这样设计:
@registry.register(name="search_web", description="搜索网页获取最新信息")
async def search_web(query: str, max_results: int = 5) -> dict:
# 实际调用搜索 API
return {"query": query, "results": [...]}ToolRegistry 自动解析函数签名,生成 OpenAI function calling 兼容的 Schema,实现与 LLM 的无缝对接。并行执行则基于依赖图进行拓扑排序,用 asyncio.Semaphore 控制最大并发数,防止 API 限流。
反思:从“执行机器”到“学习机器”
如果说感知、规划、执行是 Agent 的“一线能力”,那反思就是它的“元认知”——对自己思考过程的思考。
没有反思的 Agent 是一个“执行机器”,可能反复犯同样的错误。有反思的 Agent 是一个“学习机器”,能从失败中提取经验。
反思阶段需要回答四个问题:
- 结果是否达成目标?(质量评估)
- 哪些步骤出了问题?(归因分析)
- 为什么会出错?(根因分析)
- 下一步该怎么调整?(策略更新)
工程上,可以用枚举定义常见根因类型:
planning_error:计划本身有逻辑问题tool_failure:工具调用失败perception_error:对用户意图理解有误insufficient_info:缺少必要信息
每种根因对应不同的调整策略:重新规划、换工具重试、回到感知阶段重新理解需求等。当评分极低且根因是感知错误时,强制回退到感知阶段,这是一种安全网设计。
记忆:三层架构模拟人类记忆
Agent 的记忆系统也遵循类似人类的三层架构:
- 工作记忆(Working Memory):当前循环的上下文,直接注入 Prompt,生命周期为单次循环
- 短期记忆(Short-term Memory):保存最近的交互记录,生命周期为单次会话
- 长期记忆(Long-term Memory):存储在向量数据库中,永久保存,支持跨会话检索
工程实现上,AgentMemory 类管理这三层:
- 工作记忆用字典维护,直接用于 Prompt 注入
- 短期记忆用列表保存,超出容量时触发摘要压缩,将旧记忆合并后存入长期记忆
- 长期记忆通过向量检索,支持语义查询
记忆的写入要有选择——通过 importance 参数控制持久化策略。重要度 ≥0.7 的记忆同时写入长期记忆,模拟“重要的事情更容易记住”的机制。失败比成功更重要(重要度设为 0.8 vs 0.5),因为失败的经验更能指导未来。
完整循环:端到端代码示例
将五个阶段整合为一个完整的 Agent 循环引擎:
class AgentCore:
async def run(self, user_input: str) -> str:
# 阶段1:感知
intent = await self.perceive(user_input)
if intent.needs_clarification:
return intent.clarification_question
# 主循环
for iteration in range(self.config.max_iterations):
# 阶段2:规划(按需)
if not current_plan or needs_replan(last_reflection):
current_plan = await self.plan(intent)
# 阶段3:执行(并行)
results = await self.execute(current_plan)
# 阶段4:反思
reflection = await self.reflect(results, intent.primary_goal)
# 阶段5:记忆(嵌入各阶段)
await self.memory.remember(...)
# 判断是否完成
if reflection.score >= threshold:
return extract_final_output(results)
# 根据反思调整策略
if reflection.adjustment == "re_perceive":
intent = await self.perceive(user_input)
current_plan = None关键设计点:
- 记忆操作嵌入在每个阶段中,而非独立成步
- 失败经验比成功经验更重要
- 动态决定是否重新规划,而不是盲目执行原计划
- 所有配置参数(如
max_iterations、reflection_threshold)均可调,便于平衡成本与质量
适用边界与风险提示
Agent 核心循环是一把重武器,不是所有场景都需要。推荐用于多步骤、工具组合、路径不确定的任务;不推荐用于单轮问答、固定流程或实时性要求极高的场景。
主要风险包括:
- 成本失控:每轮多次 LLM 调用,Token 消耗线性增长。缓解:设置硬性预算上限,用便宜模型做反思。
- 幻觉传导:Agent 可能“说服自己”错误答案正确。缓解:引入外部验证,或在反思 Prompt 中注入“质疑者”角色。
- 记忆污染:长期记忆存储错误信息。缓解:记忆写入前交叉验证,区分“事实”和“推测”类型。
- 工具安全:调用不该调的工具导致副作用。缓解:对有副作用的工具实现确认机制,硬性参数校验。
- 死循环:陷入“失败→重试→再失败”循环。缓解:强制迭代上限,记录失败模式,多次相同失败后退出。
总结
AI Agent 的核心能力循环——感知、规划、执行、反思、记忆——是一个有机的、自适应的认知系统。Agent 的质量不是由最强的那个阶段决定的,而是由最弱的那个阶段决定的。
工程实践的关键是五个阶段的均衡发展和协同优化:
- 感知要深,主动澄清比盲目执行更有价值
- 规划要准,根据任务选对模式
- 执行要稳,健壮性设计是可靠性上限
- 反思要狠,根因分析才能真正改进
- 记忆要智,三层架构支撑跨会话连续性
最终,这个循环让 Agent 从“会聊天的工具”进化为“能自主解决问题的智能体”。