无问芯穹联合清华、上交开源端侧推理引擎APXInf,Pi 0.5在Jetson Thor延迟降至26ms
具身智能落地卡在“最后一公里”
现在的具身模型已经能看懂环境、理解指令,并把感知信息转化为机器人动作决策。但要让机器人在真实世界连续干活,光有“聪明的大脑”还不够——从眼睛看到、大脑决策到手脚动起来,整个闭环必须在极短时间内完成。几百毫秒的延迟对聊天机器人只是体验差异,对机器人却可能导致动作迟滞、轨迹断裂,甚至任务失败。
更现实的问题是:当模型从云端搬到机器人本体,首先遇到的不是“够不够聪明”,而是推理系统能不能扛住端侧的严苛条件。比如:模型能不能开机秒加载?有限算力能不能榨干?每次推理延迟低到不拖后腿?开发环境跑得好好的,到了机器人上会不会翻车?
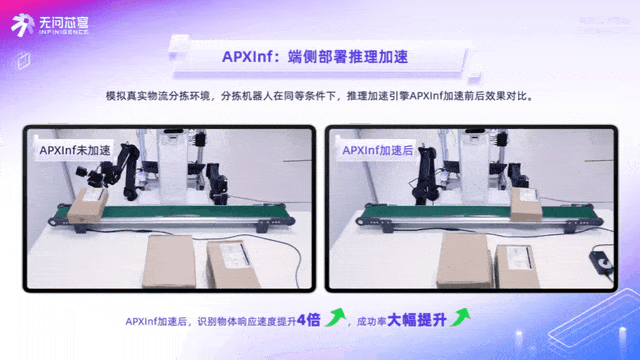
规模化落地还叠加一笔经济账:算力成本、功耗、硬件资源利用率。这意味着不能简单把云端推理框架“搬”到机器人上,而需要一套真正为端侧设计的推理系统——在有限算力、功耗和成本下,兼顾小Batch、低延迟、持续实时交互,并充分挖掘硬件性能上限。
APXInf:专为机器人端侧打造的推理引擎
今天,无问芯穹联合清华大学、上海交通大学正式开源具身智能端侧推理引擎APXInf。它覆盖从模型开发、效果验证到机器人部署的完整链路,目标不只是让模型“跑起来”,更要在有限资源下“跑得快、跑得稳、容易接、能迭代”。
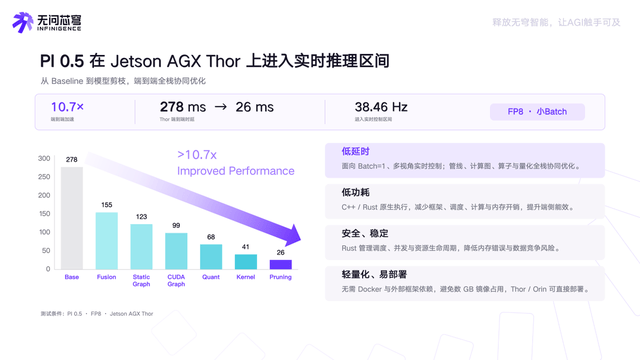
目前APXInf已实现关键突破:在Jetson Thor上,Pi 0.5模型使用FP8量化后,端到端推理延迟从278ms降至26ms以内,推理频率达38.46Hz,完全满足机器人多场景实时控制需求。10.7倍的延迟下降,意味着更快的“感知-决策-动作”闭环,让具身模型真正进入实时工作状态。
更快:端到端优化,性能SOTA
APXInf的“快”不是追求单个算子峰值性能,而是围绕机器人真实执行链路做端到端优化。通过Pipeline、Graph、Kernel及量化等多层协同,降低整体推理延迟。其核心在于:
- 利用冗余特性设计定制化运行时,在轻量化的同时极致挖掘性能;
- 结合Agent4Kernel技术,生成极限优化的融合算子;
- 针对小Batch、连续推理场景调优,而非仅关注吞吐量。
这种优化直接反映在数据上:Pi 0.5 FP8在Jetson Thor上延迟压到26ms内,频率超38Hz。这对需要高频响应的抓取、避障、导航等任务至关重要。
更稳:Rust运行时保障长期可靠
机器人推理不是“跑一次就行”,而是长时间连续运行,同时处理感知、推理、控制多个模块。最怕的不是偶尔慢一点,而是运行中抖动、异常、中断,甚至因内存或资源管理问题导致系统崩溃。
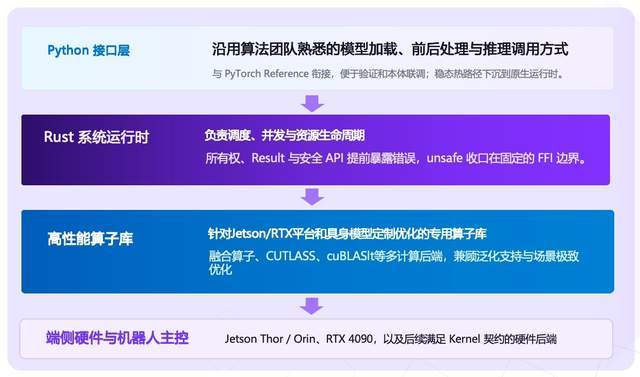
APXInf为此采用创新架构:用Rust系统语言构建极简运行时,搭配Python易用接口。
- Rust的内存安全特性从源头规避常见错误,提升稳定性;
- 极简化运行时降低开销,同时做到可核查、可验证;
- Python封装保留开发者熟悉的调用方式,平衡底层性能与上层易用。
这种设计让APXInf在真实部署环境中具备可预测性和持续运行能力,避免“实验室能跑,现场掉链子”的尴尬。
更敏捷:面向Agentic Engineering的新范式
除了跑得快、跑得稳,APXInf还关注一个更长远的问题:面对不断演进的具身模型(如VLA、VLM、世界模型),如何让新模型快速接入并持续优化?
传统推理引擎往往在性能和接入效率间难以兼顾。APXInf从设计之初就以适配Agentic Engineering流程为目标,通过冗余特性、功能隔离、工具箱模型等方法,显著提升与Agentic研发范式的契合度。
这意味着开发者可以利用代码Agent快速完成新模型适配,把Token高效转化为生产力。APXInf希望推动推理引擎从“被动执行Runtime”转变为“连接模型、硬件、机器人与开发者的Agentic Infra”,成为持续演进的基础设施。
开源现状与路线图
APXInf首发支持两款具身模型:Pi 0.5和WALL-OSS。硬件方面覆盖Jetson Orin、Jetson Thor及桌面级RTX 4090,并提供统一的模型接入接口。
未来路线图包括:
- 扩展支持更多模型类型,如VLA、VLM、世界模型(Qwen、Groot已在适配);
- 持续优化重点开源模型,扩充SOTA列表;
- 推进nvfp4极致性能优化;
- 拓展国产化生态,支持国产芯片和机器人操作系统;
- 适配AMD等主流芯片平台。
衔接RLinf,打通训练到部署全链路
APXInf并非孤立项目,而是RLinf开源生态的端侧延伸。2025年9月,无问芯穹联合清华团队开源了全球首个面向具身智能的大规模强化学习训练框架RLinf,专为具身大模型后训练设计。
如今APXInf补上了关键一环:将训练好的模型高效部署到机器人本体。两者共同构成从模型训练、效果验证到本体部署、真实运行的完整工程链路。开发者可在同一技术生态内完成全流程,避免训练与部署脱节。
邀请社区共建
APXInf第一版只是起点。无问芯穹希望与具身模型开发者、机器人团队和端侧系统工程师一起,把模型接入、运行优化和本体部署沉淀为标准化、可复用、适合代码Agent参与的开发流程。
如果你正在:
- 尝试将Pi 0.5等模型部署到机器人本体;
- 基于RTX 4090、Jetson Thor或Orin开发项目;
- 为新具身模型寻找端侧推理方案;
- 希望参与Skill接入和Agentic部署流程建设;
欢迎体验APXInf、提交Issue或贡献PR。项目已在GitHub开源,提供Quick Start指南,降低入门门槛。
具身智能的规模化落地,需要的不仅是更强的模型,更是扎实的工程基础设施。APXInf试图解决的,正是从“模型会做什么”到“机器人真正做出来”之间的那道鸿沟。