生数科技Motus2:用世界模型实现机器人策略的闭环自进化
一个能给自己打分的机器人模型
机器人拧灯泡时如果没对准螺纹,谁来告诉它错在哪?传统做法是让人反复示范正确操作,但现实场景千变万化,不可能每种情况都教一遍。更理想的状态是:机器人自己判断动作好坏,并据此调整下一次尝试。
生数科技最新发布的Motus2,正是朝着这个方向迈出的一步。它把三种能力——生成动作、预测后果、评估结果——集成到同一个模型里,形成一个可迭代的闭环。这不仅是技术组合,更是对“机器人如何持续进步”这一问题的新解法。
在前代Motus的基础上,Motus2进一步融合视觉、语言、动作与触觉信号。它既能执行任务,又能提前模拟“做完会怎样”,还能事后给自己打分。三者衔接起来,让模型具备初步的自我改进能力。
闭环怎么转起来的?
Motus2的核心机制可以用四个步骤概括:生成动作 → 预测后果 → 评估结果 → 更新策略。
首先,它的世界动作模型(WAM)负责输出下一步动作;接着,条件动作世界模型(AC-WM)基于当前状态和刚生成的动作,预测执行后的视觉结果;然后,价值模型(VM)对预测画面打分,判断这个结果是否接近任务目标;最后,高分动作在训练中获得更强的正向引导,低分动作则被逐渐抑制。
关键在于,整个流程严格遵循“动作优先”的时序逻辑:模型必须先决定做什么,才能看到预测结果。这避免了常见的“用未来帧反推动作”的作弊行为,确保学到的策略能在真实环境中泛化。
在推理阶段,Motus2采用Best-of-N规划:先生成多个候选动作,分别模拟执行后的画面,再由价值模型选出最优解。这相当于给机器人一次“脑内试错”的机会,优化当次决策。
而在训练阶段,这些打分被转化为策略更新信号。值得注意的是,只有动作生成部分的参数会被更新,预测和评估模块保持冻结,防止反馈信号干扰已学好的能力。
这种设计改变了失败数据的价值。过去,行业主要依赖“完美轨迹”,失败样本常被丢弃;现在,失败轨迹也能用于学习“哪些动作会导致不良后果”,从而帮助模型避开错误路径。
真机测试验证了闭环的有效性。在手机放置和多指操作任务中,基础策略成功率65%;仅加规划提升至67.5%;仅加基于模型的强化学习(MBRL)达72.5%;两者结合后达到75%,比基线高出10个百分点。
触觉和记忆:补上视觉看不见的信息
光靠摄像头,机器人很难判断手指是否真的夹稳了纸巾。视觉能看到手的位置,却难以感知接触力、滑动或形变。这对灵巧操作至关重要。
Motus2为此引入了一个轻量级触觉专家模块。它在短动作片段执行前读取最新触觉反馈,微调动作细节。巧妙的是,该模块复用主模型已计算的中间特征,无需重新运行整个视频骨干网络,兼顾了响应速度和计算效率。
在抽纸杯和撕纸任务中,加入触觉后平均成功率从60%升至72.5%,提升12.5个百分点。这说明,对于精细操作,触觉不是锦上添花,而是必要信息。
另一块拼图是记忆。当目标物体被遮挡或移动后,仅靠当前画面无法定位,机器人必须记住之前发生了什么。
Motus2默认缓存近期的真实观测序列。在“找隐藏方块”和“按历史提示操作按钮”两项测试中,保留完整历史信息的方案平均成功率达57.5%,明显优于压缩历史的版本。
这表明,对于依赖长期上下文的任务,原始观测本身包含不可替代的线索。当然,全量保存历史会增加存储和计算负担,目前的做法更像是一种阶段性妥协。业内也在探索其他方案,比如只保留关键帧或使用摘要机制,但物理世界的记忆问题尚无通用解法。
从人类经验到机器手:Ego数据的迁移路径
Motus2已在单手22自由度的Sharpa Wave和20自由度的WUJI Hand 2上部署,完成拧灯泡、翻书等任务。高自由度带来了操作灵活性,也大幅增加了学习难度——同一任务可能有多种手指配合方式,微小差异就会影响后续动作。
真正的瓶颈在于数据。生数科技选择了一条务实路径:以人类第一视角(Ego)操作视频为主干,再逐步迁移到机器人平台。
整套训练分为三步:
- 第一步,用大规模单目Ego视频预训练,学习物体运动和场景变化的基本规律;
- 第二步,引入双目视频和人类手部动作数据,细化交互细节;
- 第三步,通过机器人轨迹和人机对齐数据,将人类经验适配到机器手的控制空间。
这套Ego数据体系包含约13万小时人类操作视频,搭配百小时级的机器人及对齐数据。
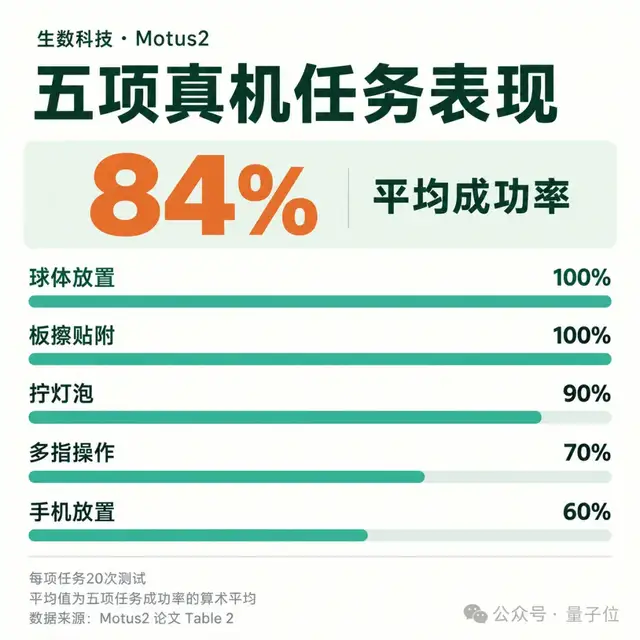
对照实验显示,在相同微调流程下,仅用人类Ego数据预训练的模型,五项真机任务平均成功率为51%;加入机器人中间训练后,成功率跃升至84%,提升33个百分点。
这说明人类数据提供了丰富的世界知识和操作先验,而机器人数据则负责解决“如何用这只特定的手实现动作”的问题。毕竟,人手和机器手在尺寸、关节范围和驱动方式上存在差异,直接照搬不可行,必须经过适配。
团队还测试了双目数据规模的影响:从2000小时增至20000小时,人类动作预测任务的验证误差持续下降,未见明显饱和。这意味着,靠扩大人类操作数据来提升模型性能,这条路仍有空间。
从L3到L4:自主智能体还有多远?
生数科技将通用世界模型的能力演进划分为五级:L1生成世界,L2与世界交互,L3在世界中行动,L4自主世界智能体,L5世界组织者。
按照这一框架,Motus2已具备L3的核心能力:理解状态、预测动作后果、输出真实控制指令。而它尝试的闭环自进化机制,则开始触及L4的关键特征——自主决策、自主反馈、持续自我改进。
不过,从单次任务内的策略优化,到开放环境中的长期自主学习,差距依然显著。例如,触觉模型在不同机器人本体间的迁移仍困难;长任务中的预测累积误差可能失控;高效长期记忆机制尚未成熟;开放世界里的持续学习也缺乏可靠框架。
但Motus2至少证明了一点:世界模型可以不只是被动执行或预测,还能主动参与自身的改进过程。评价与反馈真正进入了学习闭环,这为具身智能的下一步发展提供了新思路。
项目主页和真机演示已公开,论文也同步发布。无论这条路径最终能否通向通用具身智能,Motus2确实让机器人离“会反思”更近了一步。