最强AI模型进企业遇阻:数据控制权成新门槛
最强模型进不了最核心的系统
9 月中旬,《The Information》披露了一则看似平常却意味深长的消息:英伟达、Palantir 和 Booz Allen Hamilton 正在限制 Anthropic 模型的使用范围,或要求其提供更严格的数据保护承诺。这些公司不是小客户,而是手握重金、深度参与 AI 基础设施和政府项目的关键玩家。
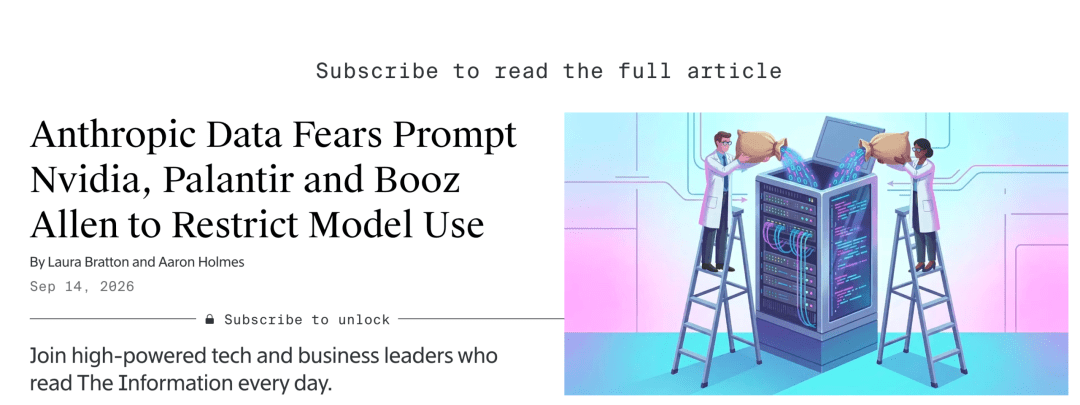
表面看,这只是几家企业调整内部 AI 使用策略。但背后反映的趋势更值得警惕:当大模型开始接触芯片设计、国防项目、金融交易和企业代码库时,模型能力越强,企业反而越不敢轻易交出数据。
Palantir 的态度最为强硬。它要求 Anthropic 提供不可撤销的「零数据留存」(Zero Data Retention, ZDR)承诺,否则不会通过自家平台向客户开放相关模型。英伟达则将 Anthropic 模型限定在低敏感度的内部任务中,涉及专有信息时优先使用自研的 Nemotron 模型。Booz Allen 更直接:网络安全项目中禁止使用 Anthropic 的商业模型。
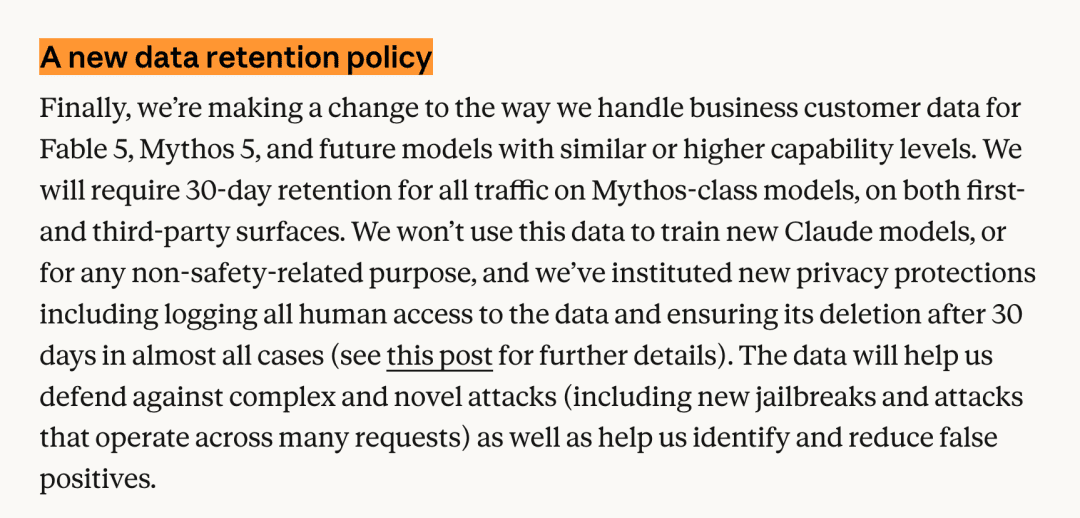
这些限制并非针对所有 AI 服务,而是集中于 Anthropic 最新的前沿模型,如 Claude Fable 5 和 Mythos 5。问题出在今年 6 月 Anthropic 推出 Fable 5 时实施的新政策:默认保留用户使用数据 30 天。
数据不用于训练,为什么企业还是不放心?
Anthropic 明确表示,这 30 天留存的数据不会用于训练新模型,也不会用于安全以外的任何用途。它的唯一目的是提升安全监测能力——比如识别跨越多轮对话的复杂攻击、新型越狱尝试,或减少安全系统的误判。
听起来合理,但对企业来说远远不够。
过去两年,企业问得最多的问题是:“我的数据会不会被拿去训练?”现在问题已经升级:即使不训练,数据存在哪里?谁有权访问?日志会不会被分析?加密密钥由谁控制?
对于写邮件、生成营销文案这类任务,SaaS 模式的风险尚可接受。但当 AI 开始作为 Agent 运行,情况完全不同。一个任务可能持续数小时,调用内部数据库、代码仓库、ERP 系统,甚至执行真实操作。整个过程中产生的 prompt、工具调用记录、返回结果和操作轨迹,拼起来就是一幅完整的企业业务图谱。
英伟达的芯片研发细节、Booz Allen 的网络攻防数据、Palantir 客户的政府情报——这些信息一旦离开企业控制边界,哪怕只是临时存储,也可能构成合规或安全风险。
所以,争论的核心早已不是“是否用于训练”,而是“数据能不能离开我的环境”。
Anthropic 的回应:把日志留在客户云里
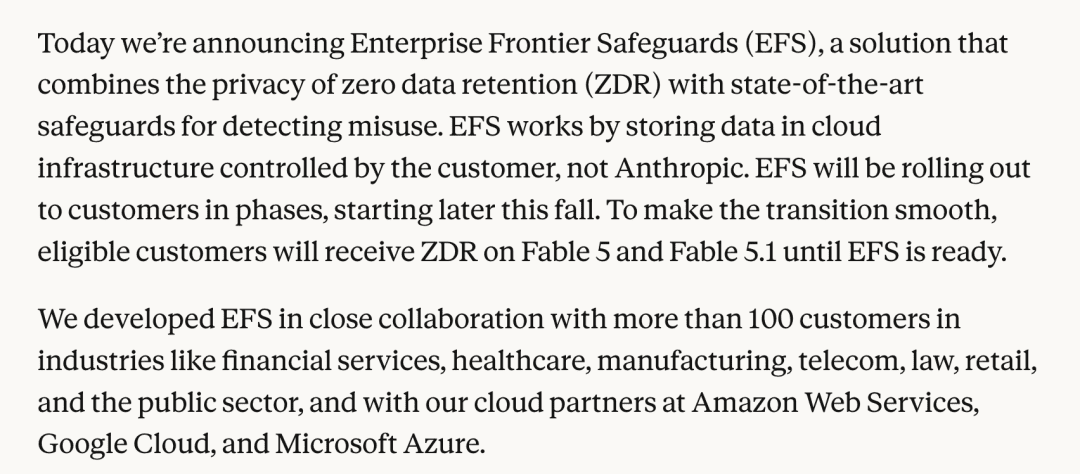
意识到这一矛盾后,Anthropic 在 9 月 1 日推出了 Enterprise Frontier Safeguards(EFS)。这套机制试图同时满足两个看似冲突的需求:企业要零数据留存,Anthropic 要安全监控。
解决方案很直接:安全日志不再存 Anthropic 的服务器,而是直接写入客户自己的云存储——Amazon S3、Azure Blob Storage 或 Google Cloud Storage。加密密钥由客户管理,访问策略由客户设定,审计日志也留在客户控制范围内。
Anthropic 的自动安全系统仍可运行。当检测到可疑行为时,系统会向客户发送警报。默认情况下,后续的人工审核也由客户团队完成,Anthropic 员工无需查看原始数据。公司称这种设计实现了“零数据留存级别的隐私”与“前沿模型的安全防护”的结合。
EFS 目前尚未全面上线,计划从今年秋季晚些时候分阶段推出。在此期间,符合条件的企业仍可使用 Fable 5.1 的零数据留存模式。
值得注意的是,EFS 并非闭门造车。Anthropic 表示,它与金融、医疗、制造、电信、法律、零售和公共部门等超过 100 家客户共同开发,并与 AWS、Google Cloud 和 Microsoft Azure 合作。这意味着,数据托管方式已从合同条款升级为产品架构的一部分。
另一条路:主权 AI 与开放模型
与此同时,企业也在探索另一条路径。9 月 10 日,英伟达与 Palantir 宣布合作推出面向关键供应链的“主权 AI”方案。
该方案将 Palantir 的 Foundry 和 AIP 平台,与英伟达的 Nemotron 开放模型结合,首先部署在英伟达自己的供应链系统中。官方强调:企业可在使用 AI 的同时,保持对专有数据的完全控制和所有权。系统既可上云,也可本地部署。
英伟达自己成了首个用户。其供应链系统需处理产能、原材料、生产周期,以及来自邮件、天气、地缘政治和供应商沟通中的非结构化信息。Nemotron 模型在 Palantir 的治理体系内分析这些数据,辅助决策,但所有信息始终处于英伟达掌控之下。
虽然官方未明说这是对 Claude 或 GPT 的替代,但它清晰展示了另一种技术路线:用能力稍弱但完全可控的开放模型,替代最强但数据需外流的闭源模型。
能力与可控性,正在分裂成两个维度
英伟达身处 AI 生态中心,与 OpenAI、Anthropic、Meta 等均有合作,自然清楚闭源模型的能力优势。但它同时拥有自研模型、算力和部署栈,有条件将敏感任务留在内部。
这揭示了一个越来越清晰的现实:模型能力是一条轴,数据控制能力是另一条轴。
过去,模型在基准测试上领先几个百分点,就足以让企业改变技术选型。但当 AI 深入核心业务后,能力优势必须经过安全、合规、数据主权和部署方式的层层过滤。在金融、医疗、国防、芯片和政府等领域,后几项往往拥有直接否决权。
这也是开放模型在企业市场始终保有特殊价值的原因。企业可以自行部署,日志自己保存,模型限定区域,网络物理隔离。极端情况下,甚至可部署在完全私有的数据中心。模型供应商无法天然获取运行数据——对某些业务而言,这种可控性本身就是核心功能。
当多个模型都“足够强”之后,真正决定谁能进入公司最核心系统的,可能是一个更朴素的问题:谁能让客户始终握住自己的数据?
Anthropic 的 EFS 是一种妥协方案,试图在不牺牲安全的前提下满足控制需求。而英伟达与 Palantir 的路线,则彻底绕开第三方模型,构建闭环生态。两种路径并存,说明市场尚未形成统一答案。
但有一点已经确定:最强的模型,未必是最适合企业的模型。在数据主权面前,能力优势可能瞬间失效。未来的企业 AI 竞争,不仅是模型性能的比拼,更是数据治理架构的较量。