用 LangGraph 实现 Tree of Thought:多级决策、剪枝回溯与 Token 成本控制
为什么需要真正的 Tree of Thought
做重要技术选型时,没人会想到一个方案就立刻拍板。真实决策过程通常是:先列几个候选,横向比较吞吐、复杂度、成本和风险;选定方向后,再进入下一层问题;如果某条路线撞上硬约束,还能退回去换第二优方案。
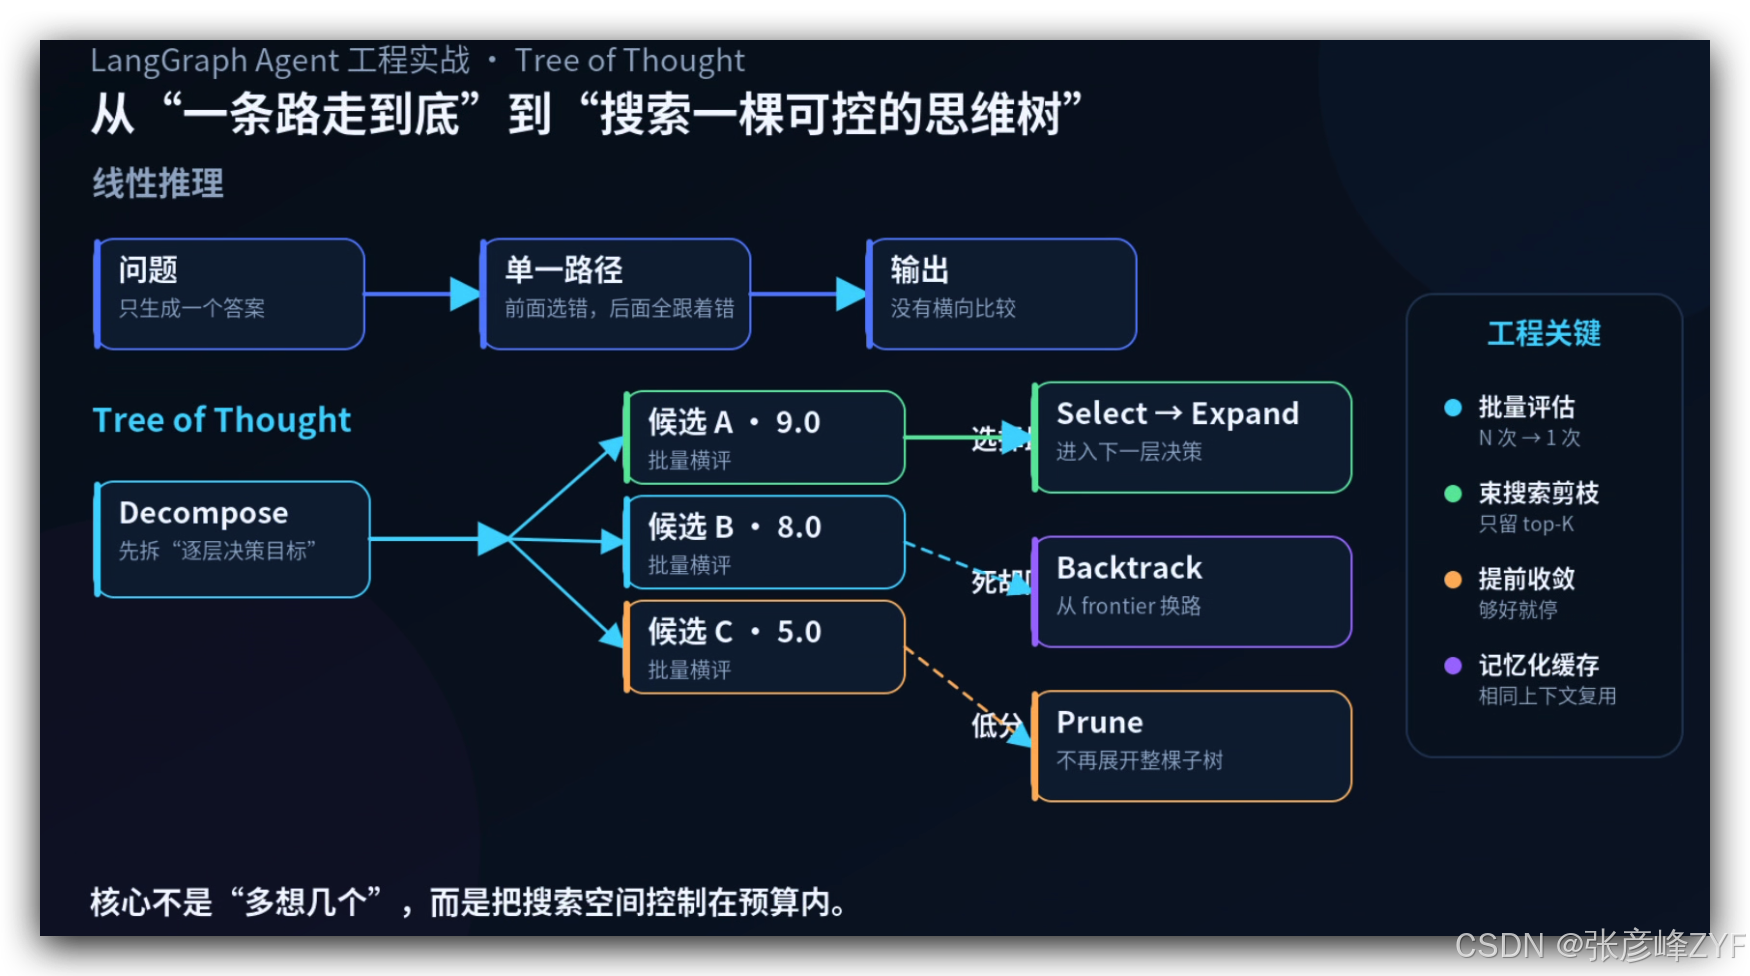
关键在于:后一层的问题,是前一层决策成立之后才存在的。你不会在“架构模式”都没决定时,就提前争论“分库分表究竟分 64 张还是 128 张”。
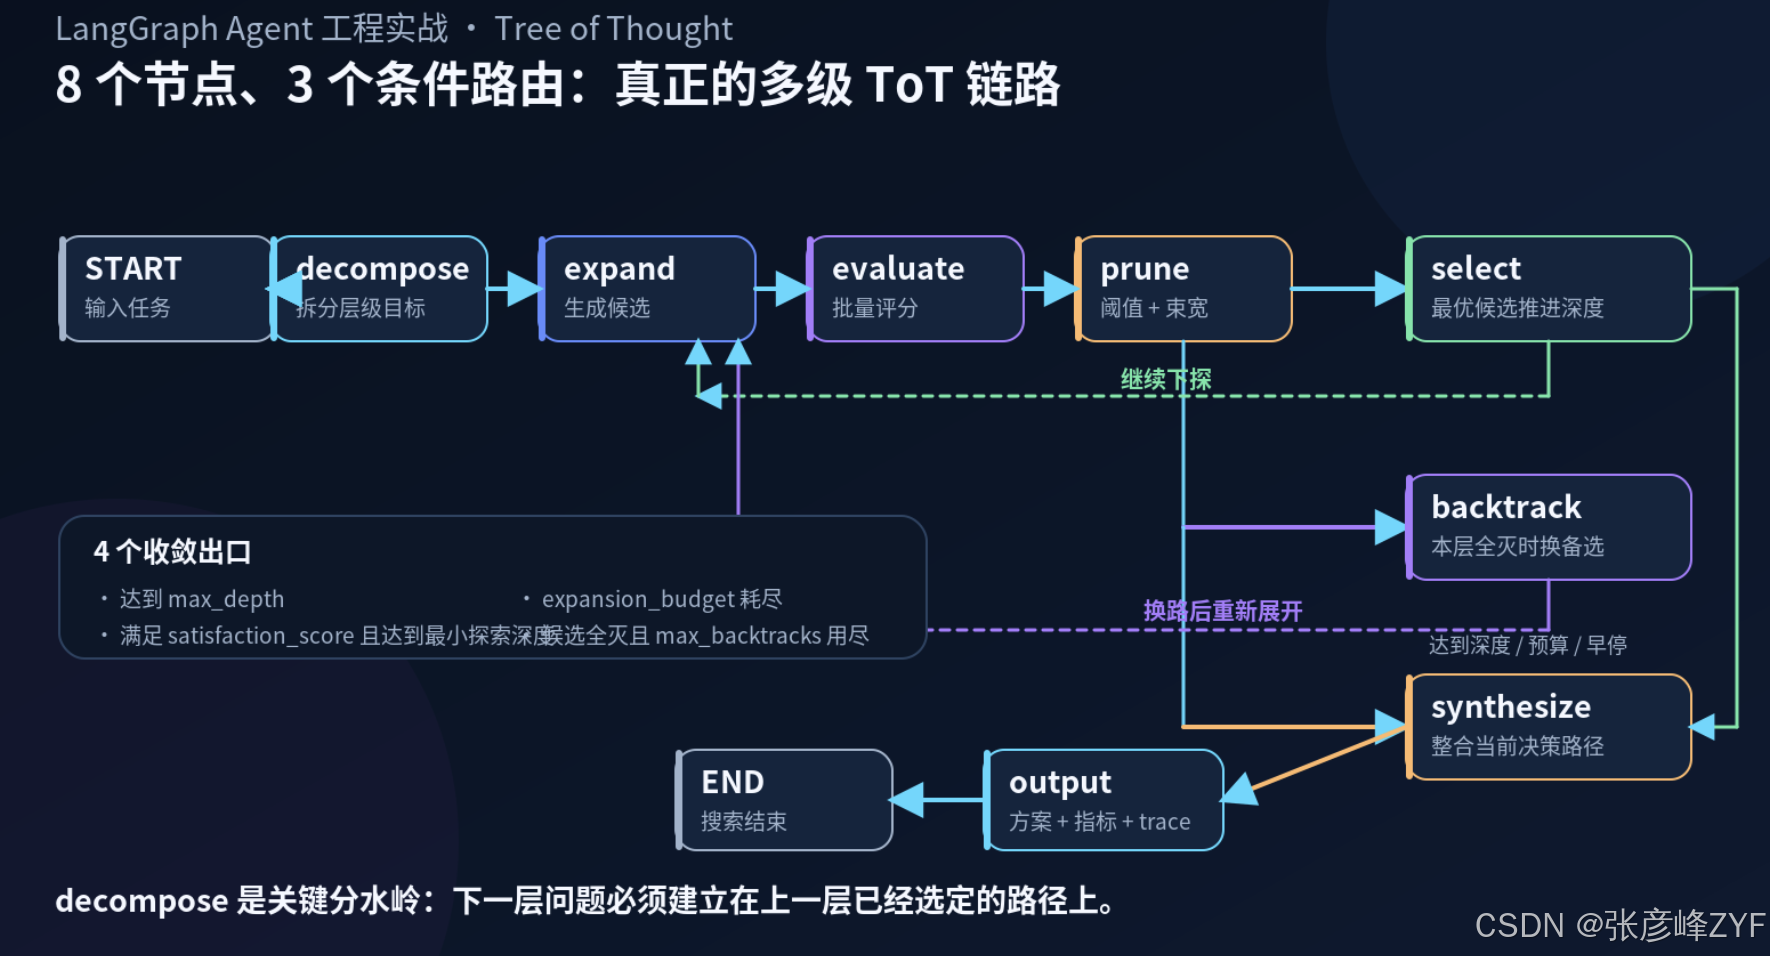
Tree of Thought(ToT)与普通“多采样”的本质区别就在这里。前者形成一棵逐层依赖、可搜索回溯的决策树,后者只是对同一问题问三遍。ToT 把搜索算法带进推理过程:每层发散多个候选、统一评估、主动剪枝、选择最优继续深入,必要时还能回溯。
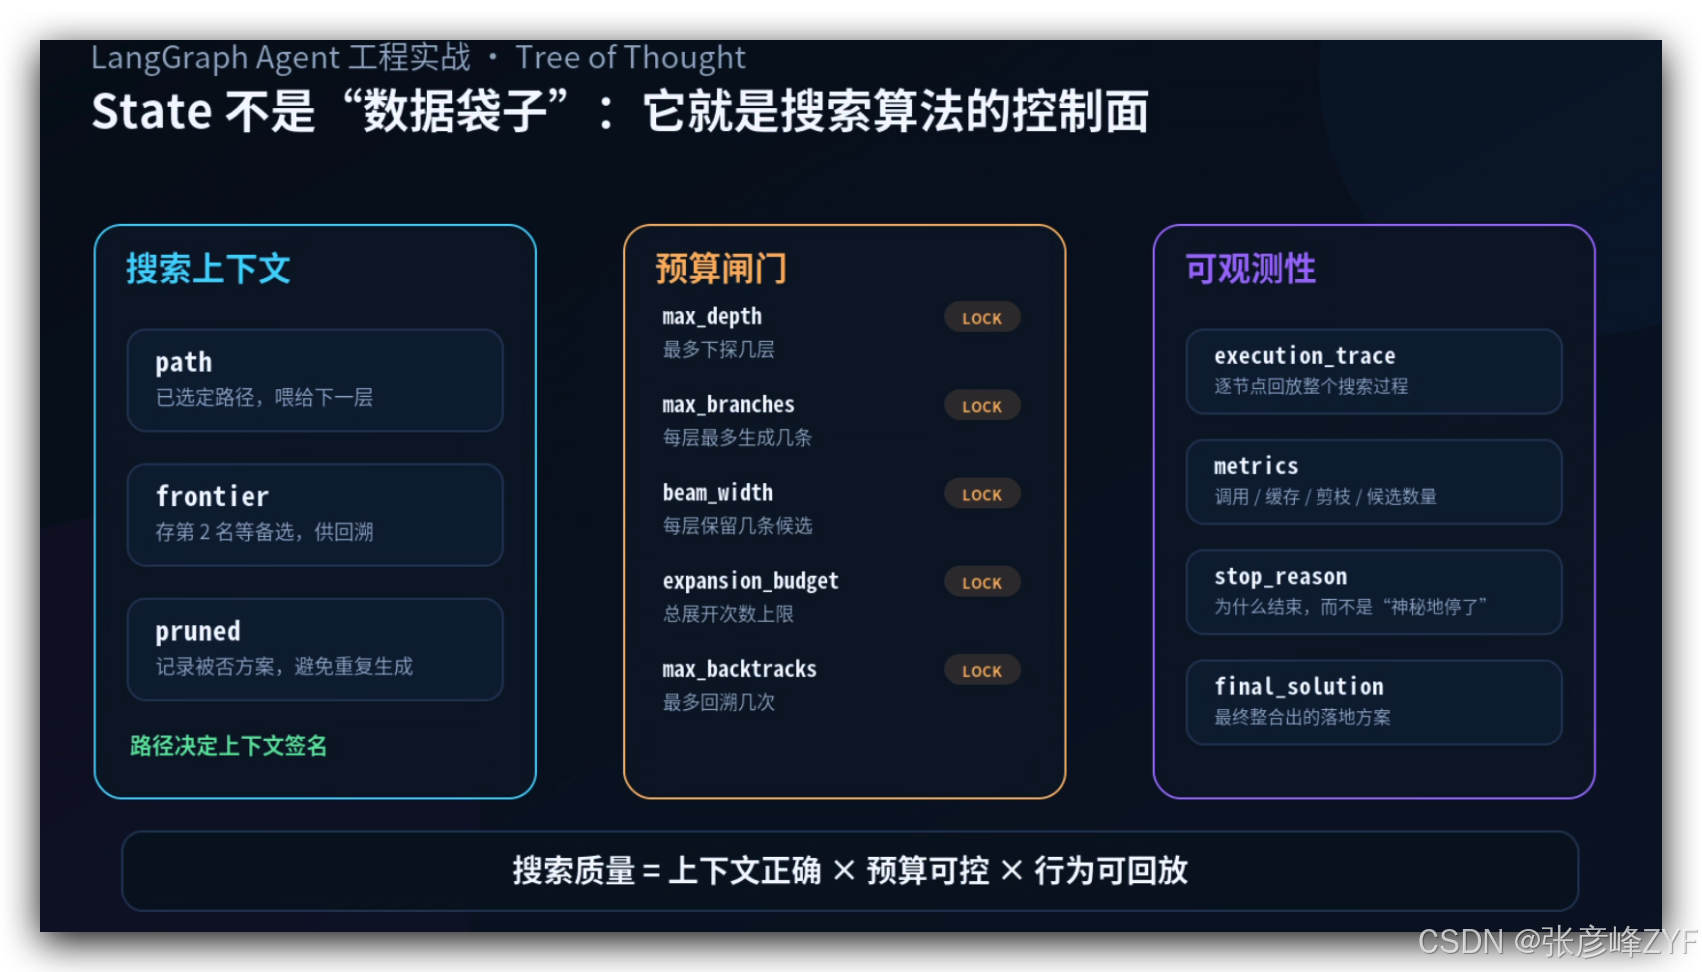
核心状态设计:path / frontier / pruned 才是 ToT 的“记忆”
ToT 的难点不在 prompt,而在状态设计。真正支撑搜索与回溯的是三组核心状态:
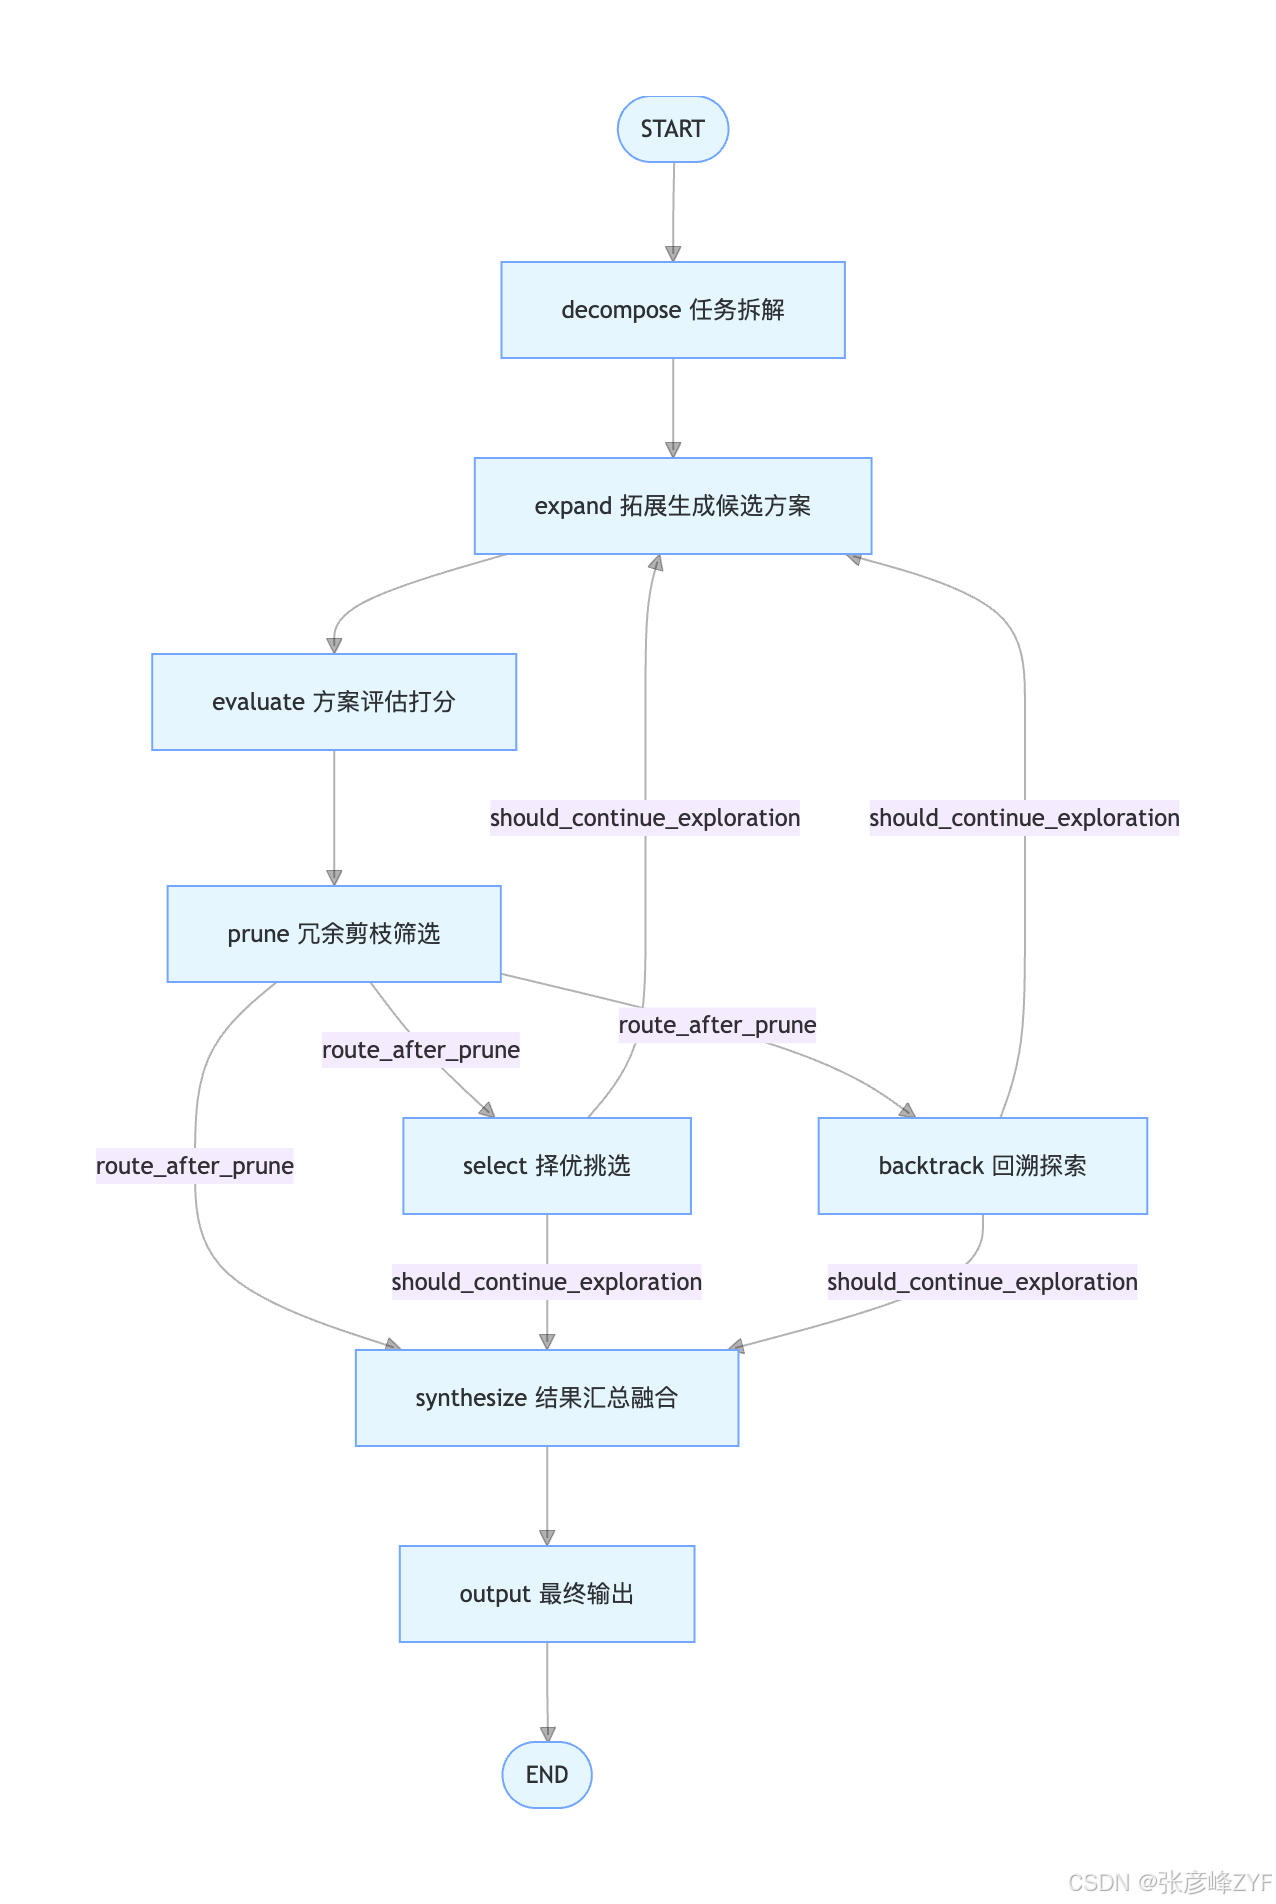
- path:已选定的主路径。下一层 expand 必须看到它,才能生成承接上层决策的候选。
- frontier:本层没立刻下探但仍值得保留的备选。回溯时从这里取,避免死胡同导致整次搜索失败。
- pruned:已被判定低价值或不可行的方向。后续发散时明确告诉模型“不要再换个说法提回来”。
这三组状态共同决定了“下一步从哪里继续想”。没有它们,所谓的 ToT 只是线性推理套了个壳。
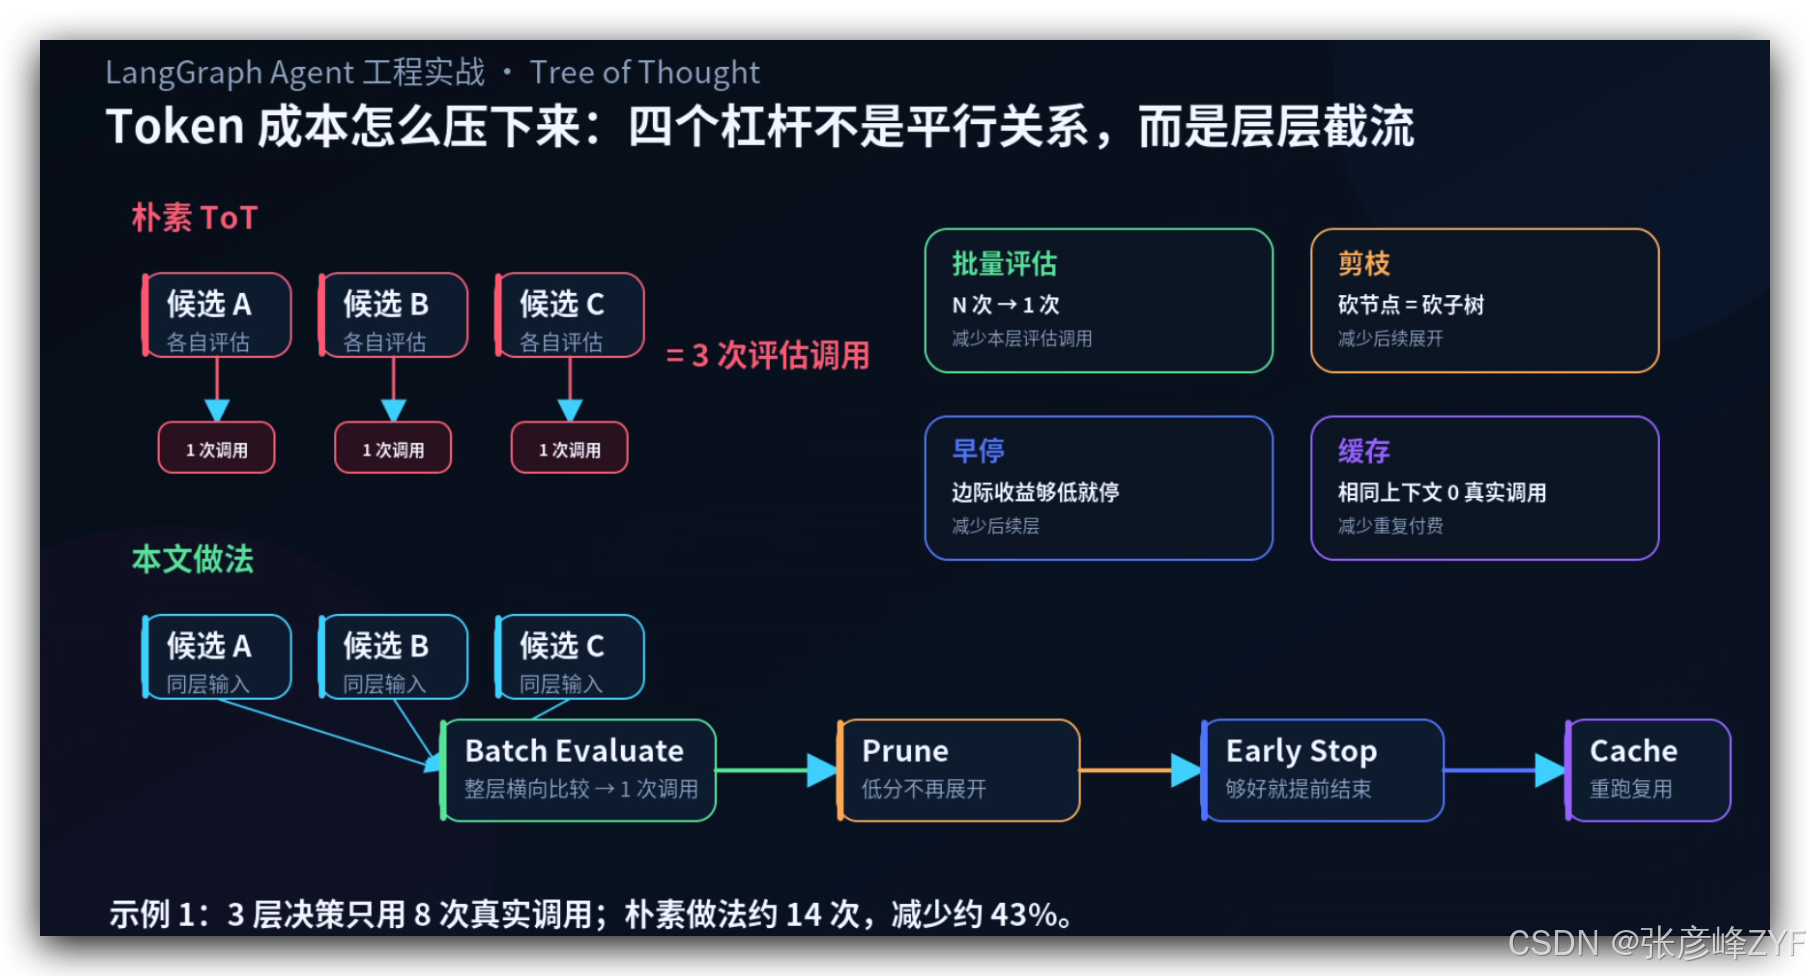
四把省钱刀:控制 Token 成本的关键手段
批量评估:把 N 次调用压成 1 次
朴素 ToT 最直接的写法是每个候选单独调一次模型评分。一层有 3 个候选,就需要 3 次评估调用。本文把整个候选集合放进同一次模型调用里批量打分。
收益不只是“省 2 次调用”,更重要的是模型终于有参照物了。孤立评分时,模型容易给出“7.5、8.0、8.0”这类安全分;但把候选放到同一上下文横向比较,更容易拉开差距,出现 9.0 / 8.0 / 5.0 这种有区分度的结果。
剪枝:砍掉一个节点,等于砍掉整棵子树
真正把搜索空间从“指数爆炸”拉回可控范围的是 prune 节点。本层候选最后被分成三类:
- beam[0]:立刻下探
- beam[1:]:进入 frontier,作为回溯备选
- 其余候选:彻底剪掉,不再产生下一层开销
这就是 ToT 最关键的成本杠杆:剪枝真正省掉的不是“这个候选本身”,而是这个候选下面原本会继续生成、评估的整棵子树。
一个很容易写错的地方是 frontier 应该收谁。正确做法是 alternates = beam[1:],因为 beam_width=2 的含义应该是:第 1 名现在走,第 2 名先排队未来可能回溯,第 3 名及以后直接被淘汰。如果错误地把 survivors[beam_width:] 放进备选池,真正的第 2 名反而进不了 frontier,回溯逻辑就成了死代码。
早停:“够好”不等于“第一层高分就停”
早停逻辑看起来简单:当前最优分达到满意阈值就结束。但真实运行很容易踩坑——模型给头名打分偏高,如果一看到 9.0 就停,精心设计的多层链路会直接退化成“一层决策”。
所以增加了最小探索深度限制:早停要求“分数足够高”且“已探索足够层数”。这样既能省成本,又不会破坏“分层决策”的价值。早停买的是“边际收益已经不值得继续付费”,而不是数学意义上的全局最优。
记忆化缓存:回溯与重跑不再重复付费
缓存实现很直接,但真正容易出问题的是缓存键包含什么。本文的缓存键会带上调用类型、任务、层级、当前层目标、已选路径签名、已剪枝信息等上下文。
尤其是已选路径签名不能省。因为回溯之后,虽然仍在“第 2 层”,但上层选择已经变了。如果只按“任务 + 第几层”缓存,模型会直接拿回上一条路生成过的候选,相当于回溯后继续重复旧答案。同一层 ≠ 同一上下文,缓存必须绑定搜索路径。
运行演示:看 ToT 如何实际工作
演示 1:三层决策真的串起来了
任务:“设计一个高并发订单系统的架构方案”,配置 max_depth=3, max_branches=3, beam_width=2。
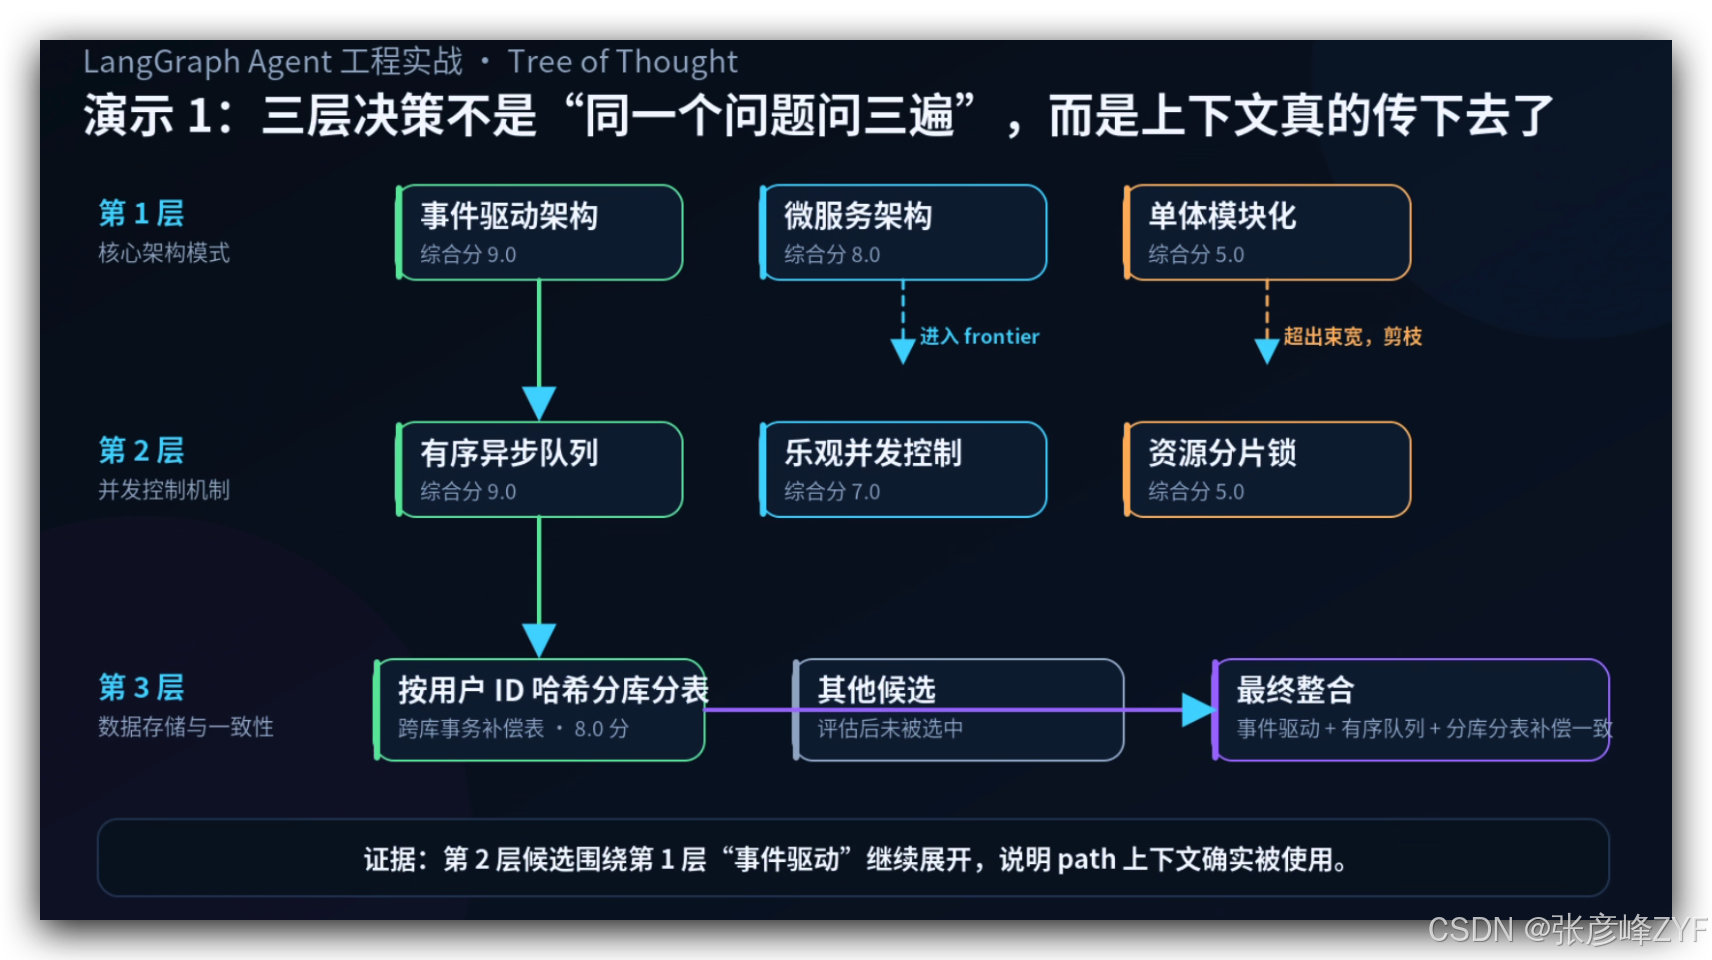
第一步,LLM 先拆成 3 个逐层目标:
- 第 1 层:确定系统的核心架构模式(单体、微服务还是事件驱动)
- 第 2 层:在选定架构下,选择订单处理的并发控制机制
- 第 3 层:设计数据存储与一致性方案
注意第 2 层目标里的“在选定架构下”——这说明第二层不是重新思考整个问题,而是只回答在第一层决策成立后才出现的问题。
第一层批量评估结果:事件驱动架构(9.0 分)立即下探,微服务架构(8.0 分)进入 frontier,单体架构(5.0 分)被剪枝。
第二层候选开始“带着上一层答案思考”,生成的方案明显围绕事件驱动架构细化,如“基于事件序号的有序异步队列处理”,而不是重新讨论架构模式。
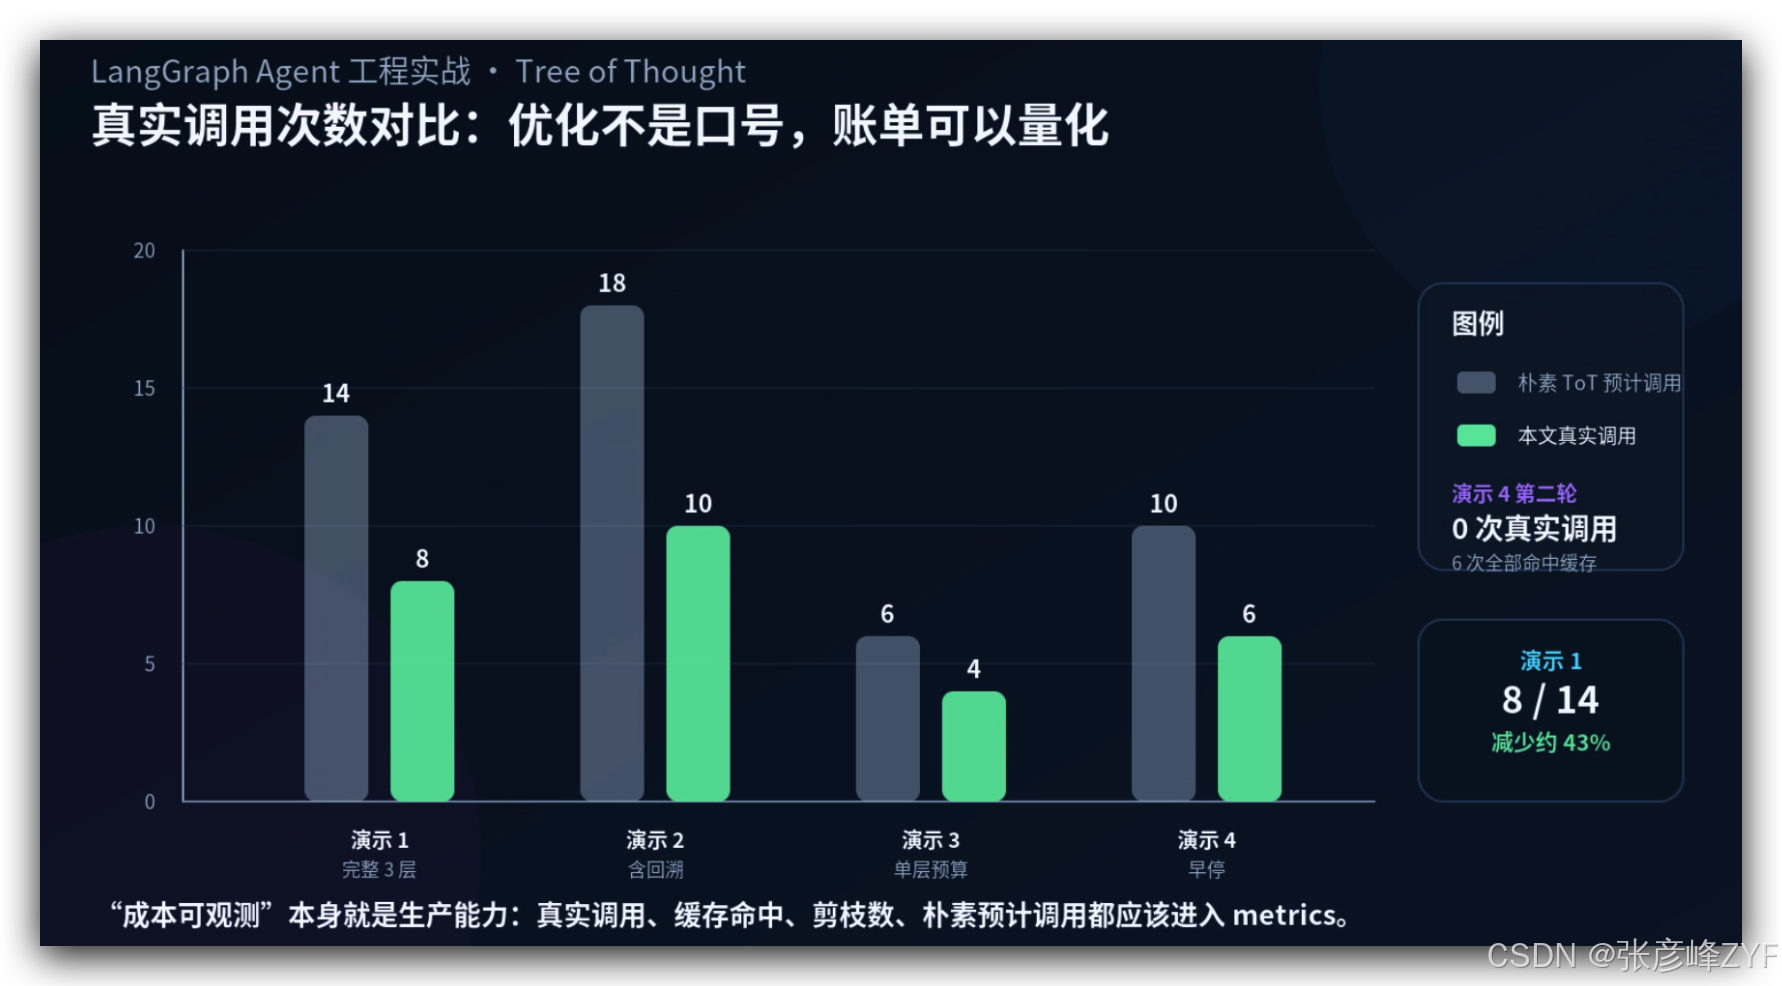
这次搜索一共花了 8 次真实调用(1 次 decompose + 3 层 × 2 次 + 1 次 synthesize),而朴素做法约需 14 次,减少约 43%。
演示 2:撞上死胡同,ToT 才真正体现价值
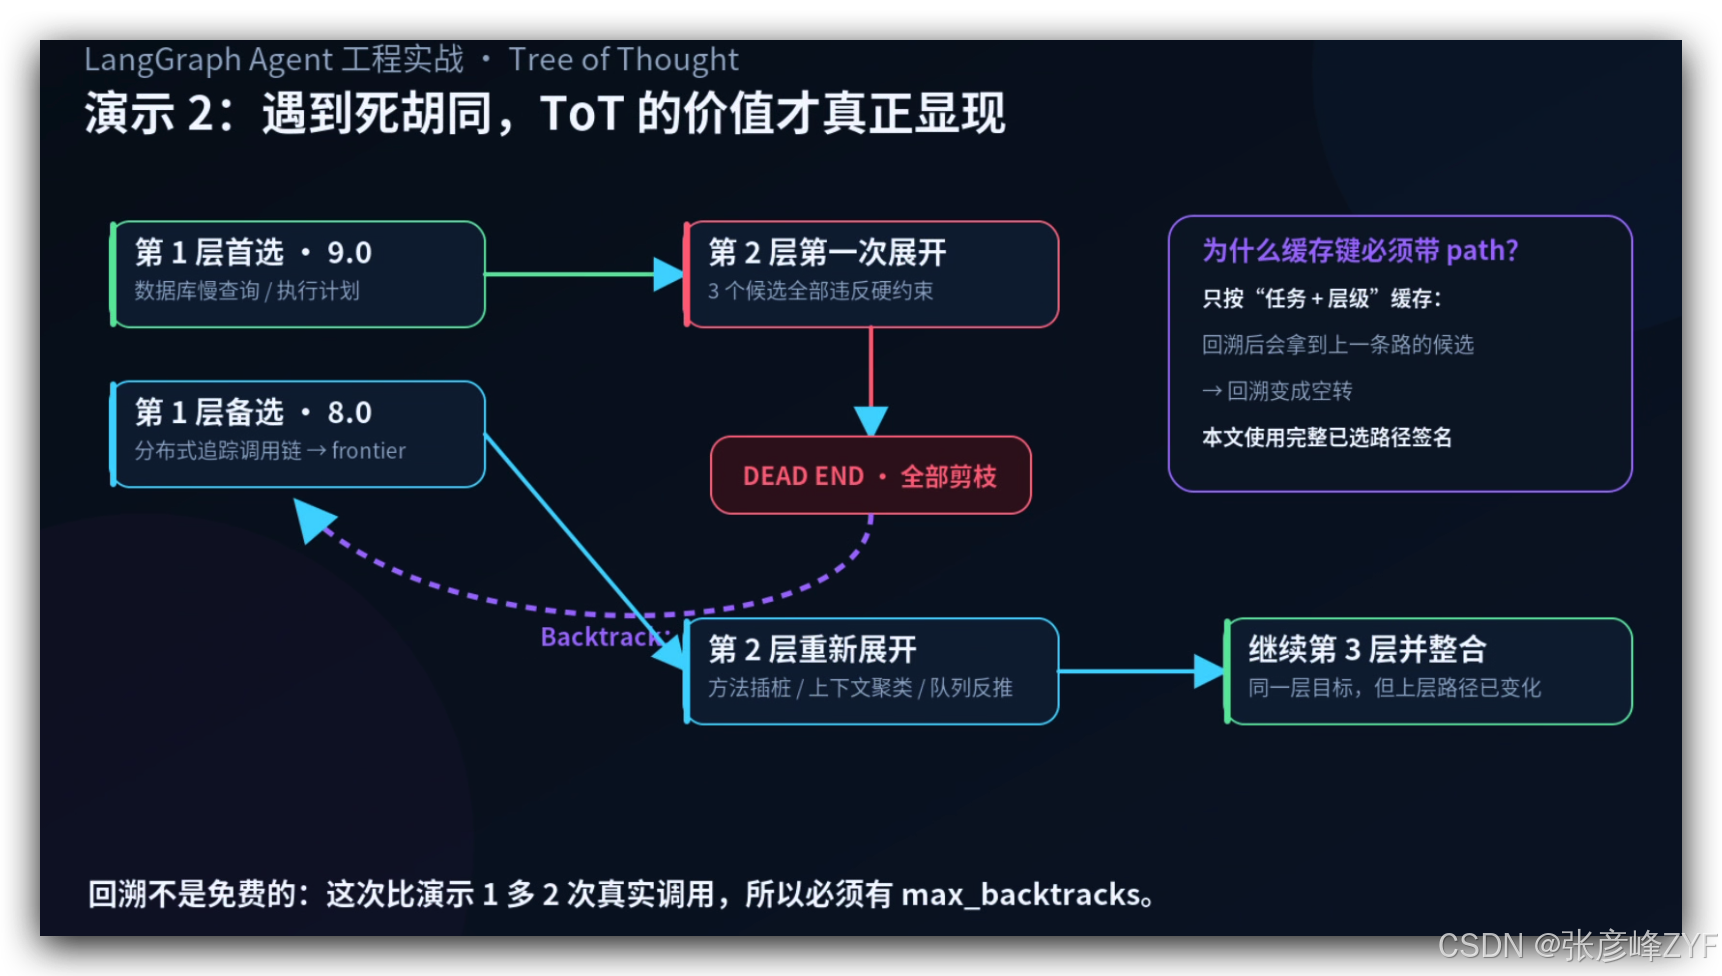
第二组演示专门注入死胡同:第 2 层所有候选都被判定违反硬约束。第 1 层先保留两条路线:数据库慢查询分析(9.0 分)和分布式追踪分析(8.0 分)。
第一次进入第 2 层后,3 个候选全部被剪掉。正常线性推理到这里往往只能失败,但 ToT 会:
- 发现 beam 为空
- 检查 frontier 是否还有候选
- 从全局备选池拿到第 1 层第二名
- 把 path 截断到对应深度
- 接上新的上层选择,重新进入第 2 层展开
回溯前后,第 2 层候选发生明显变化:从围绕数据库/JVM 的方案,变成方法级插桩、上下文聚类等更贴合“分布式追踪”路线的方案。这证明上层 path 确实传进了下一层,也验证了缓存键必须带 path。
演示 3:深度 + 展开预算,给搜索空间上“双保险”
第三组演示把限制压得很紧:max_depth=1, expansion_budget=1。只允许一层展开,有个“量子退火”方案拿到创新性 10 分但可行性只有 2 分,被直接淘汰。
这说明一个重要工程原则:“最创新”与“最可落地”往往不是同一个方案。可行性应当拥有一票否决能力,而不是只参与加权平均。
如果没有预算闸门,假设每层 3 个候选、探索 5 层,理论路径数会达到 3^5 = 243。因此至少要同时控制 max_depth(锁深度)、max_branches(锁每层生成数量)、beam_width(锁每层存活数量)、expansion_budget(锁总展开次数)。
演示 4:早停 + 缓存,两种省法可以叠加
第四组演示把满意阈值调整到 9.0。任务“设计一个可扩展的实时数据同步方案”:
- 第 1 层选定:基于发布订阅模式的事件驱动同步(9.0)
- 第 2 层选定:基于 Kafka 的分区有序 + 幂等消费(9.0)
- 满足早停条件,不再展开第 3 层
第一轮真实调用 6 次。紧接着用完全相同的任务再跑一遍,真实调用降为 0 次,6 次全部命中缓存。这就是记忆化缓存最直观的收益:调 prompt、调阈值、重复测试时,如果上下文签名没变,就不应该一遍遍重新付费。
六个最容易踩的坑
坑 1:早停阈值太低,多级链路第一层就结束
现象:设计了 3 层,实际每次只跑 1 层。原因是模型评分偏高,头名经常直接到 9.0。处理方法:先跑几轮观察分数分布再校准 satisfaction_score,同时增加最小探索深度。
坑 2:评估维度名对不上,维度分悄悄丢失
现象:某些演示能打印完整维度分,某些只剩综合分。原因是 decompose 可能生成“可行性(实施难度和资源需求)”这类长名字,但 evaluate 返回的 key 变成“可行性”,按字符串精确匹配时取不到。这种问题危险在于它通常不抛异常,只是静默退化。
坑 3:备选池一直为空,回溯逻辑实际上是死代码
现象:写了 backtrack,运行却从没触发过。原因是把“束宽之外”的候选放进 frontier,而不是把 beam[1:] 放进去。正确语义是:beam 表示“本层仍允许参与后续搜索的候选”,其中第一名现在走,其余才是未来回溯对象。
坑 4:缓存键漏掉 path,回溯之后生成一模一样的候选
现象:明明换了上层路线,第 2 层却和之前完全一样。原因是缓存键只包含“任务 + 层级”,没有包含已选路径。所有“同一层但上下文可能不同”的调用,都必须把完整路径签名放进 key。
坑 5:一调大深度和分支数,账单和运行时间一起爆炸
现象:运行越来越慢,还可能撞 GraphRecursionError。原因是搜索空间天然是指数关系,而且多级链路每层还要经过多个图节点。处理方法:四把锁一起用,并根据层数和回溯余量显式放大 recursion_limit。
坑 6:每个候选单独打分,结果全部 8 分上下
现象:看起来每个方案都“挺好”,根本拉不开差距。原因是孤立评分缺少参照,模型容易给安全分。处理方法:整层候选一次输入,明确要求横向比较并“禁止所有候选同分”。
什么时候值得用 ToT
ToT 不应该成为所有 Agent 的默认推理方式。
适合使用:
- 方案空间明显有多个合理候选
- 前一层决策会改变后一层问题
- 选错路线的代价较高
- 有明确的可比较维度
- 允许多花一些 Token 换更好的决策质量
- 需要保留“备选路线”,而不是只要一个答案
例如:架构选型、复杂故障定位、策略规划、约束优化、多阶段设计。
不太适合:
- 问题有明确唯一答案
- 任务极简单,单次推理足够
- 延迟要求非常苛刻
- 成本预算极低
- 各候选之间根本没有稳定的评估标准
对这些任务,上 ToT 只会把简单问题变成昂贵流程。
真正能上线的推理 Agent 都必须有“硬边界”
任何能循环、重试、反思、搜索的 Agent,都必须有防死循环、防组合爆炸、防无限付费的硬性保护。不同模式对应不同闸门:max_iterations、max_steps、max_rounds、max_retries、max_depth、expansion_budget、max_backtracks、satisfaction/early stop。
这才是把“炫技 Demo”变成“敢放进生产环境”的底线。ToT 的价值可以用一句话收尾:它不是替你把所有路都走一遍,而是让 AI 知道什么时候应该多想、什么时候应该放弃、什么时候值得换路,以及什么时候已经足够好。而且这四件事,都必须能被预算、状态和指标约束。