阿里浙大推出 Astar:让 AI 自主决定下一步怎么进化
算法工程师最后的堡垒,也被 AI 攻破了?
过去几年,AI 已经能帮你写代码、跑实验、做评估。算法工程师的日常,逐渐变成:让 LLM 整理昨天的实验结果,让 LLM 实现新想法,再让 LLM 监控训练进程。似乎只要把需求说清楚,AI 就能完成大部分工作。
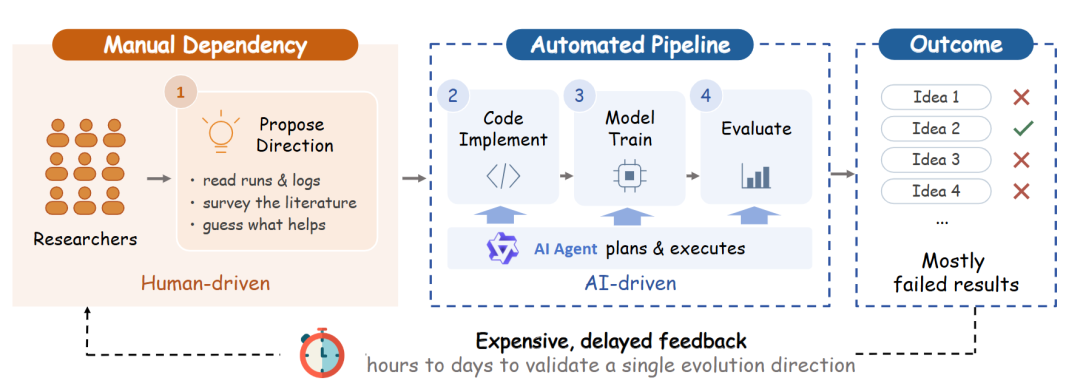
但有一件事始终绕不开人:到底该往哪个方向改模型?
这个“发现改进点”的能力,高度依赖工程师的经验和直觉。一个团队迭代快不快,往往卡在这一步。现在,连“怎么让自己变强”这件事,AI 也能自己做主了。
阿里和浙江大学联合推出了 Astar ——一个专门用于指导 AI 系统进化的语言模型。它不靠通用知识,而是去翻 AI 系统自己的“进化血泪史”:那些散落在 Git 提交记录里的代码变更、训练日志和业务指标变化。把这些真实反馈内化后,Astar 能根据当前系统状态,自适应地提出下一步演化方向。
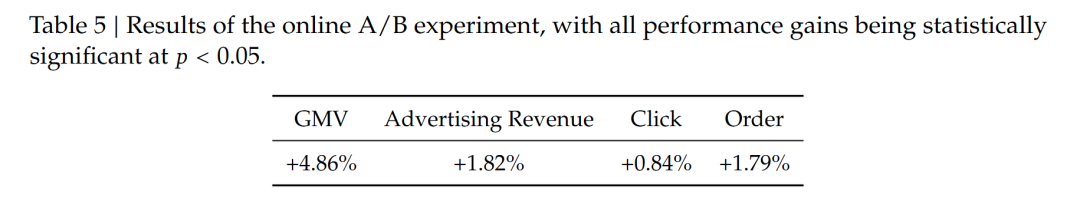
在阿里核心推荐业务落地时,Astar 自动主导了 20 轮全链路迭代,离线 HitRatio 提升 23.6%,线上 GMV 增长 4.86%。更关键的是,它把人类产生有效 idea 的效率提高了 10 到 100 倍。
为什么通用大模型搞不定工业级迭代?
有人会问:既然 GPT、Claude 这么聪明,直接把代码丢给它们出主意不行吗?
问题在于,工业场景太特殊。通用大模型学的是公开论文和开源项目,但真实业务系统往往是高度定制化的:数据分布偏斜、模型结构复杂、训练 pipeline 充满历史包袱。在这种环境下,通用建议常常水土不服。
工程师照着改完,满怀期待等三天三夜,结果指标纹丝不动,甚至反向跳水。算力和时间全打了水漂。
根本原因在于:AI 系统的迭代不是纯逻辑问题,而是一个带反馈的工程决策问题。你不仅要知道“理论上怎么改”,更要清楚“在这个特定系统里,哪种改法能带来正向收益”。
而这种经验,恰恰藏在系统自身的演化历史里。
从 Git 提交里挖金矿:Astar 的数据来源
Astar 团队盯上了每个算法团队都有的东西:版本控制系统里的提交记录。
每一次 commit,都记录了模型从上一版到下一版改了什么代码,以及随之而来的 loss 曲线、AUC、HitRate 等指标变化。这相当于一份带着真实业务反馈的“避坑指南”——哪些改动有用,哪些是无效折腾,一目了然。
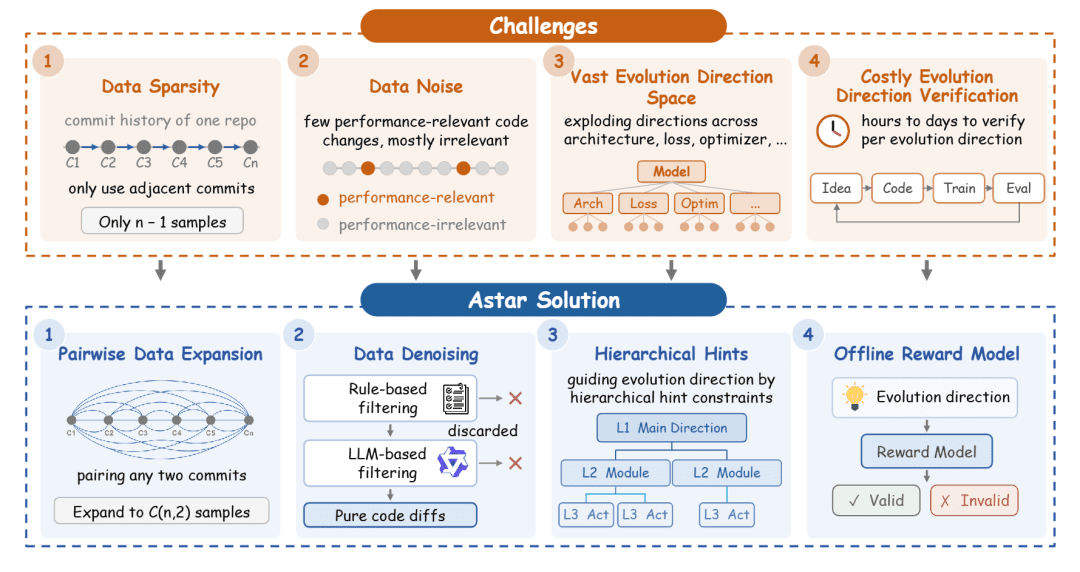
但要把这些杂乱的工程日志变成可学习的数据,得先跨过四道坎:
- 数据太少:一个仓库的真实算法迭代可能只有几十次,相邻两次提交的差异又很小,监督信号极其稀疏。
- 满库是“水”:大部分 commit 其实是加日志、改路径、删注释,跟模型性能毫无关系。
- 搜索空间太大:改进方向太多——换损失函数?调优化器?改网络结构?每个方向下还有无数微操。
- 验证成本太高:跑一次完整训练+评估要几小时甚至几天,没法像普通 RL 那样海量试错。
Astar 的整套设计,就是围绕这四个挑战展开的。
四招破局:Astar 的核心技术设计
1. 数据太少?两两组合,无中生有
与其只看相邻版本的演进,不如把历史上任意两次实验配对。比如对比 v1 和 v5,拉出它们的完整 loss 曲线,谁更低谁就是更好的版本。
这样,原本只有 N 次迭代的记录,瞬间扩展成 N² 个训练样本。更重要的是,模型既能学到短期微调技巧(如调整学习率),也能捕捉长期架构跃迁(如引入新模块)。
2. 满库是“水”?两级过滤,拧干水分
第一级是执行逻辑过滤:通过代码调用图(Reachability)和抽象语法树(AST),自动剔除所有不影响执行路径的改动——比如打印语句、死代码、格式调整。
第二级是进化意图过滤:用 LLM 对剩余代码做语义分析。如果一段修改无法被归类为明确的优化意图(如“提升收敛速度”“缓解过拟合”),就视为噪音丢弃。
经过这两轮清洗,留下的基本都是能真实影响模型性能的干货。
3. 空间太大?三级指引,层层递进
Astar 在训练时给数据打上了三级标签提示:
- 一级:主方向(如“优化策略”“特征工程”)
- 二级:细分模块(如“Muon 优化器”“梯度正交化”)
- 三级:具体动作(如“梯度降噪”“调整正交化阈值”)
推理时,模型也按这个逻辑思考:先定大方向,再聚焦模块,最后落实到具体代码。这种结构化生成,把近乎无限的搜索空间压缩成可管理的路径。
4. 验证太贵?离线打分,秒级初筛
团队用历史正负样本训练了一个奖励模型(Reward Model)。面对一个生成的改进方案,它能在一秒内预测出该方案降低 loss 的概率。
有了这个“代理专家”,系统可以:
- 在海量生成中快速筛选出 top 几个靠谱方案上机验证
- 为 Astar 的强化学习(RL)阶段提供低成本反馈,支持它主动探索新方向
这彻底绕开了“每次都要跑完整训练”的瓶颈。
小模型干翻人类专家?实测数据说话
基于上述处理后的演化语料,Astar 经历了标准的三阶段训练:中间训练(mid-training)→ 监督微调(SFT)→ 强化学习(RL)。
效果如何?在相同的推荐系统优化任务中:
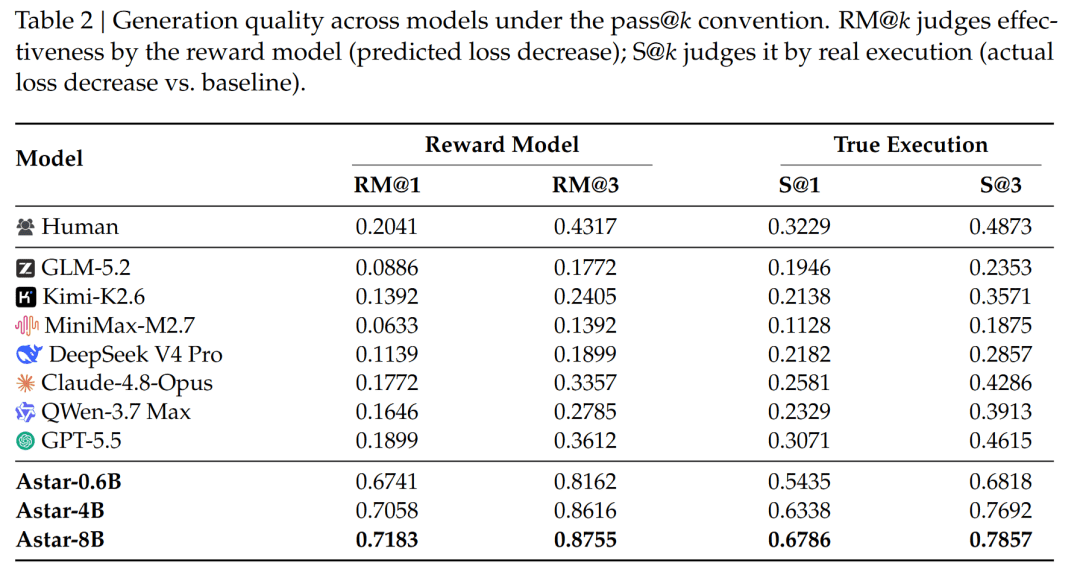
- 人类资深算法专家:单次生成有效方案的成功率(S@1)为 32.29%
- 最强通用模型 GPT-5.5:30.71%
- Astar 0.6B(6 亿参数):54.35%
- Astar 8B:67.86%
这意味着,即便是最小的 Astar 版本,单次建议的有效性也远超人类和通用大模型。
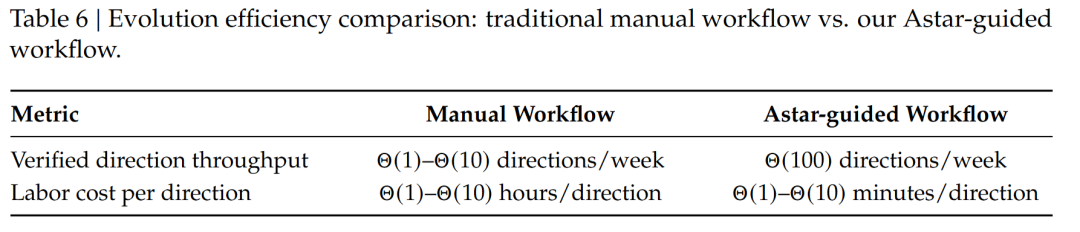
更惊人的是效率。过去,人类一周最多验证十几个方向;现在,Astar + 奖励模型 + 自动化 pipeline,能把单次试错成本从“天”压缩到“分钟”,迭代吞吐量提升一到两个数量级。
真金白银的验证:Lazada 推荐系统实战
理论再好,也得看线上表现。团队直接让 Astar “接管” 了阿里 Lazada 核心广告推荐系统的演进,在无人干预的情况下连续跑了 20 轮全自动迭代。
结果:
- 离线 HitRate@200 提升 23.6%
- 线上 GMV(商品交易总额)增长 4.86%
- 广告收入提升 1.82%
- 点击率和订单量同步显著上升
要知道,这是个已经被无数专家反复优化过的成熟系统。在这种地方还能靠 AI 自动生成的改进拿到真金白银的增长,足以说明 Astar 的实战能力。
Astar 到底提了什么“神仙建议”?
以其中一个真实案例为例。
当时团队尝试引入新一代 Muon 优化器。它的特点是通过正交化把梯度各方向的权重“拉平”,在干净数据上效果极佳。但在推荐场景中,数据充满噪声,这种“一刀切”反而放大了本该被抑制的随机波动。
通用大模型的建议通常是:“调低学习率”或“换回 Adam”。但 Astar 给出了一个极具数学美感的方案:
“在正交化之前,先做频谱降噪(Spectral Denoising)。”
具体来说,它建议利用随机矩阵理论中的 Marchenko-Pastur 定律,计算出一个确定的数学边界:高于边界的信号正常拉平,落入噪声分布区间的信号直接压制。
这个改动:
- 保留了 Muon 优化器的核心优势
- 解决了噪声放大问题
- 没有增加任何额外训练参数
这种直击痛点的修改,正是建立在 Astar 对该系统数据特性和算法数学本质的深度理解之上——而这恰恰是通用模型做不到的。
未来:人类设计 Meta-AI,AI 负责执行
Astar 的真正威力,还在于它的自我进化闭环:
- Astar 提出改进方向
- Code Agent 自动生成代码并启动实验
- 验证结果回流到系统
- 新数据反哺 Astar,使其指导能力持续增强
这意味着 Astar 是一个“活着”的模型,会随着系统一起成长。
但这并不意味着算法工程师会被取代。相反,分工正在升级:
- AI 负责:尝试微调、跑实验、验证效果
- 人类负责:设计元框架、定义新范式、构建更聪明的“造物飞轮”
当繁琐的试错劳动被自动化,人类的创造力才能真正聚焦于更高维的突破。AI 系统的无限进化之路才刚刚开始,而算法工程师,依然是这场变革的领航者。