GPT-6 Astra 解出最后一道 FrontierMath Tier 4 难题,研究级数学测试被刷穿
最后一道题被拿下,FrontierMath Tier 4 宣告饱和
2026 年 9 月,AI 在高等数学领域又迈过了一道关键门槛:GPT-6 Astra 成功解出了 FrontierMath Tier 4 中最后一道从未被 AI 攻破的题目。这意味着,这套专为测试顶尖大模型数学能力而设的研究级题库,所有题目都已被 AI 至少成功解答过一次。
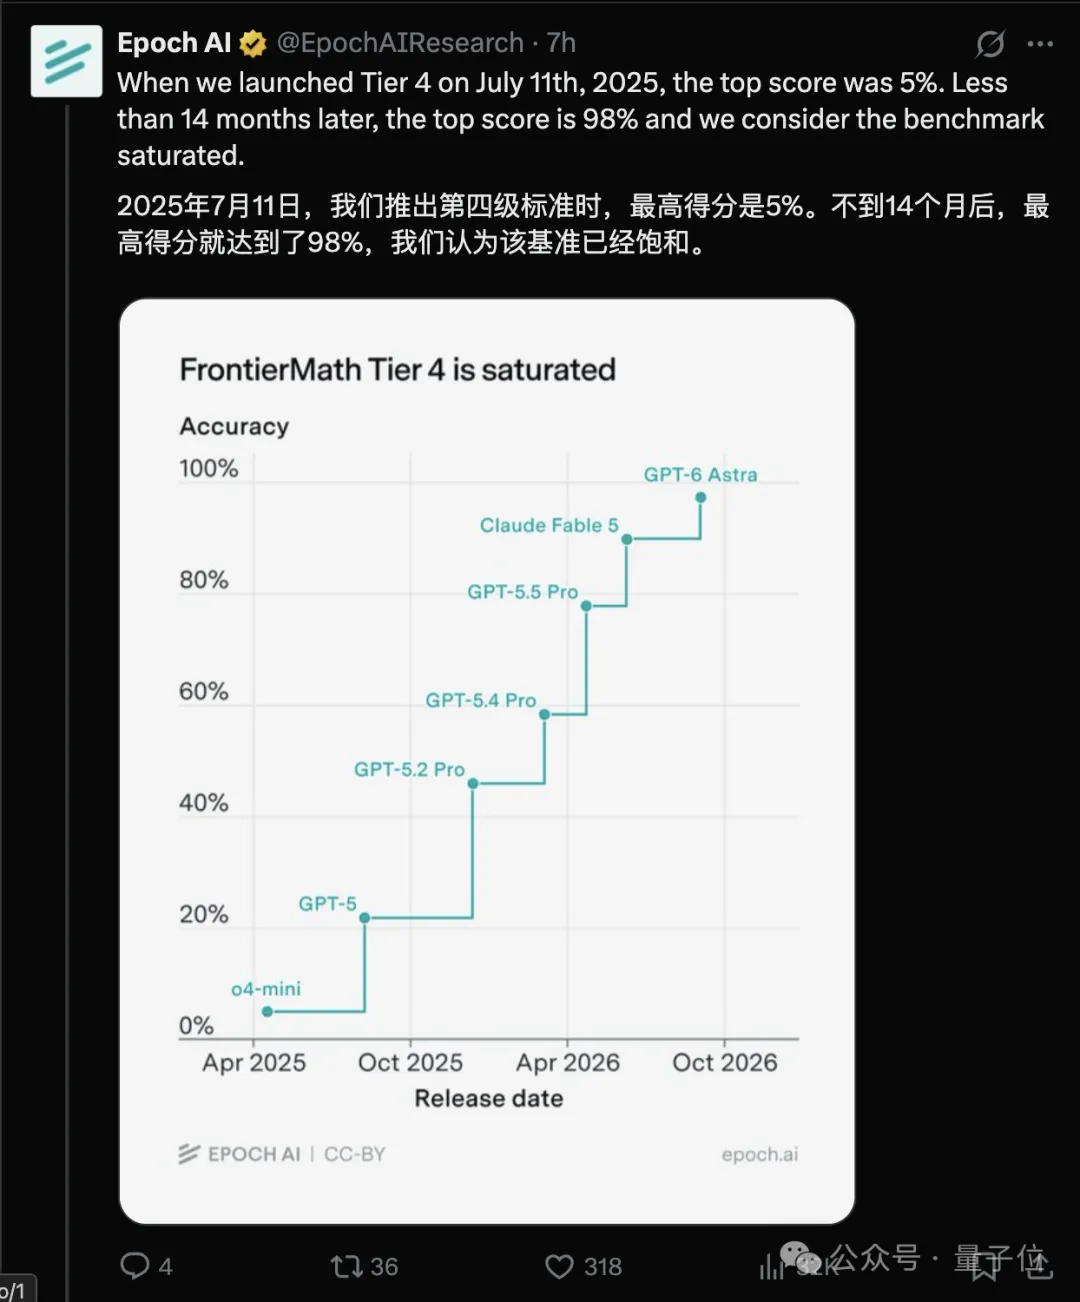
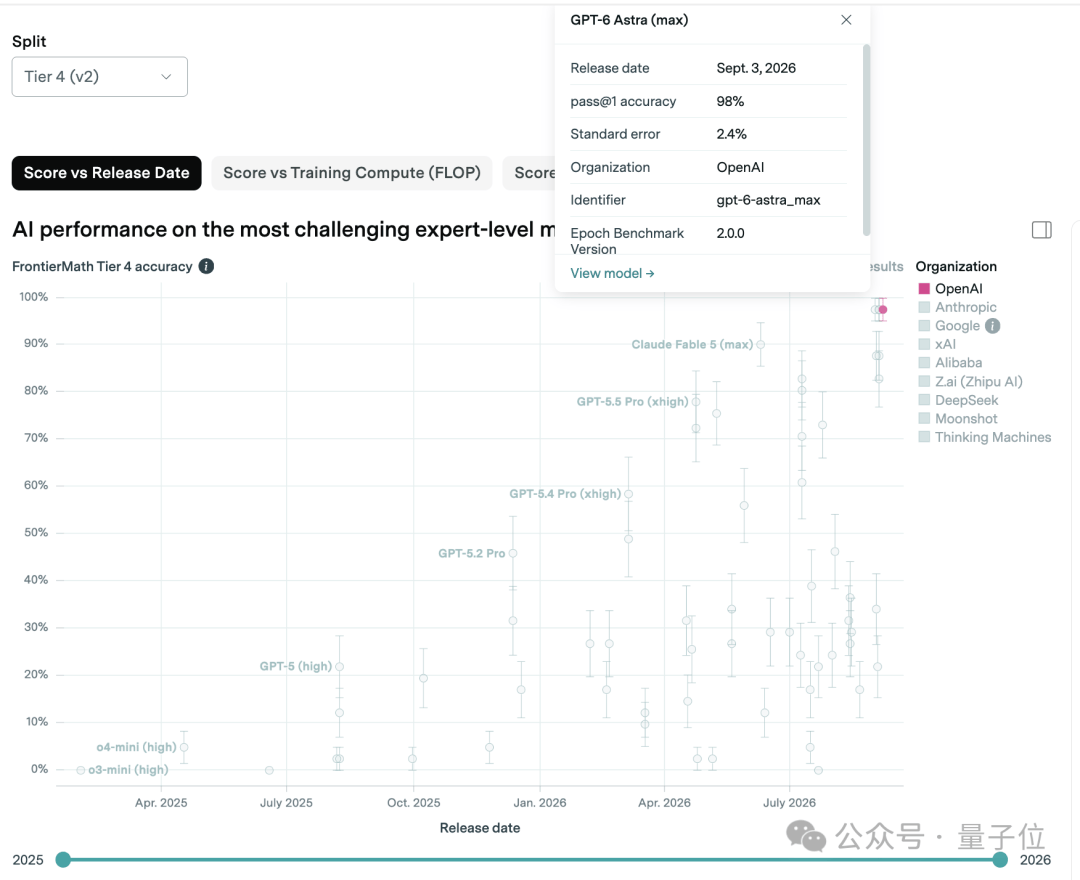
虽然 OpenAI 公布的 Astra 在 Tier 4 上的官方准确率为 97.6%,并未达到满分,但评估机构 Epoch AI 采用的是“累积饱和”标准——只要历史上不同模型、不同时间的尝试加起来,每道题都有过正确解答,就算整体饱和。Astra 此次攻克的,正是此前唯一一块“空白”。
这件事的意义不在于 Astra 单次测试多准,而在于它补上了最后一块拼图。曾经被视为 AI 数学“高墙”的 Tier 4,如今已变成可跨越的台阶。
从不到 2% 到全面饱和:一年半的飞跃
FrontierMath 最初在 2024 年底发布,初衷很简单:传统数学 benchmark 如 GSM8K 或 MATH 已经被头部模型刷到接近天花板,难以区分真正的能力差异。于是 Epoch AI 联合 60 多位数学家,包括菲尔兹奖得主陶哲轩、Timothy Gowers 和 Richard Borcherds,共同设计了一批从未公开的原创难题。
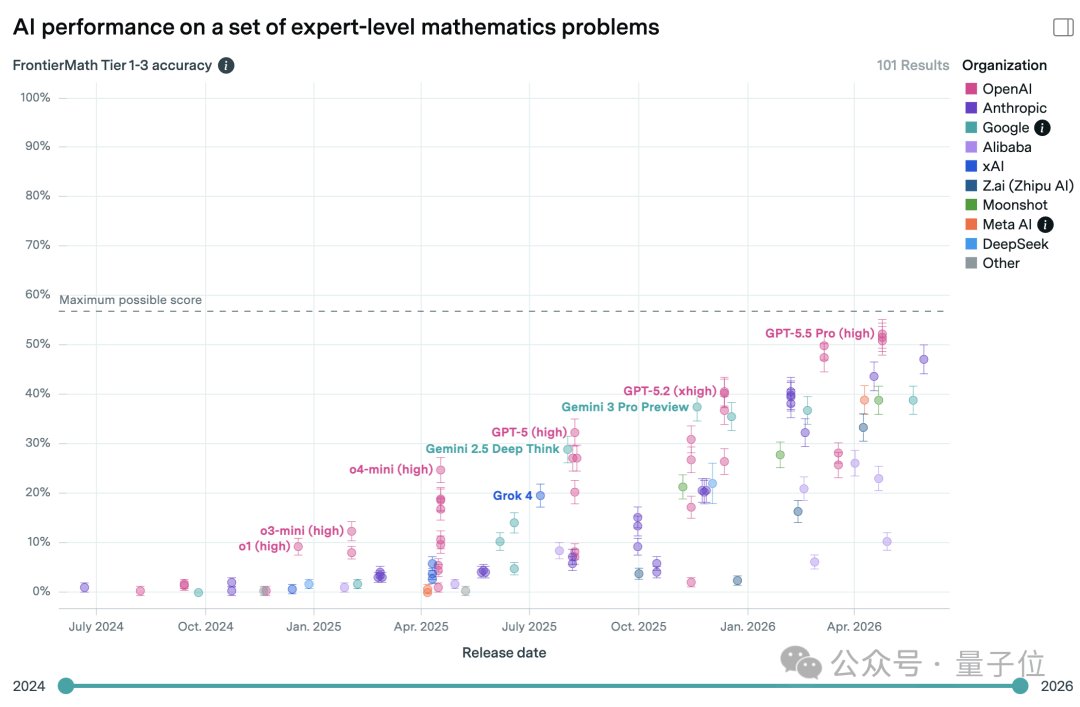
最初的题库分三级:Tier 1 接近高难度本科或奥赛水平;Tier 2 达到研究生高年级;Tier 3 则模拟博士生早期的研究探索问题。首轮测试结果令人安心——最强模型正确率还不到 2%。陶哲轩甚至认为 Tier 3 可能让 AI 卡上好几年。
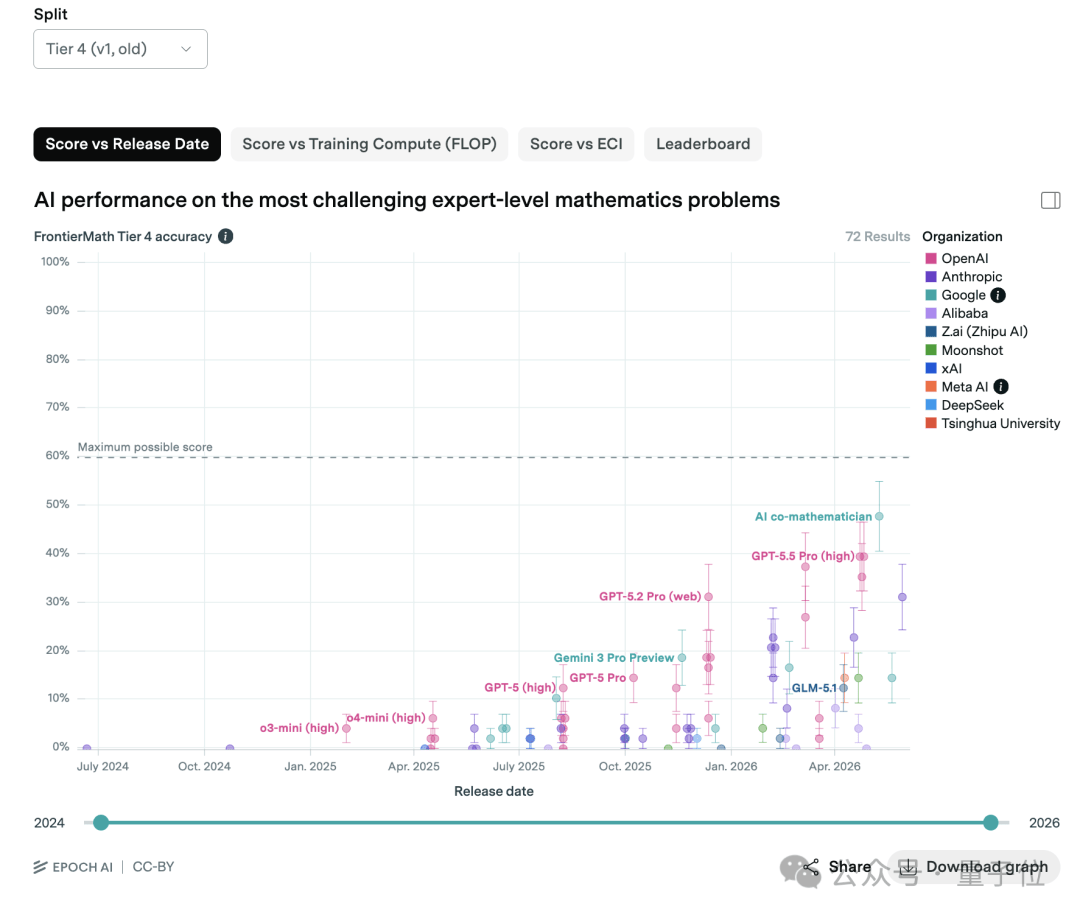
但推理模型的发展速度远超预期。到 2025 年中,前三级也开始被快速攻破。Epoch 不得不在同年 7 月新增 Tier 4,专门作为“研究级防线”。
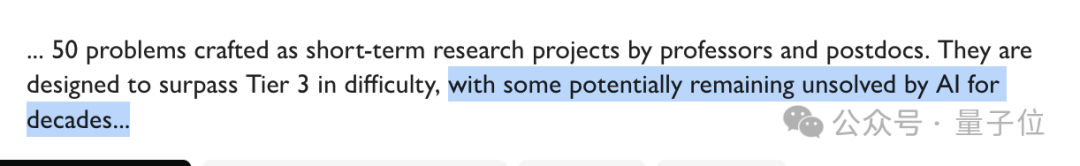
Tier 4 的 50 道题由数学教授和博士后围绕各自研究方向,花数周时间设计,再压缩成可自动验证的问题。覆盖领域包括分析、数论、组合数学、拓扑和代数几何等。发布初期,全部模型加起来只解出 3 道,且部分依赖未经充分论证的假设。Epoch 官网一度写道:“其中一些题,可能几十年都不会被 AI 解决。”
这句话现在看来有点过于乐观了。
题目修正与模型冲刺
随着模型变强,另一个问题浮现:题库本身存在瑕疵。OpenAI 在内部测试中发现 FrontierMath 错误比预想的多。Epoch 随即启动独立审计,先用 GPT-5.5 和 Claude Opus 4.7 筛查疑点,再交由数学家逐题复核。
2026 年 6 月,FrontierMath v2 发布:Tier 4 修正了 12 道题,移除了 7 道,最终保留 43 题。即便如此,模型成绩仍在飙升——GPT-5.6 Sol 达到 83.0%,Claude Fable 5 冲到 90.2%,而 GPT-6 Astra 直接将数字推至 97.6%。
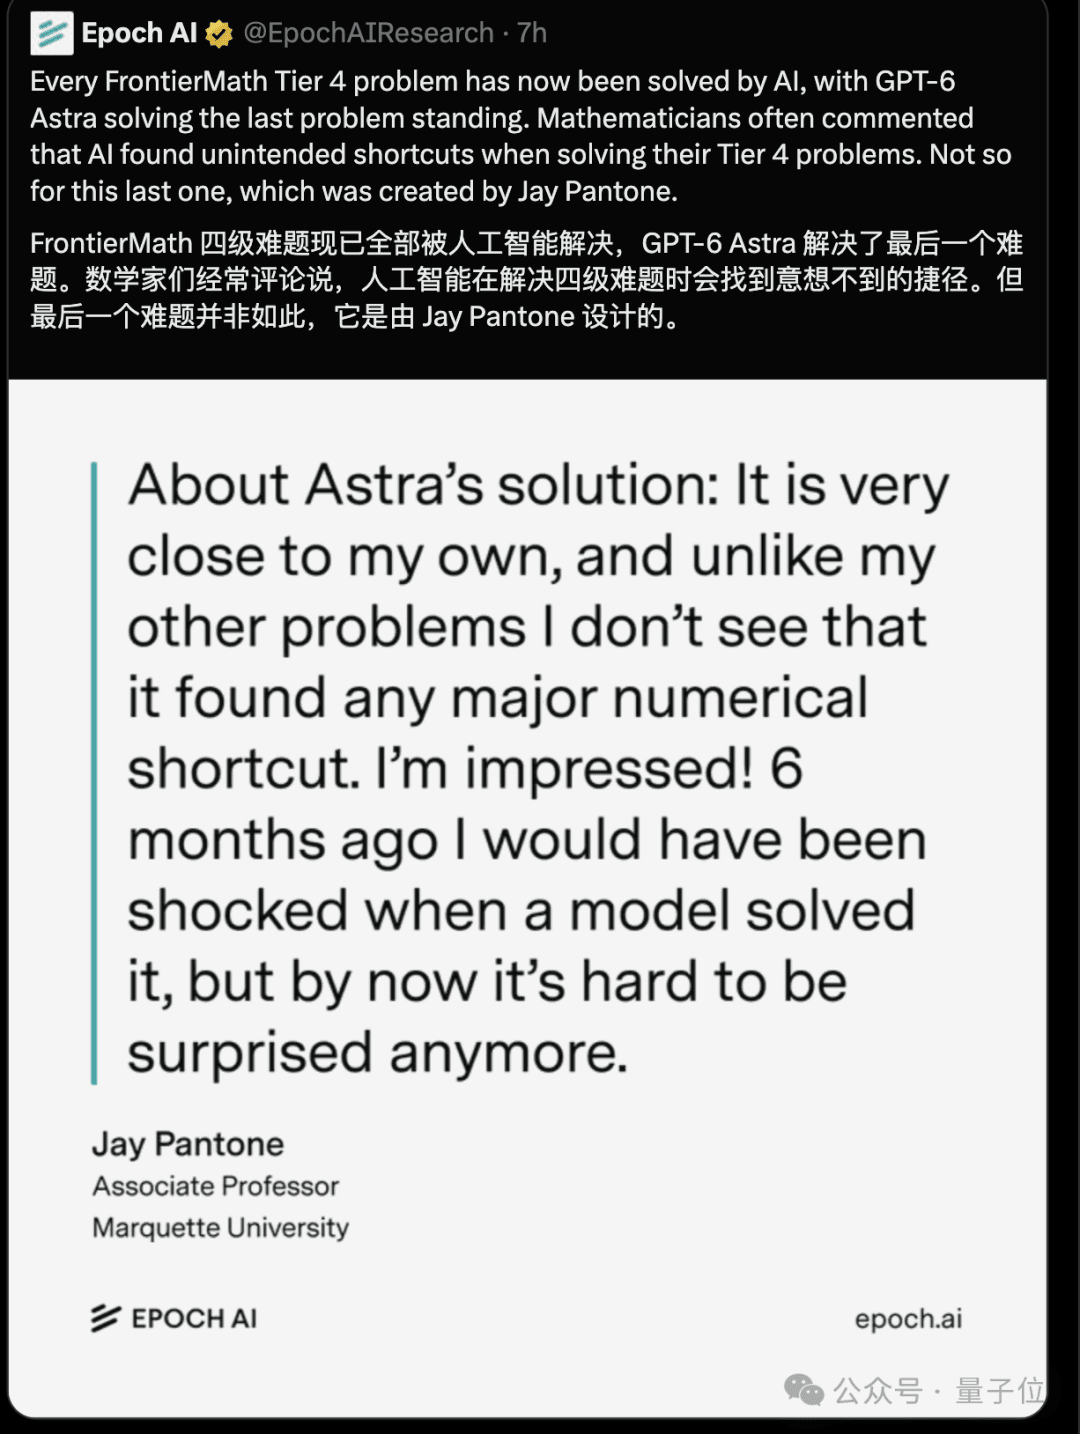
更重要的是,Astra 解出的那道题,是此前所有 AI 尝试中从未成功的。这标志着 Tier 4 的“理论防线”彻底失守。
解法更像人,而不是找捷径
马凯特大学数学副教授 Jay Pantone 是 FrontierMath 的核心出题人之一。他提到,以往 AI 解数学题常依赖数值计算或模式匹配等“捷径”,绕过真正的逻辑推理。但这次 Astra 对最后一题的解法,和他自己的思路相当接近。
“这说明模型不只是在猜答案,而是在进行某种形式的结构化推理,”Pantone 表示,“虽然我最近已经很难对 AI 的突破感到惊讶了——它们三天两头就在‘解决’千禧年难题。”
确实,数学已成为 GPT-6 Astra 展示能力的重点战场。但需要强调的是,Tier 4 被刷穿,并不等于“AI 已经掌握数学”。
下一关:真正的开放问题
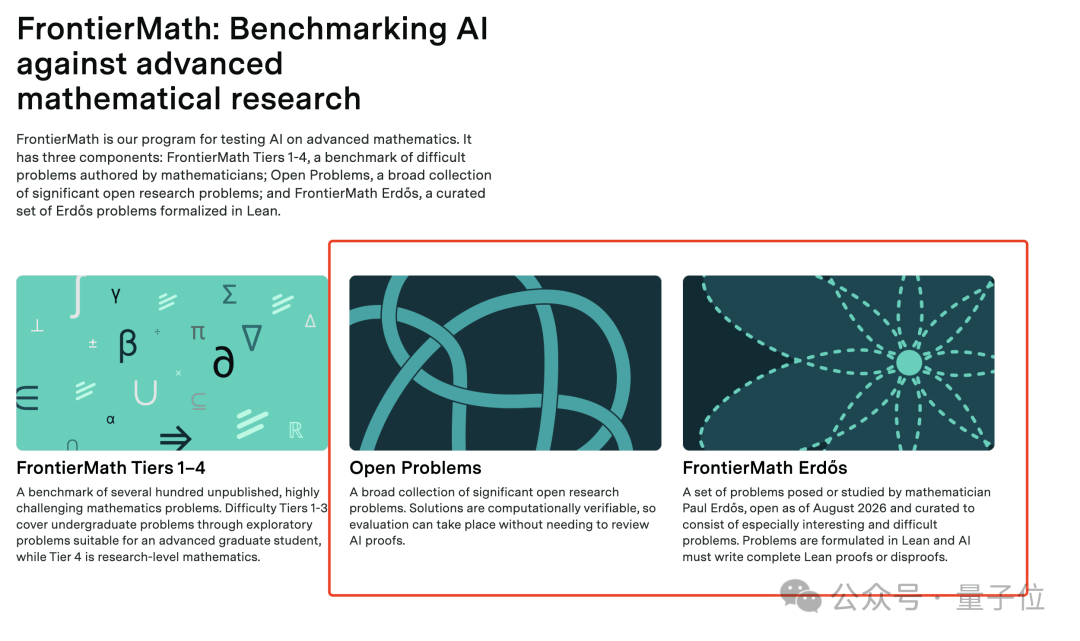
FrontierMath 团队早已意识到这一点。项目现已扩展出两个新方向:Open Problems 和 FrontierMath Erdős。
Open Problems 直接采用数学界尚未解决的真实研究问题,不再局限于“已有答案但难解”的范畴。而 FrontierMath Erdős 则更进一步:它将著名数学家保罗·厄多斯(Paul Erdős)提出的开放问题形式化进 Lean 证明助手,要求 AI 不仅给出答案,还要写出能通过机器验证的完整、严谨证明。
这才是真正的硬骨头。在最新测试中,GPT-6 Astra 面对 Erdős 的 68 道形式化问题,仅成功解决了 2 道。
这说明,当前 AI 在自由探索、构建全新理论框架、以及处理无明确路径的开放问题上,仍有巨大差距。FrontierMath Tier 4 的饱和,更像是一个阶段性终点,而非终点本身。
数学 benchmark 的未来挑战
FrontierMath 的演变也揭示了一个深层问题:当 AI 快速适应现有评测体系时,benchmark 本身必须持续进化。从最初防刷穿的设计,到后来因错误频出而修订,再到引入真正未解之谜,这个过程本身就是一场人机博弈。
未来,有效的数学评测可能不再只是“解题”,而是“提问”——能否识别有价值的问题?能否提出合理的猜想?能否在证明失败时调整策略?这些能力目前仍牢牢掌握在人类手中。
GPT-6 Astra 的突破值得肯定,但它更像是站在巨人肩膀上的又一次跳跃。数学的真正前沿,依然广阔而未知。