在单块 GPU 上从头训练 2.1 亿参数文生图模型:哪些因素真正起作用
数据在训练开始前就决定了结果
作者早期尝试使用百万级网络爬取图片配合重写标题训练模型,结果比仅用 COCO 数据集还差——图片质量参差不齐,标题与内容严重不符。这次他采取了更笨但有效的方法:从每个候选数据集中随机抽取二十张图片,在 256×256 分辨率下肉眼检查,再决定是否采用。
最终训练数据由三部分组成:60% 来自 Pexels 的高质量免版税照片(280 万张),25% 是 FLUX-Reason-6M 中经过美学评分筛选的子集(120 万张),剩下 15% 为 COCO 2017 训练集(11.8 万张)。每张图配有长短两个版本的标题,训练时 50% 概率用长标题(最多 128 个 T5 token),40% 用短标题,10% 使用空标题以支持分类器自由引导(CFG)。纯长标题会削弱对简短提示的响应能力,而只有短标题则影响画面构图。
特别值得注意的是图片裁剪策略。传统做法常将图片中心裁成正方形,但这会丢弃 94% 的 COCO 图片和 99% 的 Pexels 图片——因为真实摄影多为 4:3 或 3:2 画幅。tinydit 改用五种宽高比桶(256×256、288×224、224×288、320×208、208×320),每批数据只从一个桶中采样,且不做中心裁剪,仅做轻微缩放(长边最多裁掉 3–5%)。配合二维旋转位置编码(2D RoPE),模型甚至能泛化到从未见过的 448×256 画幅。
架构采用当前主流方案并加入寄存器
tinydit 的 Transformer 并非原创设计,而是复现了当前主流文生图模型的标准结构:基于 DiT(Diffusion Transformer),通过交叉注意力接入文本特征(类似 PixArt 和 SANA,不同于 FLUX 和 SD3 的联合注意力),配备 2D RoPE、QK 归一化、SwiGLU 前馈网络,以及 adaLN-single 调制机制。后者用一个共享调制网络加小型每层参数表替代传统的全连接层,节省了 27% 的参数量,省下的空间用于增加深度——最终模型宽度 896,16 层,14 个注意力头,总计 2.1 亿参数。
唯一新增的是“寄存器”(registers)机制,源自《Vision Transformers Need Registers》等近期研究。从第 3 层开始,16 个可学习的寄存器 token 被插入图像序列,并在输出前移除;同时每个交叉注意力层额外引入两个可学习的“空”键值槽(null key/value slots)。这些设计为模型提供了存放全局状态和“无目标注意力”的专用位置,避免其滥用图像中的某个随机 patch 或文本编码器的结束符(EOS)来承担此功能。

实测效果显著:在中等噪声水平的中间层,约 90% 的交叉注意力权重流向这两个空槽,而原本被当作“垃圾桶”的 EOS token 仅占 4%。寄存器向量的范数在中间层达到图像 token 的 4–13 倍,符合“暂存空间”的特征;每个图像 patch 也会将 8–18% 的自注意力分配给寄存器。
训练配方:时间步偏移、两项辅助损失与编译加速
时间步偏移(timestep shift)设为 2.8。tinydit 基于 rectified flow 框架,预测从噪声到图像的速度向量,时间步按对数正态分布采样(同 SD3)。由于使用 FLUX.2 自编码器生成的潜变量有 32 通道(远多于 Stable Diffusion 的 4 通道),图像在更高噪声水平下仍可辨识。为让模型在高噪声区域获得足够训练,需人为增加噪声强度。设置偏移后,一半训练样本的噪声比例超过 74%,且 20 步采样中有 15 步落在该区域——这正是画面布局形成的关键阶段。

两项辅助损失:一是速度方向的余弦损失(来自 LightningDiT),因为在高噪声下均方误差(MSE)主要受向量模长影响,而方向才决定最终图像内容;二是第 5 层特征的离散损失(dispersive loss,Wang & He, 2025),通过拉大不同样本内部表征的距离防止特征坍缩,且无需额外编码器,几乎零开销。
全程启用 torch.compile。很多人以为编译只用于推理,其实它对训练同样有效:Dynamo 跟踪前向计算,AOTAutograd 自动生成反向传播,Inductor 则融合矩阵乘法周围的逐元素操作。实测训练速度提升 2.4 倍,显存占用减半。唯一限制是要求静态形状,因此五个宽高比桶各自编译独立计算图。
其余配置包括:AdamW 优化器(学习率 2e-4,betas (0.9, 0.95)),bf16 自动混合精度配合 fp32 主权重,权重指数移动平均(EMA,衰减率 0.9999,对应约 1 万步窗口),批量大小 256,学习率在最后四分之一训练步数线性衰减至零。最终每步耗时 0.76 秒,40 万步训练在 3.5 天内完成。
损失值不是质量信号
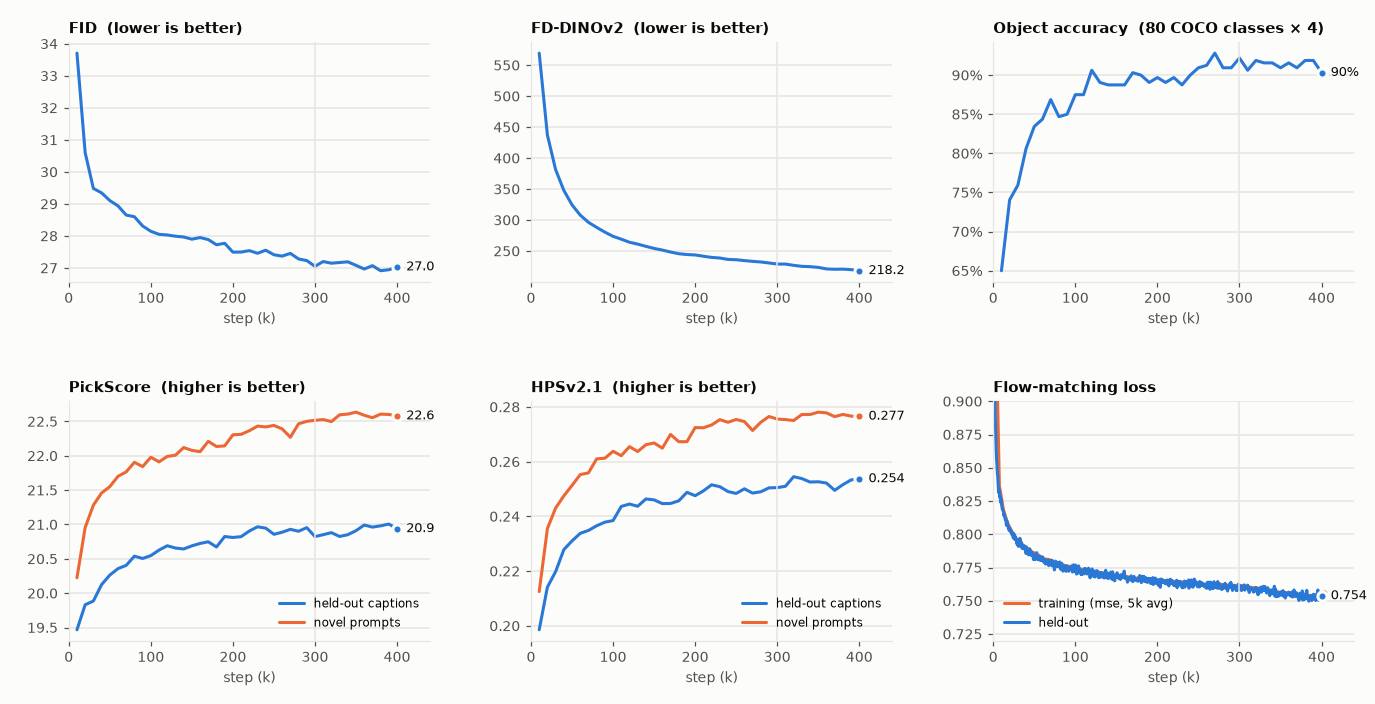
整个训练过程中,flow-matching 损失仅从 0.805 缓慢降至 0.754,但生成图像却从模糊色块进化为清晰照片。原因在于:对于给定的带噪输入,存在多个合理的“干净图像+噪声”组合,模型最优预测只能是它们的平均值,而围绕该平均值的方差构成了无法消除的“不可约误差”。在高噪声区域(占训练一半),这部分误差占主导,导致损失值变化微弱。
因此损失值仅能反映训练是否正常(训练集与验证集损失始终在小数点后三位一致,证明未发生过拟合),却无法衡量生成质量。作者每 1 万步在固定验证提示集上评估多项指标:FID、FD-DINOv2(基于 DINOv2 特征的 Fréchet 距离)、COCO 80 类物体检测准确率(用预训练检测器验证“一张 {类别} 的照片”是否包含目标物体),以及人类偏好模型 PickScore 和 HPSv2.1 的得分。
结果显示:FID 和物体准确率在 30 万步左右趋于饱和,而 FD-DINOv2 和偏好得分持续提升至训练结束。最后 10 万步的学习率衰减使 FD-DINOv2 进一步提升 5%。
| 步数 | FID | FD-DINOv2 | 物体准确率 | PickScore | HPSv2.1 |
|---|---|---|---|---|---|
| 1万 | 33.7 | 570 | 65% | 19.5 | 0.199 |
| 10万 | 28.1 | 274 | 88% | 20.6 | 0.238 |
| 40万 | 27.0 | 218 | 90% | 20.9 | 0.254 |
模型能力与局限
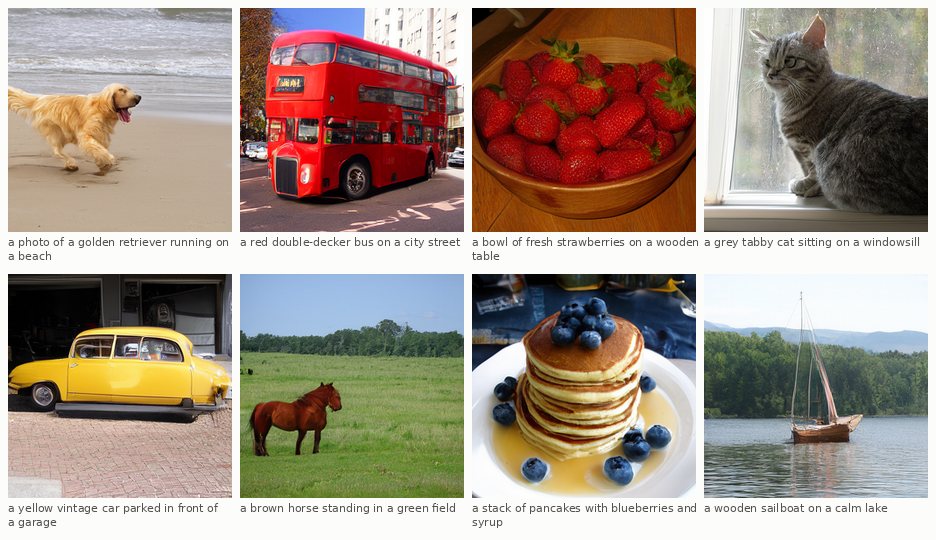
tinydit 能稳定生成单个物体、动物、场景、颜色及简单空间关系(如“左边的猫,右边的狗”),且在全部五种宽高比下表现一致。对于训练风格的长提示,也能遵循主句描述。
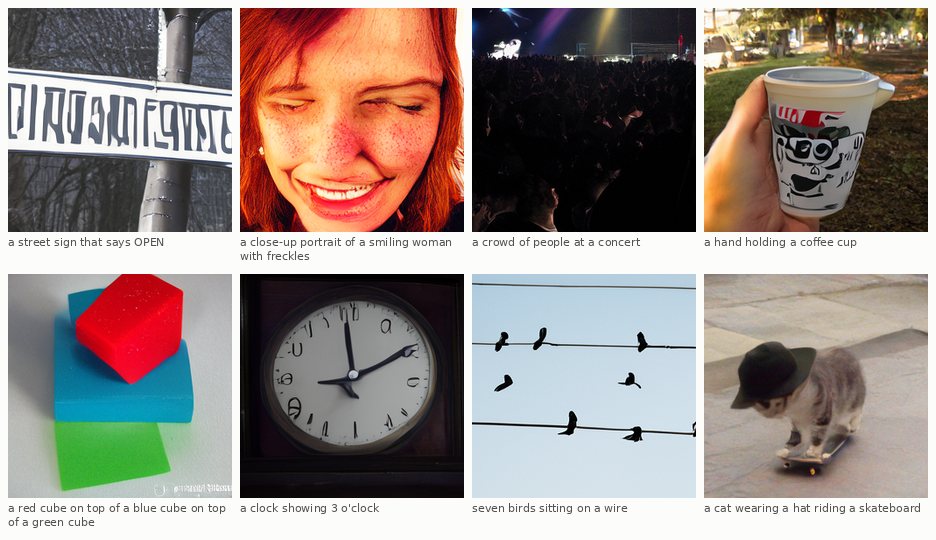
但以下任务仍是明显短板:
- 可读文字(如招牌、书本内容)
- 近距离人脸细节
- 人群(三人以上)
- 精确计数(超过三个物体)
- 钟表指针位置
- 多层堆叠几何体(如积木塔)
这些正是 2.1 亿参数模型在 256 分辨率下的天然边界,也将成为下一阶段强化学习的重点优化目标。
关于采样步数,作者发现 20 步已足够:模型自身对最终图像的预测显示,画面布局在前三步就已确定,后续步骤仅用于细节锐化。在 2456 个验证提示上测试,50 步相比 20 步仅带来 0.4 的 FID 提升,且对偏好得分毫无帮助;而若移除训练时的时间步偏移,即使加倍采样步数也无法弥补性能损失。
给后来者的五条建议
- 先看数据:在训练分辨率下肉眼检查每个候选数据集的真实样本,这比任何架构选择都重要。
- 匹配潜变量的时间步分布:32 通道潜变量需要约 2.8 的时间步偏移,否则模型会在布局形成的关键区域欠训练。
- 从第一步就用宽高比桶:放弃“先正方形预热再扩展”的习惯,直接保留原始构图,因为标题描述的往往是被裁掉的边缘内容。
- 别信损失值:选定两三个可每小时计算的指标(如 FID、物体准确率),并固定验证提示集以保证可比性。
- 编译训练过程:这是你能获得的最便宜的 2 倍加速。
目前 tinydit 故意未做蒸馏,也未使用高级 CFG 变体,因为下一步计划是基于 Flow-GRPO 的强化学习,直接用上述偏好模型作为奖励信号,针对性改进失败案例。相关成果将作为同一仓库的第二版发布。
项目代码、权重、在线 Demo 及更新均已在 Hugging Face 和 GitHub 开源。