LingBot-Map:仅用普通摄像头实现实时流式3D重建
机器人开始学会“记住”世界
人走进一个陌生房间,不会把看到的画面一帧不落地存进脑子。我们会记住门在哪、桌子在哪、自己刚从哪边过来,以及现在站在什么位置。这种选择性记忆,支撑着我们在复杂环境里持续行动。
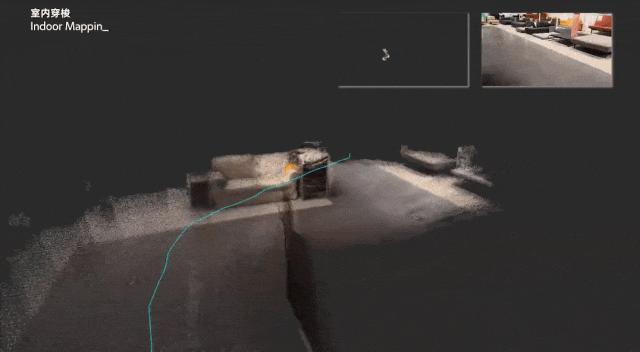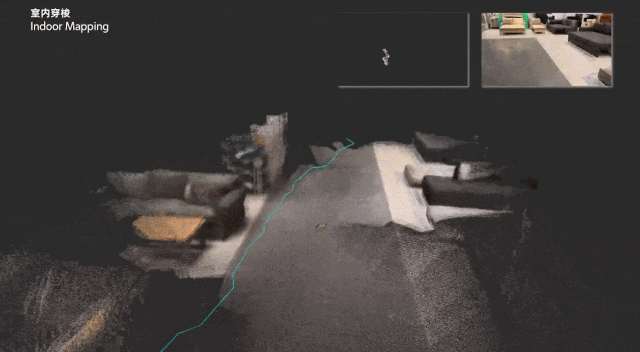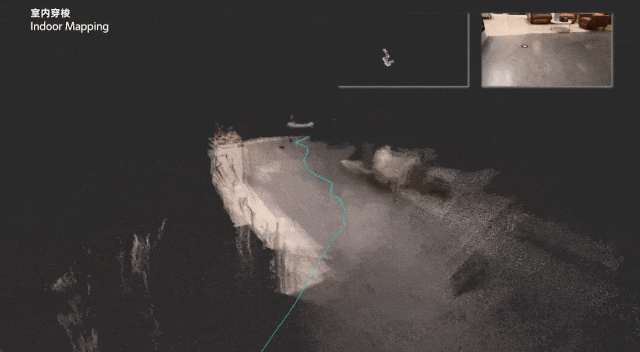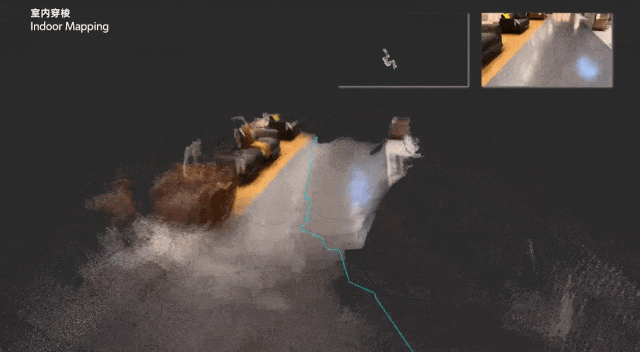
对机器人来说,这也是走向真实世界必须跨过的一道坎——不是简单地“看见”,而是“记住”并“理解”自己走过的空间。
今年4月,蚂蚁灵波开源的 LingBot-Map 正是在这个问题上迈出了一步。它不需要激光雷达,也不依赖多传感器融合,仅靠一颗普通的RGB摄像头,就能在视频流输入过程中,实时估计相机位姿并重建三维场景结构。这意味着机器人可以在移动中不断更新对环境的认知,而不会因为走得太远就“迷路”或“记混”。
更关键的是,这套系统在处理长达上万帧的视频序列时,内存占用和计算量几乎不随时间增长。这解决了流式3D重建长期存在的核心矛盾:既要保留足够历史信息以维持空间一致性,又不能让资源消耗无限膨胀。
截至目前,LingBot-Map 的 GitHub 项目已收获 16.9K Stars 和 1.9K Forks,多次登上 Trending 榜单。近日,其论文《Geometric Context Transformer for Streaming 3D Reconstruction》被 ECCV 2026 接收为 Oral 报告,并在会议 Award Candidates 名单中亮相。从开发者社区到顶级学术会议,这项工作完成了双重验证。
开源之后:社区自发推动落地
顶会认可固然重要,但真正体现技术生命力的,是它能否被普通人用起来。

LingBot-Map 开源后不久,就有开发者为其打造了可在 Apple Silicon Mac 上运行的原生桌面应用,包含3D点云查看器,让用户能直观浏览重建结果。还有人基于 Pinokio 制作了一键启动脚本,自动处理环境配置和依赖安装,大幅降低了体验门槛。

这些工具的意义在于:把一篇论文里的算法,变成了普通人点几下就能跑起来的软件。对于很多研究项目来说,这一步往往最难跨越。
与此同时,硬件适配也在快速推进。有开发者针对 RTX 4060 8GB 显存设备优化了运行策略,成功让 LingBot-Map 在轻量级 GPU 上稳定运行。这意味着它不再局限于高端工作站,而是有机会进入更多普通开发者的实验环境。
更有意思的是,有人直接把它接到了消费级设备上。一位用户将 Ray-Ban Meta Gen-2 智能眼镜(本身没有 LiDAR)改造成3D扫描仪:通过手机 App 采集视频,上传到云端 RunPod 实例运行 LingBot-Map,30秒内就生成了所在房间的三维地图。即使只用了几十秒的视频片段,室内结构依然清晰可辨。
另一次测试中,他在一台普通戴尔台式机上对着办公桌拍了一段视频,61.5秒后得到了一个可交互浏览的点云模型。这些尝试说明,LingBot-Map 已经开始走出实验室,进入真实的使用场景。
官方团队也在持续更新评测脚本、推理优化和示例案例。他们甚至展示了处理 25,000帧、持续13分钟 的室内行走视频的结果——模型依然能保持连续重建,没有出现明显的漂移或断裂。
核心突破:三层空间记忆机制
那么,LingBot-Map 到底解决了什么问题?为什么它既能被社区广泛采用,又能打动 ECCV 的审稿人?
答案藏在它的核心设计——Geometric Context Attention(GCA,几何上下文注意力) 中。
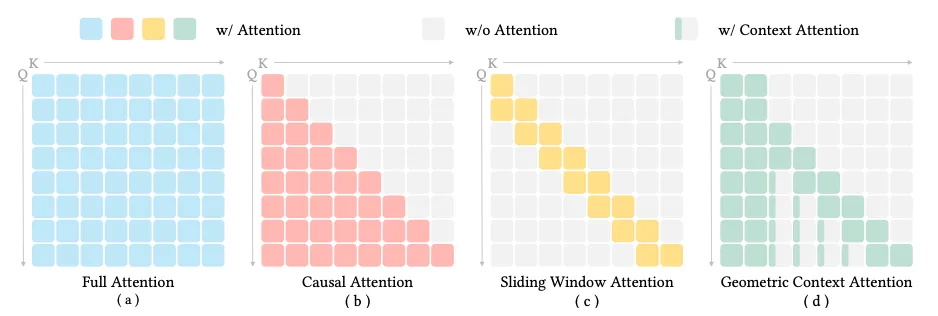
传统流式重建方法面临一个两难:如果缓存所有历史帧(如 causal attention),显存和计算量会随时间线性增长;如果只保留最近几帧(如滑动窗口),又容易丢失长期一致性,导致轨迹漂移;而结合 SLAM 的方案虽稳定,但依赖人工规则和后端优化,难以实时运行。
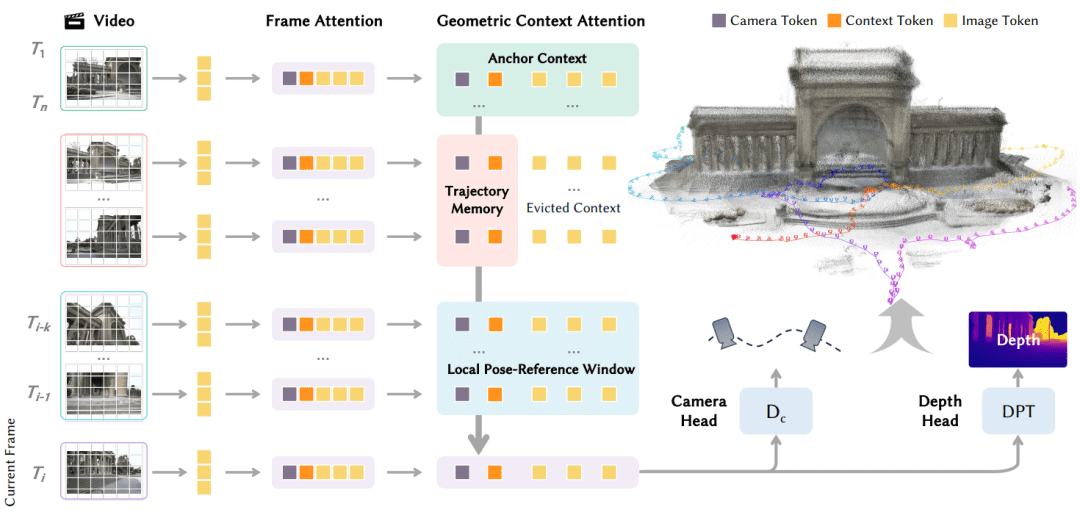
LingBot-Map 的思路是:像人类一样,只记住最关键的空间线索。它把流式状态拆成三层:
- Anchor Context(锚点上下文):记住“我从哪里出发”。这为整个坐标系提供固定参考,防止全局漂移。哪怕处理到第10000帧,模型仍清楚第一帧的位置。
- Local Pose-Reference Window(局部姿态参考窗口):聚焦“我身边有什么”。用于精确估计当前帧的位姿和深度,保证局部重建质量。
- Trajectory Memory(轨迹记忆):压缩“我走过的路”。将庞大的历史信息提炼成极紧凑的逐帧 Token,以极低存储代价保留路径印象。
这种设计带来了惊人的效率提升。在1万帧序列中,传统 causal attention 需要约500万 token,而 GCA 只需约7万,压缩近80倍。更重要的是,每处理一帧新画面,新增的计算量和内存占用几乎恒定,不随总帧数增加。
实测表现:精度与效率兼得
在 Oxford Spires 数据集上的测试验证了这一设计的有效性。
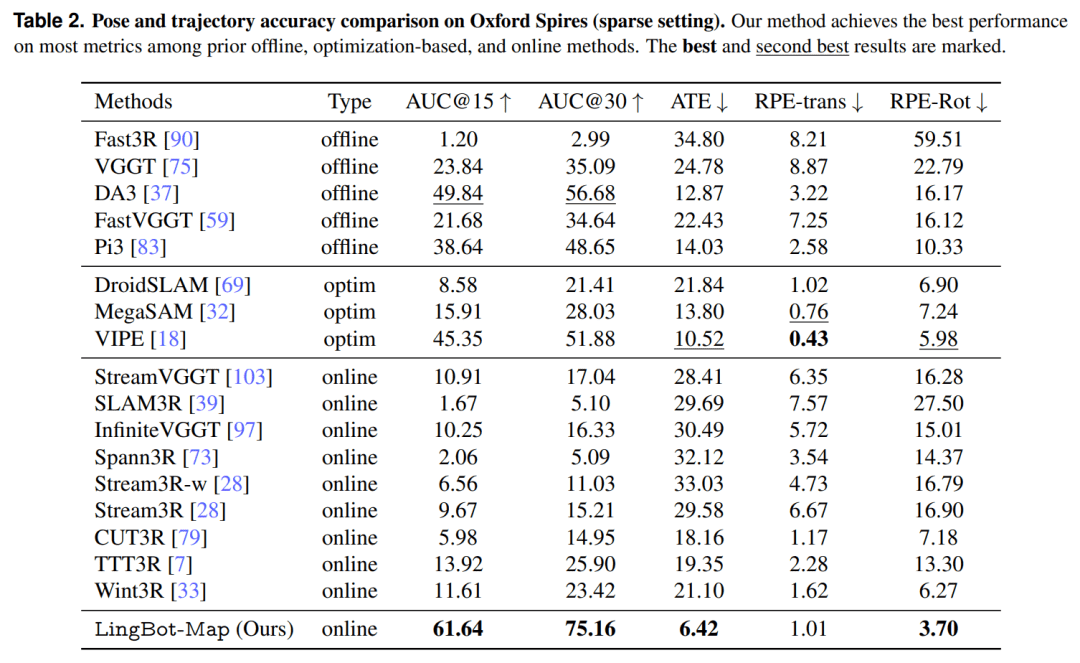
在稀疏设置(320帧)下,LingBot-Map 的 AUC@15 达到 61.64,远超最强离线方法 DA3(49.84)和 VGGT(23.84)。轨迹误差(ATE)也从 DA3 的12.87米降至 6.42米。
即便与依赖重投影优化的传统方法比,它也胜出:AUC@15(61.64 vs. VIPE 的45.35)、ATE(6.42 vs. 10.52)均占优。
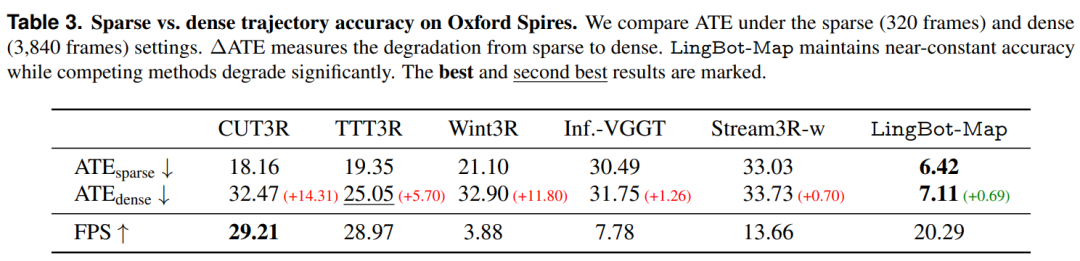
在密集设置(3840帧)的压力测试中,大多数流式方法因累计漂移导致性能骤降,而 LingBot-Map 的 ATE 仅从6.42增至7.11——序列长度扩大12倍,误差只增加0.69。
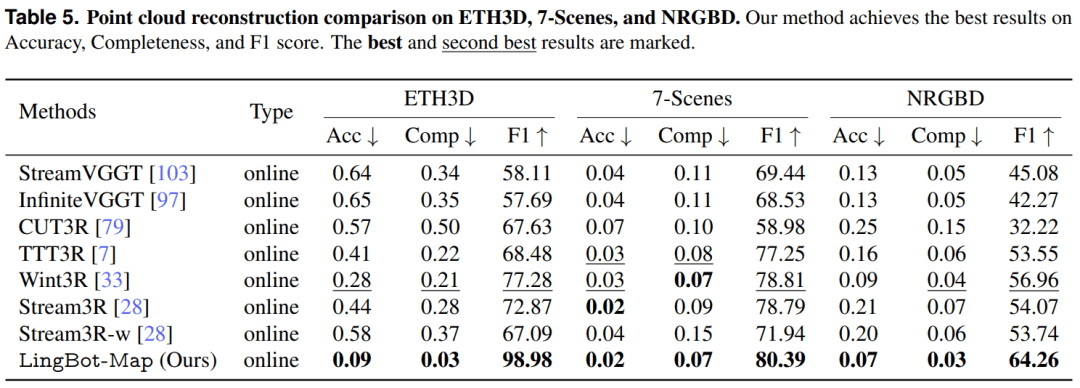
点云重建方面,在 ETH3D、7-Scenes 和 NRGBD 三个数据集上,LingBot-Map 均取得最高 F1 分数。尤其在 ETH3D 上,F1 达 98.98,比第二名高出21.7个百分点。
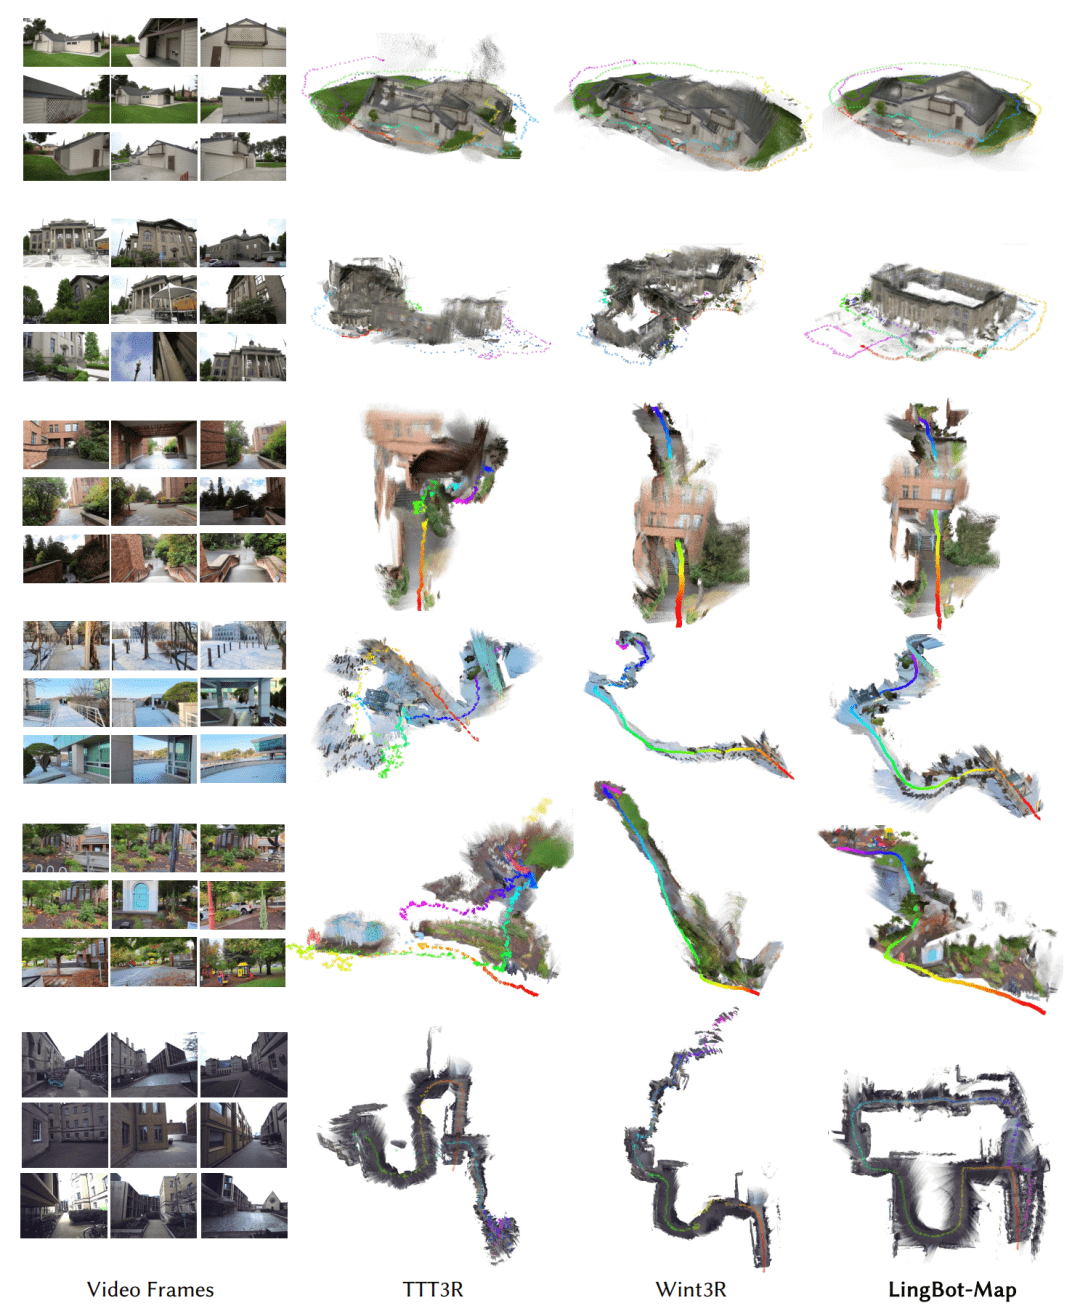
定性对比更直观:在简单场景中,竞品已出现边缘错位;在复杂室内,它们生成重复结构或模糊表面;而在最具挑战的多建筑室外场景中,TTT3R 和 Wint3R 的点云几乎坍缩成碎片,LingBot-Map 却始终保持清晰的几何结构和连续墙面。
蚂蚁灵波的空间智能拼图
LingBot-Map 并非孤立存在。它是蚂蚁灵波构建机器人空间感知体系的关键一环。
这套体系包含三个模块:
- LingBot-Vision:聚焦视觉结构理解。它提出“掩码边界建模”,让模型自主学习亚像素级物体轮廓,无需人工标注或额外边缘检测器。
- LingBot-Depth:解决高精度空间感知。通过“掩码深度建模”,利用 RGB 图像中的上下文推断缺失区域的深度,尤其擅长处理透明、反光等传统方法易失效的场景。
- LingBot-Map:实现持续空间记忆。将连续视频组织成稳定的三维表示,支持机器人在移动中更新环境认知。
三者串联,形成一条从“看见”到“理解”再到“记住”的完整链路。当机器人具备这种能力,才可能完成复杂的导航、巡检或操作任务。
LingBot-Map 所推动的,正是机器人从被动观察走向主动利用环境的关键转变——不是仅仅记录世界,而是记住它、理解它,并在此基础上行动。