HSImul3R:让人类视频中的动作真正能被机器人执行的三维重建框架
为什么“看起来坐下了”不等于“真的坐稳了”?
你拍一段自己坐到椅子上的视频,发给朋友,对方一眼就明白发生了什么。但如果你把这段视频交给一个机器人系统,让它“学会”这个动作,事情就没那么简单了。
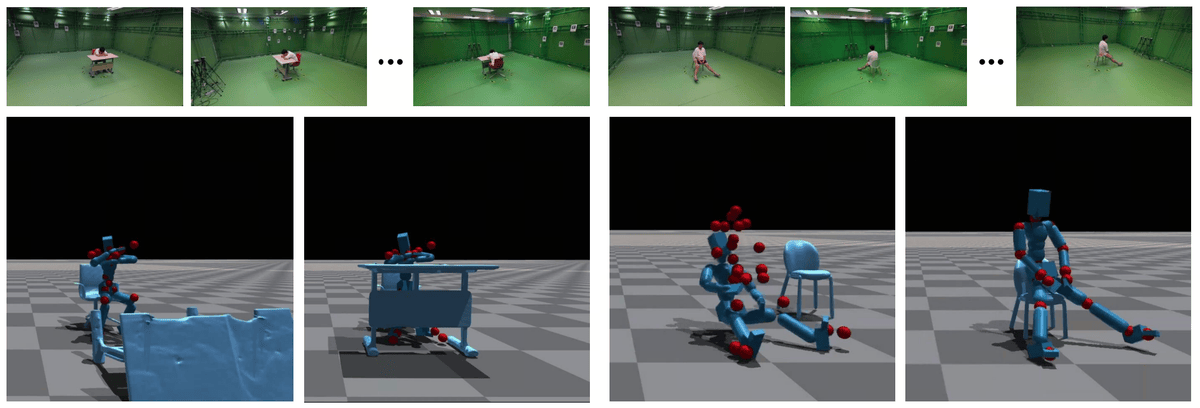
现在的三维重建技术已经能做到:从视频里恢复出你的身体姿态、椅子的形状,甚至让两者在画面里对齐得不错。可一旦把这些数据放进物理仿真器,问题就来了——椅子可能因为结构缺失而倾倒,你的虚拟身体可能直接“穿”进椅面,或者为了保持平衡而偏离座位。视觉上成立的动作,在物理世界里根本站不住脚。
这就是所谓的“感知—仿真鸿沟”:机器看得见动作,却无法确保这个动作在真实物理规则下能成立。而机器人最终要面对的,恰恰是一个由重力、碰撞、摩擦和接触决定的世界。
最近,大晓机器人联合南洋理工大学 S-Lab 和上海人工智能实验室提出了 HSImul3R,试图填平这条鸿沟。它的目标很明确:不再满足于“重建得像”,而是要让重建结果真正能放进物理仿真里跑起来,并且保持原有的人–物交互关系。这项工作已被 ECCV 2026 接收。
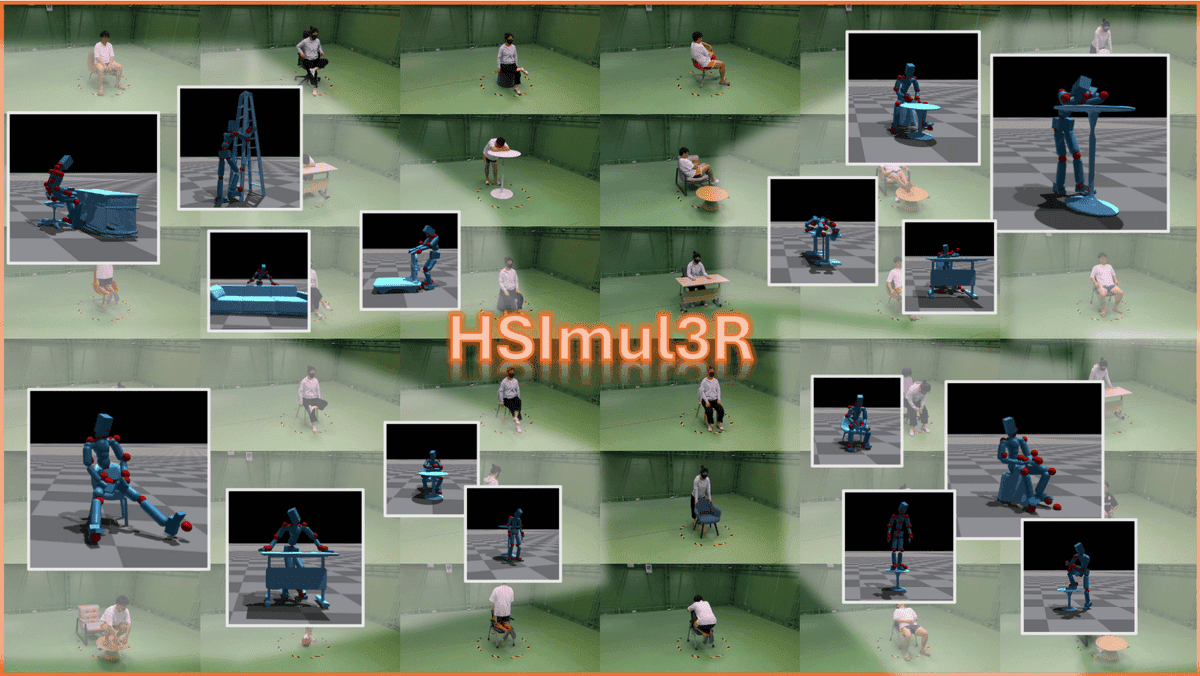
从“视觉正确”转向“物理可执行”
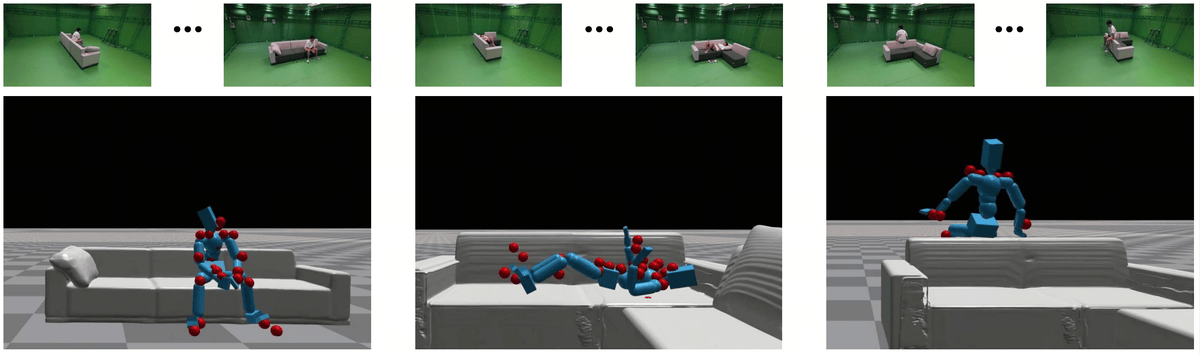
传统三维重建的评价标准,主要看几何误差、姿态还原度、视觉对齐效果。这些指标回答的是“像不像”的问题。但对具身智能(embodied AI)来说,“像”远远不够。机器人需要的是能执行的动作,而不是能渲染的动作。
HSImul3R 的核心转变在于,它把重力稳定性、真实接触和交互稳定性作为重建的核心目标。这意味着:
- 重建出来的椅子必须能在重力下站稳;
- 人坐下去时,身体不能穿模,必须与椅面形成有效接触;
- 整个交互过程在仿真中不能崩塌,比如椅子翻倒或人滑落。
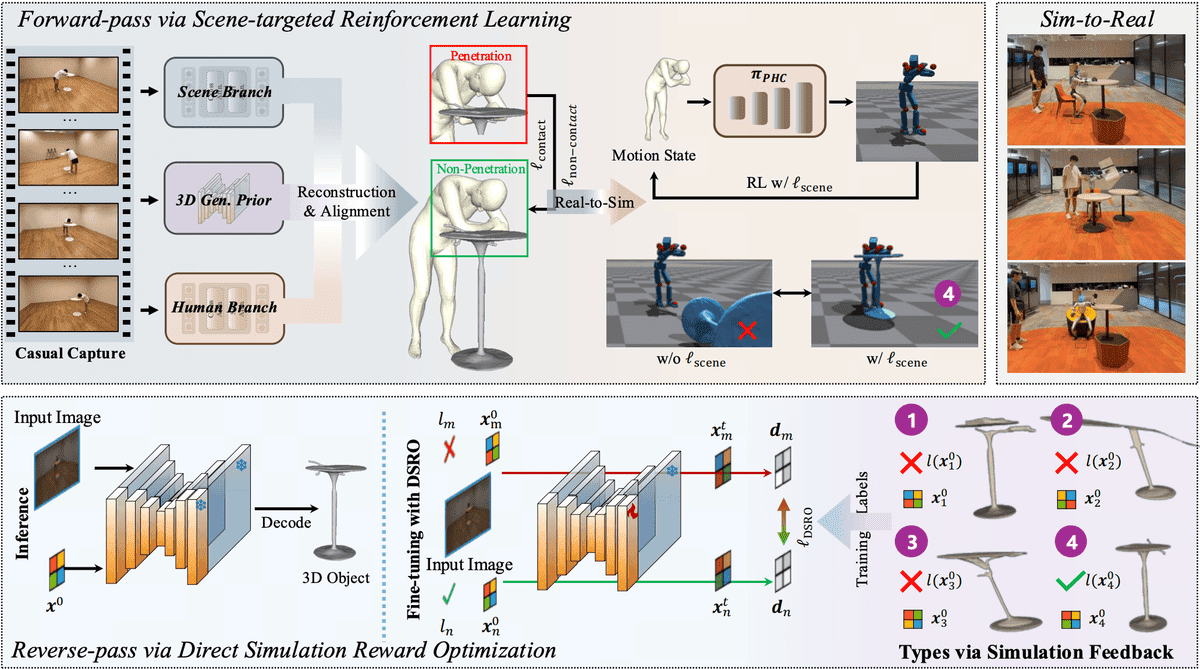
更关键的是,HSImul3R 不是先重建完再拿去仿真验证,而是让物理仿真器直接参与重建过程。它提出了一种“物理闭环”(Physics-in-the-Loop)的双向优化机制:一边优化人体动作,一边修正场景模型,仿真反馈成为重建的监督信号。
让人体动作真正“适配”当前场景
很多动作重建方法会用强化学习来优化人体运动,确保动作符合物理规律。但它们往往只关注人体自身是否稳定,忽略了与场景的交互。
举个例子:原始视频里你坐在椅子上。普通优化可能让你的身体在空中保持平衡,但为了不摔倒,你稍微往旁边挪了一点——结果就是,你没坐到椅子上。动作“可行”,但交互“失效”了。
HSImul3R 引入了 面向场景的强化学习(Scene-targeted Reinforcement Learning)。它在优化过程中加入了场景约束:系统会检测人体关键点(如臀部、手肘)与物体表面的距离,确保优化后的动作不仅动力学合理,还能准确落在目标物体上。
换句话说,它优化的不是一条抽象的“合理轨迹”,而是一段在特定场景中真正能成立的物理交互。“坐下”就必须真的坐到那把椅子上,而不是在附近找个地方站稳。
用交互结果反过来修正三维场景
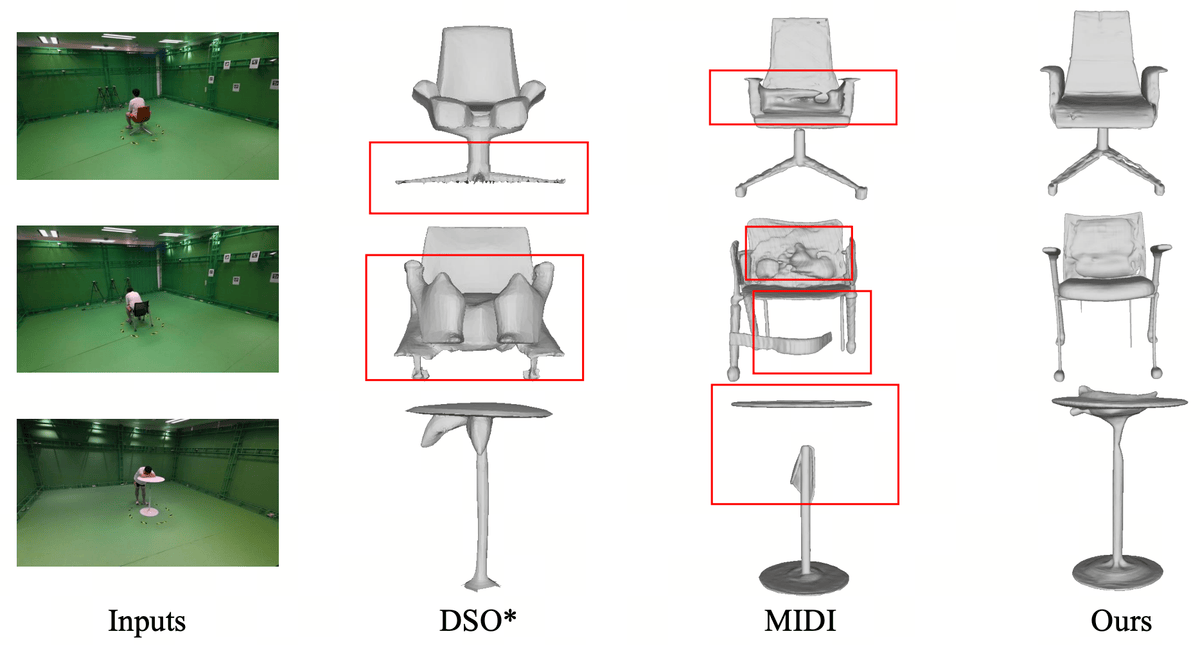
有时候,仿真失败不是因为人动错了,而是场景本身没建对。比如椅子腿被遮挡,重建出来的模型缺了一条腿,人一坐就倒。这种问题在图像生成三维(Image-to-3D)任务中很常见,尤其是细长结构或严重遮挡区域。
HSImul3R 的反向优化模块——直接仿真奖励优化(Direct Simulation Reward Optimization, DSRO)——专门解决这个问题。它把物理仿真的结果当作反馈,反向调整三维物体的生成。
具体来说,系统将仿真结果分为四类状态:
- 物体自身在重力下就不稳;
- 物体能站稳,但人一碰就倒;
- 人与物体接触了,但交互后分离或滑动;
- 人与物体实现稳定接触,整个系统保持平衡。
只有第 4 类才算“重建成功”。DSRO 会根据这个结果,调整物体的几何结构,比如补全缺失的支撑腿、修正倾斜角度,直到它能承受真实的人–物交互。
这样一来,评价标准就从“物体自己能不能站住”升级为“人坐上去之后还能不能站住”。人类的交互行为,成了优化三维世界的监督信号。
HSIBench:专测“能不能交互”的新基准
为了验证这套思路,团队构建了 HSIBench,一个专门评估人–场景交互稳定性的基准数据集。
它包含 19 种常见家具(椅子、沙发、桌子等),50 多段人体动作(坐、靠、扶、跨等),共 300 个独立交互实例。每个案例由 3 名参与者完成,从 16 个同步视角采集,确保数据多样性。
与传统基准不同,HSIBench 的核心指标是 Stability-HSI(人–场景交互稳定性)。它不仅检查物体在重力下的稳定性,还要求整个交互在仿真中持续稳定,并保留有意义的接触。
实验结果很说明问题:在 Easy、Medium、Hard 三档任务中,HSImul3R 的交互稳定率分别为 53.68%、30.56% 和 13.92%,而现有方法 HSfM 只有 10.52%、4.50% 和 2.66%。更直观的是穿模率——HSImul3R 将人–场景三维穿模率从 69.51% 降至 22.90%。
这些数字意味着,当重建服务于机器人时,“渲染真实”不再是终点。重建出来的世界,必须经得起物理交互的考验。
从视频到真实机器人:打通完整链路
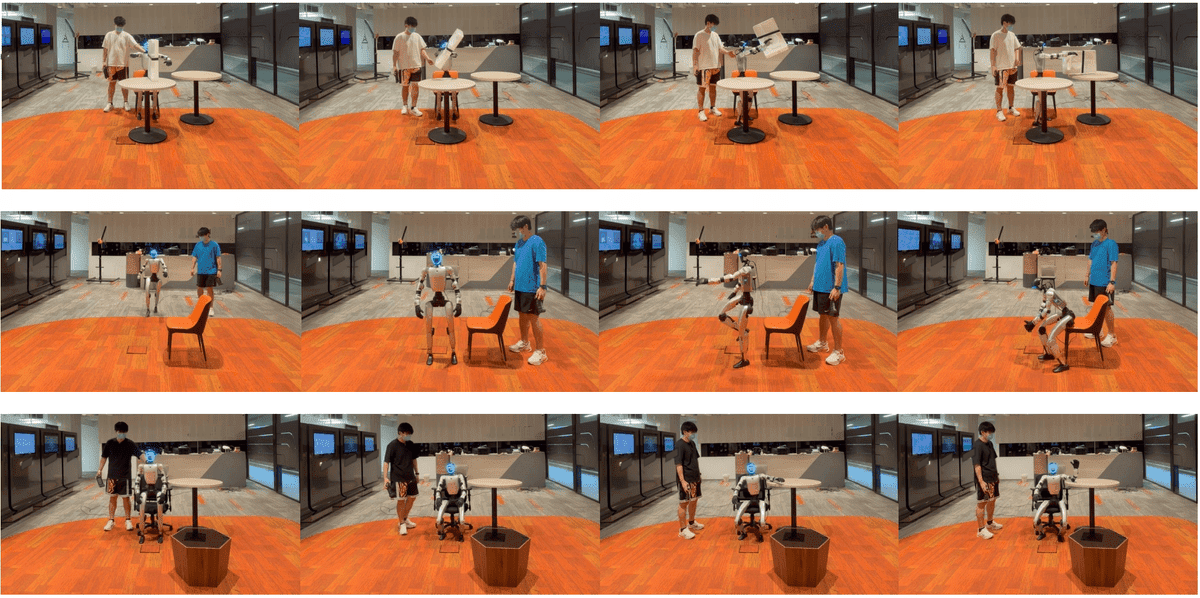
HSImul3R 的最终目标,不是停留在仿真里,而是让机器人真正执行这些动作。团队将优化后的人体运动重定向到 Unitree G1 人形机器人上,完成了从真实世界 → 仿真 → 真实机器人的闭环。
具体流程是:
- 从单目或稀疏视角视频中重建人–场景三维模型;
- 通过物理闭环优化,确保交互在仿真中稳定;
- 将优化后的人体动作作为先验,在仿真中训练全身控制策略;
- 直接部署到真实 G1 机器人上执行。
实验显示,G1 能够成功复现“坐椅子”“扶桌沿”等动作,且与环境保持稳定接触。这证明,人类视频中的交互经验,确实可以转化为可仿真、可学习、可执行的机器人技能资产。
人类视频,或许是最丰富的机器人技能库
互联网上有海量的人类行为视频——做饭、打扫、搬运、操作工具。过去,这些视频对机器人来说只是“视觉数据”,只能用来学习外观或粗略动作。但 HSImul3R 展示了一条新路径:如果能把这些视频中的物理交互关系准确重建并验证,它们就可能成为机器人学习真实技能的来源。
当然,这条路还很长。目前 HSImul3R 主要处理静态场景、单人单物体交互。多物体协作、动态环境(比如移动的传送带)、复杂力控(比如拧螺丝)仍是挑战。但方向已经清晰:机器人从人类视频中学的,不该只是“人看起来怎么动”,而应该是“这个动作为什么能在物理世界中成立”。
从视觉重建到可仿真重建,从人体动作到人–场景交互,再从真实世界到仿真、最终回到真实机器人——HSImul3R 正在推动这一链条的落地。未来,或许我们只需拍一段视频,机器人就能学会其中的物理技能,前提是,我们得先教会它“什么是真正的接触与稳定”。