DeepSeek 新 Flash 模型试图用更低价格替代 Pro,追求更高智能密度
Flash 要替掉 Pro?
DeepSeek 最近干了件挺有意思的事:在 V4.1 Flash 内测版上线的同时,直接在用户反馈问卷里问:“你觉得这个模型能全面替换线上的 DeepSeek V4 Pro 吗?”
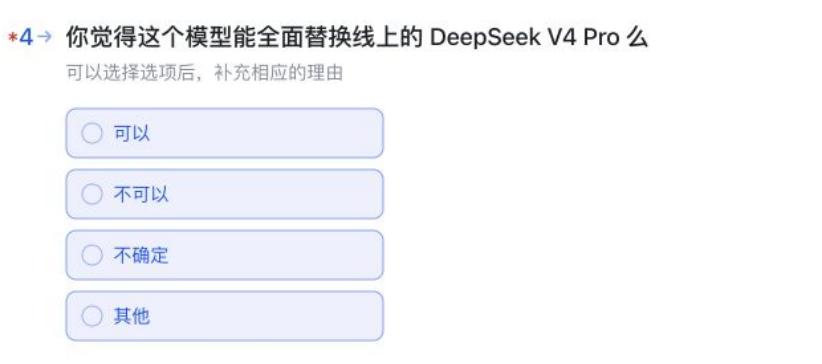
这相当于自己给自己出考题——让便宜的 Flash 去挑战贵三倍的 Pro。目前高峰时段,每百万输出 token,Flash 收 9 元,Pro 收 27 元。而就在内测开启后不久,DeepSeek 又宣布从 9 月 10 日起进一步下调 Flash 系列价格:空闲时段输入缓存命中降至 0.02 元/百万 token,未命中输入降至 1 元,输出降至 4 元;高峰价格为空闲时段两倍。三项降幅分别达 60%、33% 和 11%。
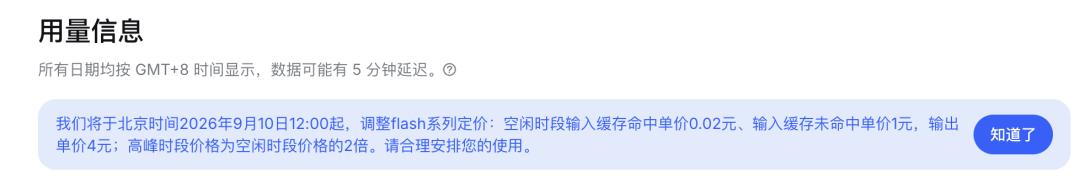
价格降了,能力跟得上吗?这才是关键。开发者当然愿意为关键任务多付钱,但日常开发中大量“可用可不用”的环节,如果能用更便宜的模型完成,积少成多就是一笔可观的成本节省。DeepSeek 的目标很明确:让新 Flash 既快又强,兼具 Flash 的速度和 Pro 的能力。
智能密度:单位计算里的有效推理
一年多前,R1 模型走红,靠的是把高水平推理变成普通用户点一下“深度思考”就能用的功能。2025 年 5 月更新时,R1 在 AIME 2025 测试中准确率从 70% 提升到 87.5%,但平均每题消耗的 token 也从 1.2 万涨到 2.3 万。换句话说,为了答得更准,它花了接近两倍的计算量。
这种策略在研究或关键任务中成立——只要结果够好,多等几秒、多花点钱可以接受。但到了日常 API 调用场景,问题就变了:用户不仅关心“能不能解决”,更在意“愿不愿意等”。等待时间直接影响体验,也直接体现在账单上。
于是 DeepSeek 在 2025 年底的 V3.2 报告中提出了“智能密度”(intelligence density)的概念。简单说,就是在相同输出质量下,尽量缩短推理链长度。因为要达到 Gemini 3.0 Pro 那样的效果,DeepSeek 往往需要生成更长的中间推理过程,这既拖慢速度,又推高成本。
小模型(如 Flash)每步计算便宜,但如果要走更多步才能追上大模型(如 Pro)的结果,单价优势可能被调用次数吃掉。所以 Flash 想真正替代 Pro,不能只靠降价,还得在效率上突破——要么更快生成长推理链,要么更早找到正确路径,省下后续无用计算。
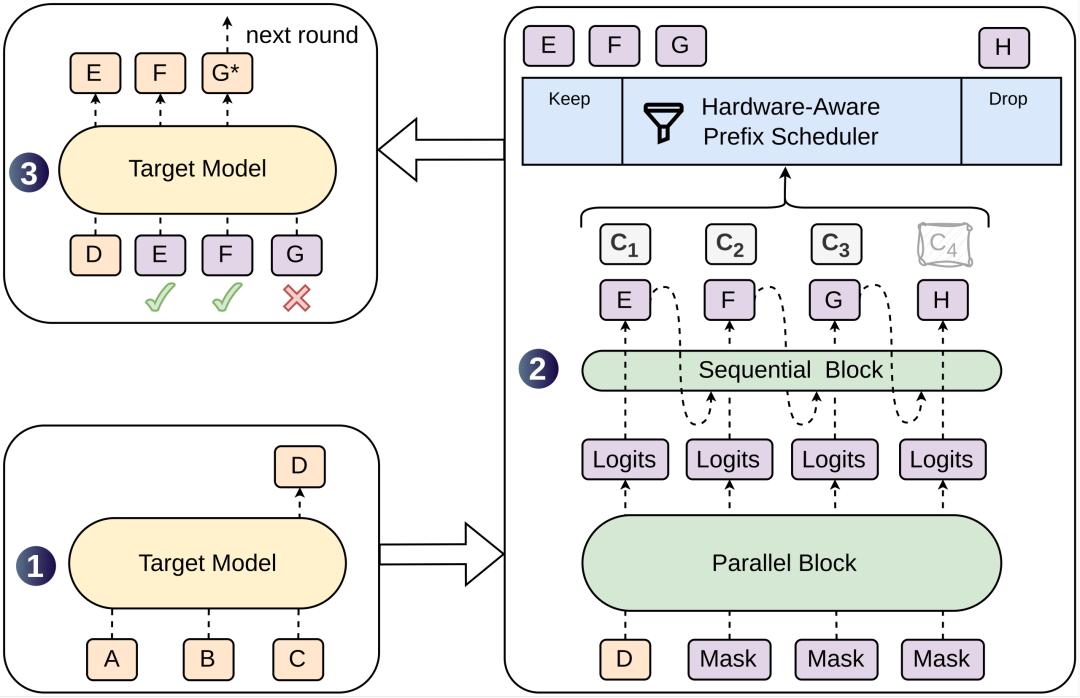
学界也开始关注这个问题。EMNLP 2025 有研究指出,单纯增加计算量未必带来最低延迟,反而需要重新设计并行策略和推测解码机制。DeepSeek 自己也在行动:7 月发布的 DSpark 论文显示,在保持服务吞吐不变的前提下,V4-Flash 的单用户生成速度提升了 60%–85%。他们优化的是推测解码中的验证浪费——先快速生成候选 token,筛掉低置信度的部分,再由主模型验证,从而让用户更快拿到结果,同时不压垮服务器。
对 API 提供商来说,这很关键:只有在不影响整体服务能力的情况下,单次请求的加速才有实际价值。用户等得更短,平台也能用同样资源服务更多人。
Agent 成本:一次任务,多次调用
这次内测中,有位 LINUX DO 用户“觉浅”用新 Flash 做了个停机维护页面。模型表现不错:它读到了项目规范里一条早已废弃但未删除的决策记录,还主动列出了文档更新、代码提交和审查安排。用户提出风格要统一,模型又翻出仓库已有的插画进行修改。
但他最后发现,这一趟花了 15.5 元。
这就是 Agent 和普通聊天的区别:用户只提了一个需求,模型却在后台跑了好多轮——读规范、查文件、改代码、调工具、验结果……每轮都产生输入输出,累积起来费用不低。模型单价低,不代表整项工作便宜。
要让 Agent 用得起,光降模型价格不够,还得减少不必要的调用。有些步骤需要模型判断,有些只是机械地读取、筛选、整理数据。如果后者也交给模型一步步处理,就会白白增加调用次数、拉长等待时间,还占用宝贵的上下文长度。
DeepSeek 开源的 Harness 框架就是为解决这个问题。官网用“Agent = Model + Harness”来解释:模型负责决策,Harness 负责提供工具、管理会话、运行环境,把模型的指令变成实际操作。
其中的 PTC(Program-to-Chain)模式允许模型一次性写出一段程序,把多个工具操作串起来。比如要从一批文件中筛选内容,模型可以生成一个脚本,批量读取、过滤,再把结果交回。这样就不必每读一个文件就问一次“下一步怎么办”,也不用把所有原始内容塞进上下文。
这种设计能省下的,是任务执行中的重复调用和无效输入。DeepSeek 在 PTC 的设计文档里明确把这两类开销列为优化目标。对开发者来说,最终比的是:同样一件事,谁做得好,谁花得少。
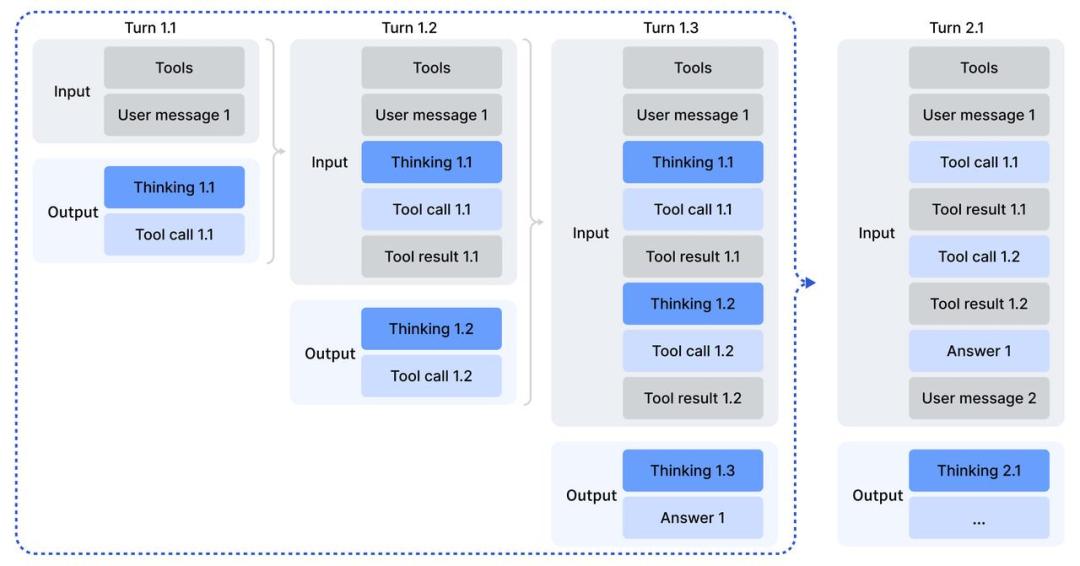
V3.2 技术报告还提到另一个细节:在连续工具调用中,如果丢弃之前的推理,模型就得重新分析整个问题。为此,团队调整了上下文管理策略,让已有推理能在同一次任务中保留。8 月 10 日的开发日志还显示,他们修正了极简模式的工具配置,让它使用持久化的 Bash 环境,确保连续操作的状态不丢失。
这些改动说明,模型公司做执行框架不是多此一举。模型学会了用工具,但实际跑起来还需要配套的环境。DeepSeek 把 Harness 开源,等于给了开发者一套可直接复用、调试和改进的参考实现。
高端模型的新定位
DeepSeek 不是唯一在重新校准产品线的公司。2026 年 7 月,Anthropic 发布 Opus 5,主打以 Fable 5 一半的价格提供接近其前沿水平的能力,并将其设为 Claude Max 的默认模型。官方测试显示,在最大思考强度下,Opus 5 的任务成本约为 Fable 5 的一半,性能却接近后者峰值。
这和 DeepSeek 的思路高度一致:一旦高端能力能以更低价格提供,原有的价格分层就得调整。
Anthropic 把 Fable 定位在耗时数小时甚至数天的复杂编程任务上;OpenAI 的 GPT-6 Astra 则瞄准最困难的端到端工作,涵盖复杂推理、研究、文档生成等。这类旗舰模型的目标,是让用户交出任务后,能直接拿回可检查、可交付的结果——而不是每走几步就喊用户来救场。
如果 Flash 真能接手现在 Pro 的大部分日常任务,下一代 Pro 就可以把计算资源集中在更难、更长的问题上,去争夺 Astra 和 Fable 所代表的高端市场。那时候,“深度思考”不仅要深,还要能独立闭环。
这也解释了为什么原生多模态和 Harness 变得重要。一个要独立完成工作的模型,迟早得看图、读表、判断界面是否符合要求。只会处理文本、只能给建议,会严重限制它能接的活。
早在 2026 年 4 月 V4 预览版发布时,DeepSeek 就明确提到适配 Claude Code、OpenClaw 等 Agent 产品,并展示了生成 PPT 页面的能力。现在,新 Flash 升级结构和多模态,Harness 优化执行流程,两者配合,正在把效率优化从“一次推理”扩展到“一项任务”的全过程。
对 DeepSeek 来说,效率提升带来双重回报:一是减少完成任务所需的总计算量,直接降低成本;二是在相同等待时间内完成更多有效推理,从而解决更难的问题。前者决定技术进步能走进多少人的日常,后者则推动“深度思考”继续向前。
目前 V4.1 Flash 还是中间版本,能否全面替代 Pro、推理链能否显著缩短、下一代 Pro 的具体定位,都还需后续验证。文中提到的 DSpark 加速效果也来自此前 V4 服务的测试,不能直接算作本次更新的成果。但方向已经清晰:Flash 要让更多工作变得划算,Pro 则要找到更多值得等待的任务。