MetaRSI-v1:让AI自我改进系统也能自我进化
自我改进的瓶颈:方法本身不会变
过去两年,AI领域最热门的方向之一是让模型自己改进自己——自己生成训练数据、自动优化提示词、修复代码错误。这类方法统称为递归自我改进(Recursive Self-Improvement, RSI)。从STaR、Self-Refine到STOP、Darwin Gödel Machine,各种方案层出不穷。

但一个关键问题被长期忽视:这些系统里,“负责改进的那套程序”本身有没有进化?答案是否定的。几乎所有现有RSI系统都依赖一套固定的改进逻辑,反复作用于模型。这意味着,即便模型能力在增强,驱动这种增强的机制却是静态的——改进停留在“一阶”,无法突破方法本身的天花板。
MetaRSI-v1:把改进作用于改进者自身
近日,CosmosMind联合斯坦福、伯克利、MIT、清华、北大等十余所高校的研究者发布技术报告《MetaRSI/RSI²》,提出全球首个元递归自我改进架构。其核心思想很简单却激进:不仅让模型自我改进,还要让“改进模型的方法”也能自我改进。团队称此为“自我改进的平方时代”(RSI²)。
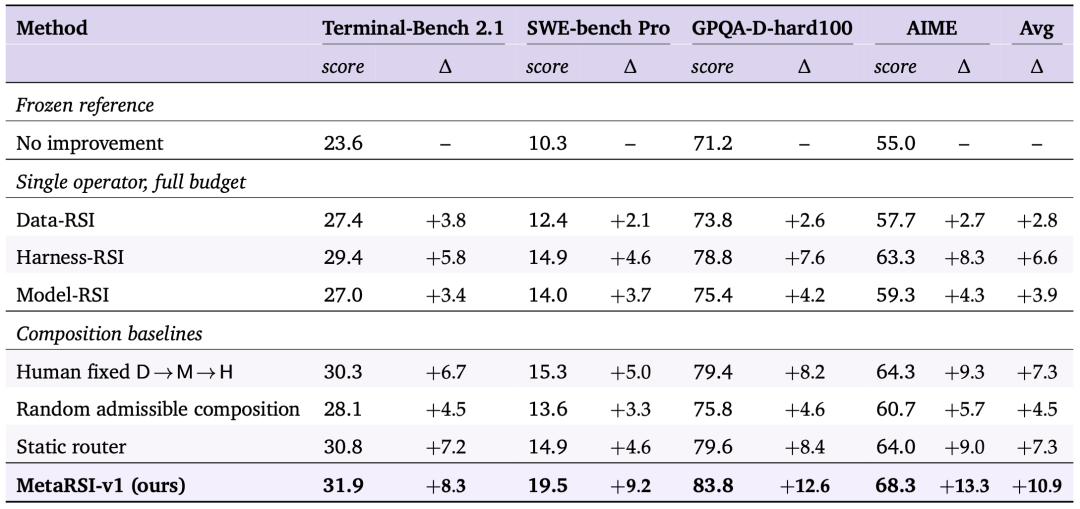
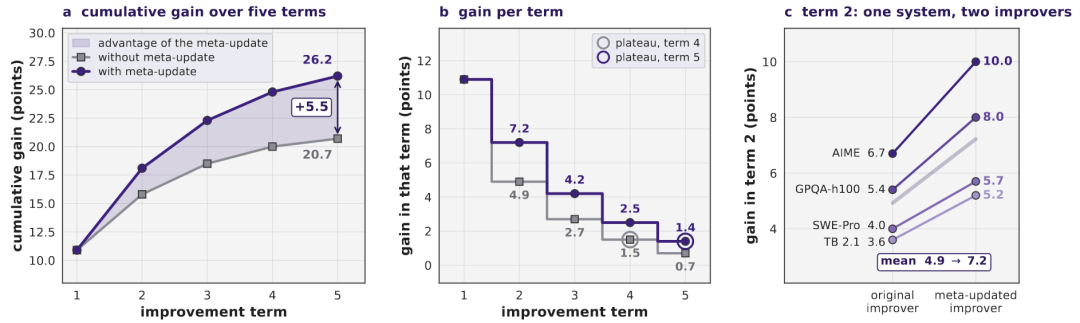
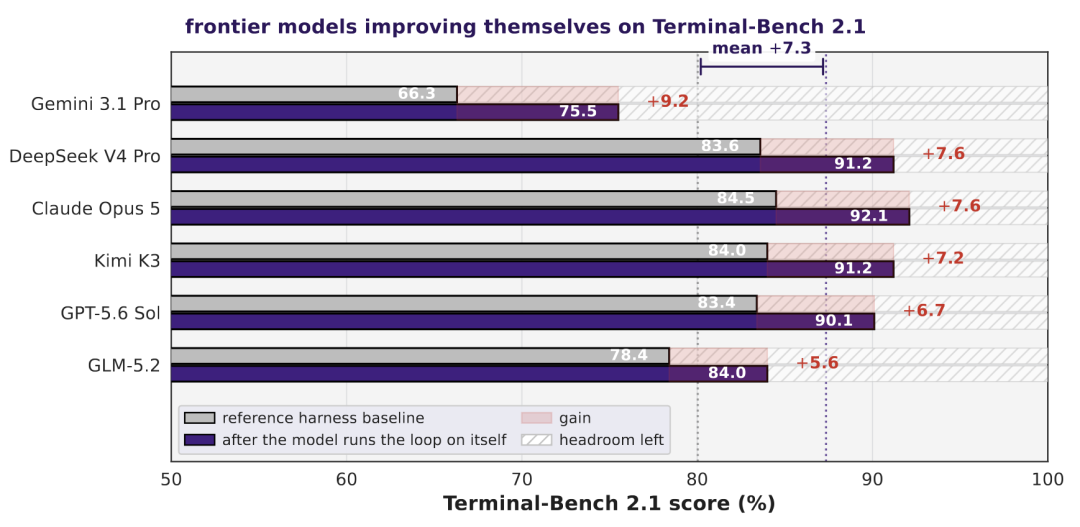
在完全不依赖外部教师模型的前提下,MetaRSI-v1让一个仅30亿激活参数的小模型在四项高难度基准上平均提升10.9分;同时,GPT-5.6、Claude Opus 5等六款前沿大模型也平均提升7.3分。更重要的是,它试图为整个RSI领域提供一套统一的架构语言。
Loop Kernel:统一的改进骨架
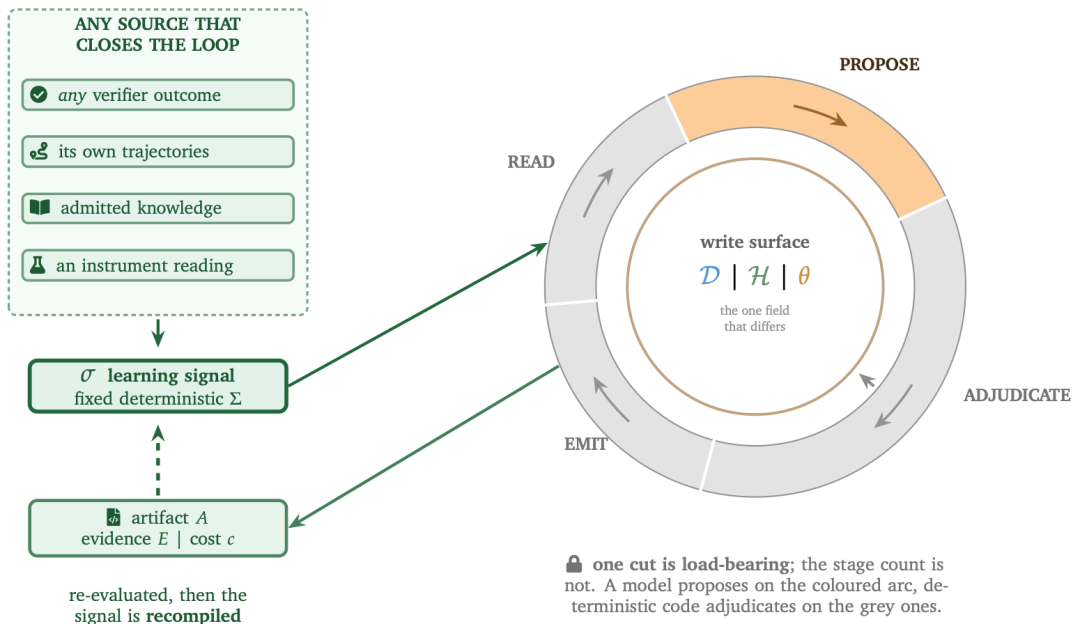
MetaRSI-v1的核心创新是提出Loop Kernel范式——首次将“进步如何发生”抽象为一个与具体对象无关的闭环流程:
- 消费反馈:从任务执行中提取学习信号;
- 提出改动:在Data(数据)、Harness(脚手架)、Model(模型)三个可写面上生成变更;
- 验证裁决:由验证器判断改动是否有效;
- 回流信号:将结果作为下一轮改进的输入。
这一Kernel使得Data、Harness、Model不再是孤立模块,而是同一逻辑在不同维度的实例化。它们可组合、可调度,构成了首个可复用的自我改进底层骨架。
三类算子:覆盖所有可写面
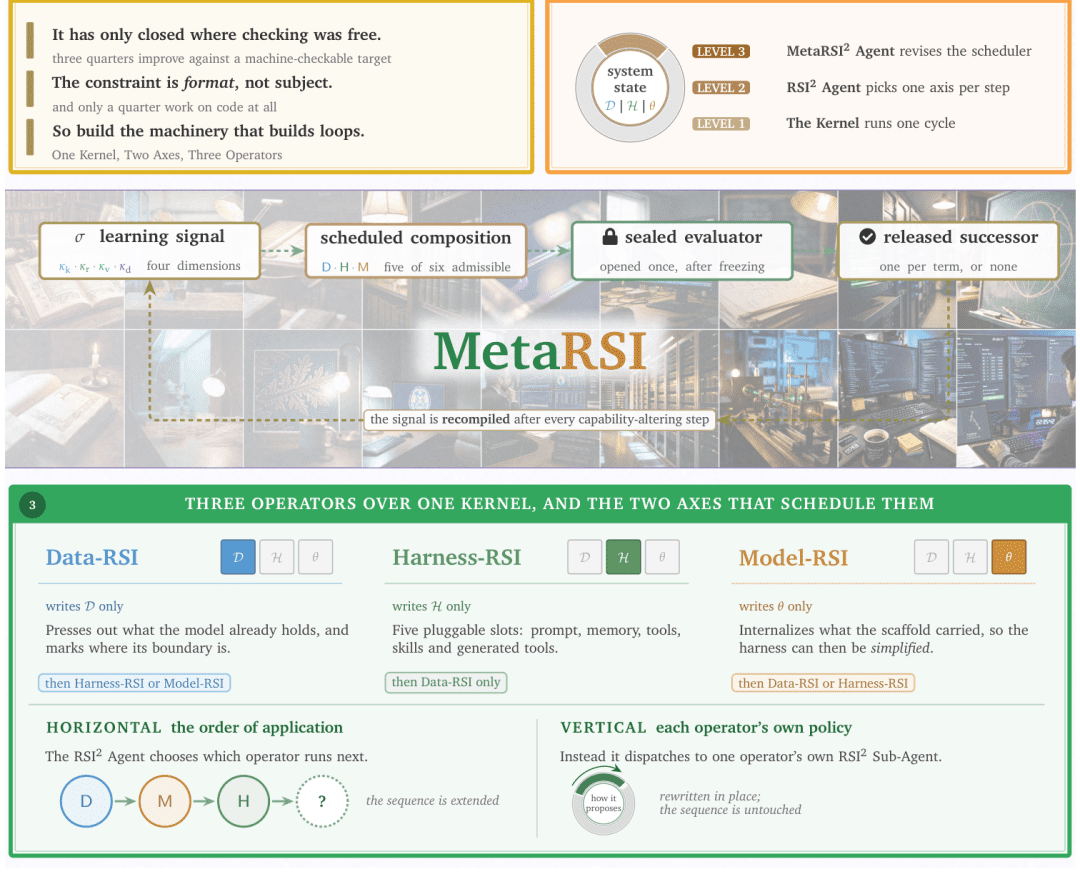
基于统一的Loop Kernel,MetaRSI定义了三类算子,分别对应三个可写面:
- Data-RSI:从模型运行轨迹中提取信号,合成经过验证的训练数据,用于标定并放大模型的能力边界(包括正向能力和易错点)。
- Harness-RSI:在System Prompt、Skill、MCP、Tools、Memory五个可插拔槽位上动态调整脚手架,既能增加新功能,也能删除冗余组件。
- Model-RSI:直接更新模型参数或结构,将反复验证有效的行为内化为模型固有能力。
这三类算子并非独立运行,而是协同工作:Data-RSI产出的数据供Harness和Model消费;后两者的改进又会反馈回Data-RSI,重新标定能力边界,形成持续演进的飞轮。
双轴编排:横向选择与纵向优化
MetaRSI引入两条编排轴,解决“何时用哪个算子”以及“如何优化算子本身”的问题:
- 横轴(horizontal orchestration):在每个决策点,系统根据当前信号选择下一个要执行的算子(如先做Data-RSI再做Harness-RSI),并将其送入Loop Kernel。
- 纵轴(vertical optimization):系统可向特定算子的子代理下发指令,让后者根据反馈改写该算子自身的RSI规则——例如调整Data-RSI的数据合成策略。
这种设计使得改进不仅发生在目标系统上,也发生在改进策略的调度逻辑上。
四层Agent嵌套:从执行到元控制
整套架构由四个Agent协同运作,形成三层RSI嵌套:
- Transition Agent:负责衔接上游算子的输出与下游算子的输入,确保产物能被正确消费。
- RSI² Agent:在每个决策点决定进行横向编排(选算子)还是纵向优化(改策略)。
- RSI² Sub-Agent:接收RSI² Agent的指令,具体执行算子内部策略的调整。
- MetaRSI² Agent:学习如何更优地进行纵横决策,反过来优化RSI² Agent的行为。
这四者构成三级优化:算子改进目标系统 → 双轴编排改进算子用法 → 元层改进编排策略本身。人类专家可随时介入任一层,形成human-in-the-loop系统。
实验验证:小模型与大模型双双受益
实验分两条路线:
小模型路线使用Qwen3.5-35B-A3B(350亿总参数,30亿激活),启用全部三类算子。在Terminal-Bench 2.1、SWE-bench Pro、GPQA-Diamond高难度子集、AIME四项基准上,MetaRSI-v1平均提升10.9分。其中SWE-bench Pro的解决率接近翻倍,且多轮自进化后的累计增益显著高于基线RSI。
前沿模型路线面向GPT-5.6 Sol、Claude Opus 5、Kimi K3等闭源大模型,仅启用Data与Harness算子(因无法修改模型权重)。结果显示,六款模型在Terminal-Bench 2.1上平均提升7.3分,证明即使是最强模型,其脚手架和数据使用方式仍有可观优化空间。
五条定律:重新定义自我改进的本质
基于实践,团队提炼出五条关于递归自我改进的基本定律:
定律一:验证决定前沿。一个领域能否形成自改进闭环,取决于是否存在可靠的任务验证器。没有验证,就没有真正的进步。
定律二:自我认知会过期。RSI一旦改变Agent能力,其原有的系统描述(如“我能处理XX类型任务”)立即失效,必须重新探测边界。
定律三:能力与载体无关,成本与载体有关。同一能力放在Harness中需每次推理付费,内化进Model则只需训练一次。成熟循环会持续将能力迁移到更便宜的载体。
定律四:可信度由不可写面度量。在闭环内部,真正变强和放宽成功标准会产生相同分数,且这种偏差无法通过内部统计察觉——必须依赖外部不可篡改的验证。
定律五:循环不凭空创造能力。所有增益要么来自外部信息熵输入(如新数据),要么是对已有潜力的激发与固化。每次提升都应区分“放大已有能力”和“引入新能力”两部分。
从架构到生态:让每个领域跑起自己的循环
MetaRSI-v1不要求一个领域一次性部署完整Loop。科学研究本就是流水线:假设→实验→执行→解读,每个环节都有明确输入输出。与其追求大而全,不如先在任一环节跑通一个小循环——它的输出自然成为下游的输入。
当足够多的小循环运转起来,它们会自动衔接,最终编织成覆盖整个科研流程的大循环。这大幅降低了新领域的接入门槛:只需准备三样东西——可执行的任务族、判断对错的验证器、一份初始脚手架(哪怕很粗糙),其余部分均由通用机制接管。
为推动这一愿景,团队同步开源了RSI-Harness——一个能自我学习、自我迭代的通用脚手架框架。它可在使用中为不同科学领域沉淀出可移植的Harness Genome(脚手架基因组)。团队还搭建了Genome开放社区,希望每个领域都能积累自己的可靠脚手架,让新闭环站在前人肩膀上启动。
这套设计的意义不止于工程优化。它指向一种可能:未来每个科学领域都将拥有自己的“自我进化引擎”,在验证驱动下持续迭代方法论,加速知识发现的进程。