DeepSeek Harness深度解析:企业级Agent调度层的架构革命
引言:AI开发者的五大核心痛点
当前AI应用开发面临几个关键瓶颈:首先,主流Agent工具如Claude Code或Codex CLI存在严重的模型绑定问题,企业无法自由切换至私有部署模型;其次,功能扩展能力极其有限,闭源架构导致无法触及核心逻辑;第三,执行过程缺乏透明度,复杂任务出错后难以追溯中间状态;第四,企业级安全需求如数据不出域、操作审计、权限控制等基本无法满足;最后,现有方案多为单体架构,无法灵活组合不同模型和工具形成协同工作流。这些痛点本质上源于传统Agent框架将核心组件硬编码的设计缺陷。
DeepSeek Harness的出现正是为了解决这些问题。它通过"一切皆插件"的架构原则,将模型适配器、工具注册表、会话日志、沙箱策略甚至Agent主循环全部解耦为可替换组件。这种设计不仅实现了真正的模型无关性,更赋予开发者前所未有的定制自由度。下文将系统解析其技术架构与实践价值。
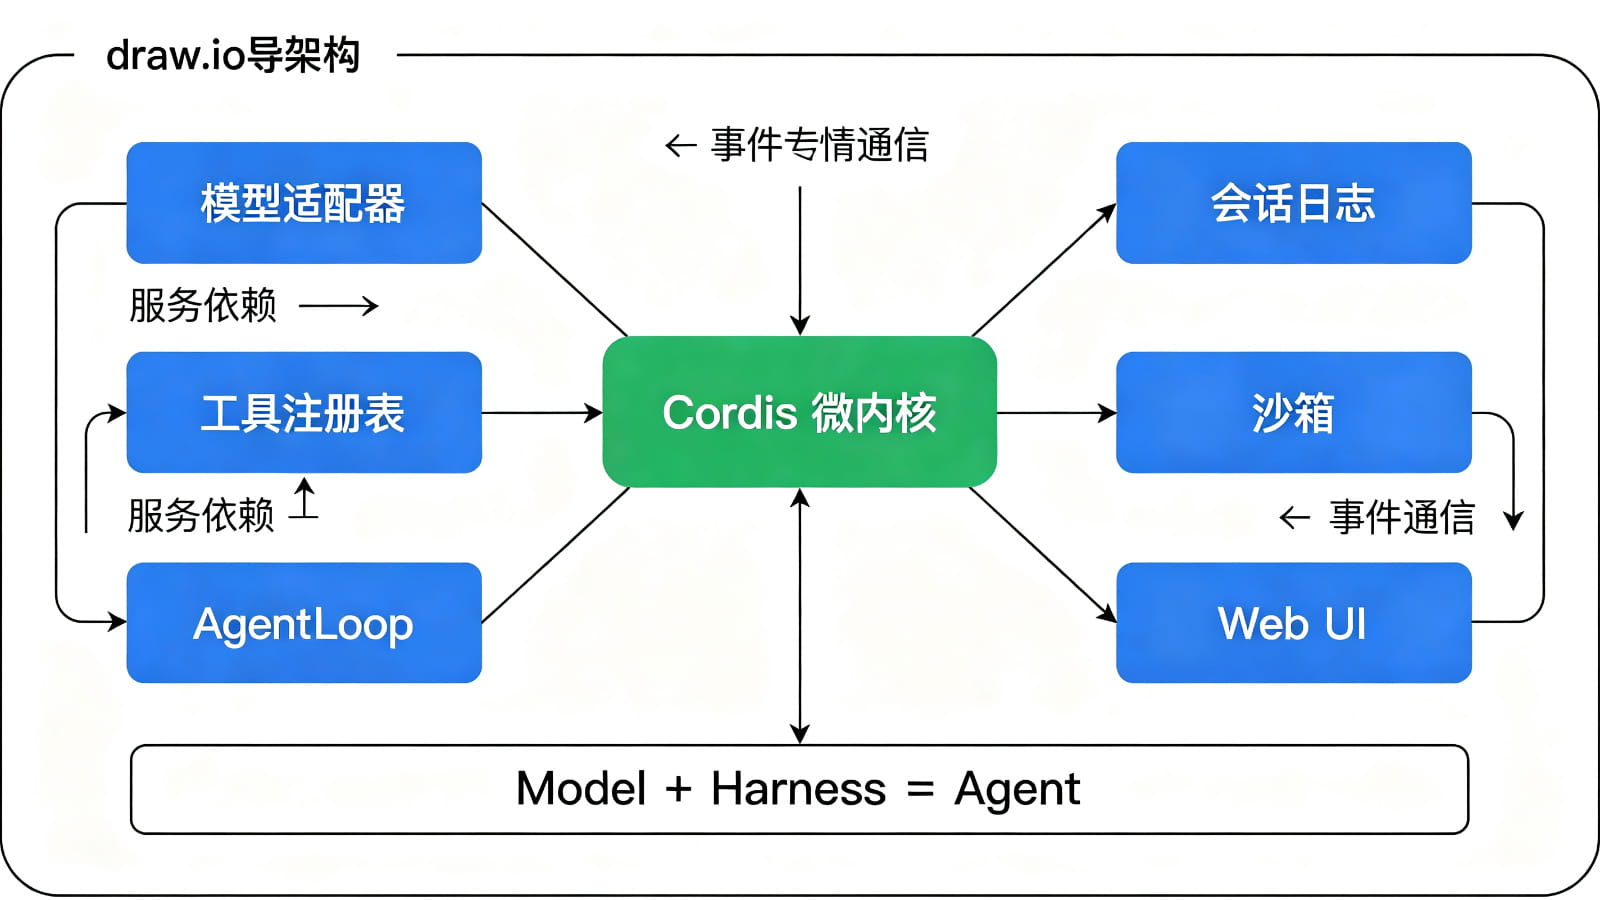
核心架构:Cordis微内核与插件生态
Cordis的时空可组合性原理
Cordis作为DeepSeek Harness的底层元框架,其创新性体现在两个维度:空间可组合性指插件通过服务依赖和事件总线实现松耦合协作,避免硬编码调用;时间可组合性则确保插件生命周期(加载/初始化/卸载)的原子性,卸载时自动清理所有注册项。这种设计使得系统能在运行时动态调整能力组合,例如热插拔安全审计插件而不中断服务。
具体实现上,Cordis采用Fiber机制管理插件状态。每个插件实例对应独立Fiber,其注册的工具、事件监听器均绑定到该Fiber。当插件卸载时,Fiber销毁会触发反向撤销操作,彻底清除关联资源。这种机制从根本上解决了传统插件系统常见的"孤儿状态"问题。
插件契约与开发规范
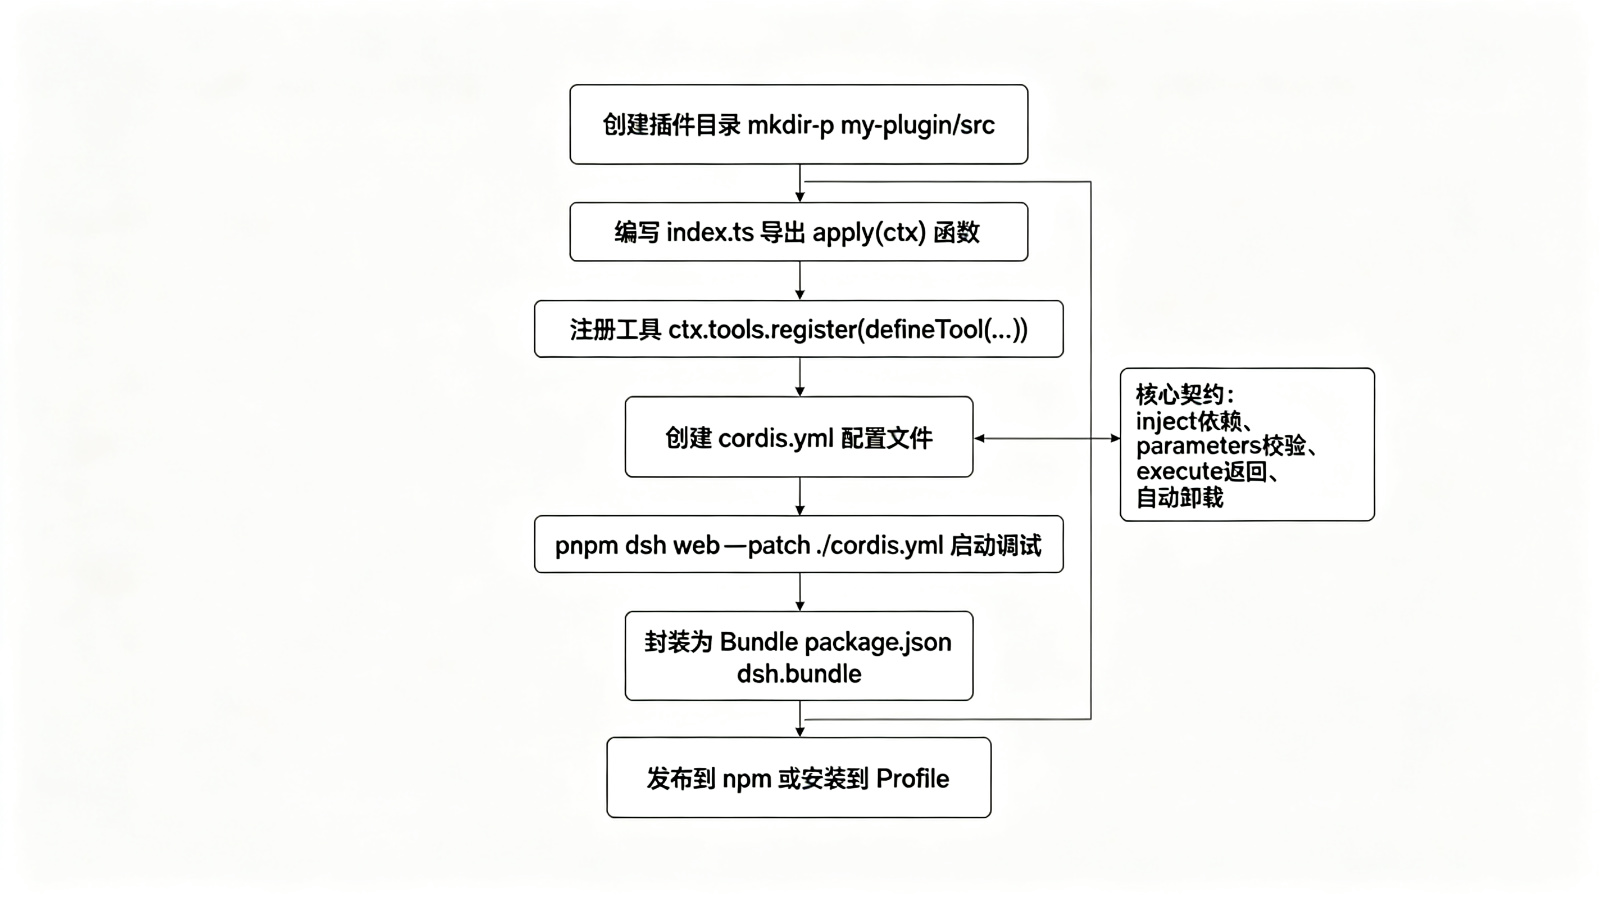
一个合规的Harness插件需遵循严格契约:
- 依赖声明:通过
inject数组显式声明所需服务(如['tools', 'llm']) - 类型安全:工具参数必须定义JSON Schema,执行前自动校验
- 错误处理:基础设施故障需抛出异常而非静默失败
- 资源绑定:所有注册项必须关联到插件Fiber
以文本统计插件为例,其execute函数不仅验证charsPerToken参数的有效性,还将返回值严格限定为符合预定义Schema的JSON字符串。这种契约设计确保了插件间的互操作可靠性。
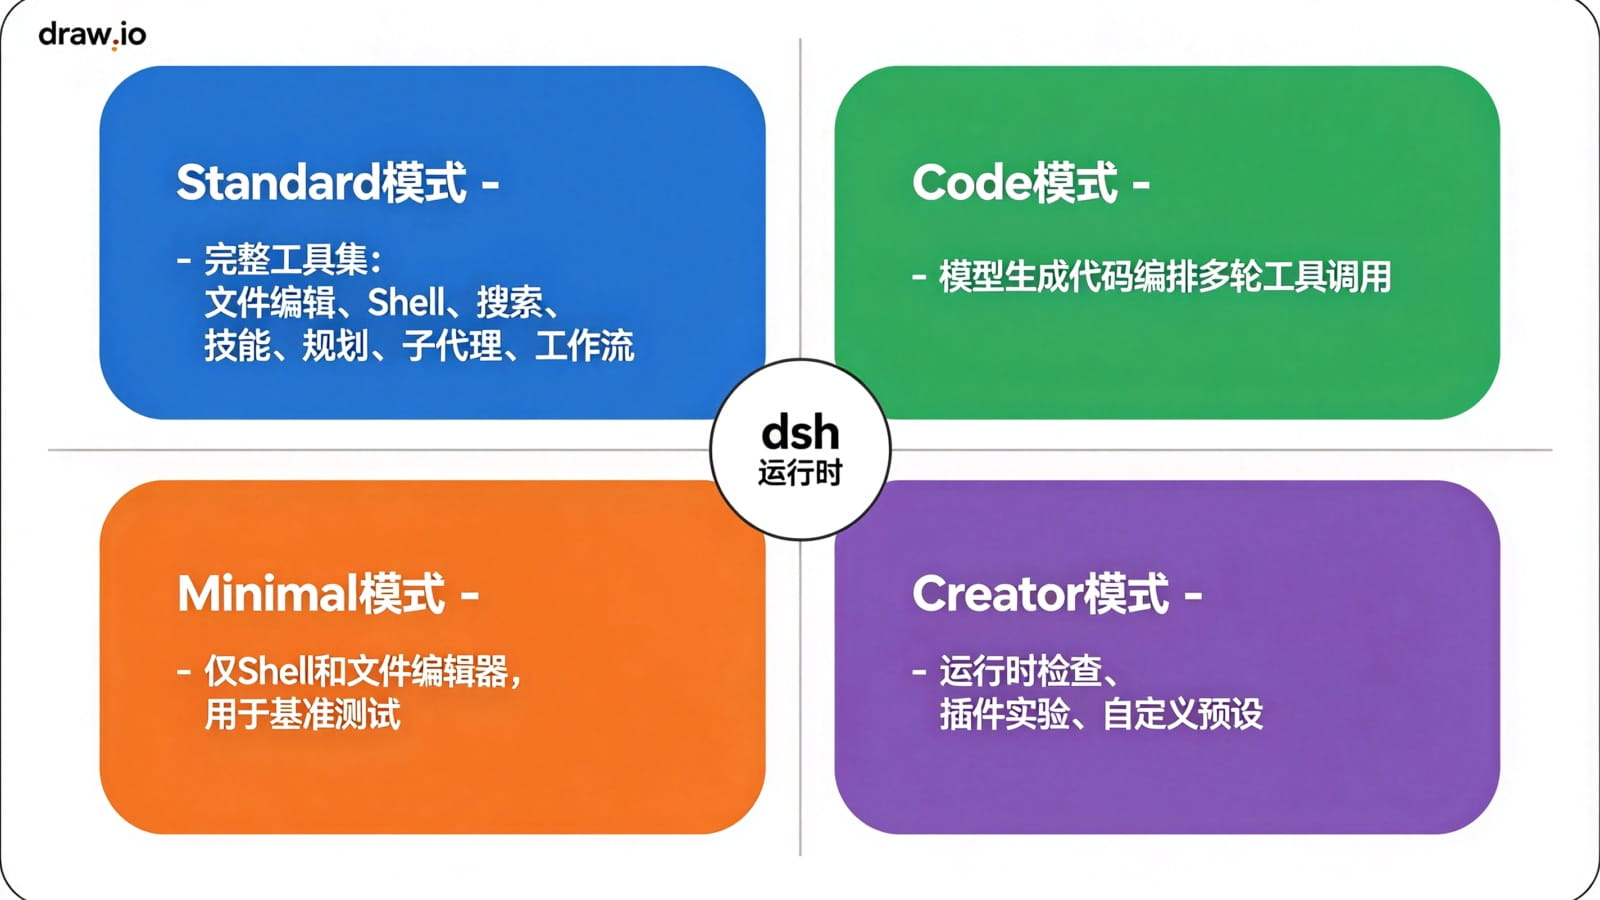
四种运行模式的工程价值
Standard模式:全功能开发环境
Standard模式集成53+个文档化工具,覆盖文件编辑、Shell执行、网页搜索等全栈开发场景。其独特价值在于内置的目标分解引擎——当用户输入"创建NestJS+Vue3全栈项目"时,Agent会自动拆解为:
- 初始化后端项目结构
- 配置PostgreSQL连接
- 实现JWT认证模块
- 创建前端Vue3模板
- 集成Axios请求库
每个子任务通过工具链闭环执行,错误时触发反思重试机制。这种模式特别适合需要端到端交付的复杂项目。
Minimal模式:纯净基准测试
Minimal模式仅保留str_replace_editor和持久化Bash两个基础工具,专为模型能力评测设计。在对比GPT-4o与Claude Sonnet 4的编码能力时,该模式可排除工具差异干扰,聚焦模型本身的逻辑实现质量。实测显示,在LeetCode Hard题目上,Minimal模式能更准确反映模型在算法设计、边界处理等核心维度的差异。
Code模式:精细化工作流编排
Code模式通过TypeScript SDK暴露工具调用接口,允许模型生成精确的工具调用序列。例如在CI/CD流水线中:
await cloneRepository('https://gitlab.internal/project');
const testResult = await runTests();
if (!testResult.success) {
const fix = await analyzeError(testResult.logs);
await applyPatch(fix);
await rerunTests();
}
await generateReport();这种显式编排方式比自然语言指令更可靠,特别适合需要严格顺序控制的运维场景。
企业级落地实践
内网代码审查Agent架构
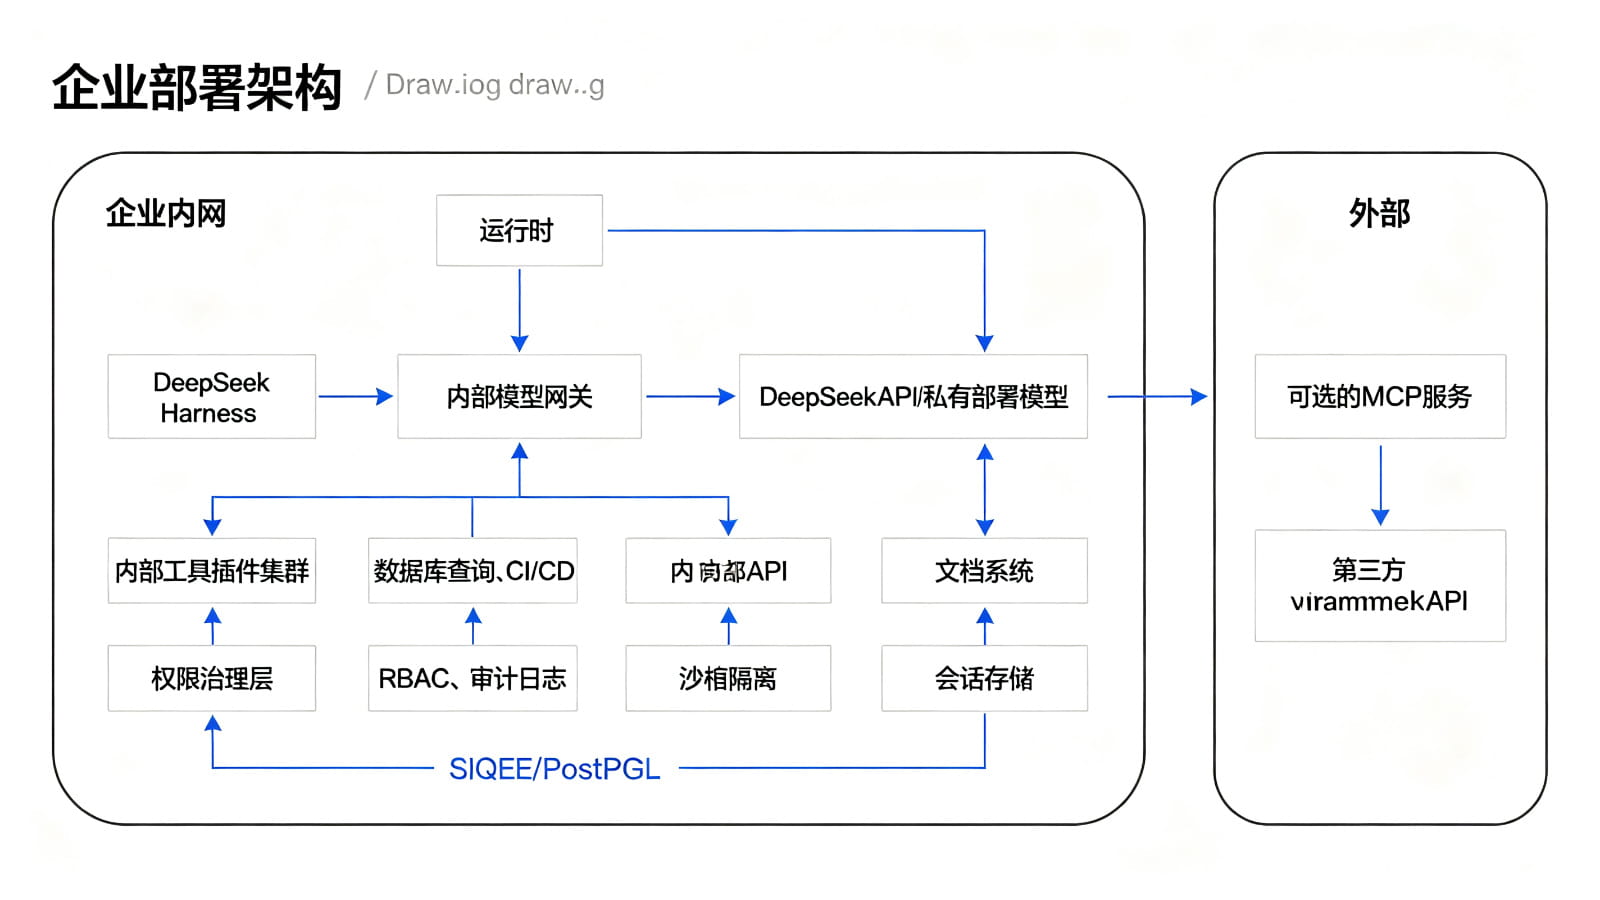
某金融科技公司部署的代码审查系统包含三层防护:
- 网络层:模型API指向内网网关,GitLab工具插件通过双向TLS认证
- 执行层:沙箱采用Landlock限制系统调用,仅允许访问
/workspace/repos目录 - 审计层:所有工具调用记录同步至Elasticsearch,保留180天
其GitLab工具插件实现两个关键方法:gitlab_get_mr_changes获取变更集,gitlab_post_review_comment提交结构化审查意见。审查规则通过System Prompt注入,例如"检测SQL注入漏洞时需验证参数化查询使用情况"。
多模型对比测试平台
AI团队构建的基准测试平台支持动态模型切换:
models:
providers:
internal-v3: { baseUrl: http://model-gateway/v1 }
openai-gpt4o: { apiKey: ${OPENAI_KEY} }
anthropic-claude: { apiKey: ${ANTHROPIC_KEY} }测试任务执行时,平台并行调用各模型,记录响应时间、token消耗、输出质量(通过AST解析验证代码正确性)。数据显示,在金融计算场景中,内部V3模型在精度上超越GPT-4o 12%,但推理速度慢1.8倍。
自动化日报生成系统
该系统通过三阶段工作流实现:
- 数据采集:每日18:00定时拉取Git提交记录、Jenkins构建状态、Jira进度
- 内容生成:LLM整合多源数据生成结构化日报
- 分发通知:通过飞书Webhook推送至项目群
关键创新在于上下文压缩技术——将原始数据(平均2.3MB/天)提炼为300字摘要,既保留关键信息又降低token消耗。实测显示该方案使日报生成成本下降67%。
与竞品框架的本质差异
结构性 vs 功能性插件
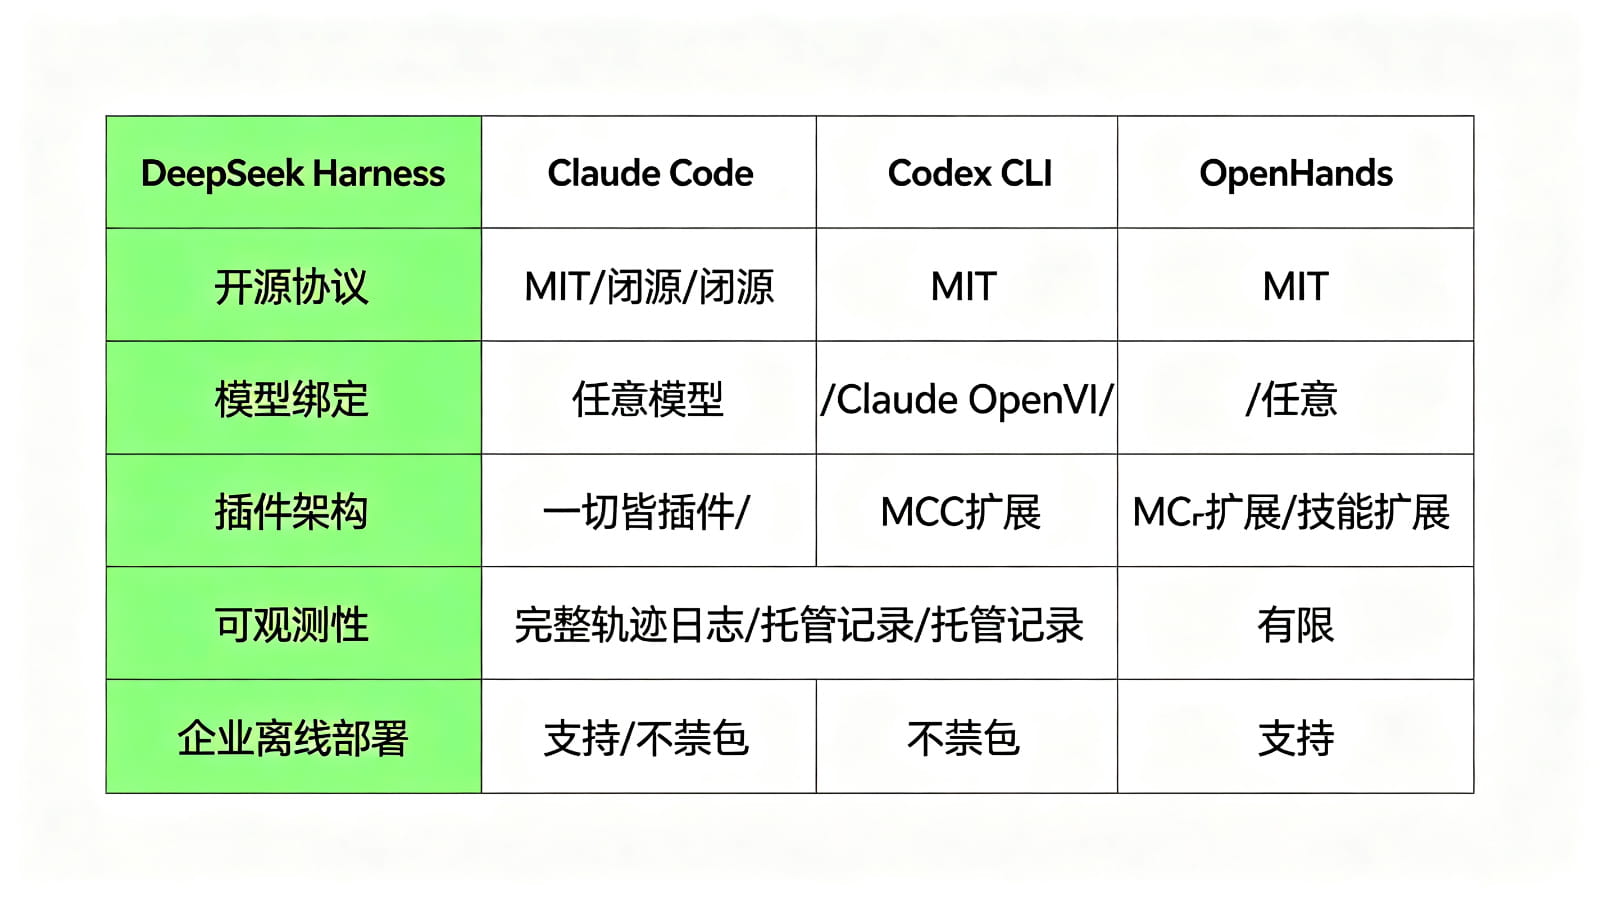
传统框架如LangChain的插件属于功能性扩展——在固定核心上添加新能力。而DeepSeek Harness的插件是结构性的,连Agent主循环都可替换。这意味着:
- LangChain用户只能选择框架预设的ReAct、Plan-and-Execute等循环策略
- Harness用户可自定义带强化学习反馈的循环逻辑
这种差异使Harness更适合需要深度定制的企业场景,而LangChain更适合快速原型开发。
子代理调度机制
Harness的子代理调度具有三大优势:
- 异构兼容:可收编Claude Code等闭源工具作为子代理
- 统一追溯:所有子代理操作记录在同一会话日志
- 动态唤醒:通过reportDelivery机制避免父任务空等
相比之下,AutoGen等框架的Agent均为同质化实例,且状态隔离导致调试困难。Harness的混合调度能力使其成为真正的"Agent操作系统"。
生产环境风险与应对
破坏性变更管理
开发者预览版的主要风险在于API不稳定性。建议采取以下措施:
- 版本锁定:在package.json中固定
@deepseek-ai/dsh版本 - 数据备份:定期导出会话数据库(SQLite格式)
- 兼容层封装:对核心插件添加适配层,隔离底层变更
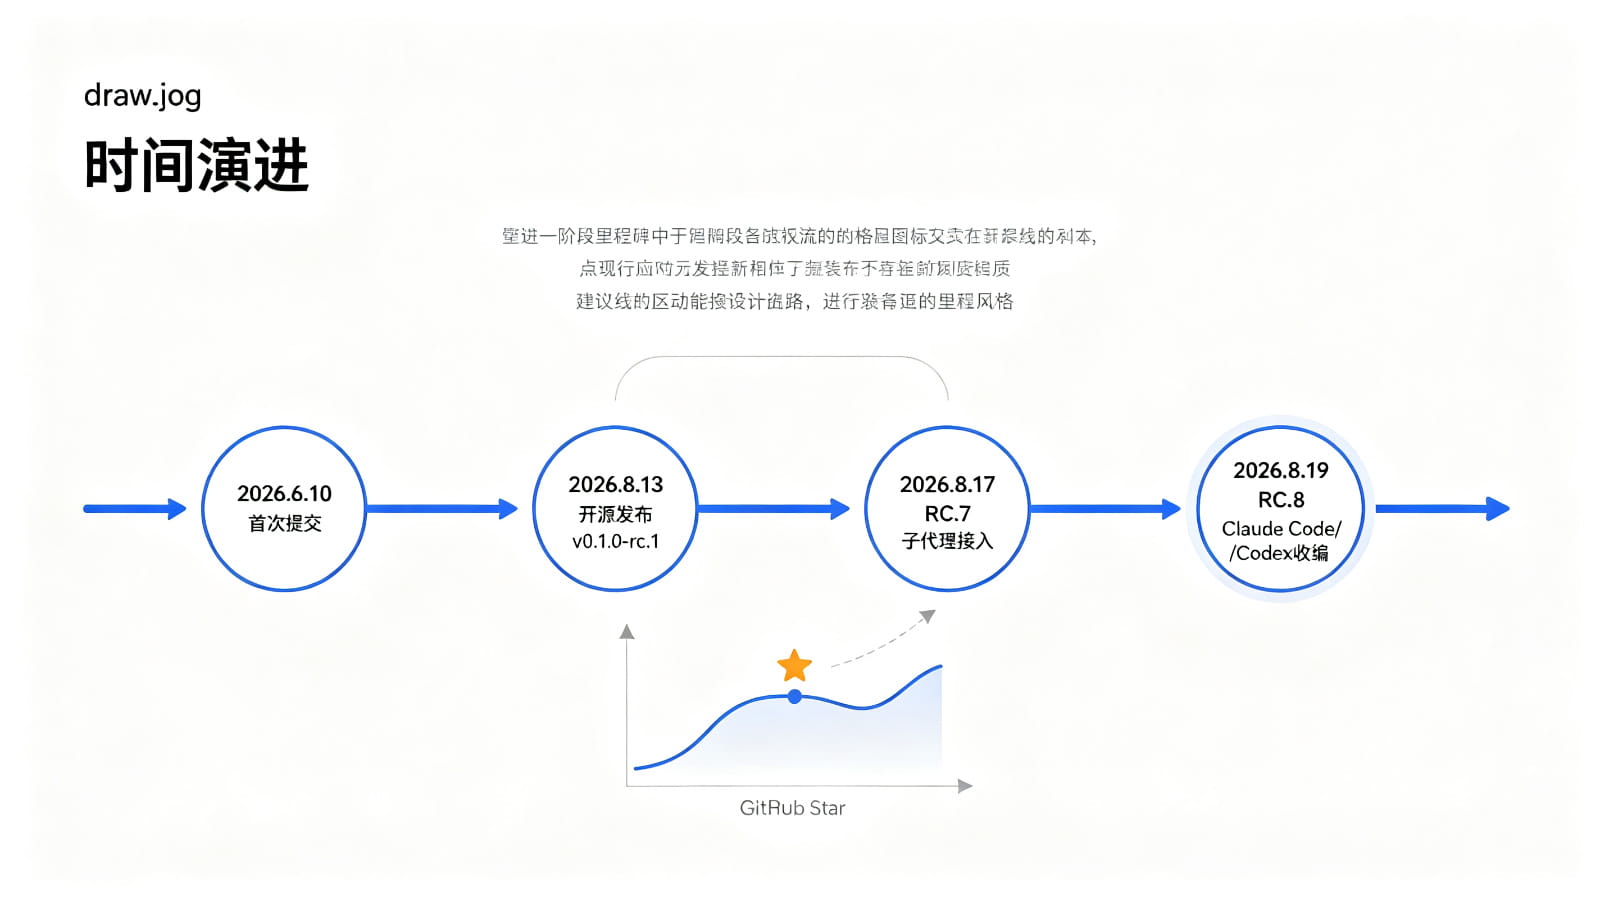
某团队在RC.7升级RC.8时,通过预置的migration脚本自动转换了会话日志格式,避免了数据丢失。
安全加固方案
企业部署需实施四层防护:
| 防护层 | 措施 | 工具示例 |
|---|---|---|
| 网络 | 内网隔离+API网关 | Traefik + OAuth2 Proxy |
| 执行 | 容器化沙箱 | gVisor + Landlock |
| 权限 | RBAC插件 | 自定义role-based-access |
| 审计 | 操作日志同步 | Filebeat → ELK |
特别要注意禁用遥测功能——尽管设置telemetry: false,仍需检查网络请求是否包含设备指纹。
未来演进方向
DeepSeek Harness的路线图显示三个关键方向:
- 插件市场:计划推出官方插件仓库,支持版本签名和依赖解析
- 分布式调度:将Cordis扩展至多节点集群,支持跨机器子代理协作
- 硬件加速:集成vLLM等推理后端,优化本地模型调用性能
随着插件生态成熟,Harness有望成为AI时代的"Kubernetes"——不是直接提供应用,而是为各类Agent提供标准化运行环境。这种定位使其在企业级AI基础设施竞争中占据独特优势。