RSI新范式:不靠模型训练,如何让35万Agent共享踩坑经验?
在当前大模型驱动的智能体(Agent)开发热潮中,一个被广泛忽视却极其致命的问题正在悄然蔓延:智能体缺乏真正的记忆与学习能力。即便一个Agent花费数小时成功修复了一个复杂的依赖冲突,甚至补全了测试用例,这套宝贵的经验在其任务结束后便彻底消失。第二天,另一个Agent面对几乎相同的代码仓库和报错信息,却像从未有人来过一样,从头开始盲目尝试,重复踩入同样的陷阱。
这种“单次推理强、长期记忆弱”的现象,本质上暴露了当前Agent架构的根本缺陷——系统不具备经验沉淀与复用的机制。更残酷的是,这种缺陷并非源于模型能力不足,而是整个工程范式对“经验”本质的误解。
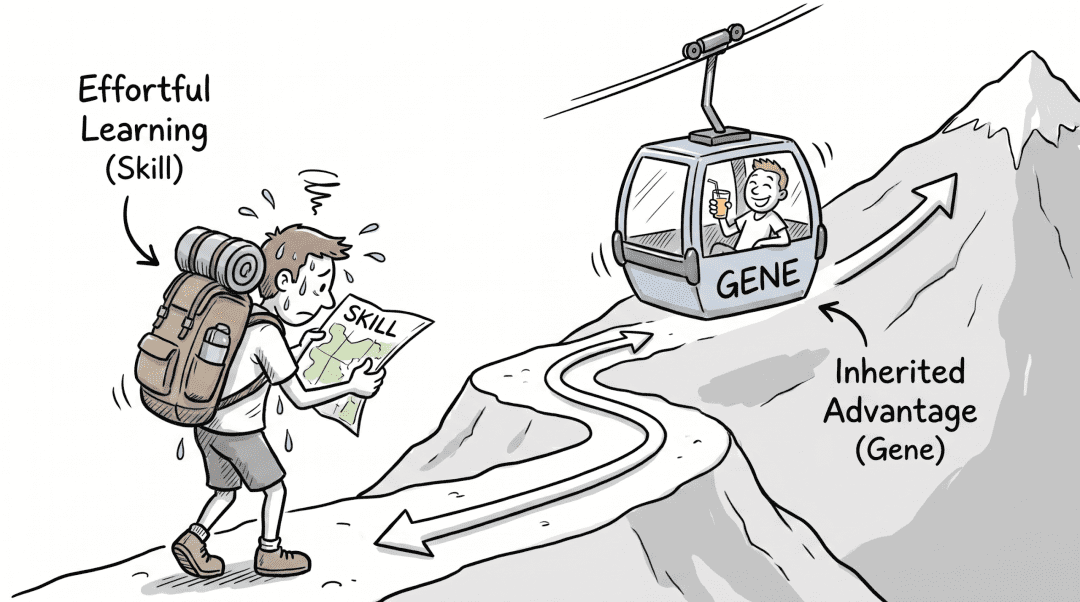
经验不是日志,而是可执行的控制信号
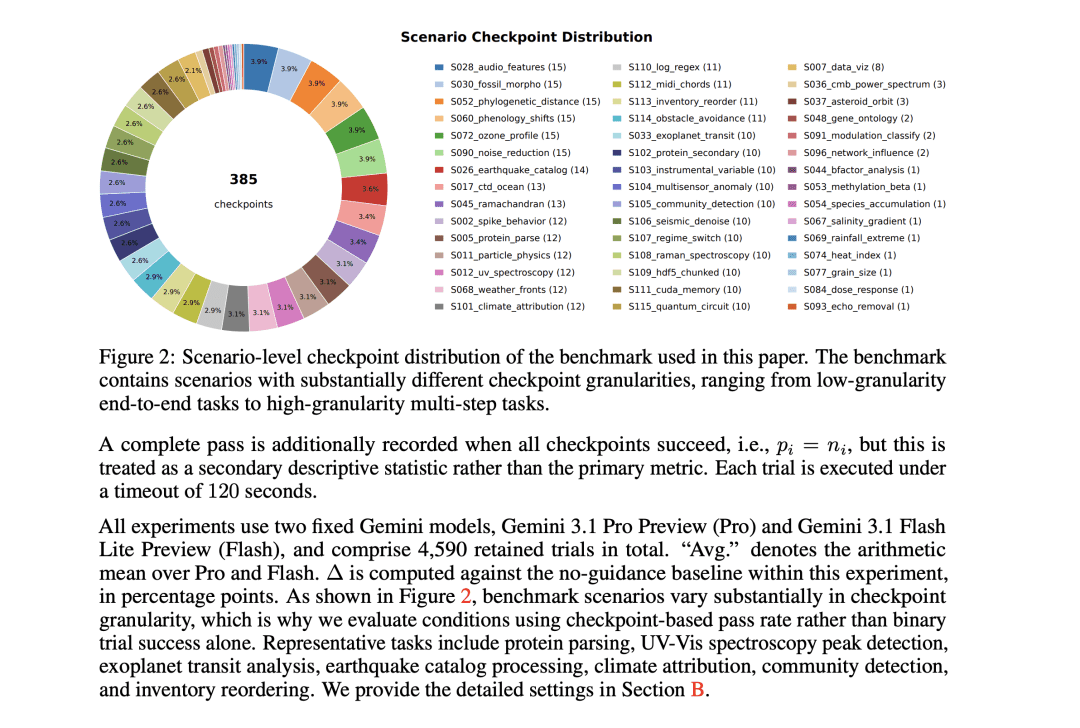
传统做法倾向于将Agent的执行过程记录为长篇日志或技能文档(Skill),并通过RAG(检索增强生成)在后续任务中注入。然而,EvoMap团队在《From Procedural Skills to Strategy Genes》论文中通过4590次受控实验明确指出:对人类有用的完整流程描述,对Agent而言往往是噪声。
原因在于,Agent的决策是在有限的推理预算内进行的。当数千Token的冗长轨迹被塞入上下文,真正关键的控制信号(例如“不要在此处重装node_modules”或“必须先检查PYTHONPATH”)会被大量无关细节稀释。更危险的是,未经验证的错误操作也可能被一并复用,导致“经验中毒”——比没有经验更糟糕。
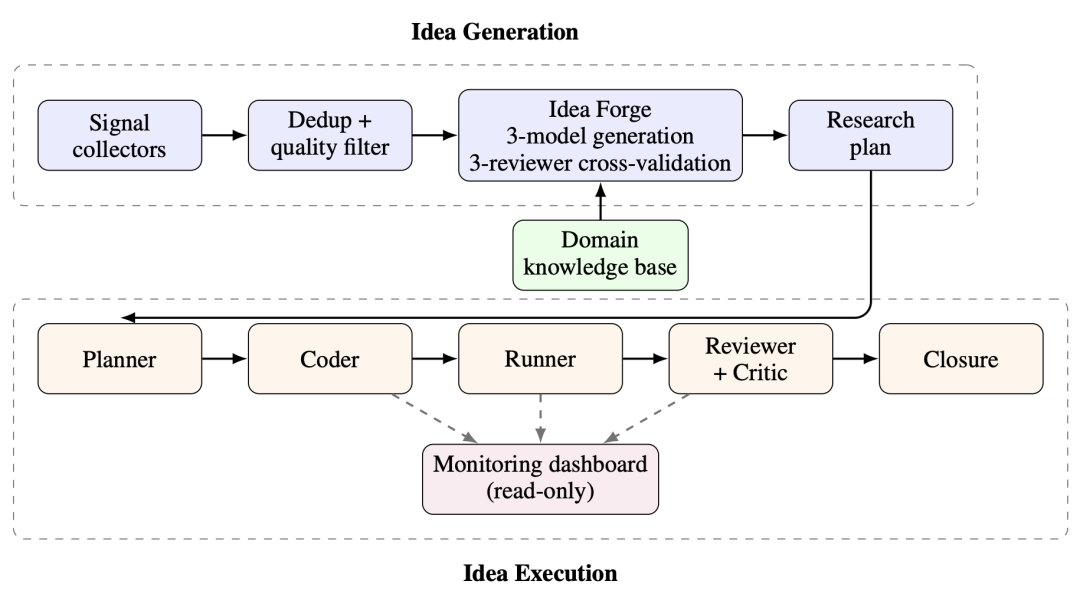
因此,经验的有效形态不应是叙述性的文本,而应是高密度、结构化、可直接干预决策流的控制片段。这正是EvoX智能体与其内置Evolver引擎的核心设计理念。
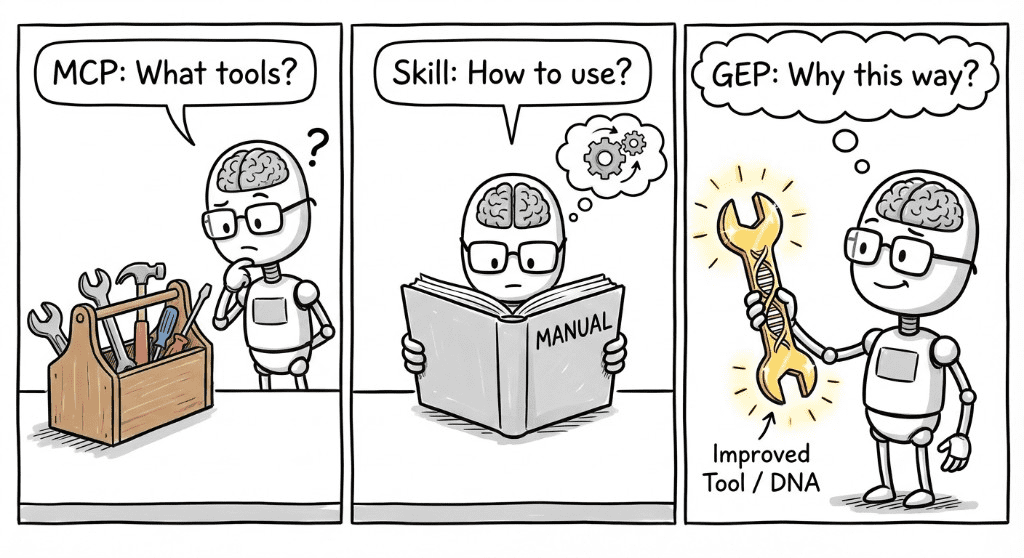
EvoX:为真实世界而生的自进化智能体
EvoX并非一个仅在模拟环境中运行的沙盒Agent,而是专为真实开发环境设计的“活体”智能体。它必须实际执行命令、读取文件、调用工具、解析报错,并在物理世界中承担操作后果。无论任务成功与否,EvoX都会生成一条包含完整动作序列、环境反馈与中间状态的执行轨迹。
这条轨迹的价值不在于其长度,而在于其真实性。只有真实的试错才能产生真实的教训。例如,在一次Django升级任务中,EvoX可能因错误地修改了settings.py中的中间件顺序而导致服务崩溃。这一失败本身并无价值,但若能从中识别出“在Django 4.x中,SecurityMiddleware必须位于SessionMiddleware之前”这一约束条件,则构成了可复用的知识单元。
Evolver:将轨迹蒸馏为“基因”
Evolver引擎的作用,正是将原始轨迹转化为这种高价值知识单元。它不进行泛泛的“反思总结”,而是采用一套严格的蒸馏机制,强制输出两类核心对象:
- DO基因:明确指示在特定上下文中应采取的关键动作(如“当检测到webpack@5与react@18共存时,优先锁定html-webpack-plugin@5”);
- AVOID基因:标记必须绝对禁止的操作(如“切勿在未备份前直接运行npm audit fix --force”)。
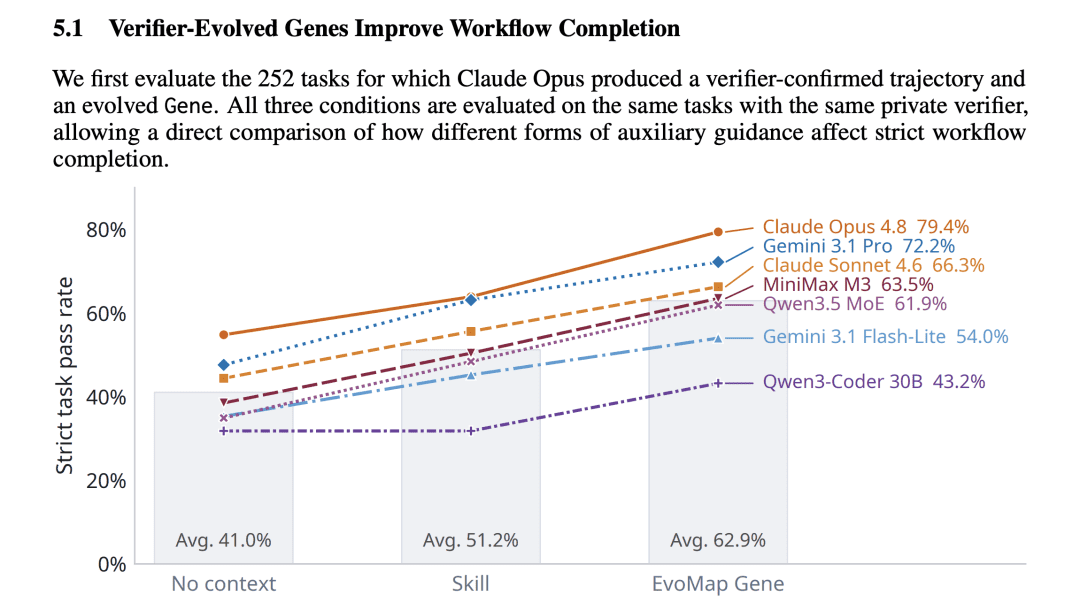
这些基因以极简的JSON结构存储,通常仅占用几十到几百Token,却能在任务执行的关键节点提供精准干预。在Claude Opus上的实测显示,使用Gene的Agent不仅多解决了39个长流程任务,Token消耗反而降低9.9%——证明了经验压缩带来的双重收益:更强的控制力与更低的计算开销。
更令人惊讶的是,Evolver还能支持无监督的科研闭环。在AutoResearch实验中,系统自动识别出某次Django修复的成功具有偶然性(仅通过部分测试),随后触发Swarm实验验证不同配置组合,最终提炼出普适性更强的修复策略,将官方新特性的测试通过率从2/7提升至7/7,且未破坏任何回归测试。
EvoMap:构建经验的达尔文网络
单个EvoX提炼的基因若仅限本地使用,其价值极为有限。真正的突破在于规模化流转。EvoMap网络为此设计了GEP(Gene Evolution Protocol)协议,将经验转化为可跨Agent共享、验证与演化的标准化对象。
目前,已有超过35.7万个Agent接入EvoMap,共同沉淀了481万项目录化管理的经验资产。其运作机制如下:
匹配与注入:当新任务到来,系统基于代码库特征、报错类型、依赖图谱等上下文,从481万基因库中检索最相关的条目,并作为System Instruction直接注入Agent的推理流程。由于基因高度结构化,注入开销极低,却能显著改变决策路径。
执行与回写:任务完成后,无论成败,EvoX的Evolver都会将本次结果封装为Event回传至EvoMap。例如,若某AVOID基因在新环境中失效(如因操作系统差异导致原禁止命令实际安全),该事件将被记录。
全局进化:EvoMap接收到反馈后,自动触发基因的生命周期管理:
- 验证(Validate):统计该基因在同类任务中的成功率;
- 变异(Mutate):若发现适用边界变化,生成带条件约束的新版本(如“仅适用于Linux”);
- 固化(Solidify):对高置信度基因提升优先级,确保广泛分发。
这种机制使得经验网络具备达尔文式进化能力——无效或过时的基因逐渐被淘汰,适应性强的变体则快速扩散。某台机器上踩过的坑,可在秒级时间内转化为整个种群的免疫记忆。
实证:不更新参数,性能却大幅提升
为验证该范式的有效性,EvoMap团队在LongWoF-Bench(包含778个复杂长流程任务)上进行了严格测试。结果显示,在不更新基模参数、不进行任何SFT或RLHF的前提下,仅通过Gene注入的EvoX Agent,在7款主流大模型上的平均任务通过率比“裸跑”基线高出8.7至15.5个百分点,显著优于依赖传统Skill文档的开源框架。
更关键的是,这种提升伴随着Token消耗的下降。这意味着系统不仅变得更聪明,还变得更高效——智能算力的利用效率得到实质性优化。
重新定义RSI:从模型训练到系统协议
当前行业对RSI(递归式自我改进)的想象,往往局限于“大模型训练更大模型”的宏大叙事。然而,EvoMap的实践表明,真正的工程级RSI无需等待基模迭代。通过在智能体与系统协议层构建“执行—提炼—验证—分发”的闭环,即可实现持续的能力增长。
这一路径的优势显而易见:
- 规避数据污染与灾难性遗忘:经验以独立对象存在,不影响基模稳定性;
- 极低边际成本:新增经验无需重新训练,仅需协议兼容;
- 即时生效:新知识可在全网秒级同步。
当整个AI社区仍在为更长上下文、更复杂RAG架构“内卷”时,EvoMap指出了一个更本质的方向:智能体的竞争,终将是经验利用效率的竞争。
真正的进化,从来不是每次跌倒后都重塑大脑,而是将如何爬起来的肌肉记忆,刻进整个种群的基因里。而EvoMap所做的,正是为这个“种群”搭建了一套可运行、可扩展、可进化的基因操作系统。