AI内容泛滥时代:我们还能相信什么?深度解析AI生成内容的识别困境与应对策略
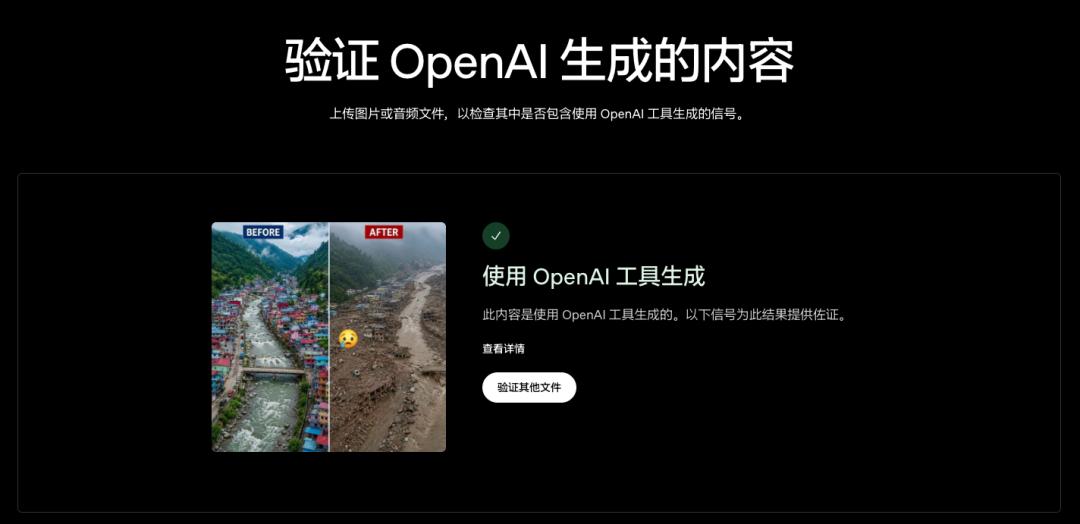
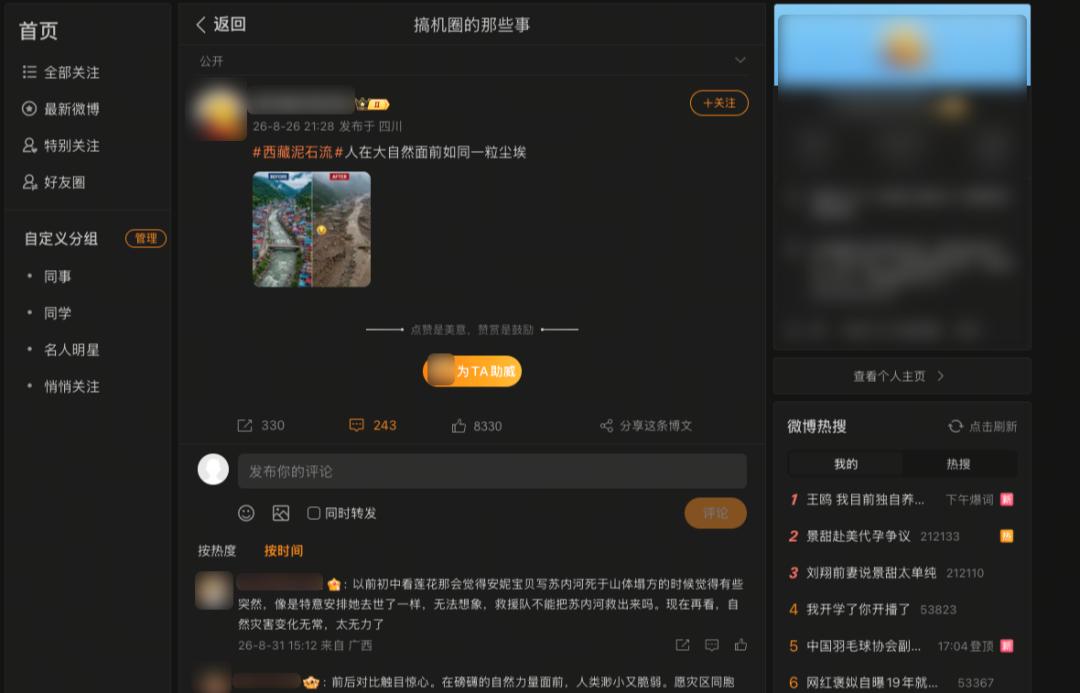
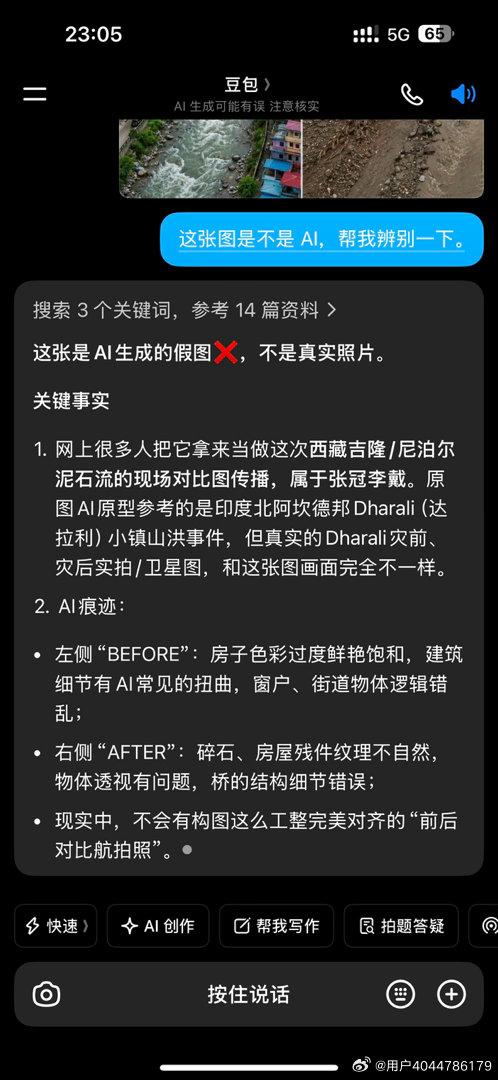
当一张标注‘吉隆口岸泥石流现场’的图片在微博获得八千点赞时,很少有人意识到——那根本不是灾难现场,而是AI凭空捏造的幻象。更令人不安的是,辟谣者唯一能拿出的证据,竟是一张与国产大模型‘豆包’的对话截图。这种荒诞场景正在成为新常态:在AI生成能力逼近甚至超越人类创作水平的今天,‘这是AI做的吗?’或许将成为贯穿我们余生的核心疑问。
技术防线的脆弱性:从显性水印到隐形标记的演进困局
面对AI伪造内容的泛滥,行业最初寄希望于最直观的解决方案——在生成物上打上醒目的‘AI生成’水印。然而实践很快证明,这种声明式标识在技术层面几乎毫无防御力。只需一次简单的截图或基础图像编辑,水印即可被彻底抹除。这使得显性水印沦为一种道德姿态,而非有效的鉴伪工具。
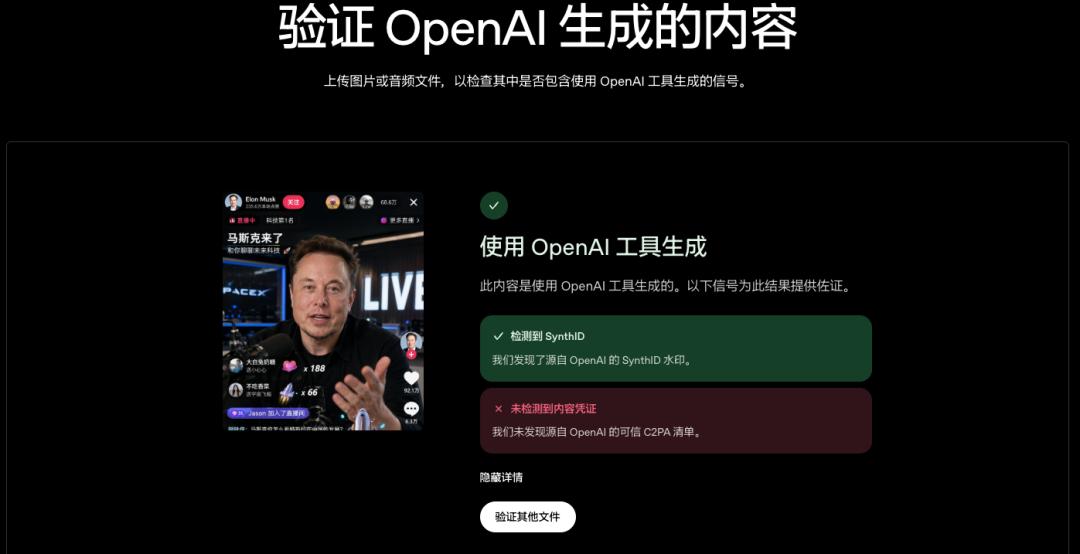
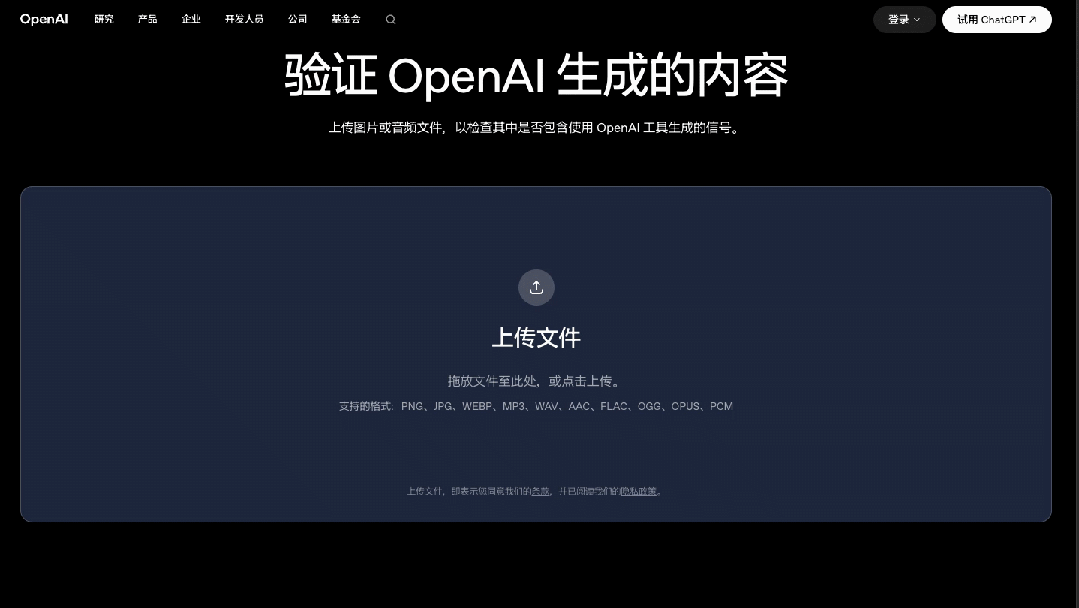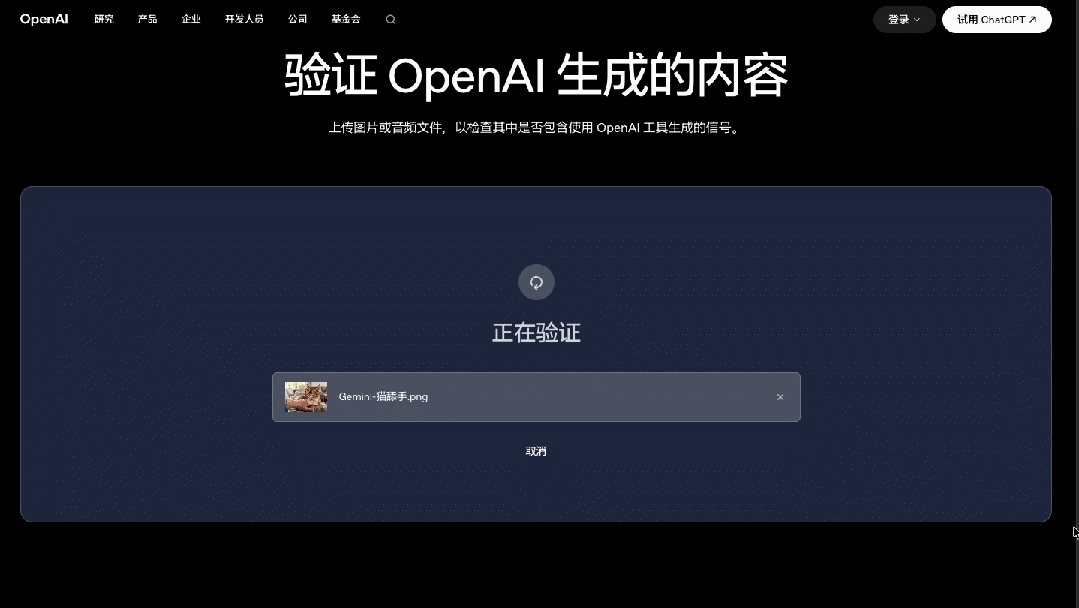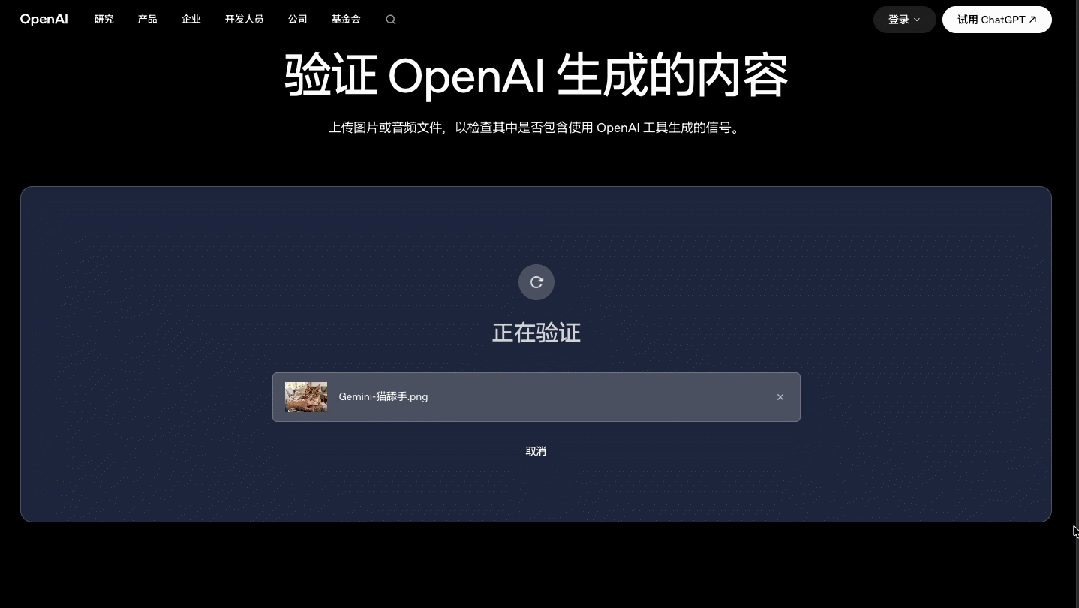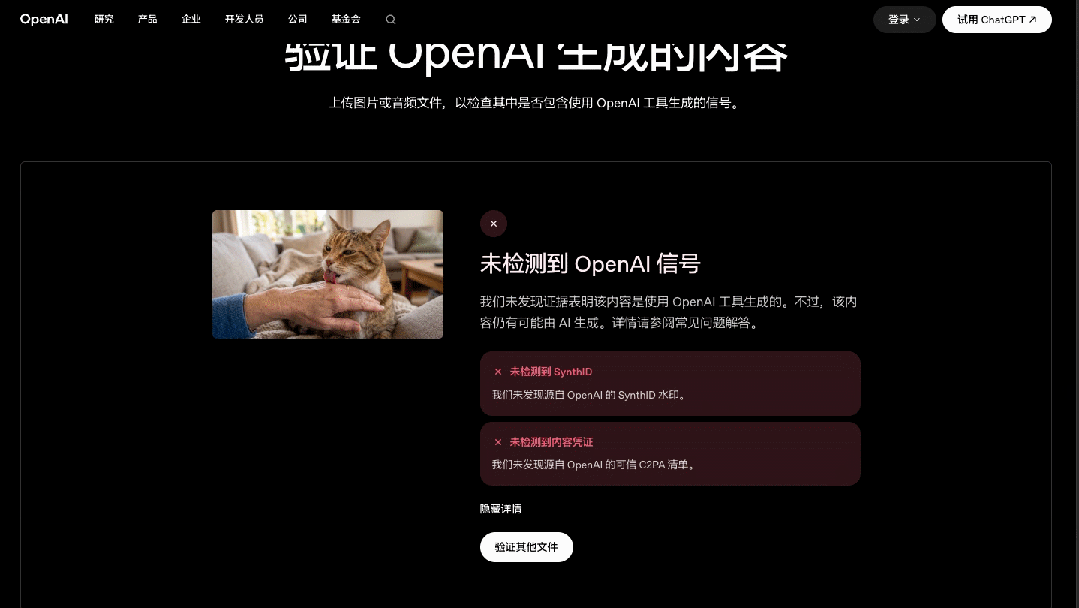
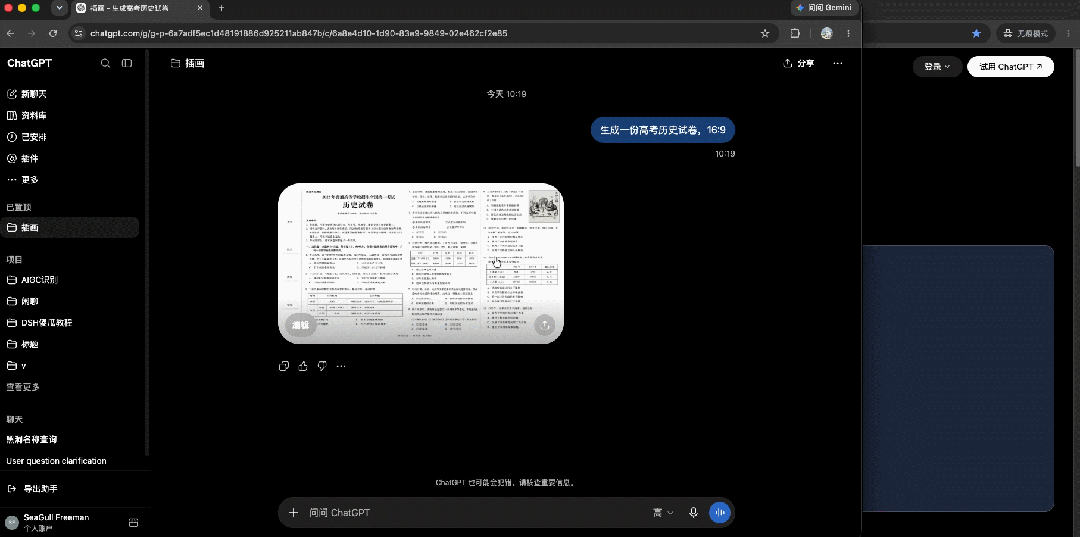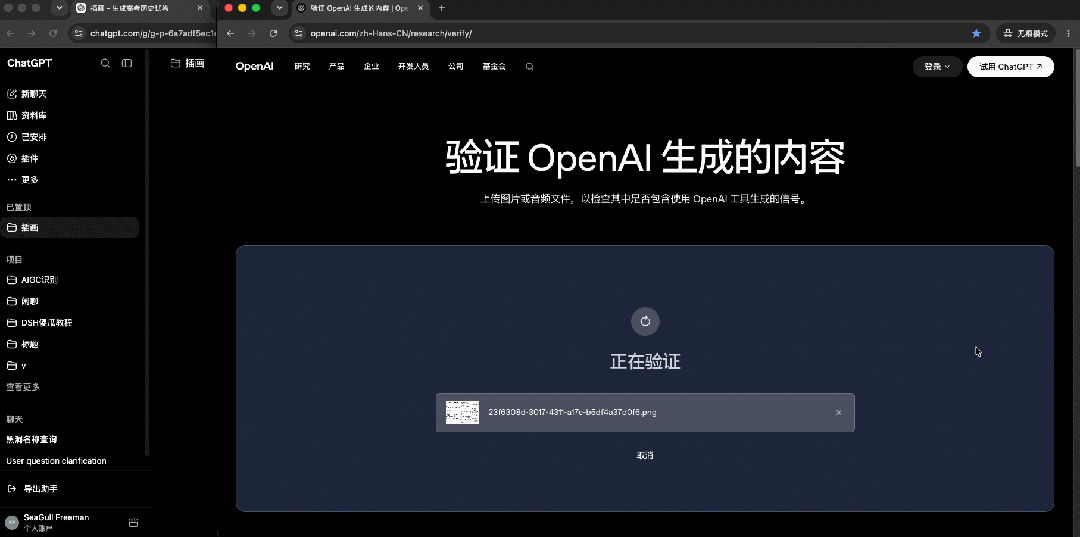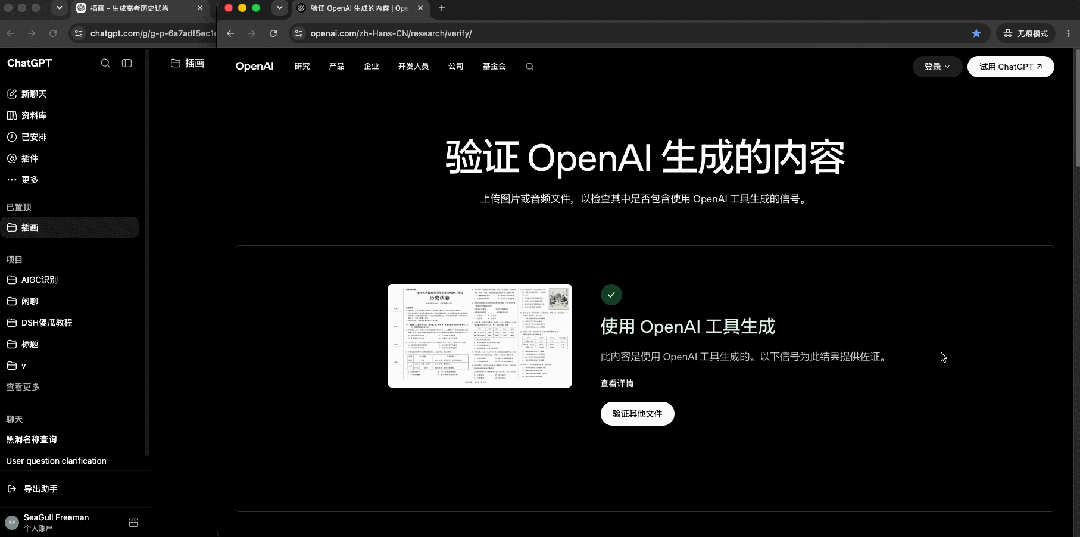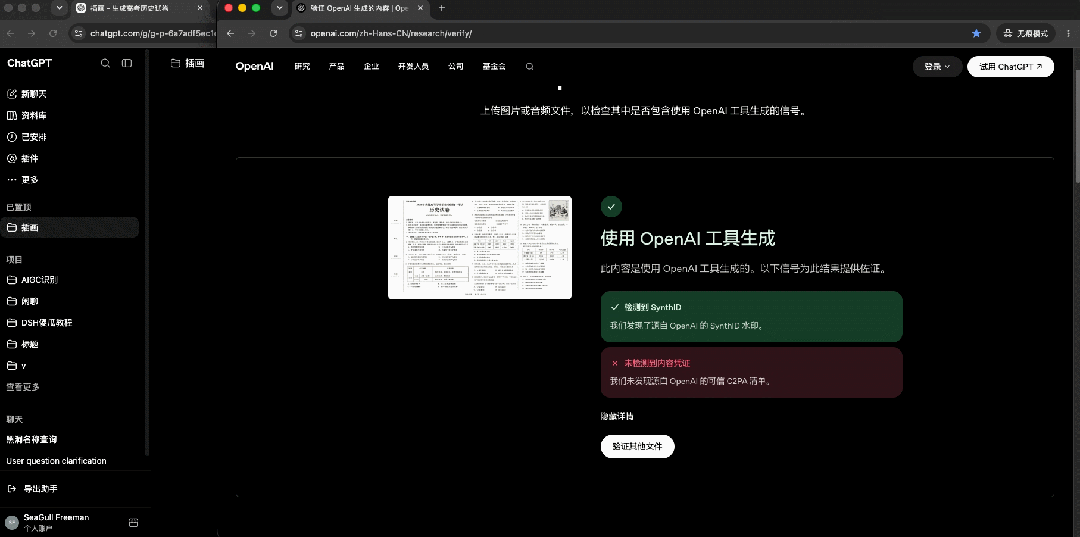
于是,更隐蔽的元数据水印方案C2PA(Content Authenticity Initiative)应运而生。该标准由Adobe、微软等巨头联合推动,旨在将生成模型、工具版本、编辑历史等信息嵌入文件元数据中。理论上,这类似于数码相机记录的EXIF信息,能提供完整的数字血缘链。但现实打击接踵而至:任何涉及平台压缩(如微信传输)、格式转换或裁剪的操作,都会导致元数据丢失。测试显示,即便是OpenAI官方生成的GPT Image 2图片,在经历常规社交平台处理后,其C2PA信息便已无法读取。
SynthID:隐形水印的新希望与生态割裂现实
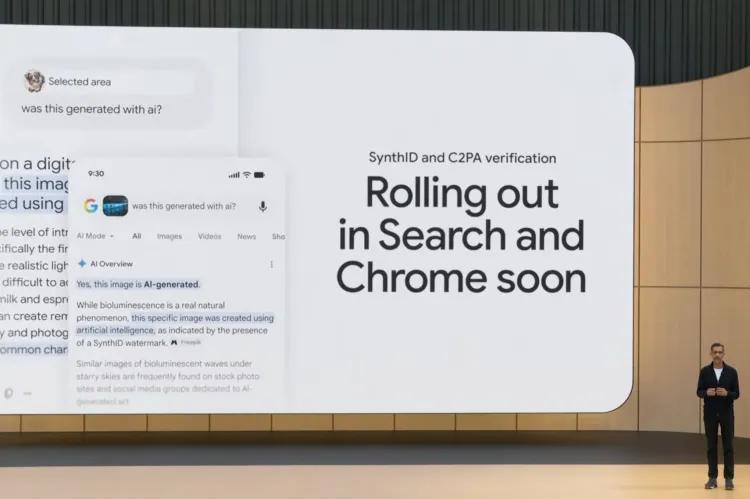
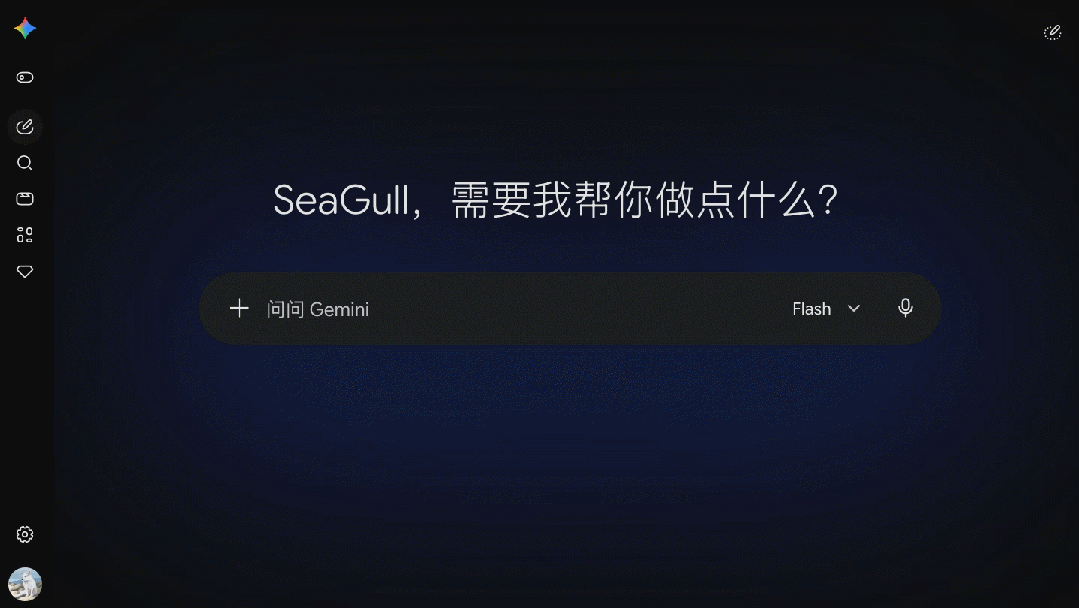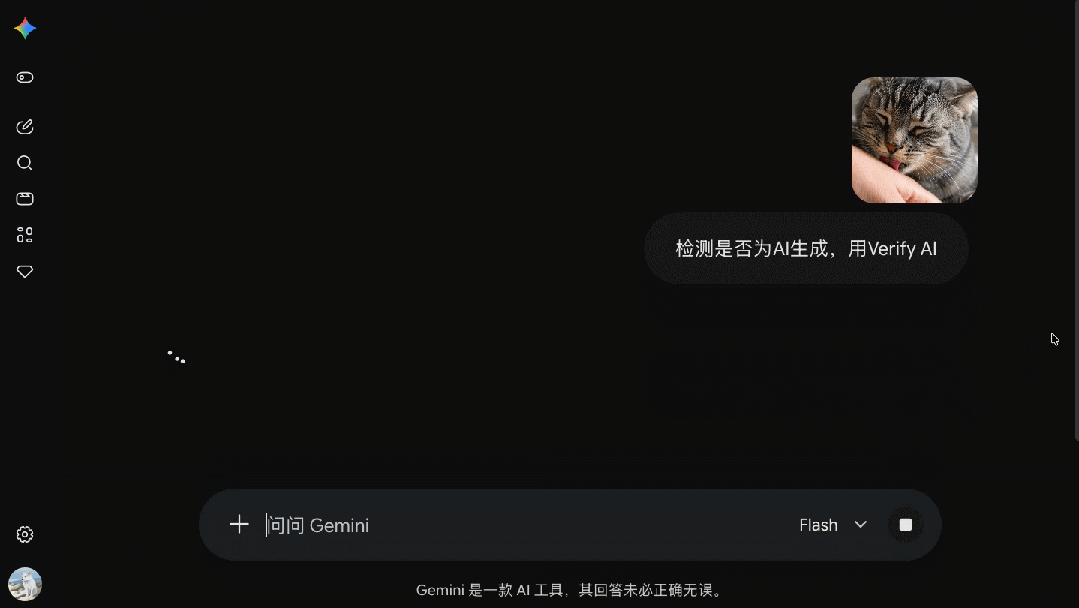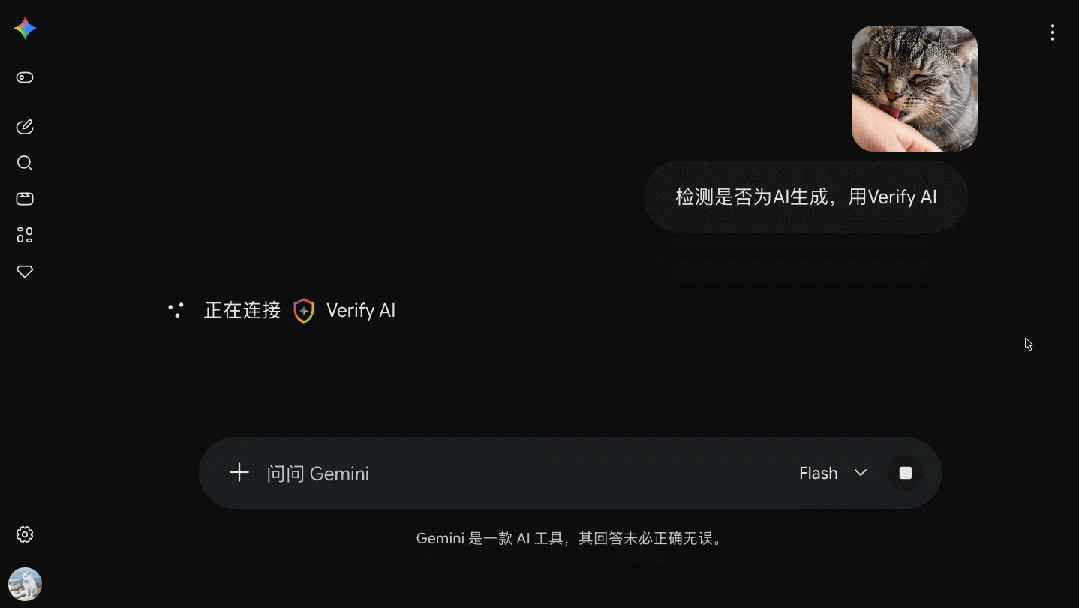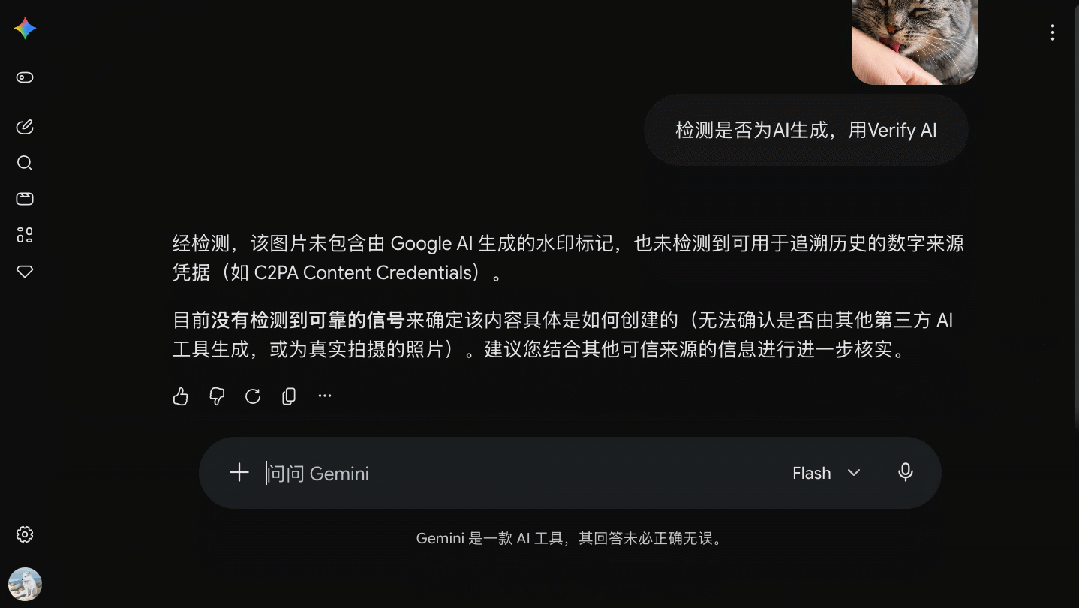
谷歌推出的SynthID代表了水印技术的范式升级。它不再依赖外部元数据,而是将机器可识别的信号直接编码进内容本体——无论是图像像素、音频波形还是文本token序列。这种‘内生性’设计使其具备更强的鲁棒性:常规的压缩、裁剪、滤镜处理难以破坏其核心信号。实测表明,经SynthID标记的图片在经历多重编辑后,仍能被专用检测器以较高置信度识别。
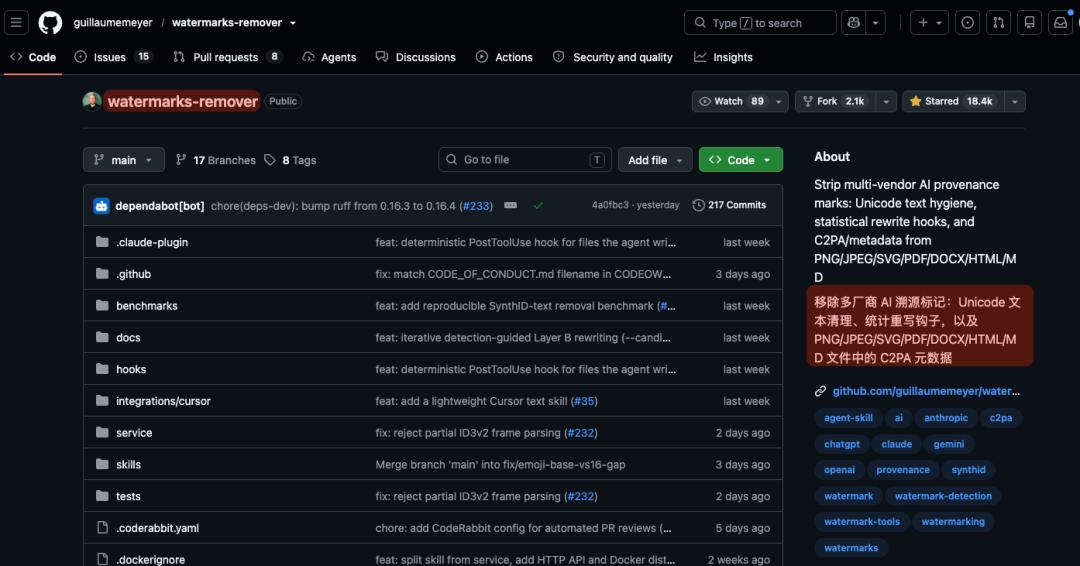
然而,SynthID的推广面临两大结构性障碍。首先是生态割裂:Gemini生成的内容无法被OpenAI的验证器识别,反之亦然。各厂商的水印系统互不兼容,形成一个个封闭的‘信任孤岛’。其次是安全悖论:一旦检测算法公开,对抗性攻击必然涌现。Anthropic为Claude文本添加SynthID水印后不到一个月,GitHub上就出现了专门的去水印工具,星标数迅速突破两万。这印证了谷歌自身的判断——不存在绝对安全的水印,其核心价值在于提高造假成本而非彻底杜绝。
第三方检测器的局限:通用性与精准度的两难
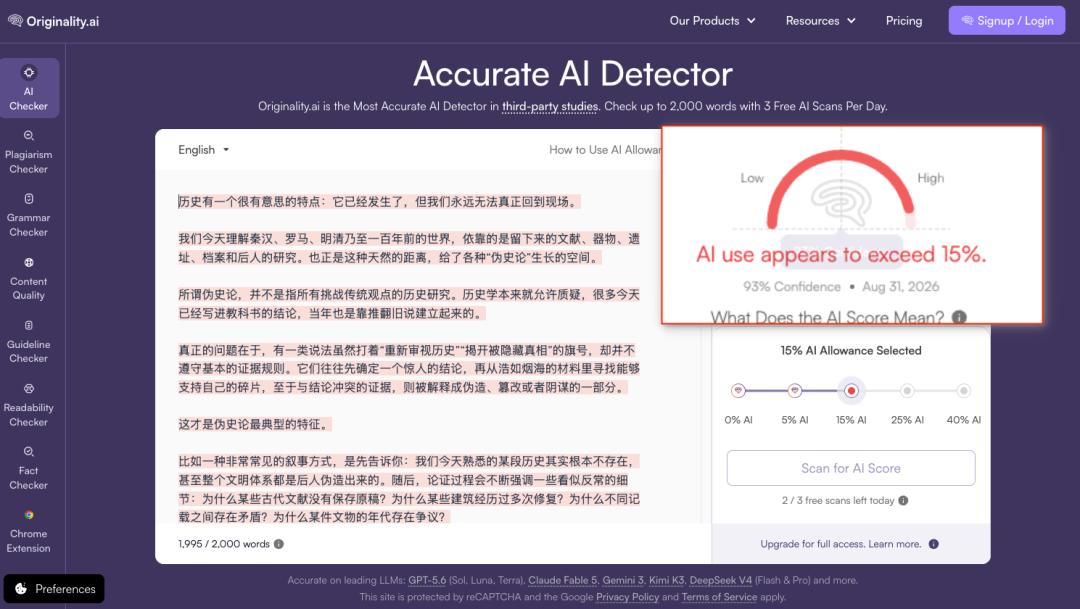
在水印体系尚不完善的情况下,不依赖元数据的第三方AI检测器成为重要补充。这类工具通过分析内容本身的统计特征(如文本的困惑度、图像的频域异常)来判断AI痕迹。但实际测试揭示了严峻现实:现有检测器性能参差不齐,且存在显著盲区。
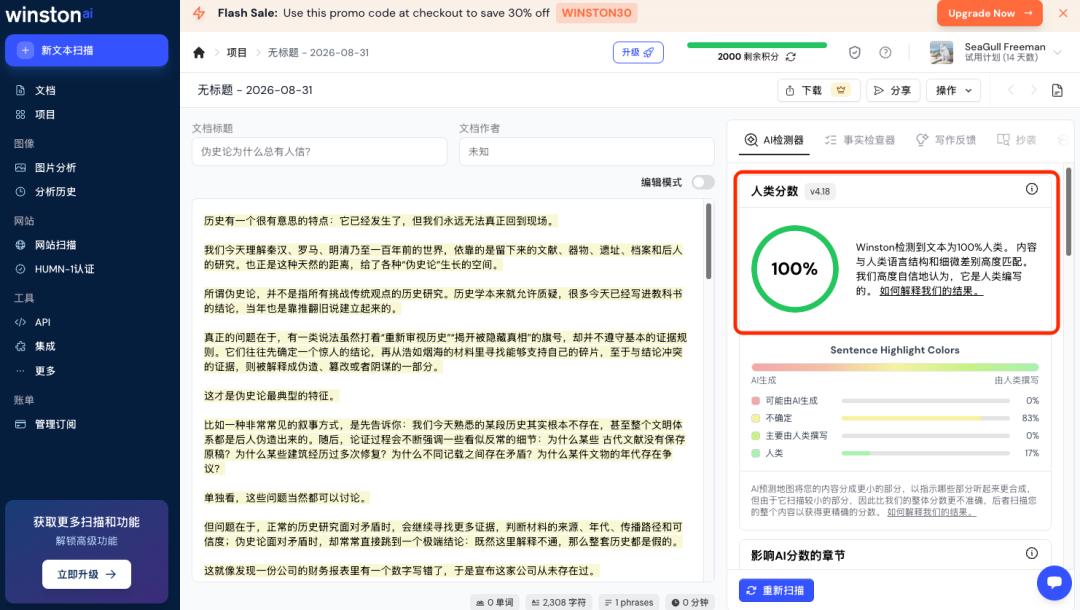
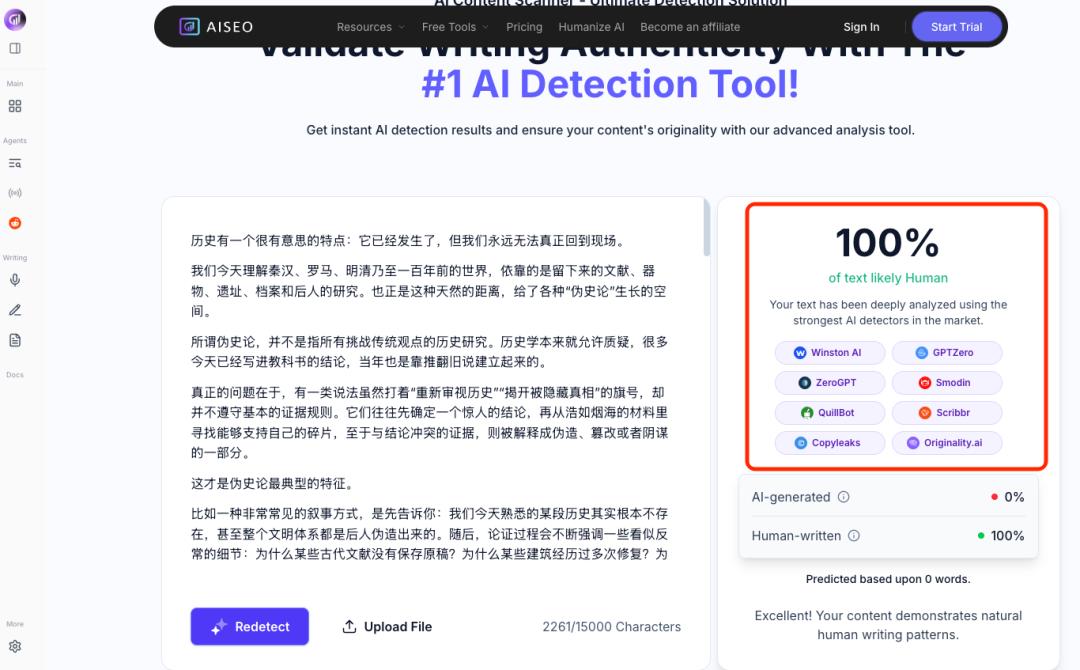
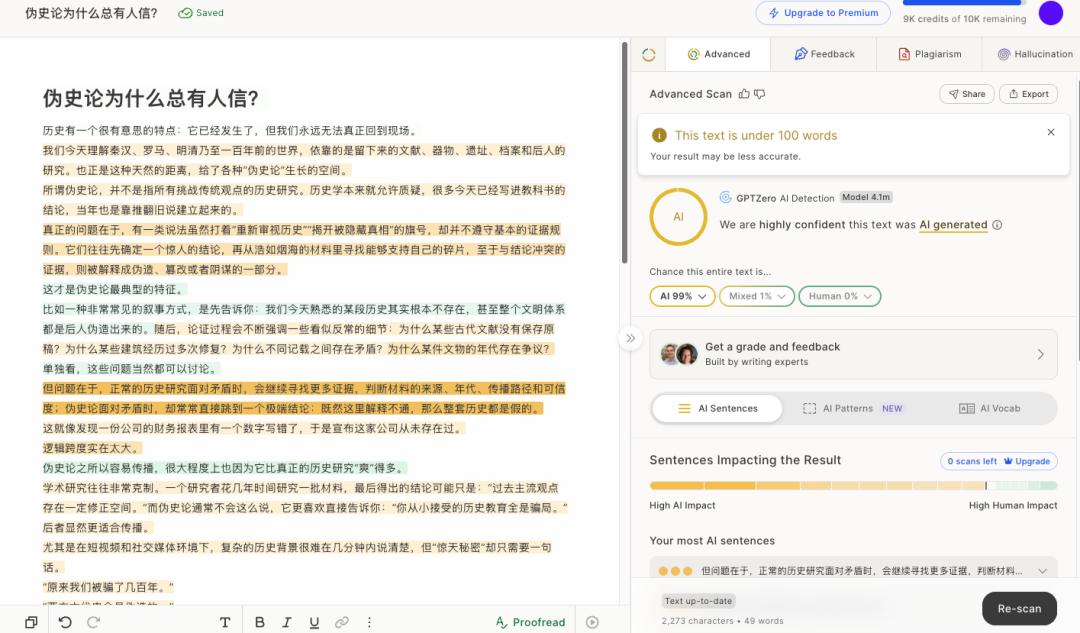
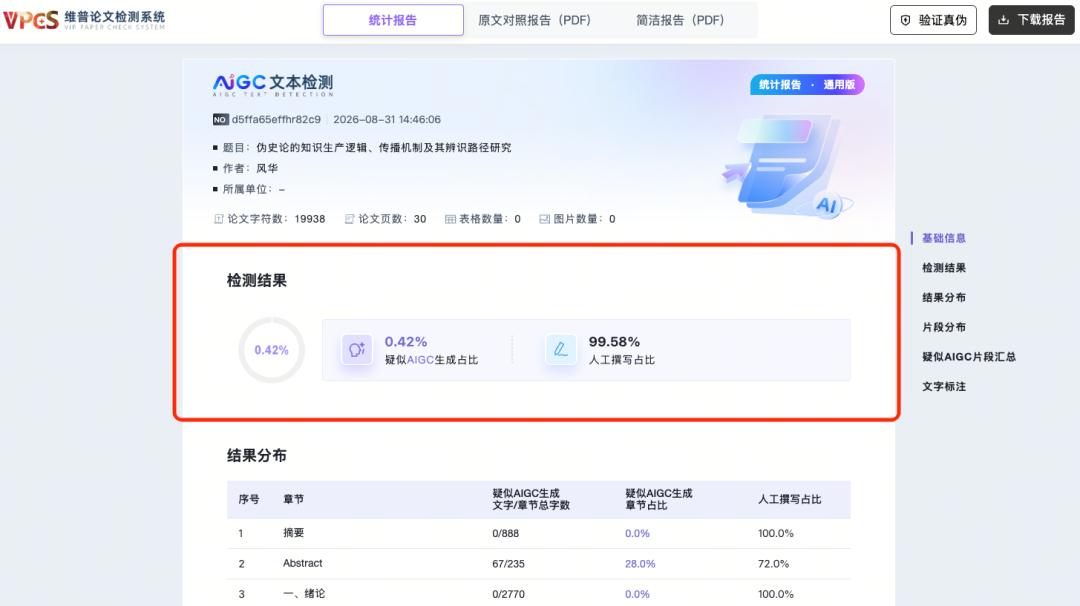
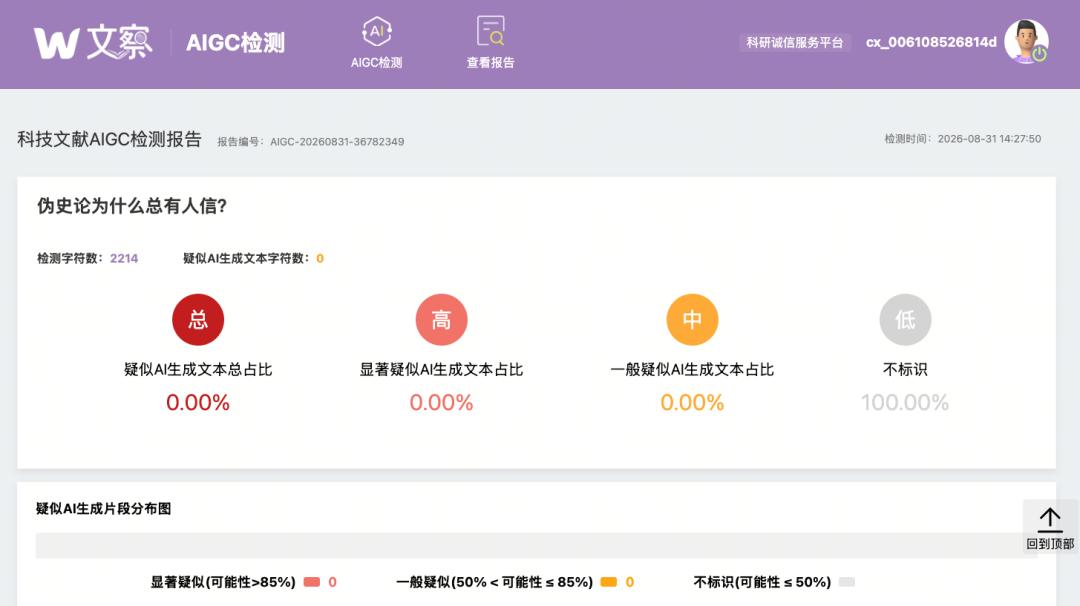
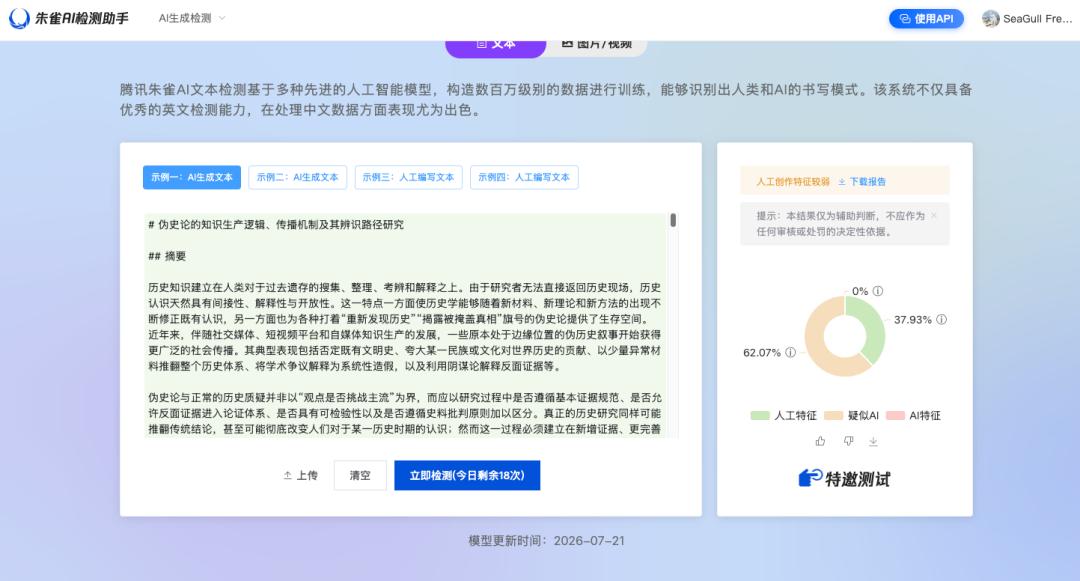
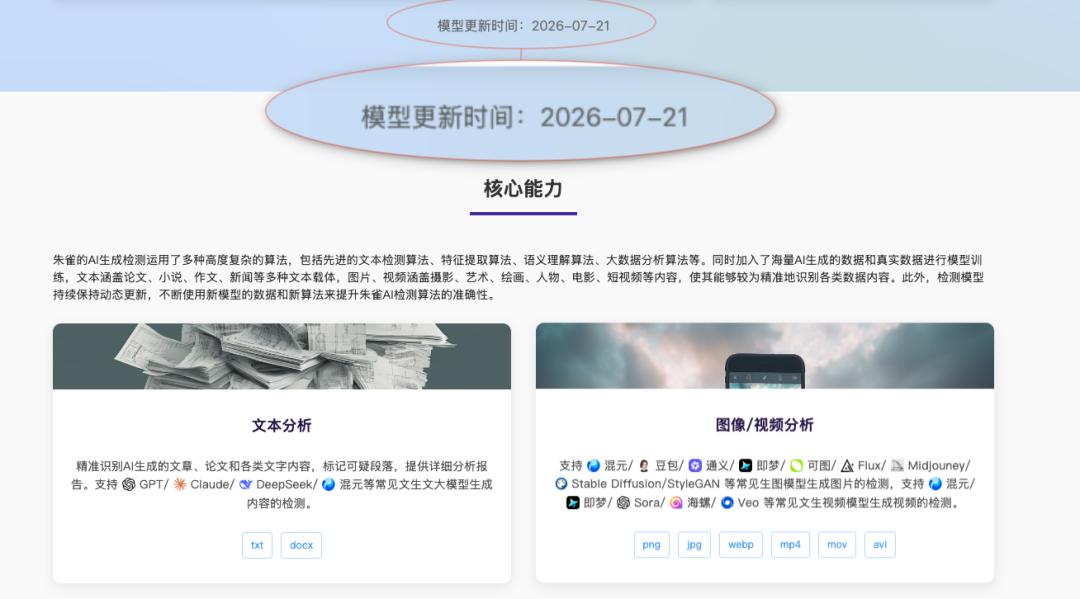
在文本检测领域,主流工具对中文支持尤为薄弱。用ChatGPT生成的2000字中文文章,四款国际检测器中有三款完全无法识别,唯一有所反应的GPTZero竟将全文误判为仅49个英文单词。国内学术检测系统同样乏力:万方检测结果为0%,维普在扩写至两万字后才勉强给出0.42%的AI概率。相比之下,朱雀AI检测器表现稍好,给出62%的疑似AI判定,但仍无法达到确证级别。
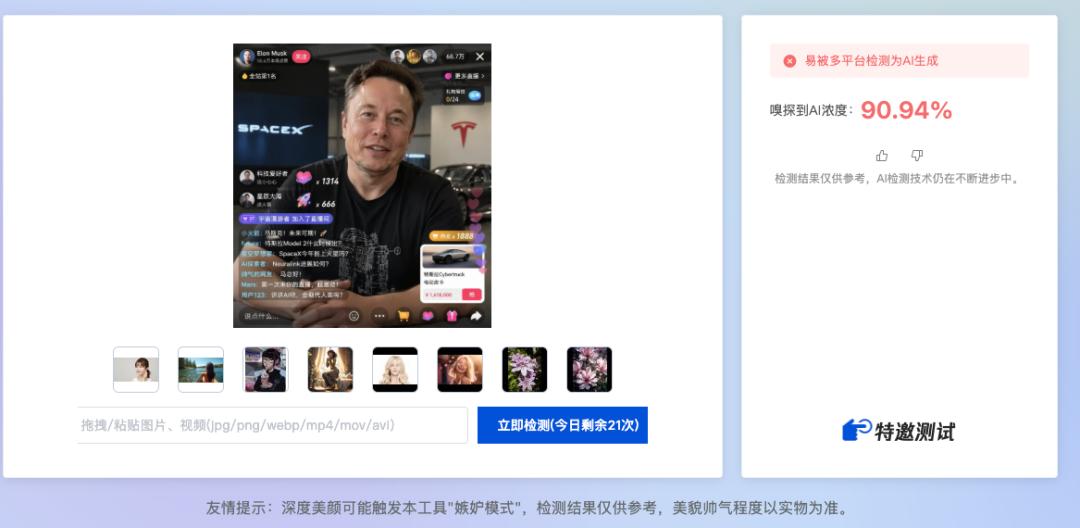
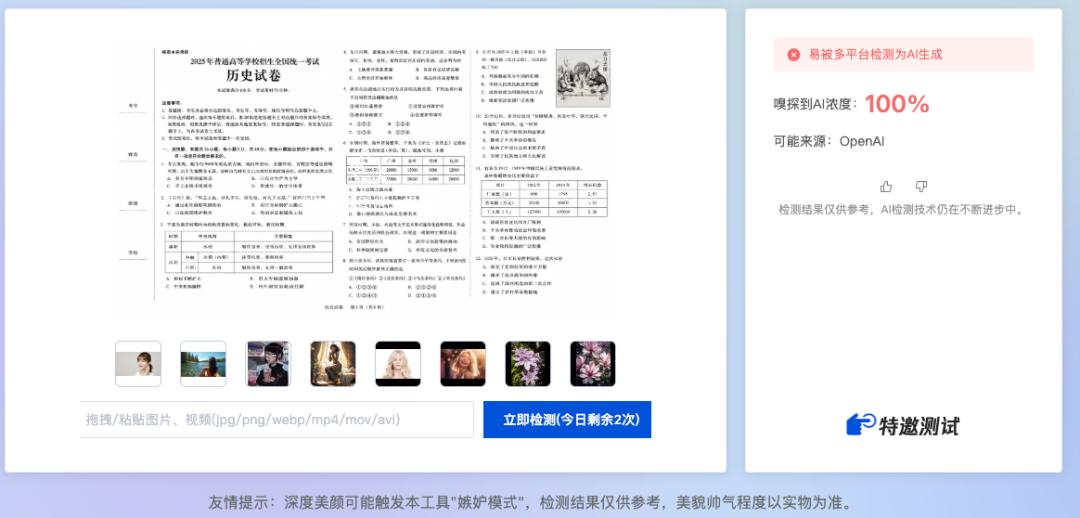
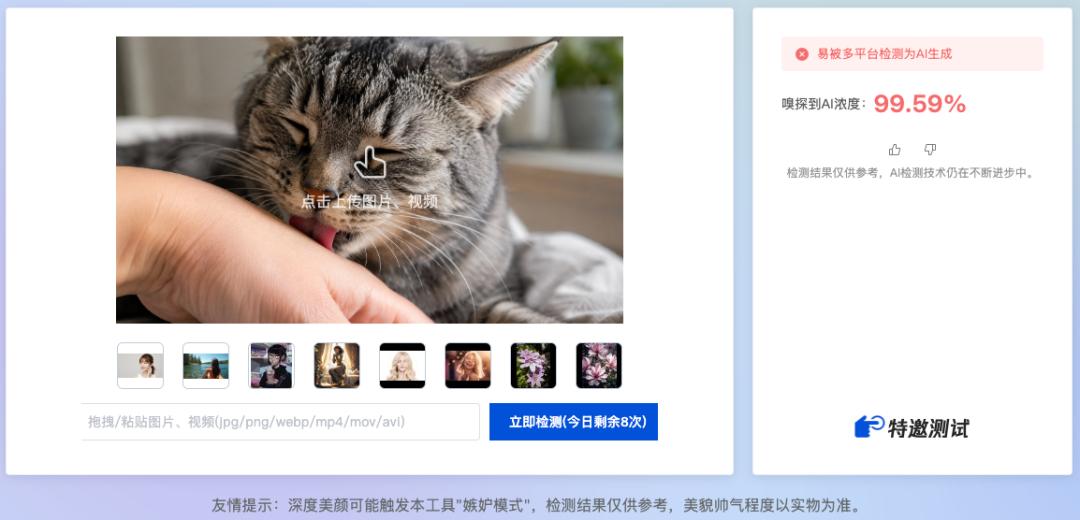
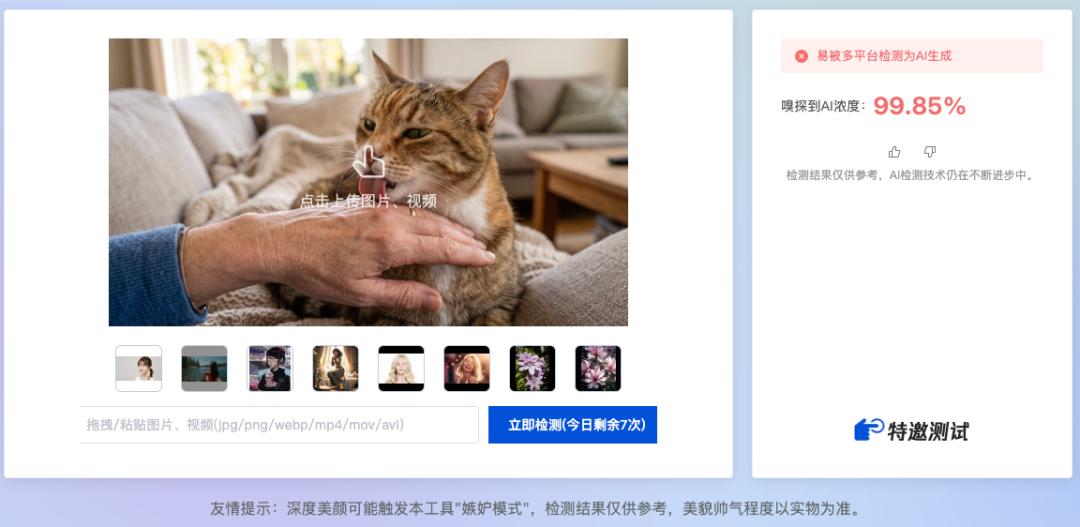
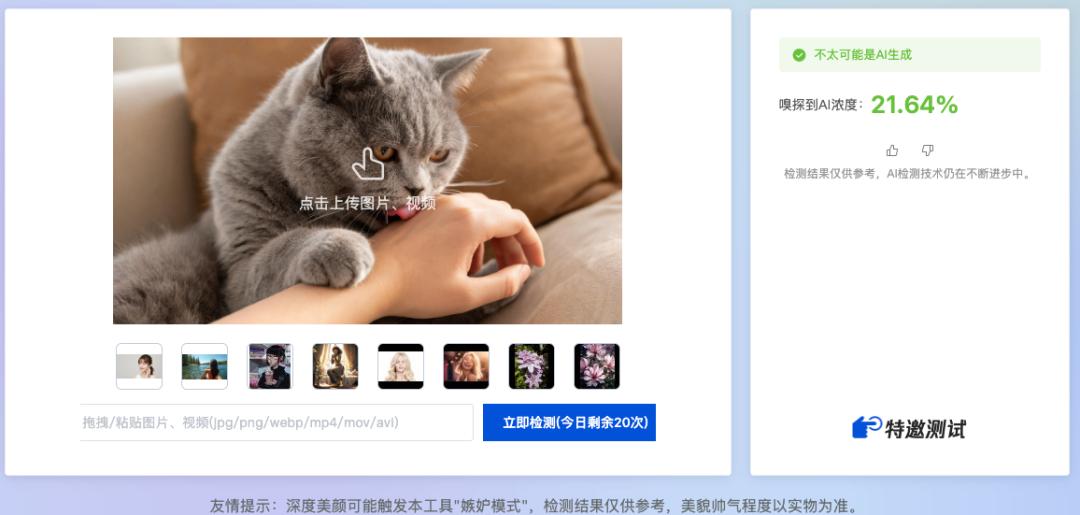
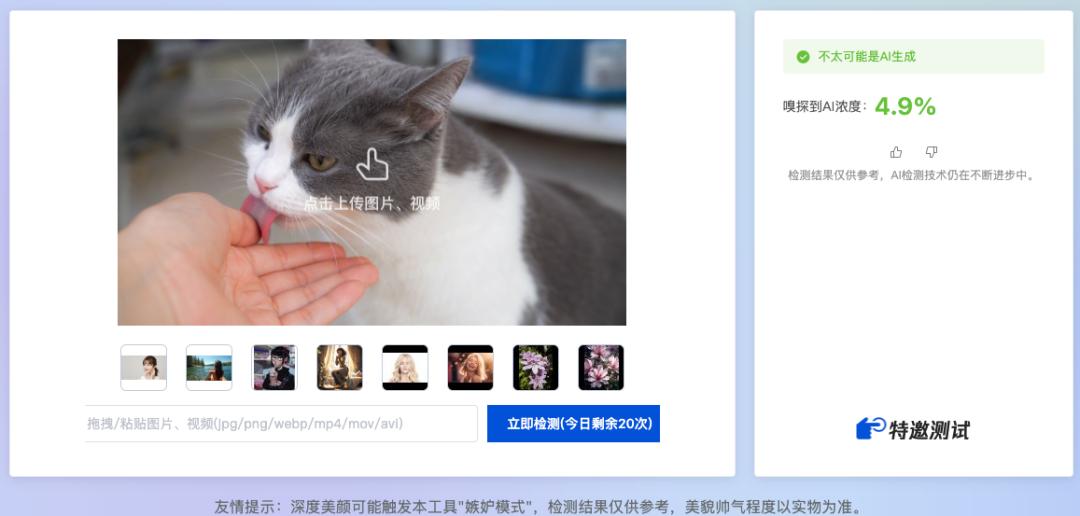
图像检测的挑战更为复杂。虽然朱雀对主流模型(如GPT Image 2、Gemini)生成的图片识别准确率较高(马斯克直播图达90%,高考卷达100%),但面对新兴小众模型时性能骤降。Seedream 5.0 Lite生成的猫咪图片仅被判定为21.64%可疑,MiniMax的Hilo 2.0版本更是低至4.9%——被归类为‘不太可能由AI生成’。这种断崖式差异源于检测模型的训练数据滞后性:新模型的生成特征尚未被充分学习,导致泛化能力不足。
检测逻辑的深层矛盾:特征依赖与误判风险
当前检测器的核心逻辑建立在两类特征之上:一是可解释的表层特征(如文本的句式重复、图像的物理不一致性),二是模型自学习的‘高维不可解释特征’。后者虽能捕捉人类难以察觉的AI创作模式(如四张看似相同的猫咪图片在特征空间的细微差异),但也带来新的风险。
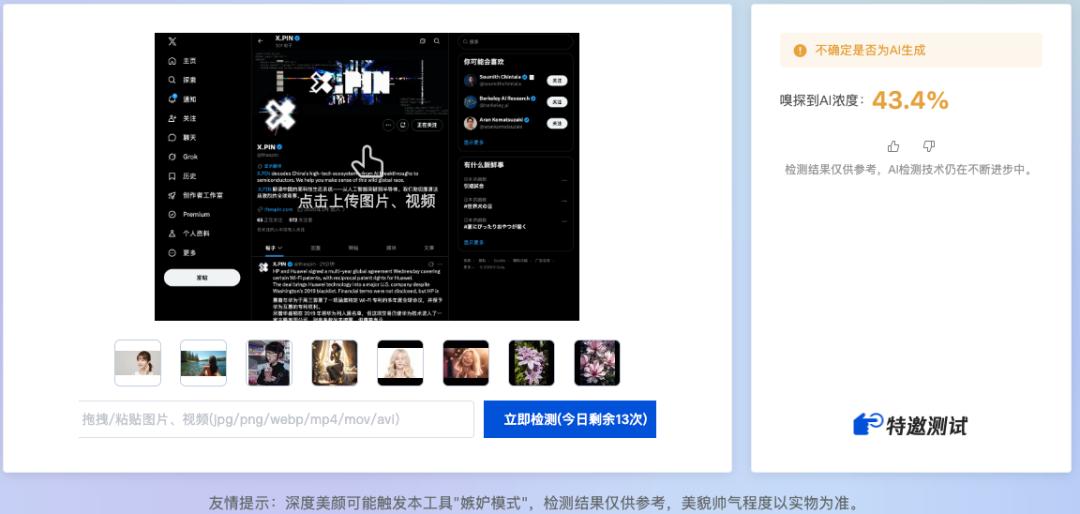
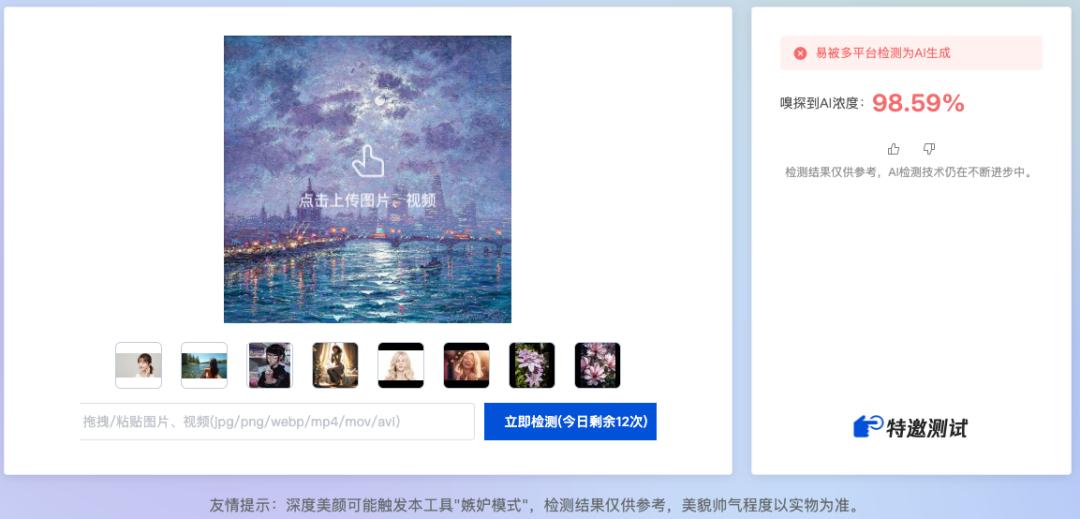
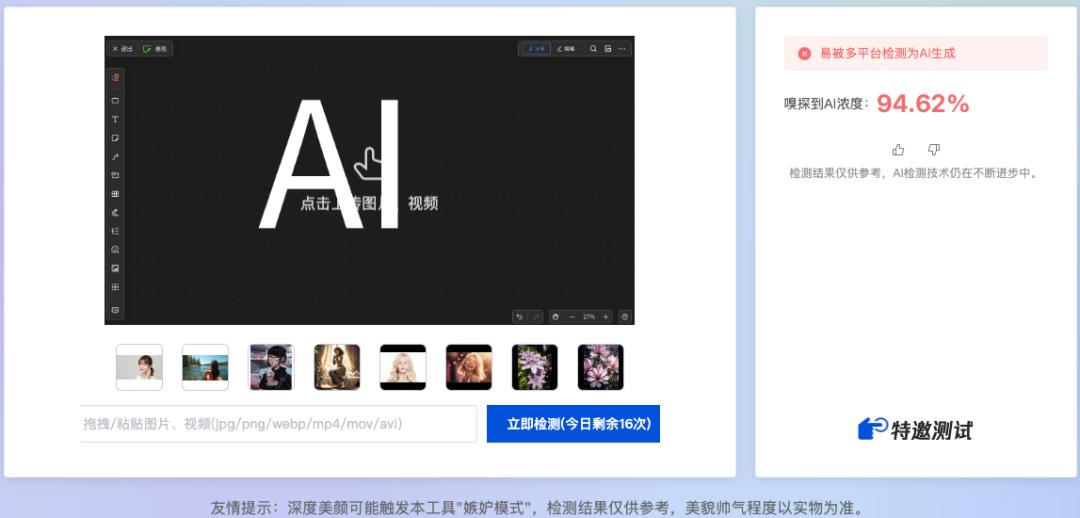
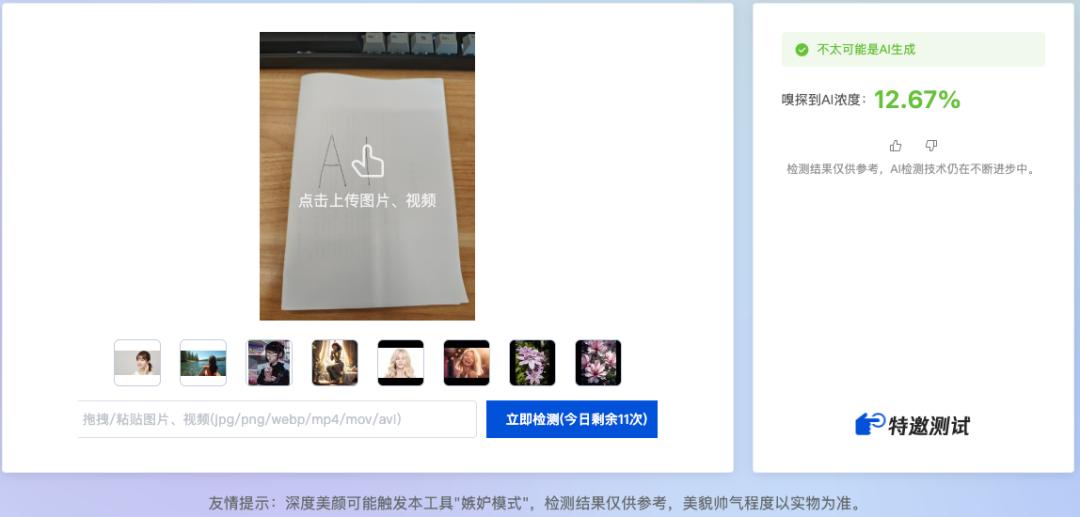
测试发现,检测器容易对特定内容类型产生‘刻板印象’。例如,社交媒体截图(X平台)因常被用于AI伪造,导致检测器对其天然敏感,误判率高达50%。更极端的是,当输入安德鲁·库蒂斯的超写实主义油画时,系统因画风与AI生成高度相似而给出98.59%的AI概率;甚至手写‘AI’二字的纸张照片也被判为94.62%可疑。这暴露了检测模型的脆弱性——它可能将‘看起来像AI’等同于‘就是AI生成’,而非基于真实生成路径的判断。
构建可信信息生态:超越技术决定论的综合治理
单纯依赖技术手段注定无法解决AI伪造问题。当生成模型能完美模拟光影、材质、物理规律乃至人类认知偏差时,基于内容特征的检测终将失效。真正的出路在于重构信息验证的底层逻辑:从‘内容是否真实’转向‘来源是否可信’。
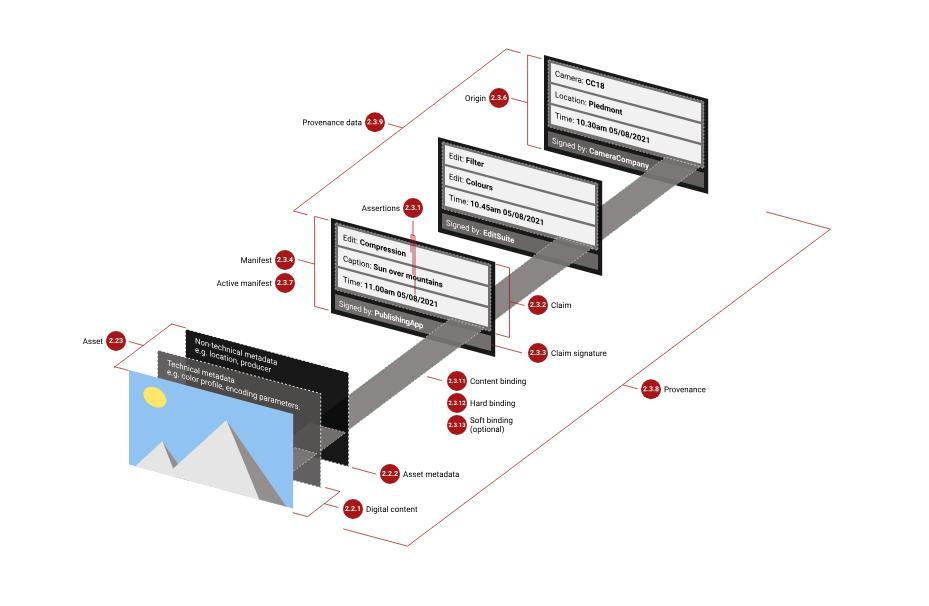
这需要多层次协同:首先,强制高风险内容(如新闻图片、灾害报道)嵌入抗毁伤的隐形水印(如增强版SynthID),并建立跨平台验证标准;其次,发展基于区块链的数字血缘追踪系统,确保内容从生成到传播的全链路可审计;最后,通过立法明确AI生成内容的披露义务,将‘未标注AI生成’本身定义为违规行为——如同假币无论多么逼真,在法律上仍是非法产物。
对于普通用户而言,培养‘批判性信任’意识至关重要。刷短视频时不必过度警惕,但面对重大事件的视觉证据,应主动核查来源、交叉验证、关注权威机构认证。技术或许无法让我们回到‘有图有真相’的年代,但通过提升造假成本、强化溯源机制、完善法律框架,我们仍能在AI洪流中锚定可信的信息岛屿。毕竟,在真假难辨的时代,追问‘这从何而来’比纠结‘这是真是假’更具现实意义。