Meta发布Muse Voice Transcribe:实时分轨转写20+说话人,每千分钟3美元值不值?
近年来,语音识别技术从单人朗读走向真实世界复杂场景的挑战日益凸显。会议室里多人插话、电话客服中客户与坐席交替发言、线上直播中观众与主播混杂发声——这些高噪声、高并发的音频环境对传统自动语音识别(ASR)系统构成严峻考验。2026年9月,Meta正式推出其首个实时音频感知模型 Muse Voice Transcribe,试图以一体化架构破解这一难题。
该模型最引人注目的能力在于:在包含20余名说话者的录音中,仍能实现精准的说话人分离与同步转写。这意味着系统不仅能“听清”谁在说话,还能“记住”每个说话人的声纹特征,并将其发言内容独立成轨,最终输出结构化的多通道文本。这种能力在以往通常需要多个独立模块(如语音活动检测、说话人嵌入提取、聚类、ASR等)串联完成,而Muse Voice Transcribe将其整合进单一推理流程,显著降低系统复杂度与延迟。
流式处理:边说边出字,告别“等待式”转写
传统批处理式ASR需等待整段音频录制完毕后才开始识别,导致用户无法在对话进行中获取文字反馈。而Muse Voice Transcribe采用流式架构(streaming architecture),允许模型在音频输入过程中持续输出转写结果。例如,在一场线上会议中,当某位参会者发言时,系统几乎同步生成对应文字,并标注说话人ID(如Speaker 3),无需等到会议结束。
这种设计极大提升了用户体验,尤其适用于以下场景:
- 实时会议纪要:自动记录多方讨论内容,便于会后整理与任务分配;
- 无障碍字幕:为听障人士提供即时语音转文字服务,支持多说话人区分;
- 客服质检:实时监控通话质量,自动标记关键语句或情绪波动;
- 播客/访谈后期:快速生成带说话人标签的原始文稿,节省人工标注时间。
值得注意的是,流式处理并非简单地“切片识别”。Muse Voice Transcribe在内部实现了端点检测(endpoint detection)与上下文缓存机制,确保句子边界判断准确,避免因过早截断导致语义断裂。例如,当说话人停顿思考时,系统不会误判为发言结束,而是结合语义连贯性与声学特征综合判断。
自适应延迟:智能权衡速度与准确率
在实时系统中,延迟与准确率往往是一对矛盾体。若追求极低延迟,模型可能因信息不足而误识;若等待更多上下文,则响应变慢,影响交互流畅性。为此,Meta引入了名为“自适应延迟”(adaptive delay)的动态决策机制。
该机制的核心思想是:不对所有词汇采用统一的延迟策略,而是根据当前语音片段的识别难度动态调整。具体而言,系统会实时评估以下因素:
- 语音清晰度(信噪比、发音规范性);
- 词汇罕见程度(是否包含专业术语、专有名词);
- 上下文歧义性(是否存在同音异义或多义结构)。
对于高置信度的常见词(如“今天”“会议”),模型可立即输出;而对于模糊或复杂的片段(如“量子退相干效应”),则会短暂缓冲后续几帧音频,利用更长的上下文提升识别准确率。Meta官方测试显示,该机制在保持平均延迟低于800毫秒的同时,将词错误率(WER)降低了12%以上。
这种精细化控制远超传统固定缓冲窗口的做法,体现了大模型时代对“感知-决策-输出”闭环的深度优化。
多语言与混合语码:覆盖全球70+语言,支持自然切换
全球化应用场景要求语音系统具备强大的多语言处理能力。Muse Voice Transcribe在训练阶段覆盖了超过70种语言,涵盖主流语种(英语、中文、西班牙语等)及部分低资源语言(如斯瓦希里语、孟加拉语)。截至发布时,已有25种语言通过严格验证,达到商用级准确率标准。
更值得关注的是其对混合语码(code-switching)的支持。在真实对话中,用户常在一句话内切换语言,例如:“这个project的deadline是下周一,你得赶紧finish it。”传统ASR对此类输入往往识别混乱,而Muse Voice Transcribe通过联合建模多语言声学与语言模型,能够自然处理句内或句间的语言切换,无需预设语言标签。
此外,开发者还可通过上下文偏置(contextual biasing)功能,向模型注入特定领域的关键词列表或术语表。例如,在医疗场景中加入“心肌梗死”“CT扫描”等词汇,可显著提升相关术语的召回率。这种灵活性使其能快速适配金融、法律、教育等垂直领域。
成本与接入:每千分钟3美元,开发者友好
在商业化方面,Meta采取了相对亲民的定价策略:每1000分钟音频处理费用为3美元(约合人民币20.2元),折合每小时0.18美元。对比市场同类服务(如Google Speech-to-Text流式API约0.024美元/分钟,即14.4美元/千分钟),Muse Voice Transcribe的价格优势明显。
更重要的是,该服务通过Meta Model API开放,支持RESTful接口与WebSocket流式接入,文档齐全,示例丰富。开发者只需几行代码即可集成实时转写能力,无需自建GPU集群或维护复杂语音流水线。对于中小企业或初创团队而言,这大幅降低了AI语音应用的门槛。
不过需注意,当前API仅支持音频输入,暂不提供视频分离或背景音乐抑制功能。若需处理含强背景噪声的录音,建议前置降噪模块。
行业地位:登顶Artificial Analysis流式ASR榜首
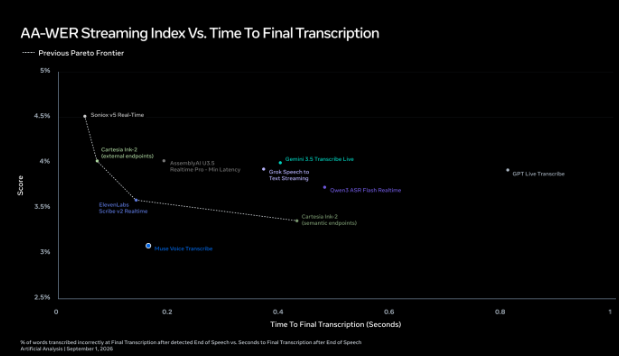
据Meta官方披露,截至2026年9月1日,Muse Voice Transcribe在权威评测平台Artificial Analysis的“流式语音转文本”排行榜中位列第一。该榜单综合考量延迟、准确率、多说话人处理能力、语言覆盖广度等维度,具有较高公信力。
这一成绩标志着Meta在语音AI领域的重大突破。过去几年,Meta虽在文本生成(如Llama系列)、图像生成(如Make-A-Scene)等领域表现活跃,但在语音赛道相对低调。Muse Voice Transcribe的推出,不仅补全了其多模态AI能力拼图,也为开发者生态注入新动力。
潜在挑战与未来方向
尽管技术亮点突出,Muse Voice Transcribe仍面临若干挑战:
首先,极端重叠语音(如三人同时高声争论)的分离效果仍有提升空间。虽然支持20+说话人,但实际性能随并发数增加而下降,尤其在声学特征相近的说话人之间(如同性别、同龄人)。
其次,低资源语言的准确率尚未完全公开。70种语言中仅25种通过验证,其余语种的实际表现尚待观察。
最后,隐私与合规问题不容忽视。实时语音处理涉及敏感对话数据,Meta需明确数据存储策略(是否留存音频?是否用于模型再训练?),并符合GDPR、CCPA等法规要求。
展望未来,Muse Voice Transcribe有望向三个方向演进:一是集成情感识别与意图分析,从“转写”迈向“理解”;二是支持端侧部署,满足离线或高安全场景需求;三是与Meta旗下社交产品(如WhatsApp、Instagram)深度整合,提供原生语音交互体验。
结语:重新定义实时语音交互的边界
Muse Voice Transcribe的发布,不仅是Meta在语音AI领域的一次技术亮剑,更是对“实时多说话人语音处理”这一行业难题的系统性回应。通过流式架构、自适应延迟、多语言混合建模等创新,它在速度、准确率与实用性之间找到了新的平衡点。
对于开发者而言,每千分钟3美元的定价提供了高性价比的语音能力入口;对于终端用户而言,更流畅、更智能的语音交互体验正在成为现实。随着模型持续迭代与生态扩展,Muse Voice Transcribe或将成为下一代语音应用的基础设施之一。