腾讯混元开源Hy4preview:770B参数、1M上下文如何重塑AI生产力边界?
近年来,大模型的发展路径正经历从“规模至上”向“实用为王”的深刻转型。2026年8月28日,腾讯混元正式推出其新一代开源旗舰模型——Hy4preview,以770B总参数、49B激活参数和100万(1M)上下文长度的配置,再次将行业目光聚焦于“真实生产力场景”的落地能力。这一发布不仅标志着腾讯在基础模型领域的技术积累进入新阶段,更折射出整个AI产业对模型实效性、可部署性与垂直场景适配性的高度关注。
Hy4preview并非单纯追求参数堆砌的产物,而是通过稀疏激活机制(如专家混合架构,MoE)实现高效推理。其770B的总参数中,每次前向传播仅激活约49B,大幅降低计算开销,同时保留海量知识容量。这种设计思路与当前主流大模型如Mixtral、GLM-MoE等一脉相承,但在上下文长度上实现了显著突破——1M token的支持使其能够处理整本小说、完整代码仓库或长时间对话历史,为复杂任务提供前所未有的信息承载能力。
值得注意的是,腾讯选择以“preview”形式开源早期版本,体现出一种敏捷迭代的产品哲学。官方明确表示,Hy4preview仍存在“复杂任务长思考”等已知问题,预训练与后训练阶段均有优化空间。这种开放早期版本、吸纳社区反馈的做法,正在成为头部厂商的共识,反映出大模型竞争已从封闭式技术比拼转向开放式生态共建。
在能力构建方面,Hy4preview并非泛化通用模型,而是深度耦合腾讯内部业务场景的数据与专家知识。其训练数据来源于腾讯在软件工程、游戏开发、金融科技与网络安全等核心领域的高质量语料,并与一线工程师、研究员共同打磨。这种“领域共建”模式确保了模型在特定任务上的专业性与可靠性,避免了通用模型在垂直场景中的“水土不服”。
软件工程是Hy4preview重点突破的方向之一。传统代码助手多局限于单文件补全或简单调试,而Hy4preview则展现出对长程开发任务的理解与规划能力。例如,它能根据产品需求文档自动生成模块化代码结构,协调多个微服务接口,并在后续迭代中持续跟踪变更、自动修复兼容性问题。在内部测试中,模型可完成从需求分析、架构设计到单元测试的全流程辅助,显著缩短开发周期。
办公场景的智能化同样取得实质性进展。Hy4preview不仅能理解用户自然语言指令,还能跨文档、表格与演示文稿进行协同操作。例如,用户输入“基于Q2销售数据生成一份包含趋势分析与竞品对比的PPT”,模型可自动提取Excel中的原始数据,运用统计方法识别关键指标,撰写分析文本,并排版成符合企业视觉规范的幻灯片。这种端到端的交付能力,远超当前多数办公AI工具的碎片化功能。
游戏开发领域则展示了Hy4preview与专业引擎的深度集成能力。通过MCP(Model-Code-Platform)协议,模型可直接接入Unreal Engine 5与Unity团结引擎,实现“纯对话驱动开发”。开发者只需描述游戏玩法、美术风格与交互逻辑,Hy4preview即可生成可运行的Demo,包括角色控制脚本、关卡布局、粒子特效甚至基础AI行为树。这一能力极大降低了游戏原型制作门槛,尤其适用于独立开发者与小型工作室。
科研计算是Hy4preview最具突破性的方向之一。在数学领域,模型配合专用推理模块Hyra,成功将百年难题“三维Blaschke–Lebesgue问题”的体积下界从0.380799提升至0.41104。该问题旨在寻找给定宽度下体积最小的凸体,而Meissner四面体被猜想为最优解。当前结果距理论极限仅差约2%,显示出AI在纯数学证明中的辅助潜力。在计算物理方面,Hy4preview在32,512原子规模的磷脂双分子层分子动力学模拟中实现2.0倍加速,单步计算时间降至54.9毫秒,为生物膜研究提供高效工具。
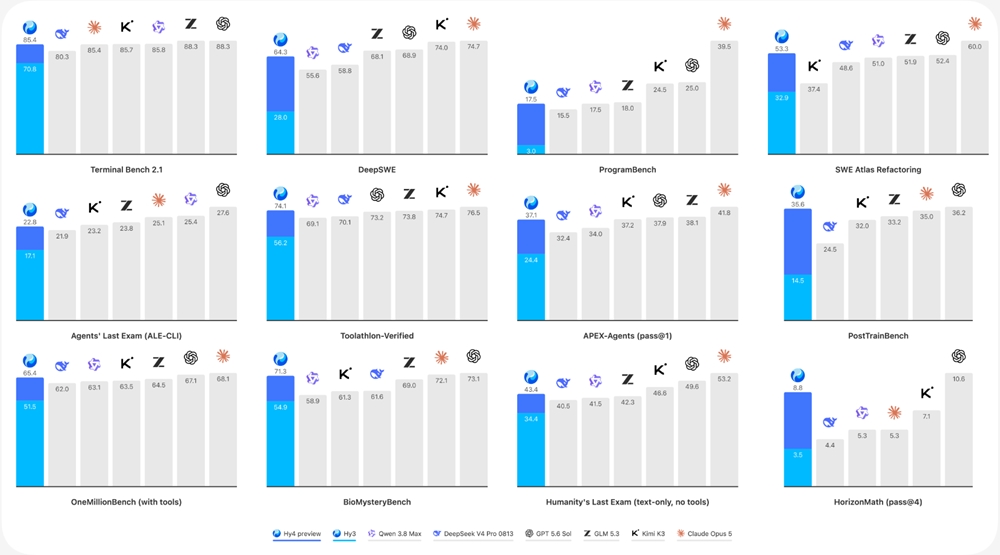
为验证模型的实际效能,腾讯组织了严格的内部盲测。163名来自工程、产品与研究部门的专家对203个真实工程任务进行评分(满分4分)。结果显示,Hy4preview平均得分为2.99,略高于智谱AI的GLM-5.3(2.92)与月之暗面的Kimi K3(2.94)。尽管差距微小,但在复杂任务如跨服务调试、多模态文档生成等场景中,Hy4preview的稳定性与一致性表现更为突出。
模型已全面开源,覆盖Hugging Face、GitHub与阿里云ModelScope等主流平台,并同步上线腾讯云TokenHub与第三方API聚合平台OpenRouter。用户可通过腾讯系产品如WorkBuddy(智能办公)、CodeBuddy(编程助手)、元宝(综合AI助手)及ima(创意生成)直接体验其能力。这种“开源+产品嵌入”双轨策略,既推动技术生态建设,又加速商业价值转化。
从行业视角看,Hy4preview的发布延续了大模型竞争范式的转变。过去两年,参数规模、上下文长度、多模态能力曾是主要宣传点,但市场逐渐意识到,真正决定模型价值的是其在具体业务流中的“可用性”与“增效比”。腾讯此次强调“真实生产力场景”,正是对这一趋势的回应。未来,大模型的竞争或将更多体现在垂直领域数据质量、工具链整合深度与用户反馈闭环效率上。
当然,Hy4preview仍面临挑战。百万级上下文虽带来信息优势,但也对内存管理、注意力机制优化提出更高要求;稀疏激活虽降低计算成本,但在低资源设备上的部署仍需进一步压缩与量化;此外,复杂推理任务中的“长思考”问题——即模型在多步推理中易丢失中间状态或陷入循环——仍是待解难题。腾讯表示将通过高频迭代持续优化,这也意味着开源社区的贡献将成为模型演进的关键力量。
长远来看,Hy4preview代表了一种新的大模型发展路径:不再追求单一维度的极致,而是通过架构创新、场景深耕与生态开放,构建可持续进化的智能基础设施。当AI从“炫技”走向“实干”,真正改变工作方式与科研范式的时刻或许才刚刚开始。