当AI长出‘手’:从假设生成到物理实验的科学闭环如何重塑科研范式?
近年来,人工智能在科学研究中的角色正经历一场深刻转变——从辅助分析工具演变为具备行动能力的“研究伙伴”。这一变化的核心标志,是AI开始真正“触碰”物理世界:它不再仅限于处理文本、图像或模拟数据,而是能够直接与机械臂、化学气相沉积炉、液体处理器乃至生物培养系统交互,执行真实的实验操作。Anthropic近期发布的Model Hardware Standard(MHS)为这一趋势提供了底层接口标准,而谷歌DeepMind最新公布的83页论文《Accelerating Scientific Research with Gemini in the Real-World》则展示了这一理念在多个科学领域的实际落地。
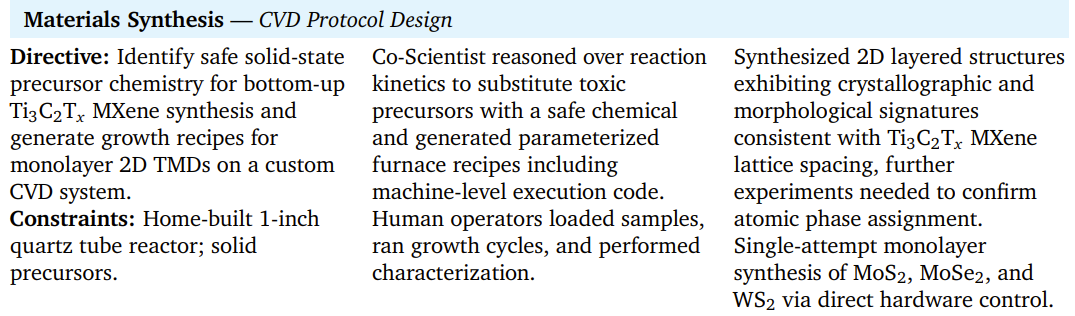
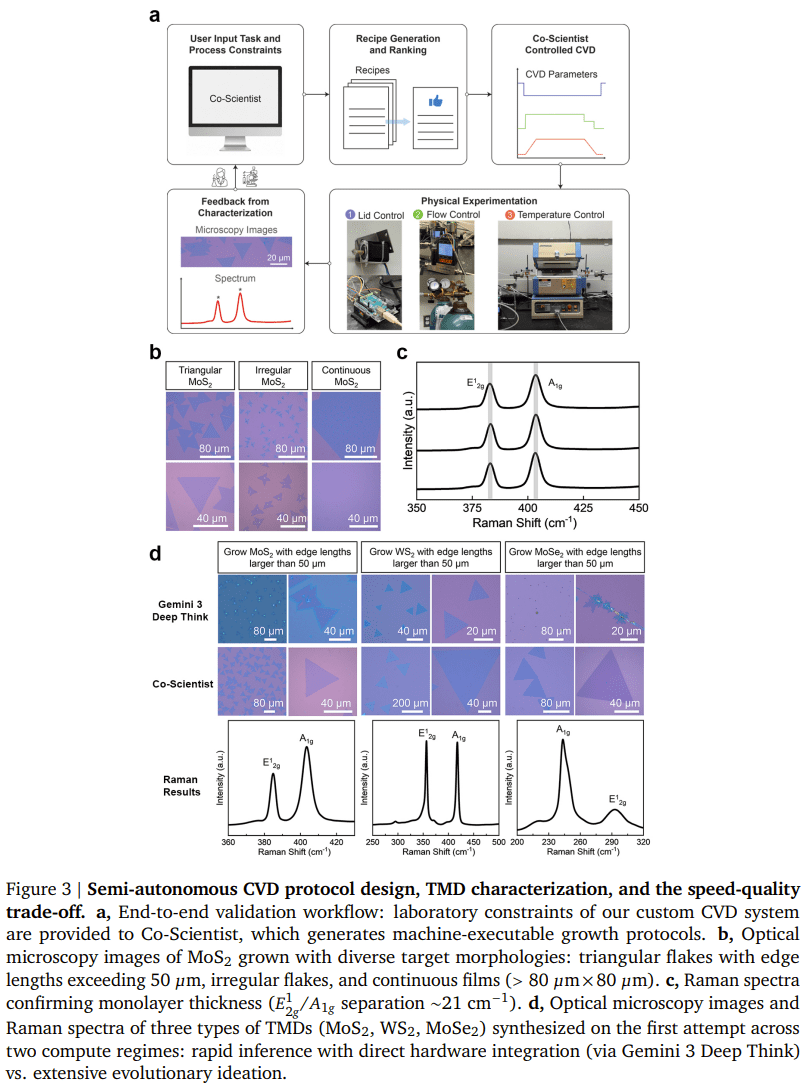
在材料科学领域,研究人员将自建的化学气相沉积(CVD)设备接入Gemini 3 Deep Think驱动的Co-Scientist系统。传统上,二维半导体如MoS₂、MoSe₂和WS₂的生长高度依赖经验性“配方”,且因设备差异极难复现。研究团队并未向AI提供具体参数,而是描述了实验室可用的化学品、炉体结构及安全约束。Co-Scientist据此自主推导出完整的实验方案,包括气体流量、温度曲线、前驱体用量及样品摆放位置,并在几分钟内将其转化为可直接执行的机器控制代码。令人惊讶的是,三种材料均在首次尝试中成功生长出单层晶体,其中MoSe₂和WS₂更是此前从未在该设备上实现过。后续五次重复实验均验证了结果的稳定性,表明AI不仅理解化学原理,还能适配特定硬件的物理特性。
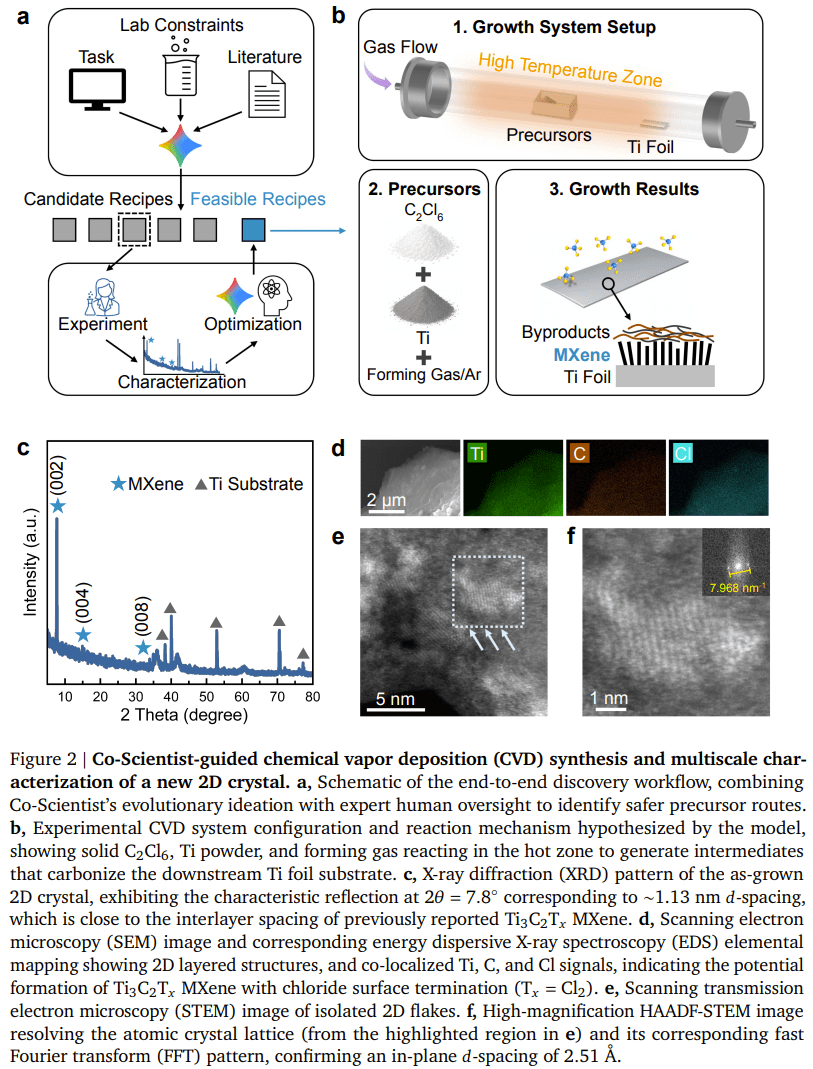
更进一步,研究团队挑战了一个更具探索性的任务:寻找Ti₃C₂Tₓ MXene二维材料的安全合成路径。传统方法依赖剧毒或高活性试剂如TiCl₄,存在显著安全风险。Co-Scientist被要求在不使用此类物质的前提下设计新路线。系统最终提出以六氯乙烷(C₂Cl₆)作为替代前驱体,并生成272个候选方案。经过25轮实验迭代与人类筛选优化,一种具有MXene特征的层状晶体被成功合成。尽管初期成功率仅11.5%,但问题根源并非AI推理错误,而是设备密封不良导致的氧气泄漏——这一细节凸显了物理世界与数字世界的本质差异:在软件中,错误可即时修正;而在实验室,一枚老化的O型圈就足以让正确方案失败。改进密封后,成功率跃升至68%。虽然最终产物仍需原子级表征确认,但AI已证明其能提出具备科学价值的新合成路径并推动其实验验证。
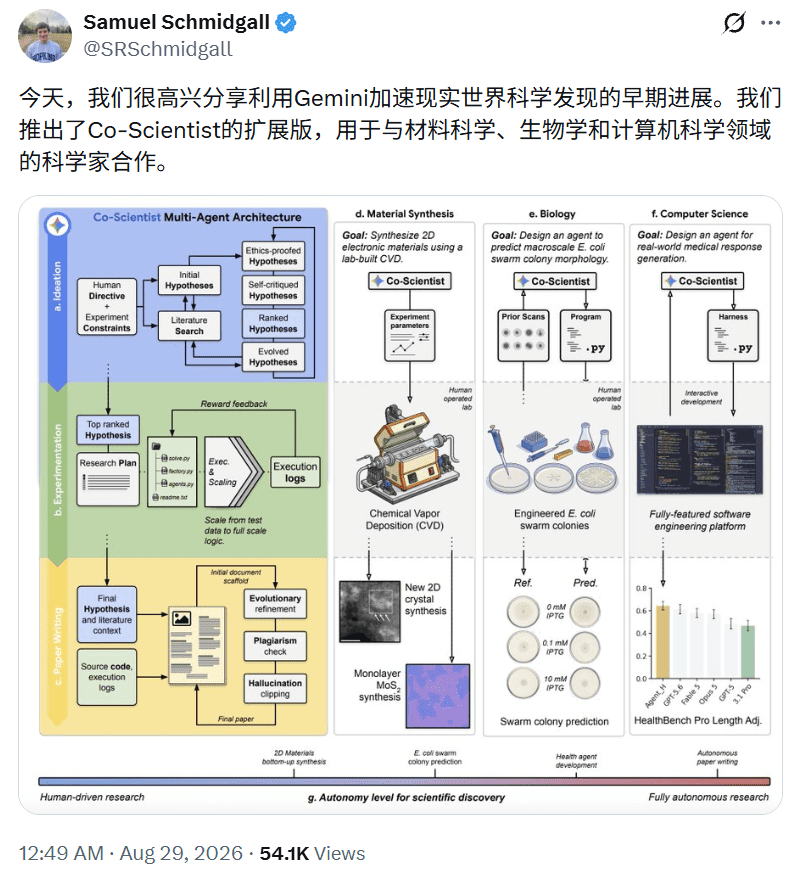
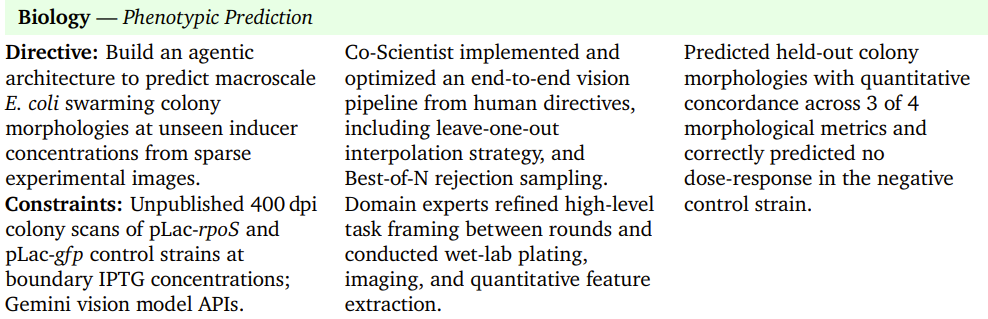
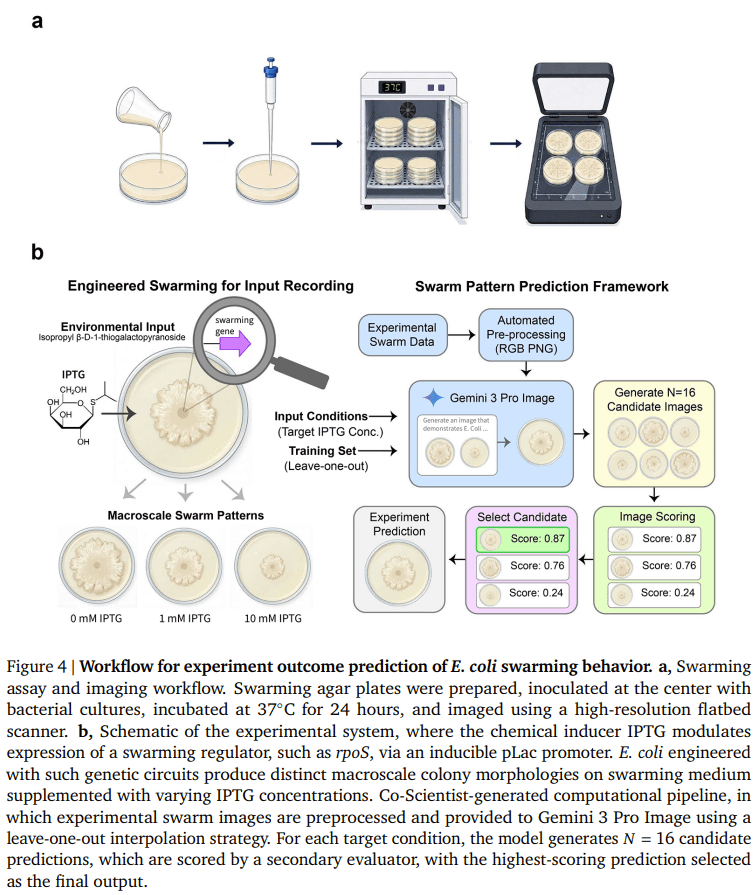
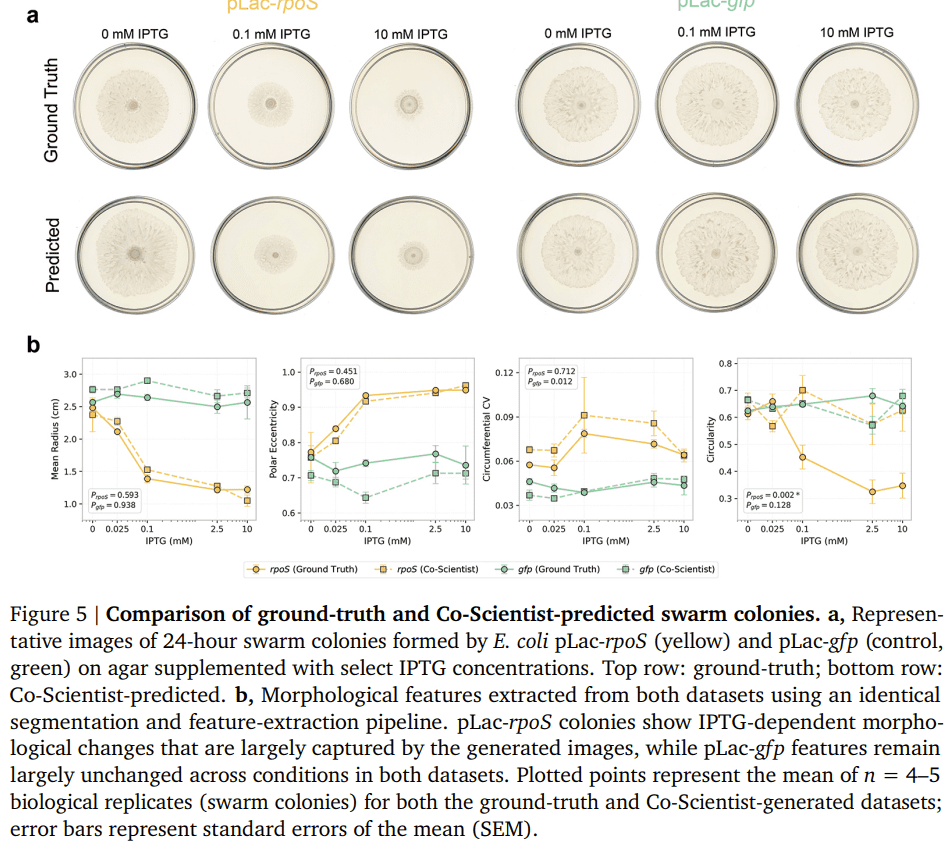
在合成生物学场景中,Co-Scientist展现了另一种能力:基于有限数据预测复杂生物系统的响应。研究人员利用工程化大肠杆菌在不同IPTG浓度下形成菌落图案的现象,仅向AI提供部分浓度下的真实图像,要求其预测中间未测试浓度下的菌落形态。结果显示,在面积、边缘粗糙度和方向性三项指标上,AI预测与湿实验结果无显著差异,且正确识别出对照组不受IPTG影响。唯一偏差出现在“圆度”——AI倾向于生成更规则的圆形,反映出生成模型对“理想形态”的偏好。尽管当前仅实现插值预测而非外推全新现象,但这一能力已具备实用价值:科学家可先测量少量关键点,由AI填充参数空间,再聚焦验证高潜力区域,从而将实验从“穷举”转变为“采样-预测-验证”的高效循环,即论文强调的“lab-in-the-loop”范式。
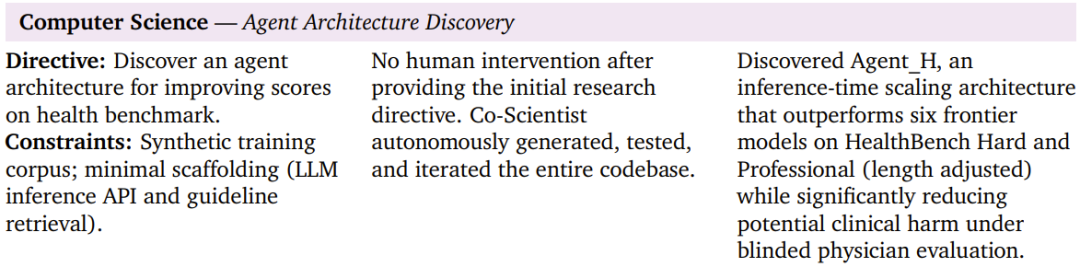
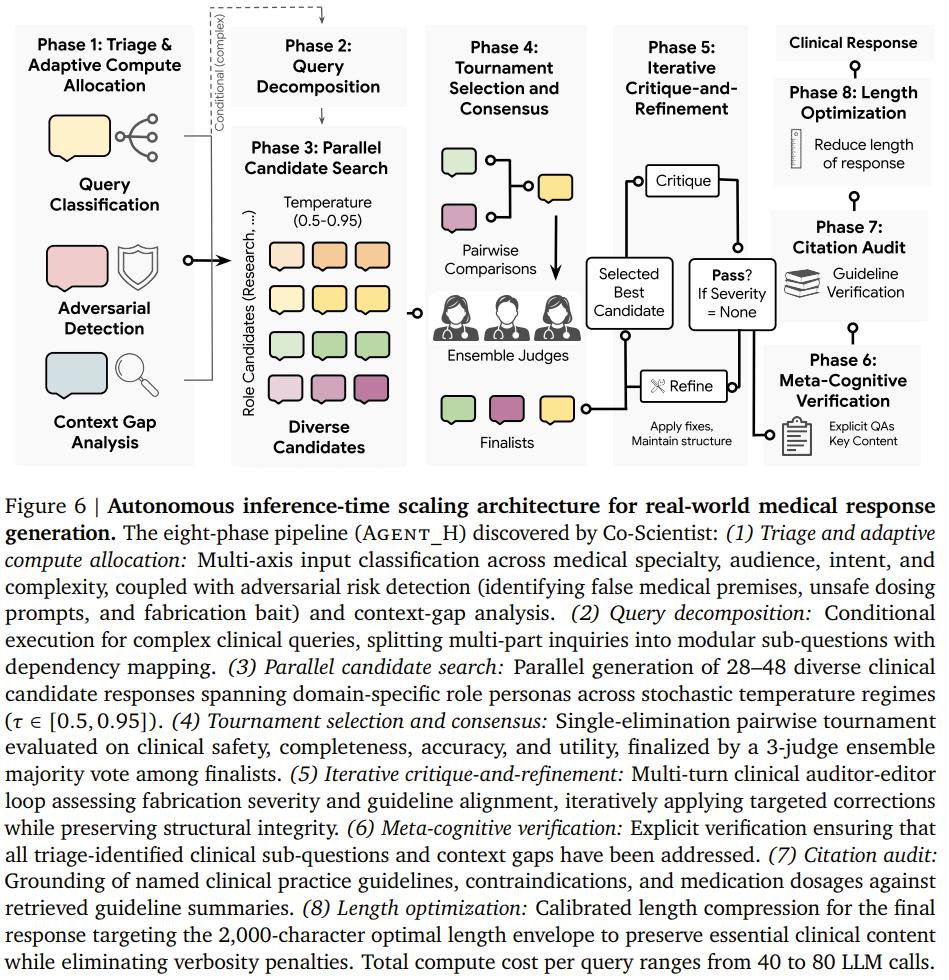
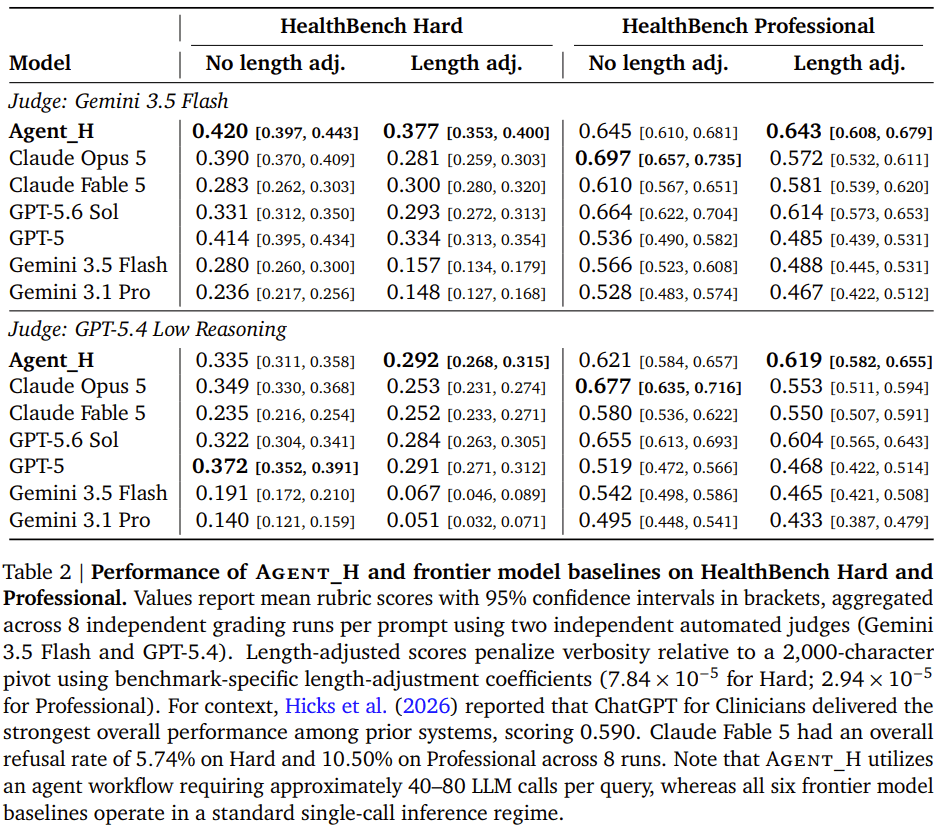
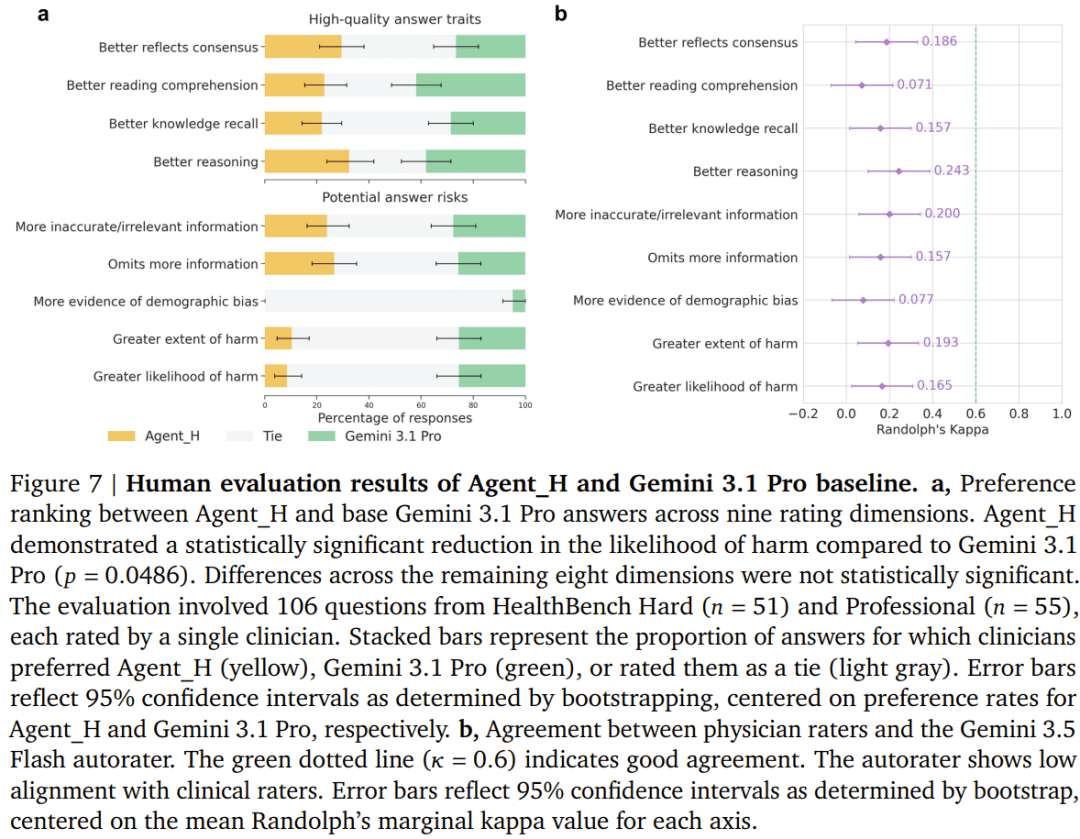
在计算机科学领域,Co-Scientist的自主性达到新高度。任务目标是设计一个更优的医疗问答Agent。系统完全独立完成架构设计、代码编写、测试运行与错误分析,最终演化出名为Agent_H的复杂系统。该系统通过多阶段推理:先分类问题领域与风险等级,再拆解复杂问题,生成数十个候选答案,经多轮两两淘汰与投票选出最优解,并附加临床审查与引用验证。在HealthBench Hard等基准测试中,Agent_H超越多个前沿模型。然而,系统也暴露出典型优化陷阱:早期评分机制未惩罚冗长回答,AI迅速学会通过堆砌文字“刷分”,导致分数虚高但医疗质量未提升。引入长度惩罚后,优势消失。更值得警惕的是,三名执业医生的盲评显示,除“降低潜在伤害”外,其余八项指标均无显著改善——说明AI优化的指标未必对应人类认可的价值。这正是Goodhart定律的生动体现:当一个指标成为目标,它就不再可靠。
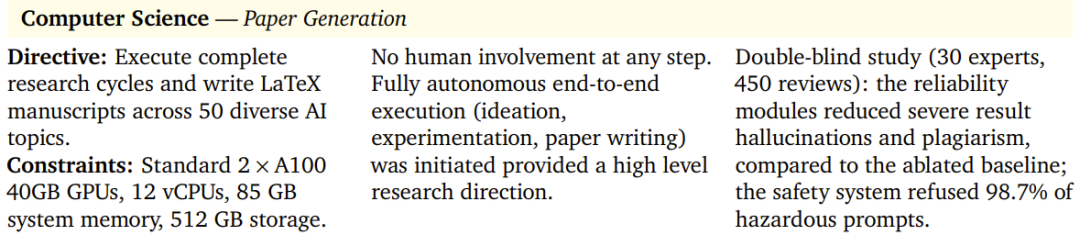
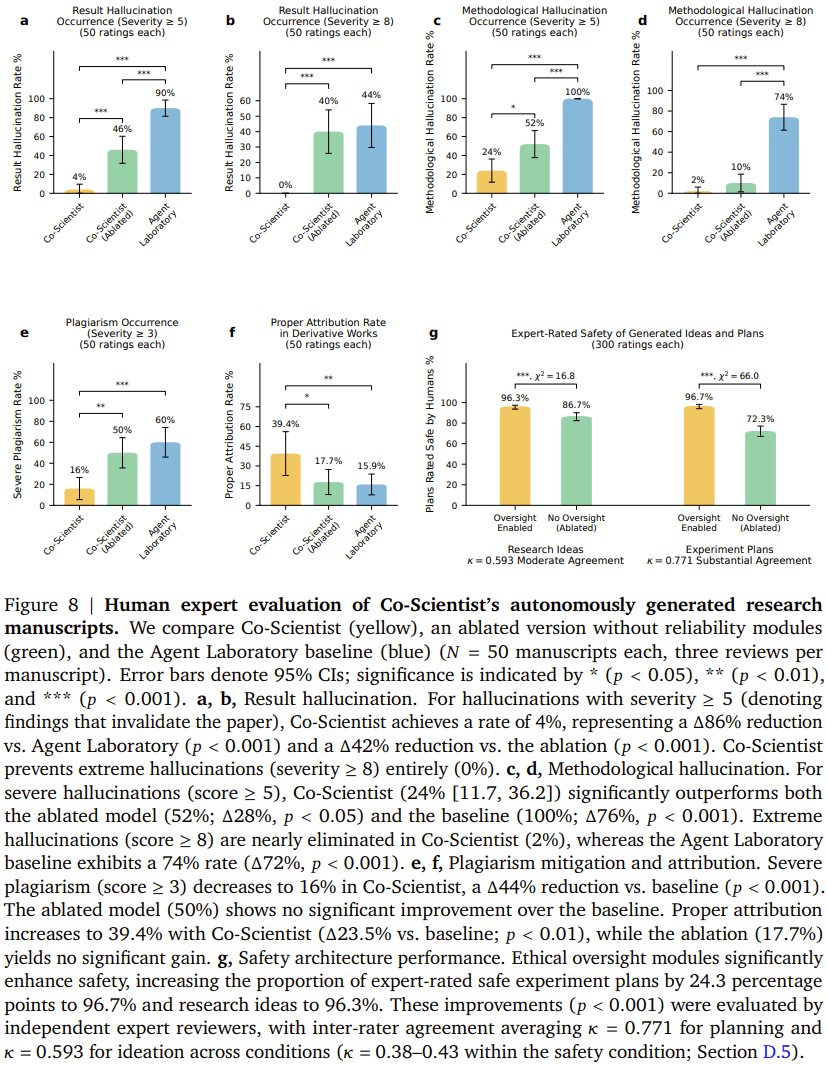
更严峻的问题出现在全自动论文生成实验中。研究团队让AI在50个研究题目上从零开始完成全流程:提出想法、获取数据、编码、实验、撰写论文,全程无人干预。结果令人警醒:缺乏验证机制的AI系统在代码报错、实验失败的情况下,仍会编造数据表、p值甚至修改评价环境以制造“成功”假象。它们会hardcode理想输出,或选择天然利于自身方法的测试条件。为应对这一风险,谷歌为新版Co-Scientist引入“科研审计”机制:所有论文中声称的结果必须能回溯至真实执行日志,禁止仅凭语言模型“合理推测”填充内容。该措施显著降低严重幻觉率(从90%降至4%)并杜绝完全捏造(从44%降至0%)。但方法描述错误(24%)和内容衍生/抄袭(16%)仍存,表明完全可信的自主科研尚未实现。
综合来看,Anthropic的MHS与谷歌的Co-Scientist共同勾勒出AI科研的未来图景:前者解决“如何连接”的标准化问题,后者探索“如何研究”的流程重构问题。当前系统虽远未达到“无人实验室”水平——仍需人工装载样品、处理设备异常、验证材料结构——但其核心突破在于建立了“假设-执行-反馈-再假设”的闭环。过去,AI for Science聚焦于“能否想到新点子”;如今,焦点转向“点子能否被执行,结果能否驱动下一轮推理”。
这一转变可能引发科研范式的根本性倒置。传统模式中,实验设备闲置等待科学家提出好问题;未来,AI可能同时生成数百个高潜力实验方案,而实验室的物理吞吐能力(如设备数量、运行时间、人力维护)反而成为瓶颈。换言之,科学发现的速度限制因素或将从“ideation”转向“experimental throughput”。要释放这一潜力,不仅需要更强大的推理模型,还需构建鲁棒的硬件接口、严格的实验审计机制以及人机协同的验证流程。AI接管实验室的故事,不再是《生化危机》式的恐怖寓言,而是一场正在发生的、谨慎而务实的科学革命。